用于我的图标库的 VLM 增强元数据
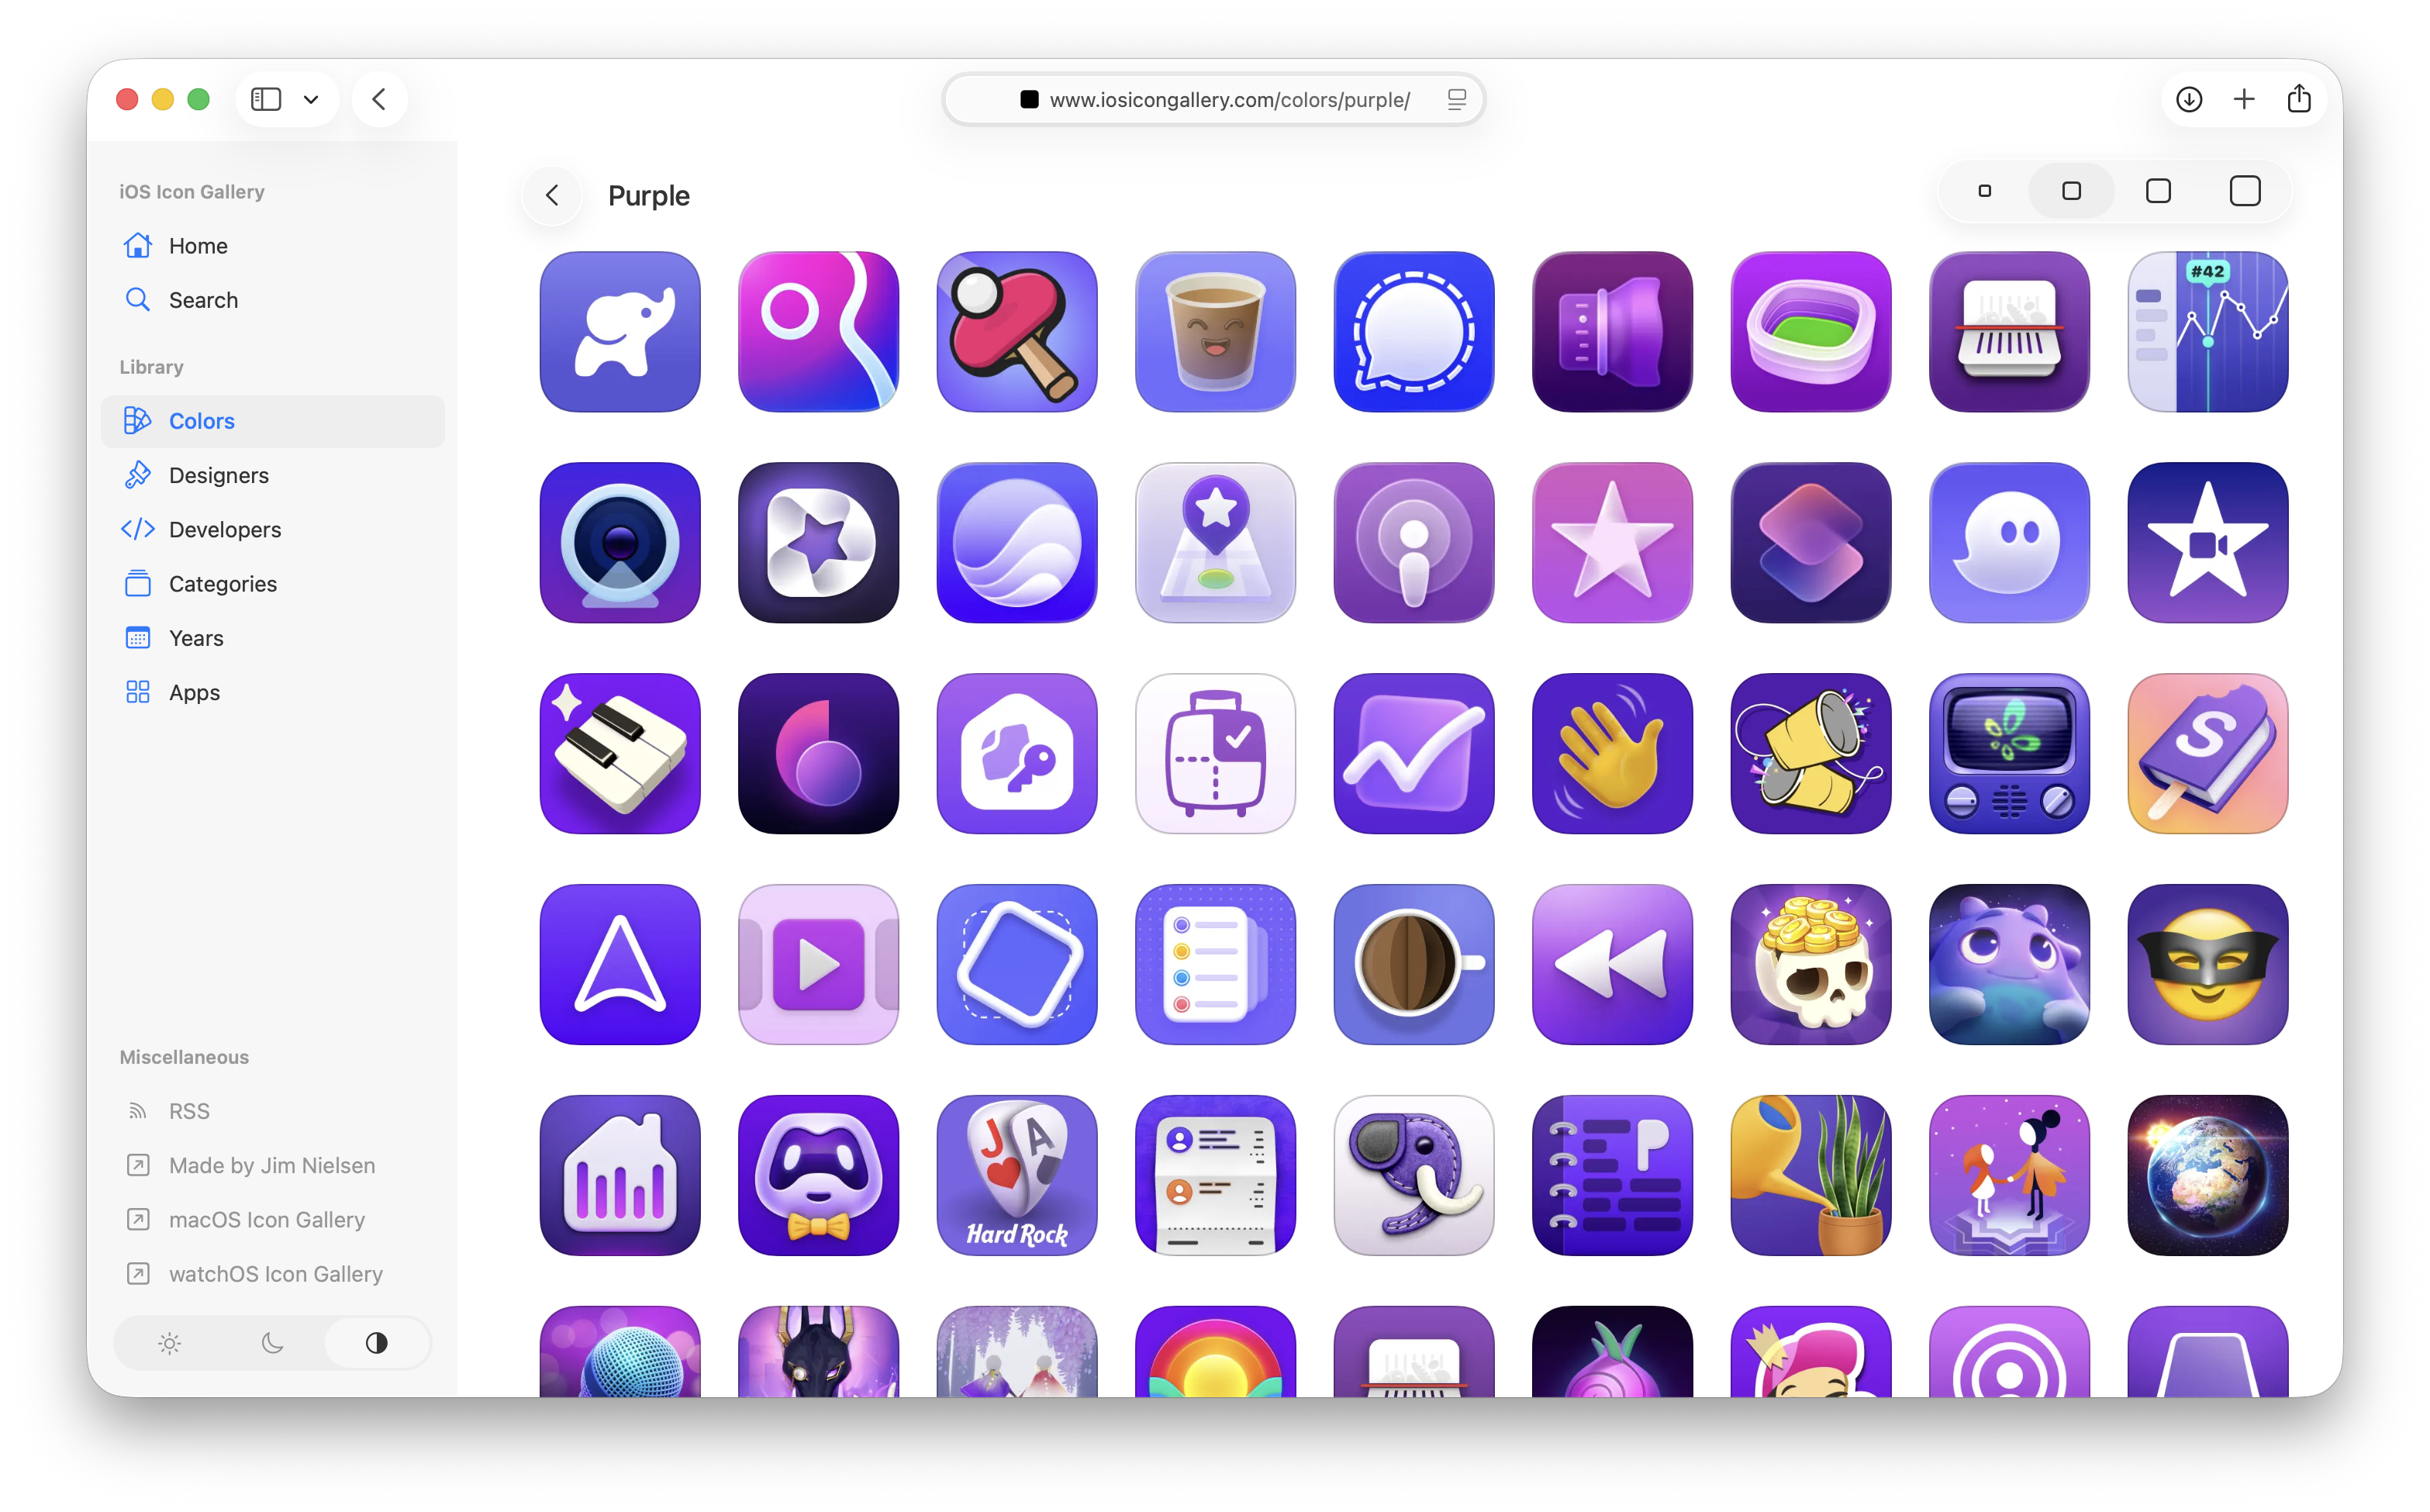
作者 Jim Nielsen 在 icon gallery 项目中尝试用视觉模型(CLIP、DINOv2、SigLIP2、Moondream VLM)做图标相似检索和自动打标。他先让 CLIP 对全量图标做 embedding,发现只有视觉特征很鲜明时匹配才靠谱;再试 DINOv2/SigLIP2,结果互有胜负,没有质变;随后用本地 Moondream 给每张图标写 caption 并抽关键词,做成 tag-overlap 搜索,关键词点击匹配比 CLIP 的 related 功能更精准,但 CLIP 做"看图找相似图"效果更好。 他最终停在"要不要把 VLM 变成项目长期依赖、时间成本如何"这一步,没有真正落地。对做本地小数据集检索、想用开源视觉模型给静态资源打语义索引的读者有实操参考价值。 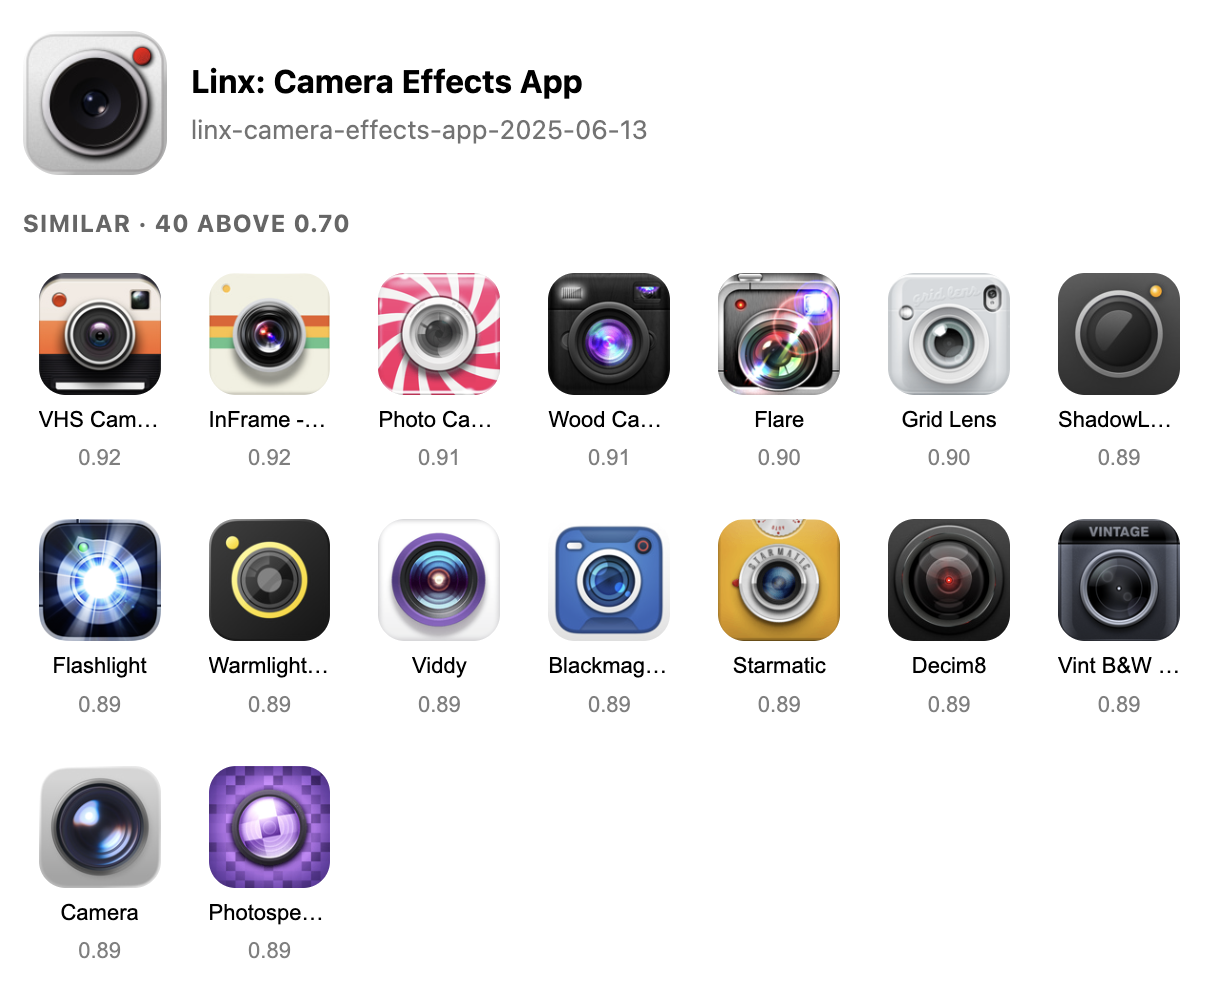
 评论
 点赞
 收藏