Chips and Cheese

RSS: https://chipsandcheese.com/feed
Chips and Cheese,深度解析计算机硬件与软件交互细节的半导体分析博客。

高通骁龙 X2 Elite 中的系统级架构

Qualcomm 的骁龙 X2 Elite Extreme 是一款面向笔记本市场的高规格 SoC,内置 18 个 CPU 核心和性能接近 NVIDIA GTX 1070 Ti 的 iGPU。 文章由 Chips and Cheese 解析其系统级架构(System Level Architecture),重点讨论随着 CPU 核心数、iGPU 算力与 DRAM 带宽同步提升后,片内互连设计面临的带宽、服务多模块和低延迟挑战。 文中指出 Qualcomm 采用类似 AMD 的 CPU 核心分簇策略,通过集群化简化片级互连,以降低延迟并保持整体性能。这是一篇有工程深度和拆解细节的硬核技术长文,适合关注 SoC 设计、移动处理器架构和 CPU/GPU 互连读手阅读。
评论点赞收藏1 天前

高通 Adreno X2 GPU 架构解析

文章分析高通骁龙 X2 Elite 中集成的 Adreno X2-90 iGPU。在 AMD 和 Intel 近年推出高性能 iGPU 的背景下,高通需要一款有竞争力的集成显卡来支撑其笔记本产品。 Adreno X2 在 Adreno X1 基础上扩展架构以提升吞吐:基本构建块为 Shader Processor (SP),每个 SP 内含一对 Micro Shader Processor Texture Processor (uSPTP),包含执行单元、寄存器文件和独立纹理缓存。 文章继续探讨 Adreno X2 相比 X1 的架构改动及其在图形性能上的提升。
评论点赞收藏11 天前

二进制翻译及其代价:Prism在Snapdragon X2上的实测与性能剖析

Windows 11的Prism二进制翻译器在Snapdragon X2 Elite上运行x86-64程序时,指令数量约翻一倍,Geekbench 7各工作负载均有显著性能损失。 256位AVX向量化工作负载(如视频播放、照片编辑)因需拆解为128位NEON指令,损失最大;分支密集的低IPC工作负载损失较小。Prism虽针对高通核心优化,但Neoverse N1/N2同样受翻译开销影响明显,根源在于翻译产生的多余指令对乱序引擎和缓存带宽造成压力。
评论点赞收藏20 天前

二进制翻译的性能代价:Windows 11在ARM上运行x86应用的实测分析

Chips and Cheese实测Windows 11 Prism二进制翻译性能:x86-64应用在ARM芯片上运行指令数翻倍,Geekbench 7多个工作负载出现巨大性能损失。 Snapdragon X2 Elite通过更宽核心和更大OoO引擎缓解翻译开销,E-Core表现甚至超过Neoverse N1。AVX向NEON翻译导致FMA指令膨胀4倍,视频处理等向量化负载损失最严重。 翻译缓存存在未记录格式问题。
评论点赞收藏20 天前

Arm推出C2-Ultra处理器、G2-Ultra NX GPU及CSS N4 IP

Arm发布三款新IP:旗舰手机将用C2-Ultra CPU和G2-Ultra NX GPU,数据中心用Neoverse CSS N4。G2-Ultra已随小米XRING O3芯片于8月24日出货。 C2-Ultra对比两代前的Cortex X925,架构布局相似,均为10宽解码、8个简单运算单元。
评论点赞收藏22 天前

Hot Chips 2026:IBM 双 ISA z/Architecture + ARM 架构访谈

<p>你好,亲爱的互联网朋友们,<br><br>今天我们来到了2026年热芯片大会!我们与IBM一起,与核心设计团队负责人Christian Zoellin和系统开发CTO Christian Jacobi一起,讨论他们刚刚公布的双ISA z/架构+ARM设计!<br><br>希望大家喜欢!</p><p><strong>以下文字记录经过简洁和可读性编辑。</strong></p><p><strong>乔治·科兹马:</strong>你好,互联网朋友们。我们现在在斯坦福参加2026年热芯片会议。今年的第一次热芯片演讲来自IBM,介绍了他们的下一代z/架构,以及他们在那里做的非常酷的事情,我们稍后会详细讲到。<br><br>不过我这里有两位来自IBM的人。如果你们愿意自我介绍。</p><p><strong>克里斯蒂安·雅各比:</strong>嗨,我是克里斯蒂安·雅各比。我是IBM研究员,也是系统开发的首席技术官。</p><p><strong>克里斯蒂安·佐林:</strong>我叫Christian Zoellin。我是一名杰出工程师,是这一代核心设计团队的负责人。</p><p><strong>乔治·科兹马:</strong>太棒了。那么,Z有什么了不起的——我暂且称它为z18,但下一代z呢?</p><p><strong>克里斯蒂安·佐林:</strong>它支持z/Architecture指令集和Arm指令集。</p><p><strong>乔治·科兹马:</strong>我记得我们上次见到类似的东西,应该是最初的Itanium。你们做的事情稍有不同。你们实际上把解码器集成到了核心里。<br><br>能不能说说解码器是怎么成为一个拥有多种模式的单一单元,还是说是两个独立的解码器?</p><p><strong>克里斯蒂安·佐林:</strong>它是一个解码流水线。让我从这里开始。有一个解码流水线,解码流水线的许多细节在两种指令集…</p>
评论点赞收藏31 天前

Xcena与三星的近内存计算CXL设备MX1

Xcena与三星合作推出MX1(Memory Xcelerator)CXL内存扩展设备,最大支持2TB DDR5内存,通过PCIe 6/CXL 3.2 x8接口连接主机,带宽128GB/s。 设备还提供8条下游PCIe 6通道可接SSD,SSD存储可暴露为内存,由MX1的DRAM充当缓存。该设备面向ML模型对内存容量的需求,将内存扩展、存储与计算能力整合到单一CXL设备中。
评论点赞收藏31 天前

三星LPDDR5X-PIM:DRAM内嵌MAC计算单元,性能接近NPU但软件适配是噩梦

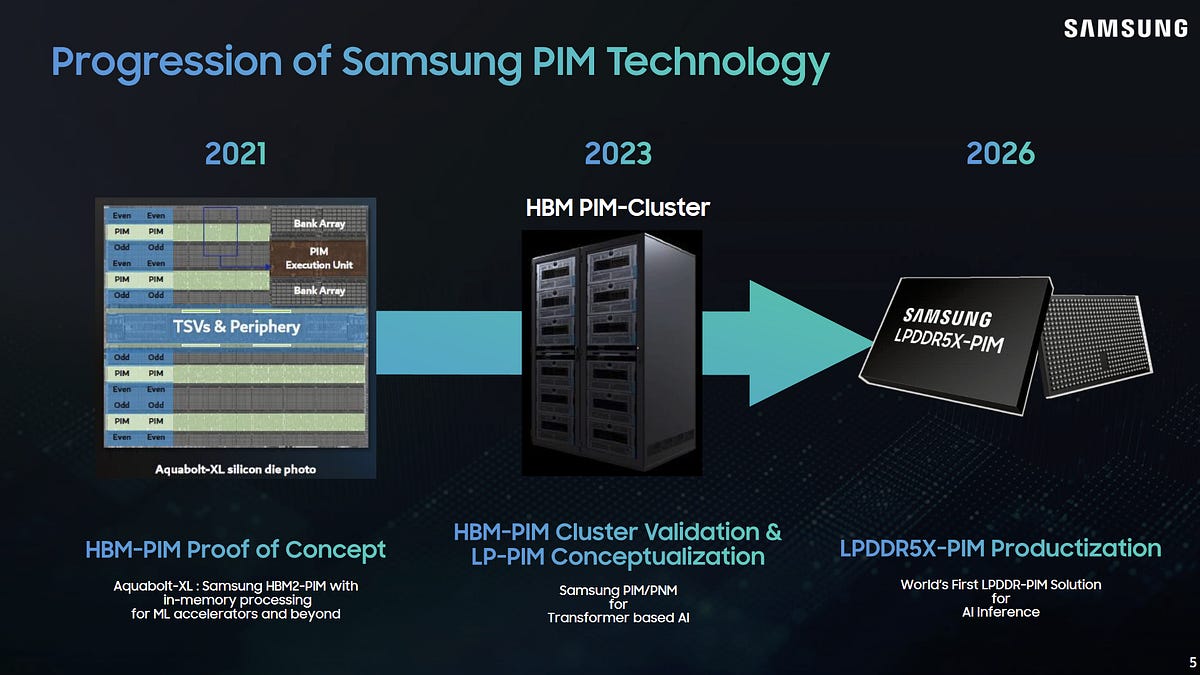
三星在Hot Chips 2026展示LPDDR5X-PIM,在DRAM芯片每个Bank内嵌入MAC计算单元,单芯片2.4 TOPS,8芯片聚合9.6 TOPS接近Intel Meteor Lake NPU。 每个PIM块通过特殊行地址控制模式,在标准LPDDR5X协议内实现计算,内部带宽614 GB/s远超外部76.8 GB/s。但软件适配面临严峻挑战:内存隔离需独占通道牺牲带宽,PIM读取会触发计算破坏缓存和推测执行,多任务OS需禁用中断和上下文切换。 作者建议从硬件层面扩展DRAM接口增加计算命令、让内存控制器作为缓存一致性对等方、新增CPU指令如"rep macb",认为这才是可行的软件采用路径。
评论点赞收藏32 天前

Hot Chips 2026:Intel Crescent Island 数据中心 GPU 详解

Intel 在 Hot Chips 2026 上披露了数据中心 GPU「Crescent Island」,采用 LPDDR5X 内存子系统,最高支持 480GB DRAM,为目前非 HBM 架构 GPU 中容量最高,可单卡直接运行 Deepseek-V4 Flash。 Intel 拒绝透露显存带宽数据。
评论点赞收藏34 天前

Hot Chips 2026:富士通 Monaka CPU 详解

富士通在 Hot Chips 2026 上介绍了新一代 Monaka CPU,回顾 A64FX 从 SPARC 转向 Arm aarch64 架构的历程。A64FX 引入了 SVE 向量扩展,奠定了 Arm 向量执行策略的基础,后续 SME 也沿用了类似思路。 Monaka 针对通用工作负载做了改进,但具体参数和性能数据需看完整演讲内容。
评论点赞收藏36 天前

Hot Chips 2026: Intel's Diamond Rapids

Hello you fine Internet folks, Intel unveiled their upcoming Diamond Rapids Server CPU at Computex where they said that Diamond Rapids has twice the memory bandwidth, PCIe Gen 6, and 50% more cores th...
评论点赞收藏36 天前

SiFive首款服务器平台:RISC-V生态补齐RVA23关键一环

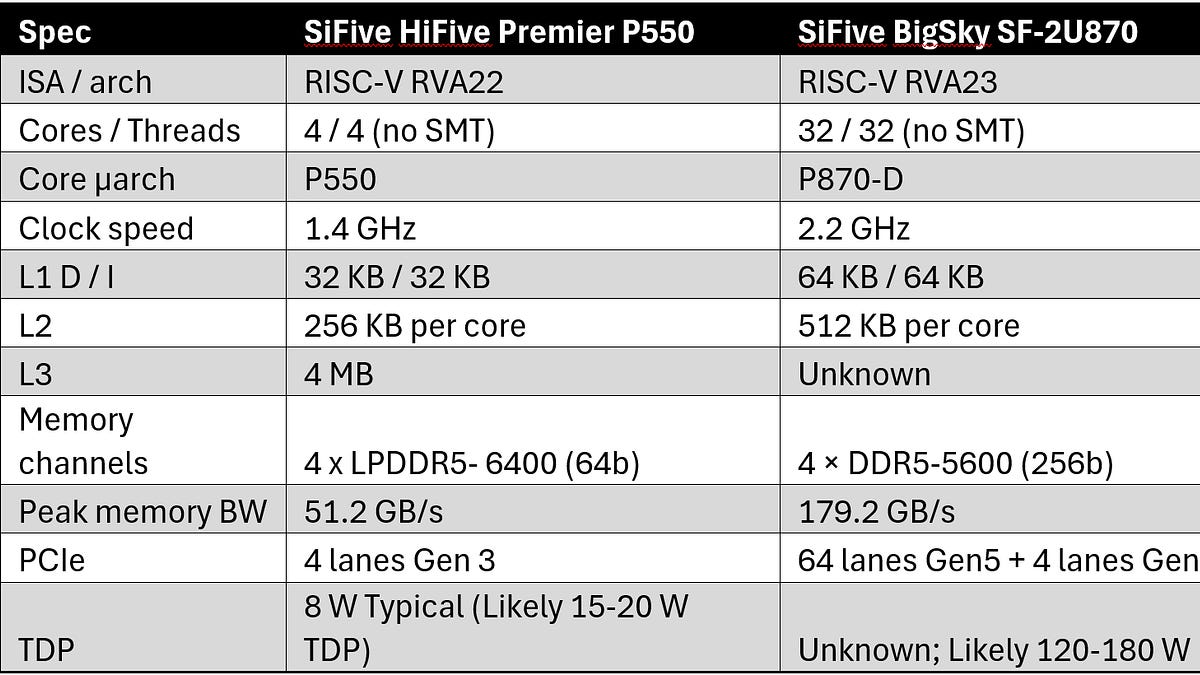
SiFive发布首款RISC-V服务器平台BigSky SF-2U870,搭载32核P870-D处理器,支持RVA23标准,可直接运行Ubuntu 26.04。与Intel Xeon 6532P-B、AMD EPYC 8325P、Ampere Altra Q32-17对比,核心优势是PCIe 5.0支持和更高主频,但核心数和内存带宽不及Ampere高端型号。 RISC-V生态长期缺RVA23硅片,BigSky填补的是开发平台"能跑起来"的空白而非性能竞争。
评论点赞收藏36 天前

Hot Chips 2026:Intel Wildcat Lake 的低成本工程取舍

Intel 在 Hot Chips 2026 发布 Wildcat Lake(Core Series 3),面向低成本笔记本市场,采用 MCP 封装而非高端 Ultra 系列的先进 chiplet 方案。 取消内置 ISP、显示管道从 4 减至 3、iGPU 仅 2 个 Xe 核心且去掉光追,但保留矩阵乘法单元以维持约 40 TOPS NPU 性能。UCIe 接口降至 8 GT/s 并省去纠错机制,通过输出缓冲区减少跨 die 通信功耗。 整体策略是精准砍掉消费端用不到的功能,用 Intel 18A 工艺搭配 Lion Cove/Skymont 核心,在续航和成本之间找平衡。
评论点赞收藏37 天前

AMD在BIOS更新中静默关闭了Zen 4的Loop Buffer

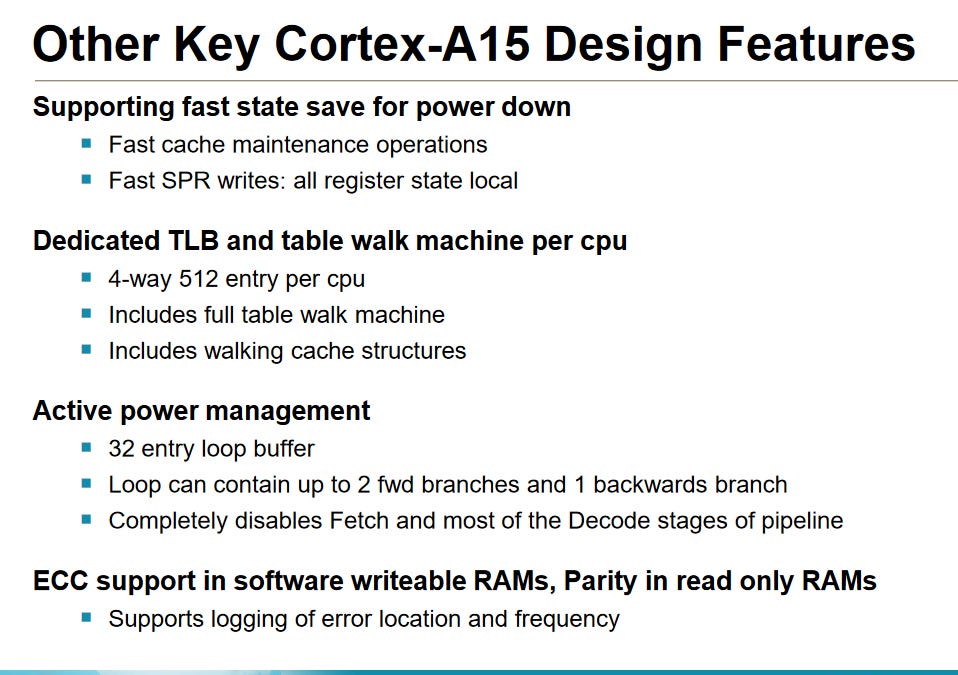
AMD在BIOS更新中静默禁用了Zen 4处理器的Loop Buffer功能,性能影响几乎为零。作者通过硬件性能计数器和SPEC CPU2017、赛博朋克2077实测验证,推测可能是首次引入该功能时发现了隐藏bug。 Op Cache完全接管后前端带宽仍绰绰有余。
评论点赞收藏37 天前

Nvidia要把CUDA带到RISC-V上,但门槛高得吓人

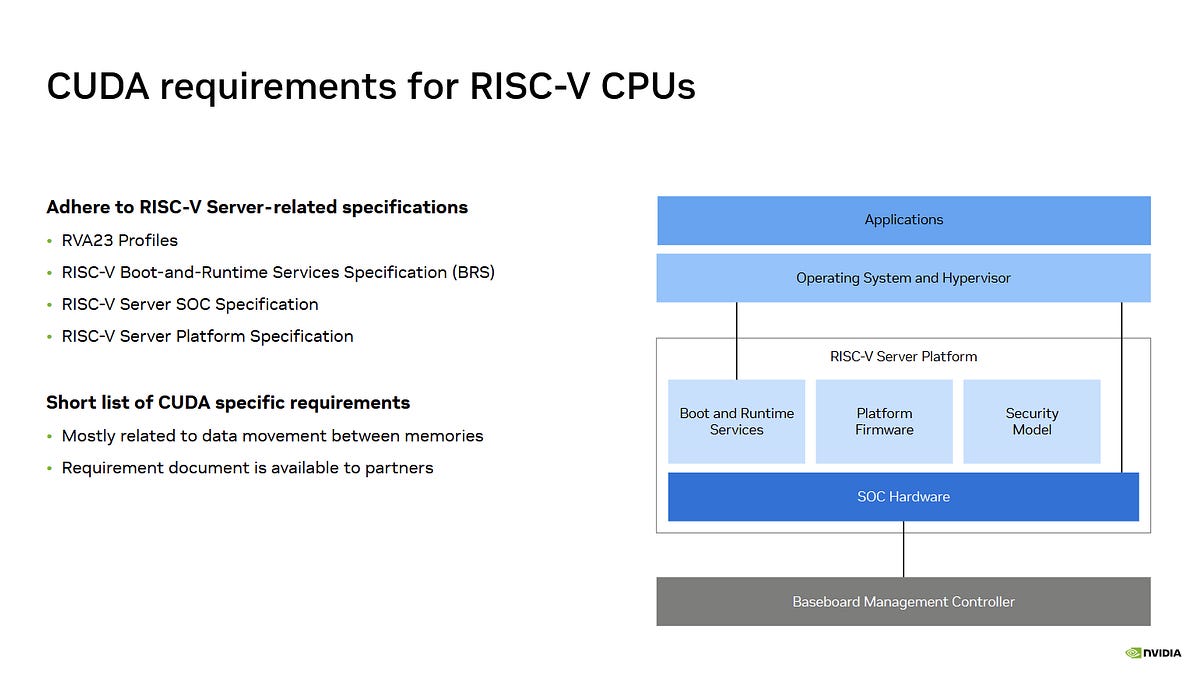
Nvidia在Hot Chips 2026上公布将CUDA扩展到RISC-V CPU的计划,要求RVA23架构、ACPI支持、PCIe缓存一致性等服务器级特性。现有RISC-V硬件几乎无法满足这些要求,预计最早出现在服务器而非消费级产品。 作者希望Nvidia未来放宽限制,让普通RISC-V系统也能跑CUDA。
评论点赞收藏37 天前

Hot Chips 2026:高带宽闪存(HBF)的应用

HBF(高带宽闪存)将SSD用的闪存技术以HBM方式封装,与计算芯片同封装,容量远超HBM但带宽略低。目前尚无产品,演讲基于仿真和预测,聚焦机器学习工作负载适配。 与Intel Optane不同,HBF不是内存池。
评论点赞收藏38 天前

Hot Chips 2026:三星与HBM基座Die的机会

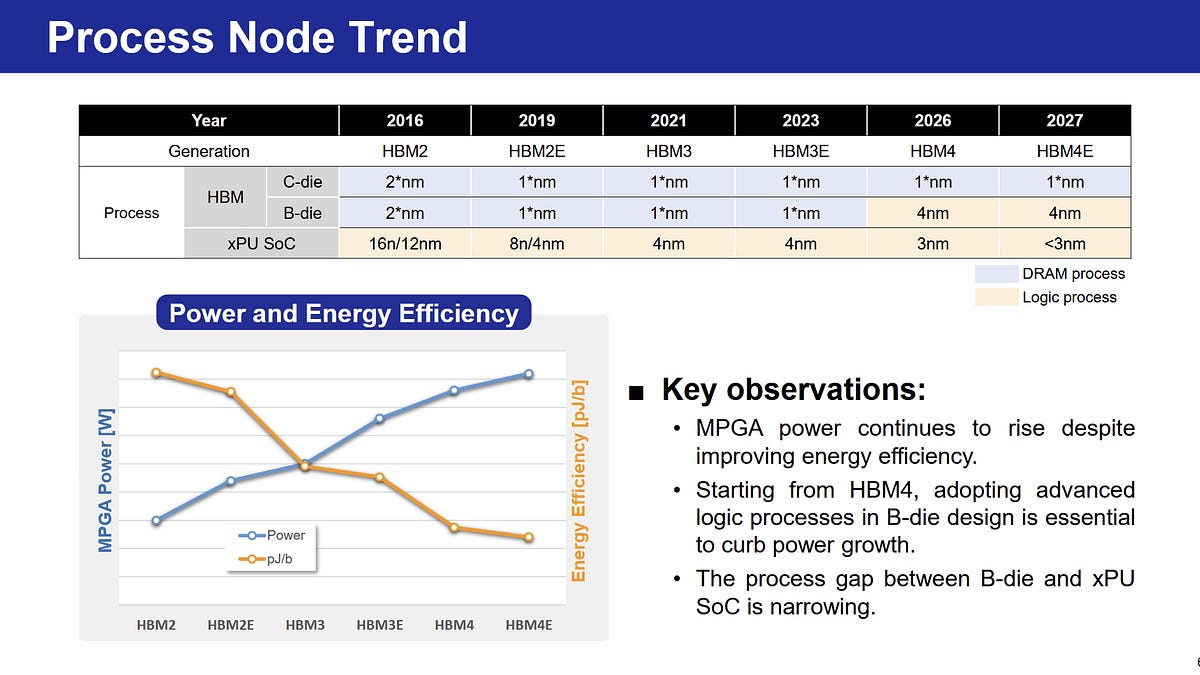
三星在Hot Chips 2026上分享了HBM基座Die的设计权衡。HBM每代带宽提升依赖两条路径:DRAM Die与基座之间的TSV密度,以及基座到主机的接口带宽。 前者靠更密更多的TSV就能解决,后者才是瓶颈——基座与主机的物理接口已经占用了基座大部分面积,增加数据引脚会让面积和功耗问题更严重。 三星指出,尽管每代HBM的能效在提升,但内存总功耗仍在持续上升。
评论点赞收藏38 天前

DAC 2026专访Synopsys:芯片设计的多物理场签核与800V供电变革

Synopsys与AMD合作推进3DIC设计,芯片签名验证从单一电气签核转向机械-电气、热-电气、电迁移、电磁多物理场联合签核。数据中心供电架构正从54V向800V演进,Nvidia主导、Bosch等支持标准化组件,电流降低大幅减少I²R损耗。 400G SerDes标准仍在制定中,预计还需1.5到2年,PAM6/PAM8方案竞争激烈,Nvidia采用双向224G作为过渡。UCIe等chip-to-chip互联标准各厂商 lane 数不统一,信号完整性设计复杂度持续上升。
评论点赞收藏50 天前

英伟达Vera白皮书有个漏洞

英伟达Vera CPU白皮书被指存在多处技术误导。Olympus核心本身表现强劲——Phoronix实测Geomean超EPYC 9575F 10%、超Xeon 6980P 1.55倍。 但白皮书将传统SMT描绘为低效时间片轮转、把可选的32 NUMA节点配置当作x86必然结果、将SPEC整数基准重新包装为"agentic benchmarks",这些表述都经不起推敲。 作者逐条拆解了SMT图示错误、NUMA拓扑选择性呈现、IPC跨ISA不可比等问题,指出白皮书硬件部分扎实、叙事部分用力过猛。
评论点赞收藏56 天前

Arm Cortex-A55 深度剖析:从分支预测到内存子系统的全面升级

Cortex-A55 是 Arm 2017 年推出的 5 系列低功耗核心,在 Mediatek Genio 1200 等芯片中作为 A78 的小核搭档使用。实测显示 A55 相比 A53 的主要改进集中在前端分支预测和内存子系统:引入了感知器预测器和 48 条目微 BTB,L1D 支持每周期同时执行一次加载和一次存储,FMA 延迟从 8 周期降至 4 周期。 但 A55 仍缺乏高性能核心常见的大 BTB,分支预测精度远落后于现代乱序核心,且在某些 Clang 编译场景下预测表现反而退步。
评论点赞收藏59 天前

RosaicLabs、Atom RTL 与 32 片 AMX:拼凑 x86 拼图

Intel 向初创公司 RosaicLabs 开放 Atom CPU 的 RTL 代码,同时 Linux 内核邮件列表出现支持 32 个 AMX tile 的实现。 Intel 罕见地允许第三方获取其 x86 核心 RTL,这与其一贯的保守策略形成对比。 Phoronix 发现的内核补丁显示,新实现将 AMX tile 数量从 Intel 量产版的 8 个提升至 16 和 32 个,暗示潜在的架构变更或竞争压力。
评论点赞收藏61 天前

AMD 推进 AI 2026:与首席架构师 Alan Smith 对话 CDNA5

AMD 首席架构师 Alan Smith 在 Advancing AI 2026 活动中详解 CDNA5 架构,宣布 MI455 和 Helios GPU 正式推出。CDNA5 从 GCN 转向 RDNA 架构,是数据中心 GPU 的重大技术跃迁。 Alan Smith 指出 CDNA5 针对 AI 训练和推理 workload 做了深度优化,支持更高带宽、更低延迟的芯片互联,并强调与软件栈的深度协同。 相比前代,CDNA5 在能效比和单精度算力上提升显著,尤其适合大模型训练场景。 该访谈包含大量工程细节,如计算单元设计、内存层次结构、互连拓扑等,对关注 GPU 架构和 AI 硬件的读者有较高参考价值。
评论点赞收藏65 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。