本地 LLM 服务器性能实测:llama.cpp、llamafile、LM Studio 与 Ollama 横向对比
<p>本地运行LLM不仅仅是选择模型。服务工具起着关键作用,它决定了提示处理的速度、令牌生成的速度以及模型部署的难易程度。我们在四台流行的本地服务器上测量了这些差异(,,,以及我们自己的)利用我们的,一种依赖于比较不同平台上的服务器。</p><p>我们在Mac Studio M4(使用Metal GPU加速)、搭载NVIDIA L40S的Linux服务器(CUDA)和Steam Deck(Vulkan)上进行了测试。我们涵盖了三种Qwen型号大小:0.8B、9B和27B(最后一个因内存限制在Deck上跳过),并测试了提示解析从1,024到8,192个令牌,以及32或64个令牌输出的令牌生成。</p><p>这不是最终排名。它是在三种不同环境中,提供相同模型权重时这些工具表现的实用快照,试图理解每个服务器的“秘密武器”所在。</p><h2><strong>我们发现了什么</strong></h2><ul><li><strong>最大的加速来自配置,而非发动机选择。</strong>在llamafile构建中启用CUDA图后,0.8亿模型的L40S解码提升了16.8%。较新的Vulkan着色器工具链在9B模型上提高了Steam Deck提示处理效率高达63%,且最佳的推测解码草稿长度在不同平台间互换,Metal版本中第二轮获胜,CUDA上第四轮获胜。</li><li><strong>这四台服务器共用同一个核心。</strong>每个设备都通过底层llama.cpp服务GGUF,这也是为什么一旦权重和环境固定,它们在提示处…</li></ul> 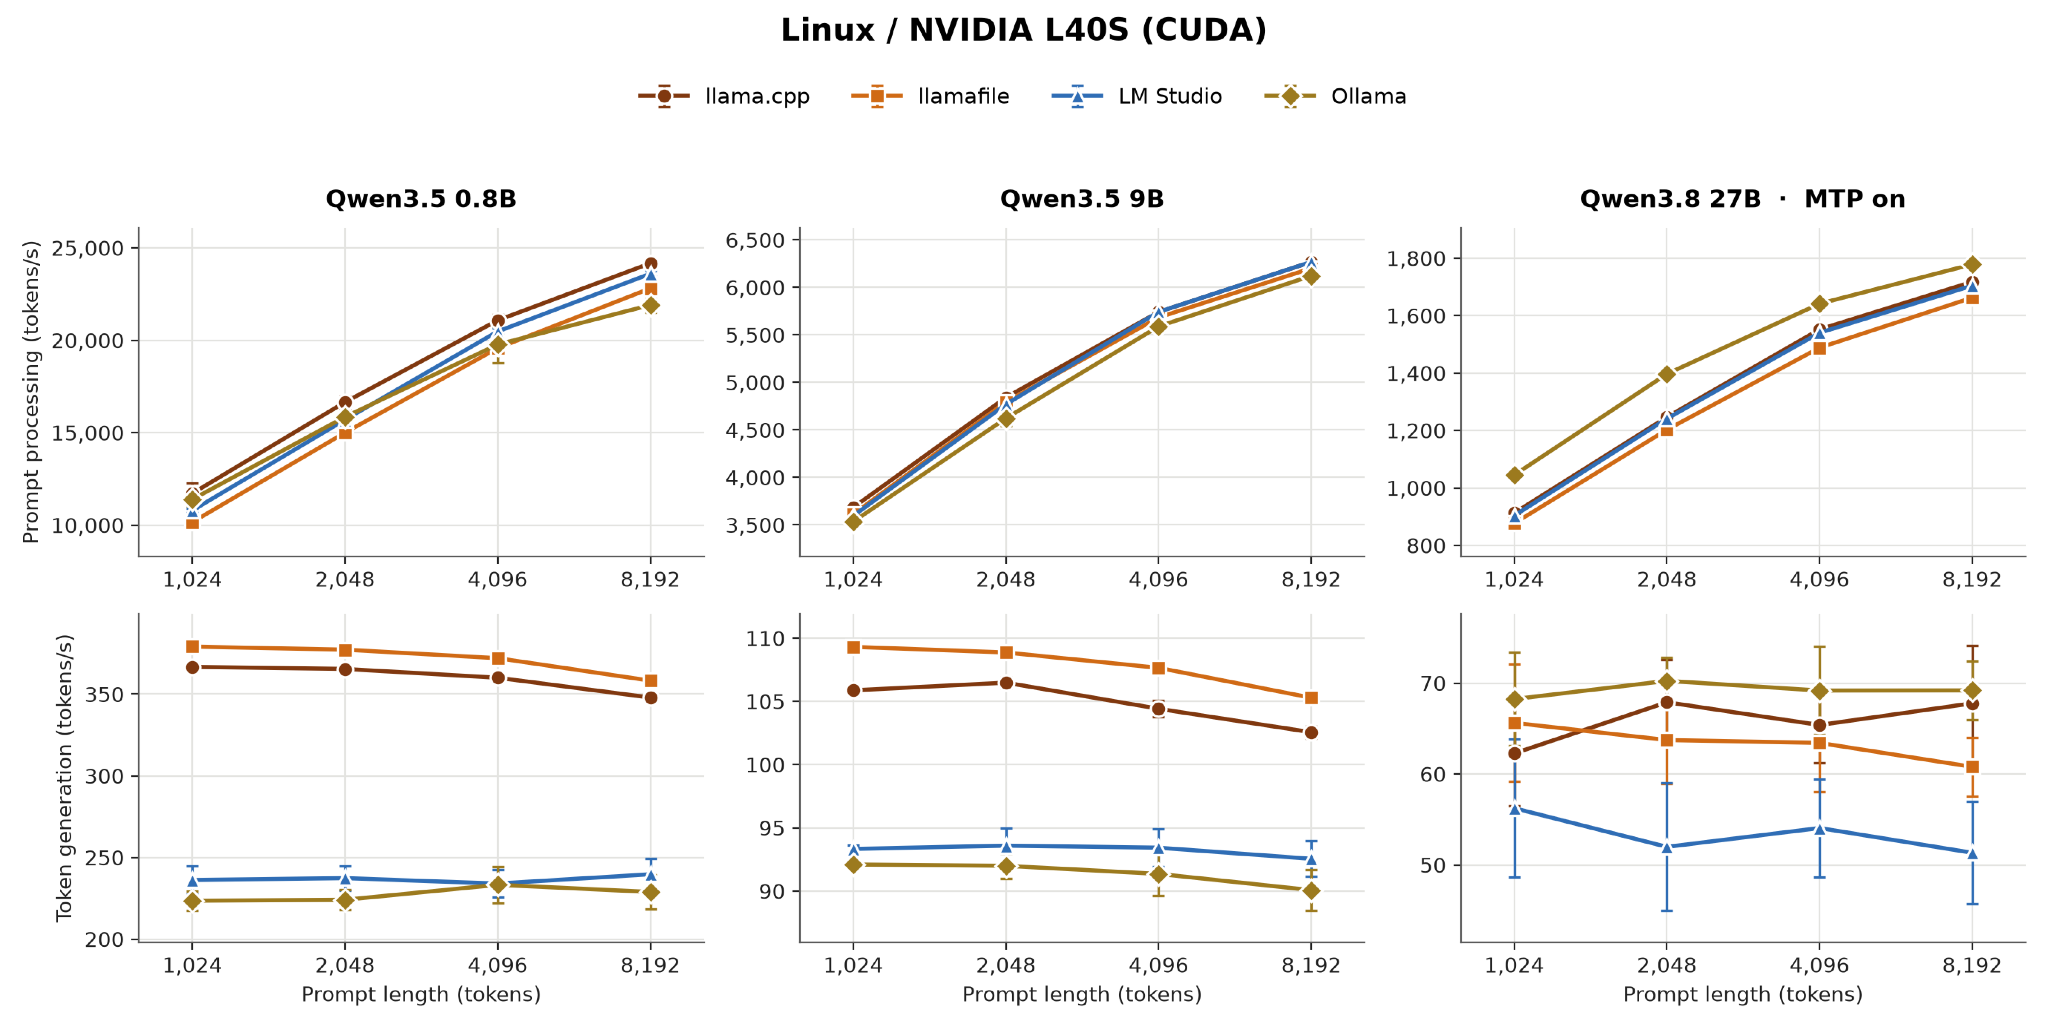
 评论
 点赞
 收藏