
本地 LLM 服务器性能实测:llama.cpp、llamafile、LM Studio 与 Ollama 横向对比
 3


本地运行LLM不仅仅是选择模型。服务工具起着关键作用,它决定了提示处理的速度、令牌生成的速度以及模型部署的难易程度。我们在四台流行的本地服务器上测量了这些差异(llama.cpp,LM工作室,奥拉玛,以及我们自己的灯丝)利用我们的讲解骆驼本奇,一种依赖于骆马-班奇比较不同平台上的服务器。
我们在Mac Studio M4(使用Metal GPU加速)、搭载NVIDIA L40S的Linux服务器(CUDA)和Steam Deck(Vulkan)上进行了测试。我们涵盖了三种Qwen型号大小:0.8B、9B和27B(最后一个因内存限制在Deck上跳过),并测试了提示解析从1,024到8,192个令牌,以及32或64个令牌输出的令牌生成。
这不是最终排名。它是在三种不同环境中,提供相同模型权重时这些工具表现的实用快照,试图理解每个服务器的“秘密武器”所在。
我们发现了什么
- 最大的加速来自配置,而非发动机选择。在llamafile构建中启用CUDA图后,0.8亿模型的L40S解码提升了16.8%。较新的Vulkan着色器工具链在9B模型上提高了Steam Deck提示处理效率高达63%,且最佳的推测解码草稿长度在不同平台间互换,Metal版本中第二轮获胜,CUDA上第四轮获胜。
- 这四台服务器共用同一个核心。每个设备都通过底层llama.cpp服务GGUF,这也是为什么一旦权重和环境固定,它们在提示处理中只能有几个百分点,也说明上述设置比选择哪个服务器更重要。
- 大部分解码间隙是固定的主机开销,而不是GPU工作。每个代币的成本几乎固定(Mac 约 0.4 毫秒,L40S 约 1.8 毫秒,Deck 约 5.4 毫秒),所以同样的开销在快机型上占很大比例,而在慢机型上占较小比例。
测试设置
我们测试了三个环境:
环境 | 硬件 | 操作系统 | 测试车型 |
|---|---|---|---|
Mac Studio | M4 Max,64 GB 统一内存 | macOS Tahoe 26.6.2 | Qwen3.5 0.8B,Qwen3.5 9B,Qwen3.8 27B |
Steam Deck | Steam Deck OLED,AMD 梵高 APU,16 GB 共享内存 | Steam OS 3.8.16(版本 20260716.1) | Qwen3.5 0.8B,Qwen3.5 9B |
Linux L40S 系统 | 32核Intel Xeon Gold 6338处理器,一颗NVIDIA L40S 48GB 显存 | Ubuntu 24.04.3 LTS | Qwen3.5 0.8B,Qwen3.5 9B,Qwen3.8 27B |
软件版本,三台机器上完全相同:llama.cpp b10441(提交 0177dcc73)、llamafile 0.10.6(提交 42ff11b)、Ollama 0.34.0、LM Studio 运行时 2.28.2(metal / cuda12 / vulkan)、llama-benchy 0.4.0。
每个运行时都服务于lmstudio-community的相同GGUF文件:llama.cpp和llamafile直接加载;Ollama通过由这些文件构建的标签提供;LM Studio通过显式模型键钉顶到同一GGUF。
0.8B测试使用Q8类伪影,9B测试使用Q4_K_M量化。每个模型加载了16,384个上下文长度令牌,支持完整的GPU卸载,对于27B模型,我们在草稿长度2(LM Studio默认)时启用了推测解码。
我们有意保留每个运行时的单独批处理默认值。
我们测量到了什么
基准报告了两种吞吐量测量,均以每秒令牌数表示:
- 提示处理(PP)衡量服务器在文本生成开始前处理输入提示的速度。
- 代币生成(TG)衡量服务器处理提示后产生输出令牌的速度。
在处理长文档、大型代码库、代理或长对话历史时,提示处理最为重要。令牌生成在交互式聊天中更为重要,因为用户在等待回复出现。
基准测试使用了四种提示大小(1,024、2,048、4,096和8,192个令牌),文本生成则用32和64个输出令牌进行测量。
你在图中看到的每个点都是15次骆马-卧推运行的结果。第一个只是作为热身,然后忽略;剩下的14个中,丢弃最快的2个和最慢的两个,中间的10个被平均。
误差条在所有14次热身后运行中均为±1个标准差。服务器在每次运行前都会重启,因此权重和KV缓存是冷启动的,四个服务器在每次模型评估中交错分布,因此机器状态的缓慢漂移不会有利于先完成的服务器。
测量数据是客户端的,只有一个例外:LM Studio 在 macOS 上的解码数据是基于引擎自身的时序。原因是 LM Studio 在 macOS 上以爆发方式发布输出流,这使得客户端的数据与服务器端的数据不一致。
Linux / NVIDIA L40S
在NVIDIA L40S上,即时处理非常接近。令牌生成是指服务器之间分离:
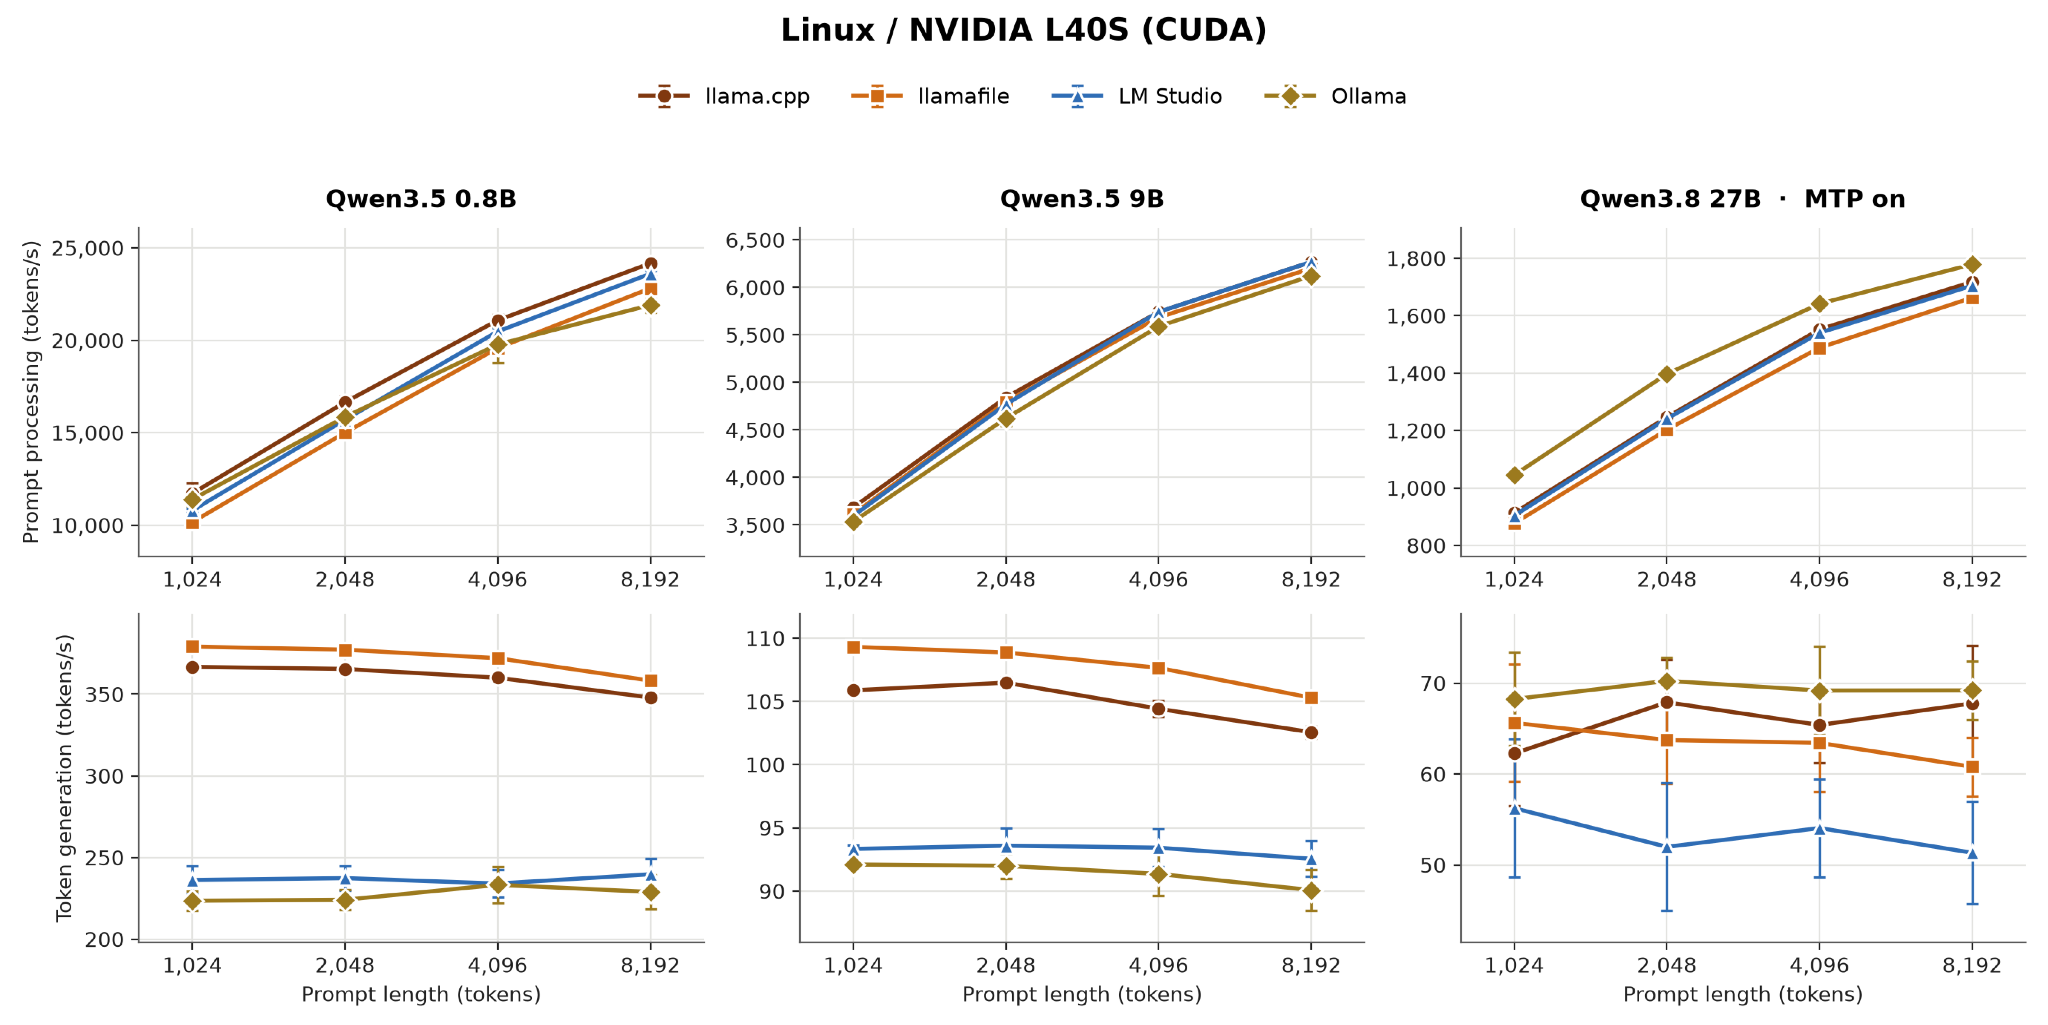
对于这种巨大差距,一种假设是主机端每个代币的成本固定,而非GPU工作量的差异。从百分比来看,快速模型上显得显著(67%),而慢模型(18%)则显得适中,但我们用每代币的毫秒数来测量绝对值,并验证了各模型几乎恒定:大约L40S的1.8毫秒,Mac上的0.4毫秒, 和Steam Deck 上的 5.4 毫秒.
这次实验也是构建标志战胜所有引擎差异的地方:在此之前,llamafile 自带的 CUDA 后端编译时没有 CUDA 图。开启 CUDA 图后,解码改进了0.8B指数+16.8%,9B指数+6.5%,27B指数+4.3%.
Mac Studio
Metal 的提示处理非常一致。三款型号中,llama.cpp、llamafile 和 Ollama 在每个提示长度的间距都在 ±% 以内。例外的是小型型号的 LM Studio,而且很可能也是固定成本。
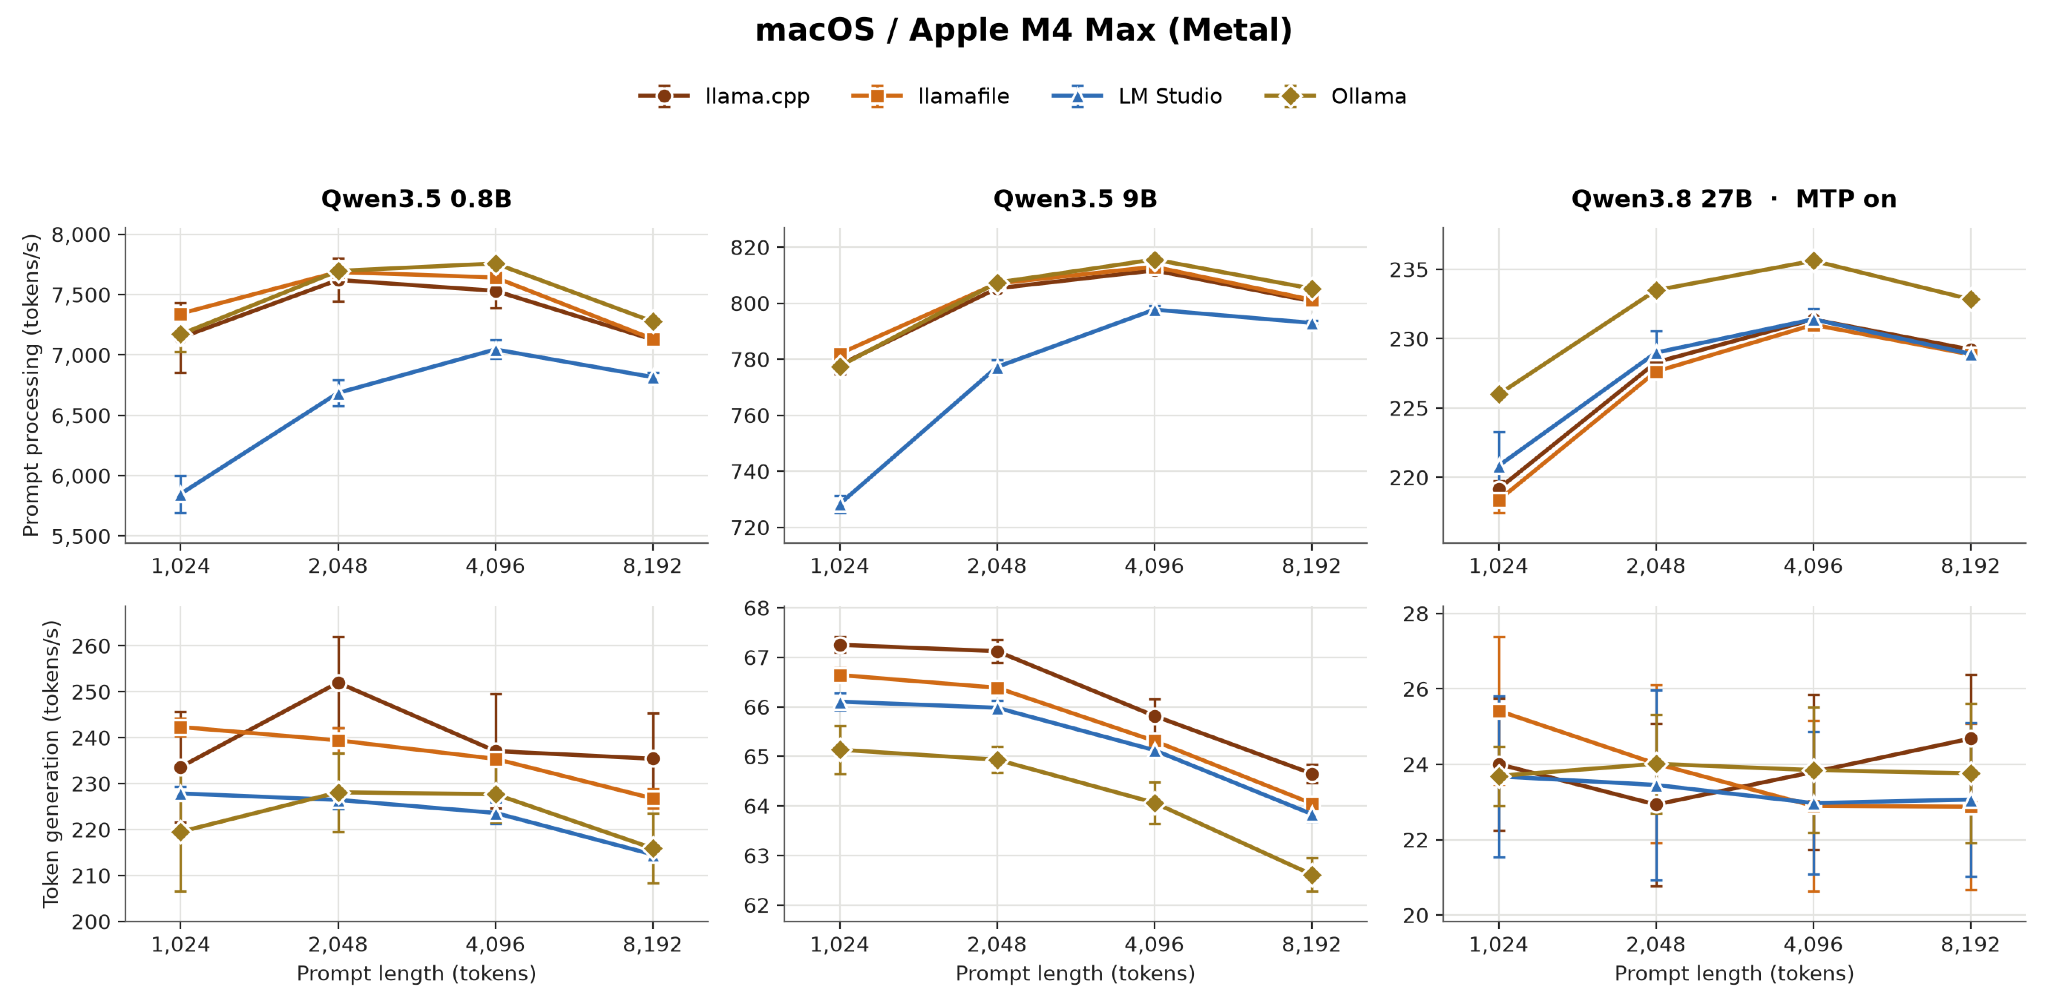
金属版也是草稿长度最关键的地方:Ollama库默认采用4个代币的推测解码,27B解码实际上更糟完全没有猜测(≈15 对 23.4 tok/s)。在第二轮选秀时,它上升到 24-25 tok/s。
L40S 的扫频率反过来也一样,也就是说,第四选秀在那方面比第二选秀多多 16%。结论是没有便携式的“最佳”设置。
Steam Deck
Deck 是所有机器中最大的扩展,几乎全部都来自着色器编译器的选择。
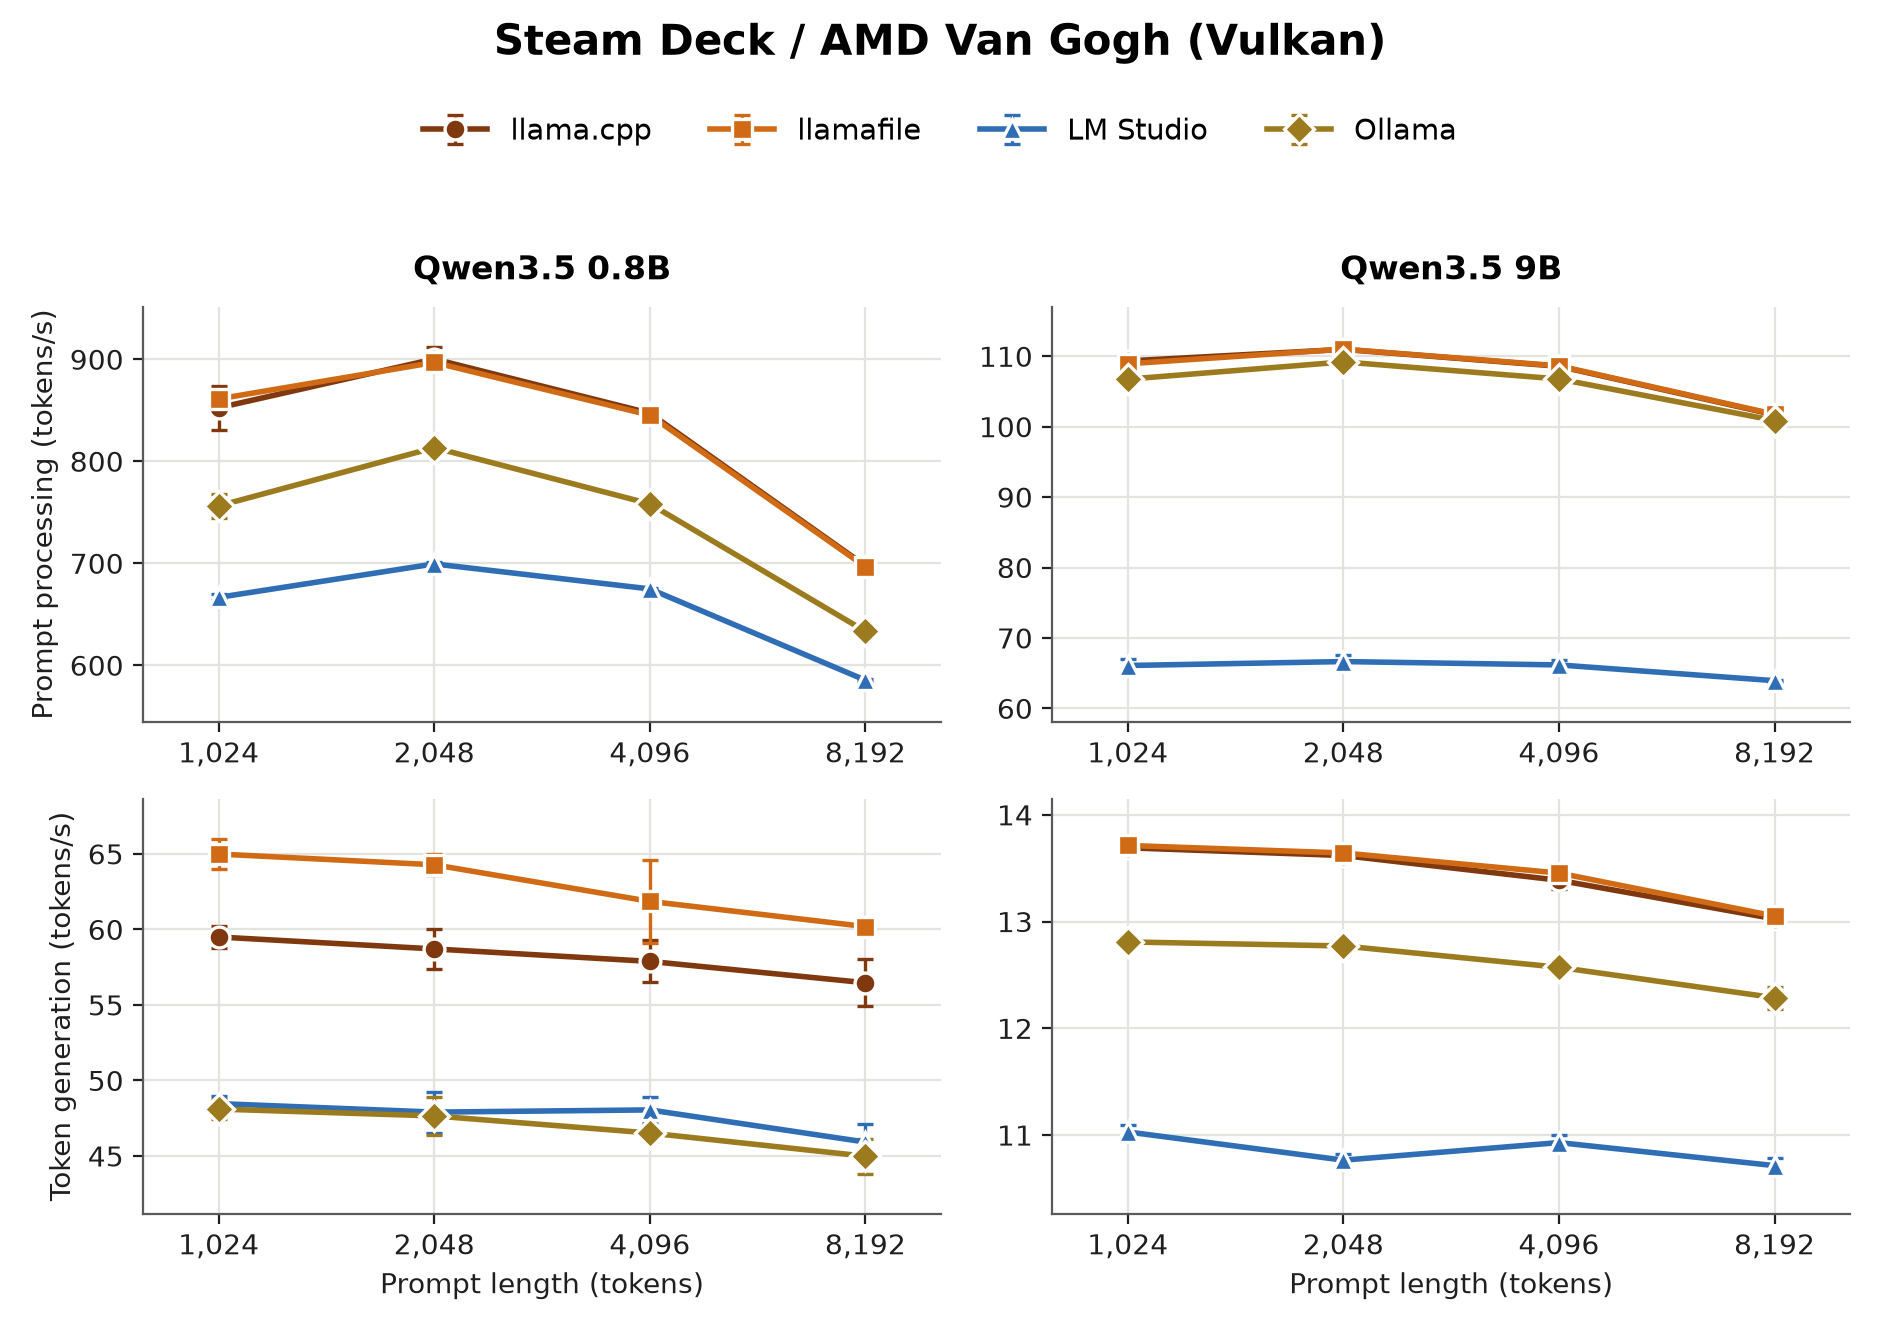
Steam Deck上的四行图;llama.cpp和llamafile负责提示处理和生成,Ollama 坐在他们下面,LM Studio 的路径最明显地体现在9B生成。
我们直接测试了这一点,而不是推断。基于同一个llamafile/llama.cpp提交,使用两个不同版本的Vulkan着色器库(Ubuntu 24.04的shaderc 2023.8 vs LunarG Vulkan SDK 2026.03),我们成功地提升了性能如下:
- 提示处理:+25.9%(0.8B),+63.3%(9B)
- 解码:+18.2%(9B),−0.6%(0.8B)
LM Studio在剧情上的不足是其已发布运行时的特性,而非引擎,且与其他版本不同,用户无法修复,因为运行时是预构建的。
为什么提示处理曲线有三种不同的形状
在解读这些图时,我们惊讶地发现,三种环境下的提示处理曲线差异很大:L40S的吞吐量随提示长度上升,Mac的吞吐量时而上升时下降,而Deck上则大多是下降。
有趣的是,这并非三种行为,而是同一曲线的三种不同视图。
模型预填充时间为t(n) = c + a·n + b·n²:固定的每次请求成本、线性项(matmuls)和二次项(注意)。吞吐量 n/t(n) 峰值在n* = 4 (c/b) √.低于这个范围,固定成本仍在摊销,吞吐量会上升;超过这个值,注意力就会占据上风。
拟合测量到的0.8亿曲线:
机器 | C(固定) | B(注意) | 峰值 N* | 关注份额在 n=8,192 |
|---|---|---|---|---|
L40S / CUDA | 52毫秒 | 0.071 ns/tok² | ~27,000 | 1.4% |
M4 Max / 金属 | 19毫秒 | 2.46 ns/tok² | ~2,800 | 14.4% |
Steam Deck / Vulkan | 288毫秒 | 70.2 ns/tok² | ~2,000 | 40.1% |
L40S的峰值是我们测试过的最长提示的三倍多,所以我们只看到上升的分支。该牌组已经有40%的注意力绑定,达到8,192个代币。
每个运行时的权重:苹果硅片上的MLX
上面所有设备都固定了砝码,这是比较发动机最公平的方式,但并不是人们通常运行这些工具的方式。在苹果硅片上,Ollama和LM Studio都能正常运行MLX(苹果自家的模型权重标准,而非 GGUF)这些版本经常被提供默认情况下除非你明确选择了GGUF变体。
因此,我们觉得也有必要展示最大型号(27B)在每个运行时对其偏好伪影的性能:
提示处理略有提升,且两者提升幅度相同:Ollama 在 1,024 个令码提示时为 +9.9%,LM Studio 为 +10.7%,8,192 个提示时则降至约 +6%,+9%。
这是比较中最干净的部分:没有混淆因素,两个运行时均约提升 10%。
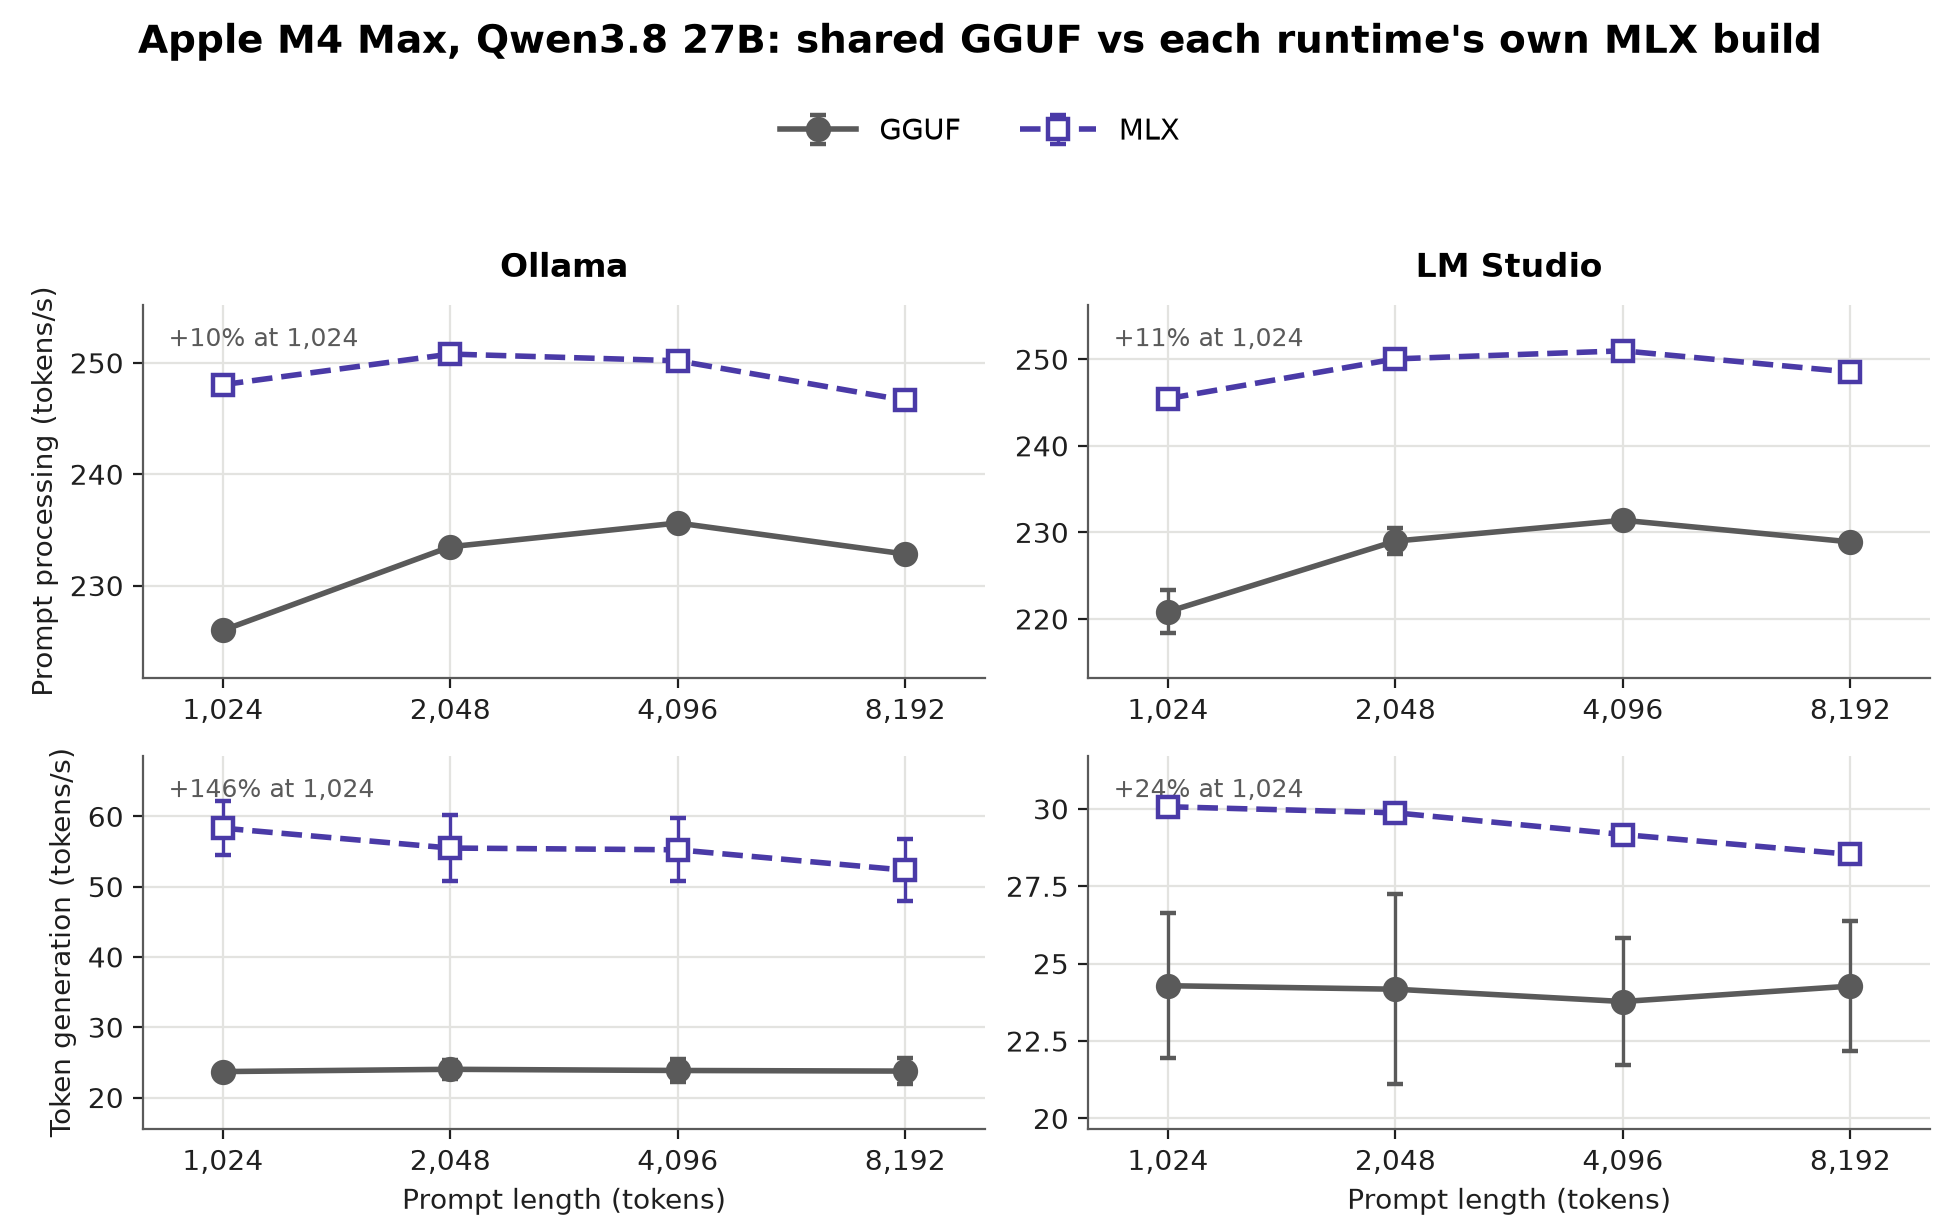
生成阶段才是有趣的地方,也就是两者不再可比的地方。这两个MLX数据之间的差距并非MLX:Ollama的MLX运行器本身依赖推测解码,具有自适应选秀深度,而LM Studio的MLX则完全不做选秀。
这些数字有两个注意事项。这些文物是重量不一样: LM Studio 的 MLX 构建是 4 位仿射,组大小为 64(15 GB),Ollama 的标签报告为 nvfp4(18.2 GB),共享的 GGUF 是 Q4_K_M(17.7 GB)。
这个实验回答的是“每个运行时默认速度有多快”,而不是“哪个引擎更快”。llama.cpp 和 llamafile 没有,因为两者都没有 MLX 路径,这本身就是一个值得权衡的事实,尤其是如果你在为 Mac 选择工具时。
这些结果在实际中的意义
没有一个放之四海而皆准的服务器,但原因比“视情况而定”更具体。控制权重、构建标志、着色器工具链和后台负载后,四个引擎在提示处理上相差不多,解码差异大多是固定的主机端每个代币成本。
推动我们数字上升数十%的是编译器标志、着色器工具链和推测解码设置。
我们的实际建议不是“对每个服务器进行基准测试”。总体来说,归结为以下建议:
- 检查一下你的服务器是怎么建的,不仅仅是哪一个。同一引擎在Deck上以两种编译方式相差1.6×。
- 将推测-解码设置匹配到平台,因为最佳价值在金属和CUDA之间切换。
- 注意你机器上还运行了什么如果你在乎你的模型性能。
- 将提示处理与生成分离,并看看你实际使用的提示时长。
一如既往,根据你需要解决的任务自行选择:对于长文档摘要,提示处理可能主导整体延迟;对于聊天或代码完成,令牌生成通常更为明显。
仅在与你部署环境相似的硬件上进行模型和服务器组合的基准测试,并记住不同配置的结果可能无法预测你的体验。
性能始于可用性
我们还在一台大约十年前的Intel MacBook Pro上尝试了这四个工具。只有llama.cpp和llamafile能在其已安装的macOS上成功运行。当前的Ollama发行版不支持其已安装的macOS版本,尽管Ollama为Intel Mac提供了从源代码构建的路径。
LM Studio当前的macOS版本支持Apple Silicon,但不支持Intel Mac。(Ollama 发展指南,LM Studio的需求)
这是兼容性检查,而非性能可比运行,因此未包含在吞吐量结果中。但它强调了另一个重要区别:llama.cpp 和 llamafile 保留了一条 CPU 路径,可以在更新的 GPU 应用无法使用时保持旧硬件的实用性。
局限性
这些结果比较的是实际设置,而非完美控制的后端实现,因此有一些注意事项。
报告的数字被裁剪。每个点是14次热身后运行中中间10个的平均值,去除最快的2个和最慢的两个;误差条是所有14个的标准差。修剪稳定了中心估计值,但隐藏了尾部,因此图表低估了偶尔出现的异常值。
时序是客户端的,只有一个例外。LM Studio 在 macOS 上的解码是基于引擎自身的时序来测量的,因为它在那里是以突发方式发布输出,客户端数据与服务器端数据不一致。
因此,这一系列的测量方式与其他系列不同。
基准测试衡量服务器运行后的吞吐量。尚未测量首次令牌时间、端到端延迟、模型加载时间、内存使用、功耗或并发请求。这些因素可能会改变实际排名。
LM Studio和Ollama配置中的高变异性也值得进一步研究。特别是,L40S的短发电和长发电测试有时会产生不同的速率,而llama.cpp和llamafile则相对稳定。
接下来会发生什么
下一轮应包括Windows以及额外的macOS和Linux硬件。我们还希望将测量范围扩展到吞吐量之外,包括首次令牌时间、模型加载和启动时间、内存和功耗等指标。
最后,这些测试仅涵盖Qwen家族。Llama、Gemma、Mistral及专家混合模型的结果将有助于区分一般服务器行为与模型特有效应。
结论
该基准测试最清晰的结果也是最不光鲜的。所有服务器都以某种方式建立在llama.cpp之上,因此引擎只有在为特定平台或模型带来临时优化时才能领先(如Llamfile 是的对于CPU推断,MLX金属的 does 或《黑暗之魂4》对于少数临时模型,确实如此)。
除此之外,推动我们数字增长10%的是配置:编译器标志、着色器工具链、推测解码设置。
更广泛的结论比任何个人胜利都更重要:本地LLM的性能取决于模型、工作负载和平台。有用的比较必须将提示处理与令牌生成分开,报告方差,记录环境,并避免将结果归入一个评分。
它应少关注什么引擎表现最好,试着接听为什么这种情况会发生。
该讲解骆驼本奇Tool为重复这些测试并扩展到更多硬件、模型和操作系统提供了基础。
Moz AI团队对四台本地LLM服务器——llama.cpp、llamafile、LM Studio和Ollama进行了测试,分别覆盖Mac、Steam Deck和NVIDIA主机,以确定哪一台更快。
事实证明,这个问题本来就不该问。一旦他们稳住模型和机器,四台服务器的距离都只剩几个百分点,因为它们在底层运行的是同一个llama.cpp核心。
真正推动数字的不是服务器选择。而是它的构建方式。我们在llamafile中遗漏的一个编译器标志让我们损失了17%。Steam Deck上一个更新的图形工具链帮我们买了60%。
代码相同,构建不同,波动巨大。
给本地运行模型的人的结论是:别再纠结用哪个工具了,开始检查它是如何编译的。完整数据、三台机器和我们发布的修复都在帖子里。
链接在下面。