oMLX:Apple Silicon 上的 LLM 推理服务器,支持连续批处理与 SSD 缓存
支持 Apple Silicon 的 LLM 推理服务器,支持连续批处理和 SSD 缓存——通过 macOS 菜单栏管理
oMLX
LLM推理,针对你的Mac优化
连续批处理和分级KV缓存,直接从菜单栏管理。
junkim.dot@gmail.com ·https://omlx.ai/me
安装·快速入门·特色·模型·CLI 配置·基准测试·oMLX.ai
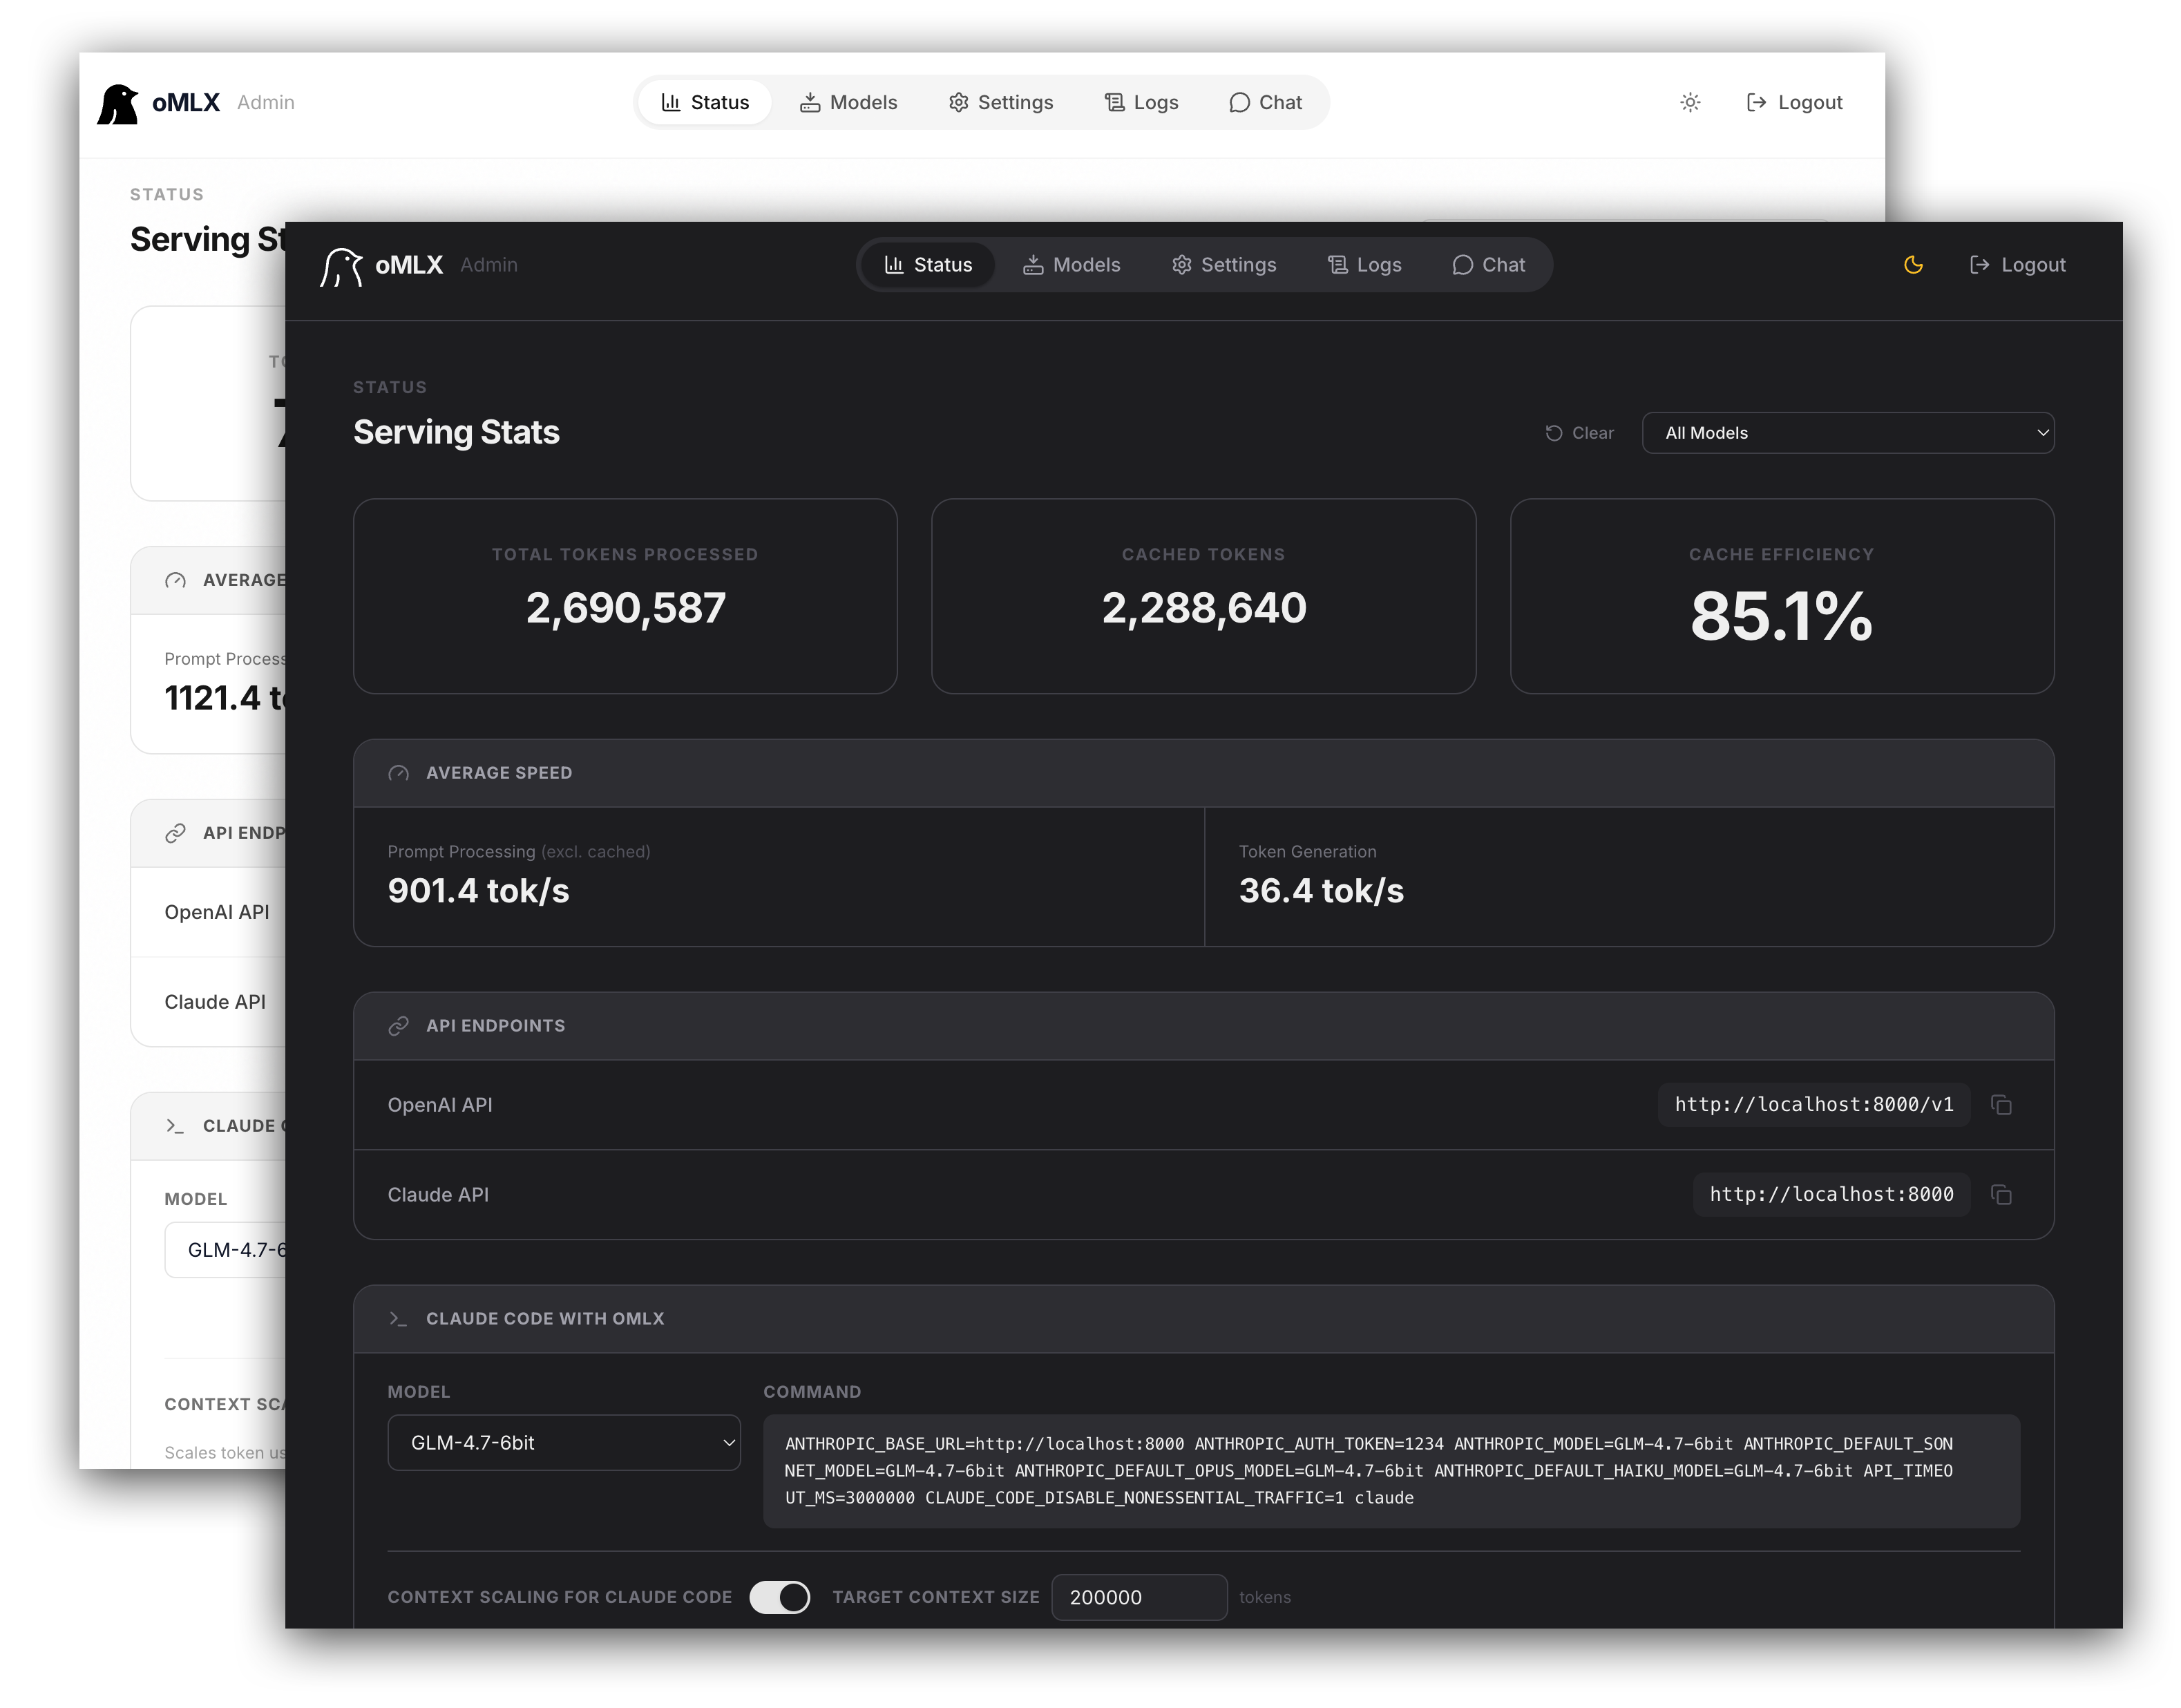
我尝试过的每一个大型语言模型服务器都让我在便利和控制之间做出选择。我想把日常模型钉在内存里,按需自动替换较重的模型,设置上下文限制——并且所有这些都通过菜单栏来管理。 oMLX 在热内存层和冷 SSD 层之间持久化 KV 缓存——即使上下文在对话中途发生变化,所有过去上下文仍保持缓存并可跨请求重用,使得本地大型语言模型在实际编程中可通过 Claude Code 等工具实现实用。这就是我建造它的原因。
安装
macOS 应用
下载.dmg来自发行作品,拖到应用,完成。应用内置自动更新功能,未来升级只需一键。macOS应用还安装了轻量级~/.omlx/bin/omlxCLI shim 让终端命令和 Apple 快捷方式可以控制应用管理的服务器。
自制内容
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx

# Upgrade to the latest version
brew update && brew upgrade omlx

# Run as a background service (auto-restarts on crash)
omlx start

# Optional: MCP (Model Context Protocol) support
/opt/homebrew/opt/omlx/libexec/bin/pip install mcp
可选的 GLM-5.2 / MiniMax M3 原生自定义内核目前需要 HEAD 构建:
brew install jundot/omlx/omlx --HEAD --with-custom-kernel
来源
git clone https://github.com/jundot/omlx.git
cd omlx
pip install -e .          # Core only
pip install -e ".[mcp]"   # With MCP (Model Context Protocol) support

# GLM-5.2 / MiniMax M3 / Qwen3.5 native custom kernels (strongly recommended
# if you serve those families -- see note below)
OMLX_WITH_CUSTOM_KERNEL=1 pip install -e .
需要macOS 15.0+(红杉)、Python 3.11–3.13和Apple Silicon(M1/M2/M3/M4)。
关于原生自定义内核的说明:一片平原pip install -e .不构建它们,受影响的型号系列随后默然退回更慢的通用路径——对于GLM-5.2,融合后的DSA预填充与内核约快30倍(测量为845倍,而M3 Ultra为约29 tok/s),且备援也占用更多内存(#2137)。构建它们需要 Metal 工具链,而命令行工具本身无法提供这些功能 (xcrun: error: unable to find utility "metal"安装完整的 Xcode,或使用官方 DMG,后者内核已预编译。自制内容可以建造它们brew install jundot/omlx/omlx --HEAD --with-custom-kernel但那个版本也需要完整的Xcode。验证你的安装情况:python -c "from omlx.custom_kernels import native_kernel_status; print(native_kernel_status())"
快速入门
macOS 应用
从你的应用程序文件夹启动oMLX。欢迎界面会引导你完成三个步骤——模型目录、服务器启动和首次模型下载。就这样。要连接OpenClaw、OpenCode、Codex、Hermes代理或Copilot,请参见集成.
CLI
# Managed background server (macOS app or Homebrew install)
omlx start
omlx stop
omlx restart

# Foreground server attached to this terminal
omlx serve --model-dir ~/models
服务器会自动从子目录中发现LLM、VLM、嵌入模型和重新排序器。任何兼容 OpenAI 的客户端都可以连接到http://localhost:8000/v1.内置聊天界面也可在以下网站提供http://localhost:8000/admin/chat.
自酿服务
如果你通过 Homebrew 安装,可以作为托管的后台服务运行 oMLX:
omlx start                    # Start via brew services
omlx stop                     # Stop
omlx restart                  # Restart

brew services start omlx    # Start (auto-restarts on crash)
brew services stop omlx     # Stop
brew services restart omlx  # Restart
brew services info omlx     # Check status
该服务运行omlx serve零配置默认值(~/.omlx/models,端口8000)。omlx start,omlx stop, 和omlx restart是可移植生命周期命令;自制安装 委派给brew services.自定义时,可以设置环境变量(OMLX_MODEL_DIR,OMLX_PORT,等等)或者跑omlx serve --model-dir /your/path一次是将设置保持为~/.omlx/settings.json.
日志写入两个地点:
- 服务日志:
$(brew --prefix)/var/log/omlx.log(stdout/stderr) - 服务器日志:
~/.omlx/logs/server.log(结构化应用日志)
特色
支持文本大型语言模型(LLM)、视觉语言模型(VLM)、OCR模型、嵌入和重新排序器,适用于苹果硅片。
管理仪表盘
网页界面/admin用于实时监控、模型管理、聊天、基准测试及按车型设置。支持英语、韩语、日语、中文、法语、俄语、西班牙语和巴西葡萄牙语。
所有 CDN 依赖均由供应商提供完全离线运行。

实验性多MAC推断
源代码构建可以通过 MLX 管道排名在 Ring 或 Thunderbolt RDMA/JACCL 上将一个下载的语言模型分割到内存不等的 Mac 上。集群仪表盘负责只读对等发现、严格的SSH/运行时验证、字节感知的不等分片规划、测量计算/链路重新平衡、余量感知的执行调优、激活,以及两台Mac上的实时分片/性能映射。
交互式、平衡型和吞吐量配置文件揭示了融合批处理、提示缓存亲和性、旋转KV限制、环连接调优以及能力门控实验性仅令牌输出路径。
参见跨 Mac 的分布式推理用于设置、安全边界、当前限制以及物理硬件验证检查表。
视觉语言模型
运行VLM时,采用与文本LLM相同的连续批处理和分层KV缓存栈。支持多图像聊天、base64/URL/文件图像输入,以及带视觉上下文的工具调用。
OCR模型(DeepSeek-OCR、DOTS-OCR、GLM-OCR)通过优化提示自动检测。
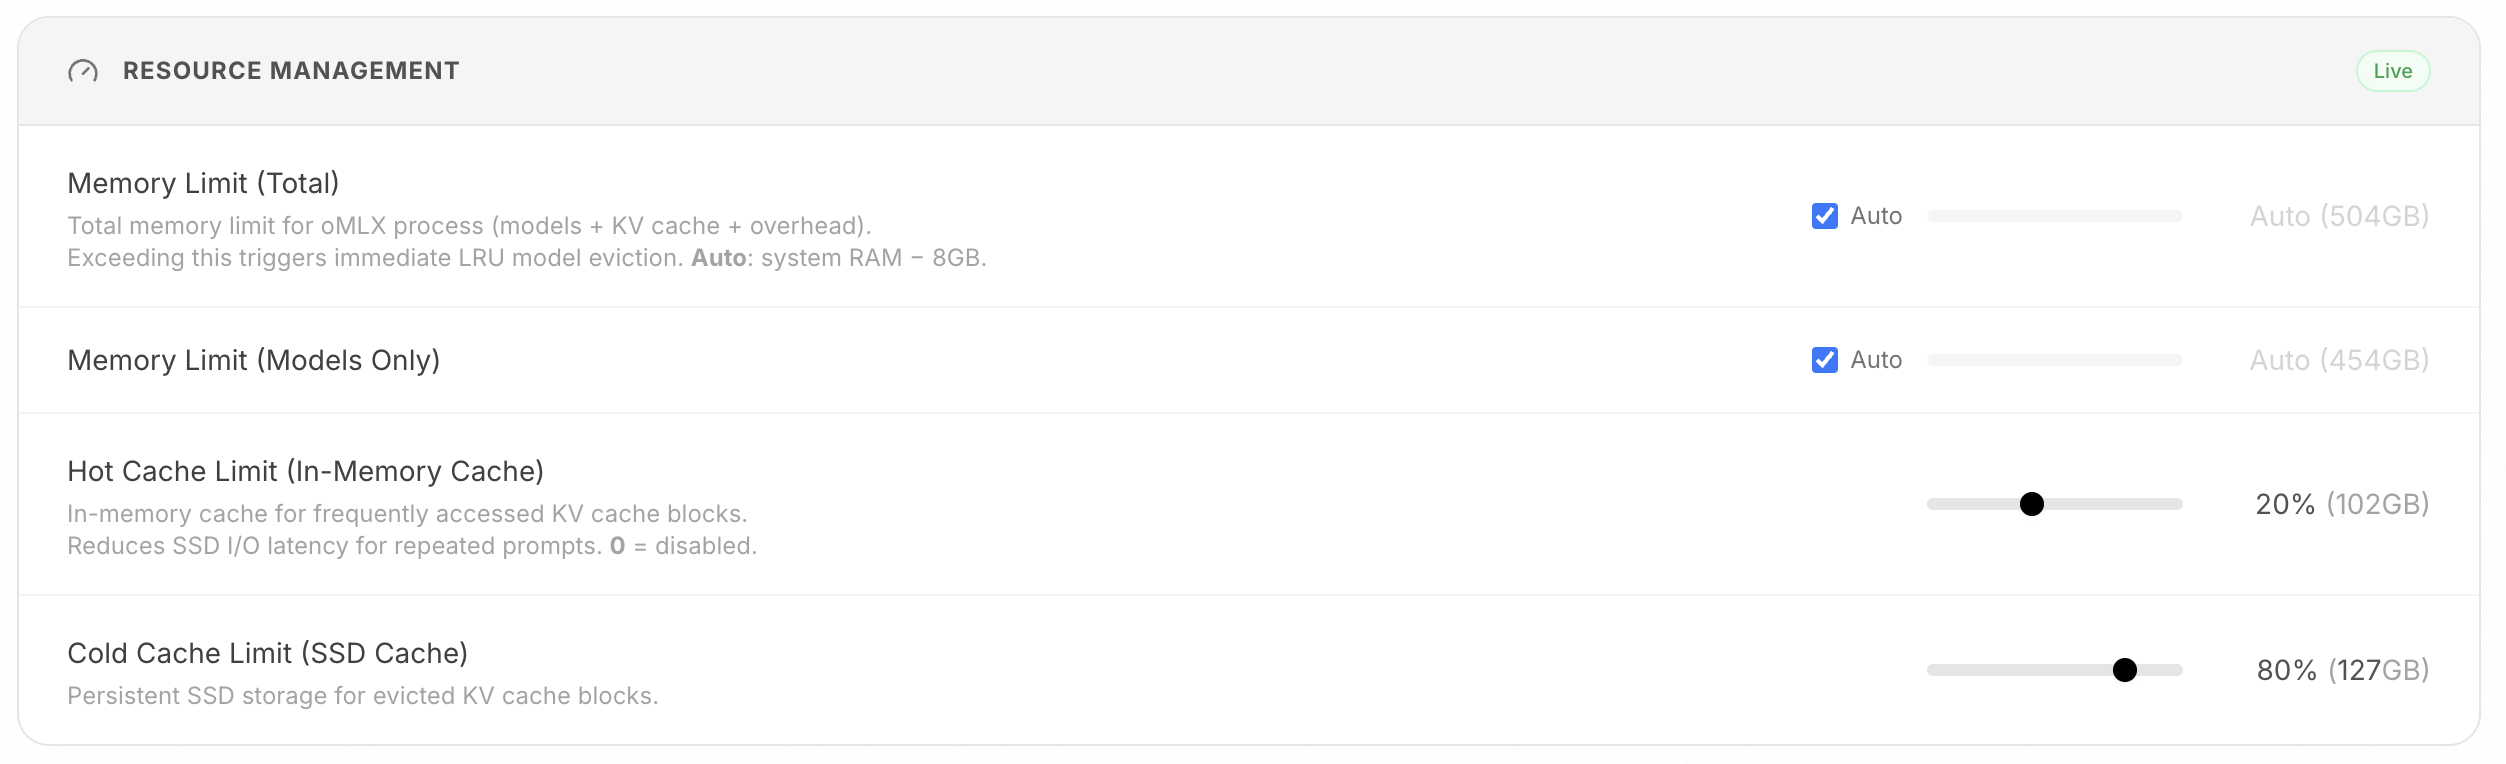
分层KV缓存(热+冷)
基于块的KV缓存管理,灵感来自vLLM,支持前缀共享和写时复制。该缓存分为两个层级:
- 热级(内存):频繁访问的块会保留在内存中以便快速访问。
- 冷级(SSD)当热缓存满时,块会以安全张量格式卸载到SSD。下一次请求前缀匹配时,这些请求会从磁盘恢复,而不是从头重新计算——即使服务器重启后也是如此。
连续批次处理
通过 mlx-lm 的 BatchGenerator 处理并发请求。最大并发请求可以通过CLI或管理面板配置。
Claude 代码优化
支持使用 Claude Code 运行较小上下文模型的上下文缩放。Scale报告令牌计数,使自动压缩触发器在正确时机触发,SSE保持活着防止长时间预填充时的读取超时。
多模型服务
在同一服务器内加载LLM、VLM、嵌入模型和重排序器。模型通过自动和手动控制相结合的方式进行管理:
- LRU驱逐:当内存不足时,最不常用的模型会自动被淘汰。
- 手动装卸: 管理面板中的互动状态徽章允许你按需加载或卸载模型。
- 模型钉扎Pin 经常使用模型来保持它们始终加载。
- 按模型的TTL:为每个模型设置空闲超时,在一段时间不活动后自动卸载。
- 进程内存强制: 总内存限制(默认:系统内存 - 8GB)防止系统范围的 OOM。
按型号设置
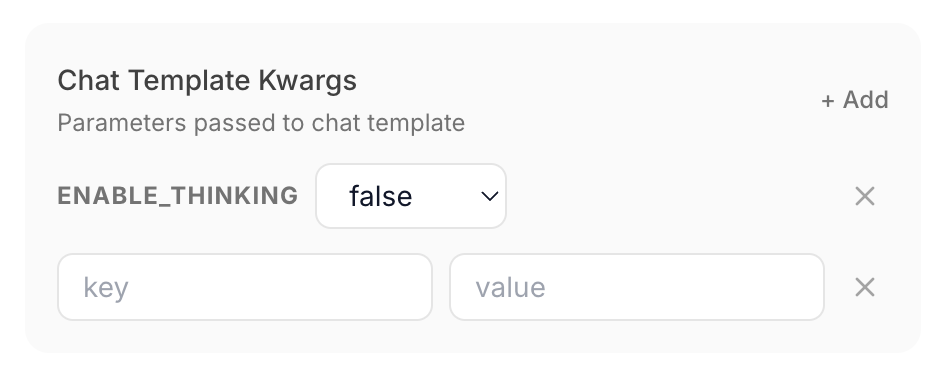
直接在管理面板中配置采样参数、聊天模板kwargs、TTL、模型别名、模型类型覆盖等。更改会立即生效,无需重启服务器。
- 型号别名: 设置一个自定义API可见名称。
/v1/models返回别名,请求同时接受别名和目录名。 - 模型类型覆盖:手动将模型设置为LLM或VLM,无论是否自动检测。
- 简介:保存每个模型的命名捆绑包,并在管理面板中切换。配置文件也可以选择性地作为独立模型曝光:
/v1/models还有列表:(例如:qwen3-8b:thinking),该配置与基础型号共用同一引擎,配置文件设置是按请求叠加的——没有额外内存,无需重新加载。当基础型号带有别名时,暴露的ID会被宣传为:;目录名称表单依然正常,就像基础模型一样。
内置聊天
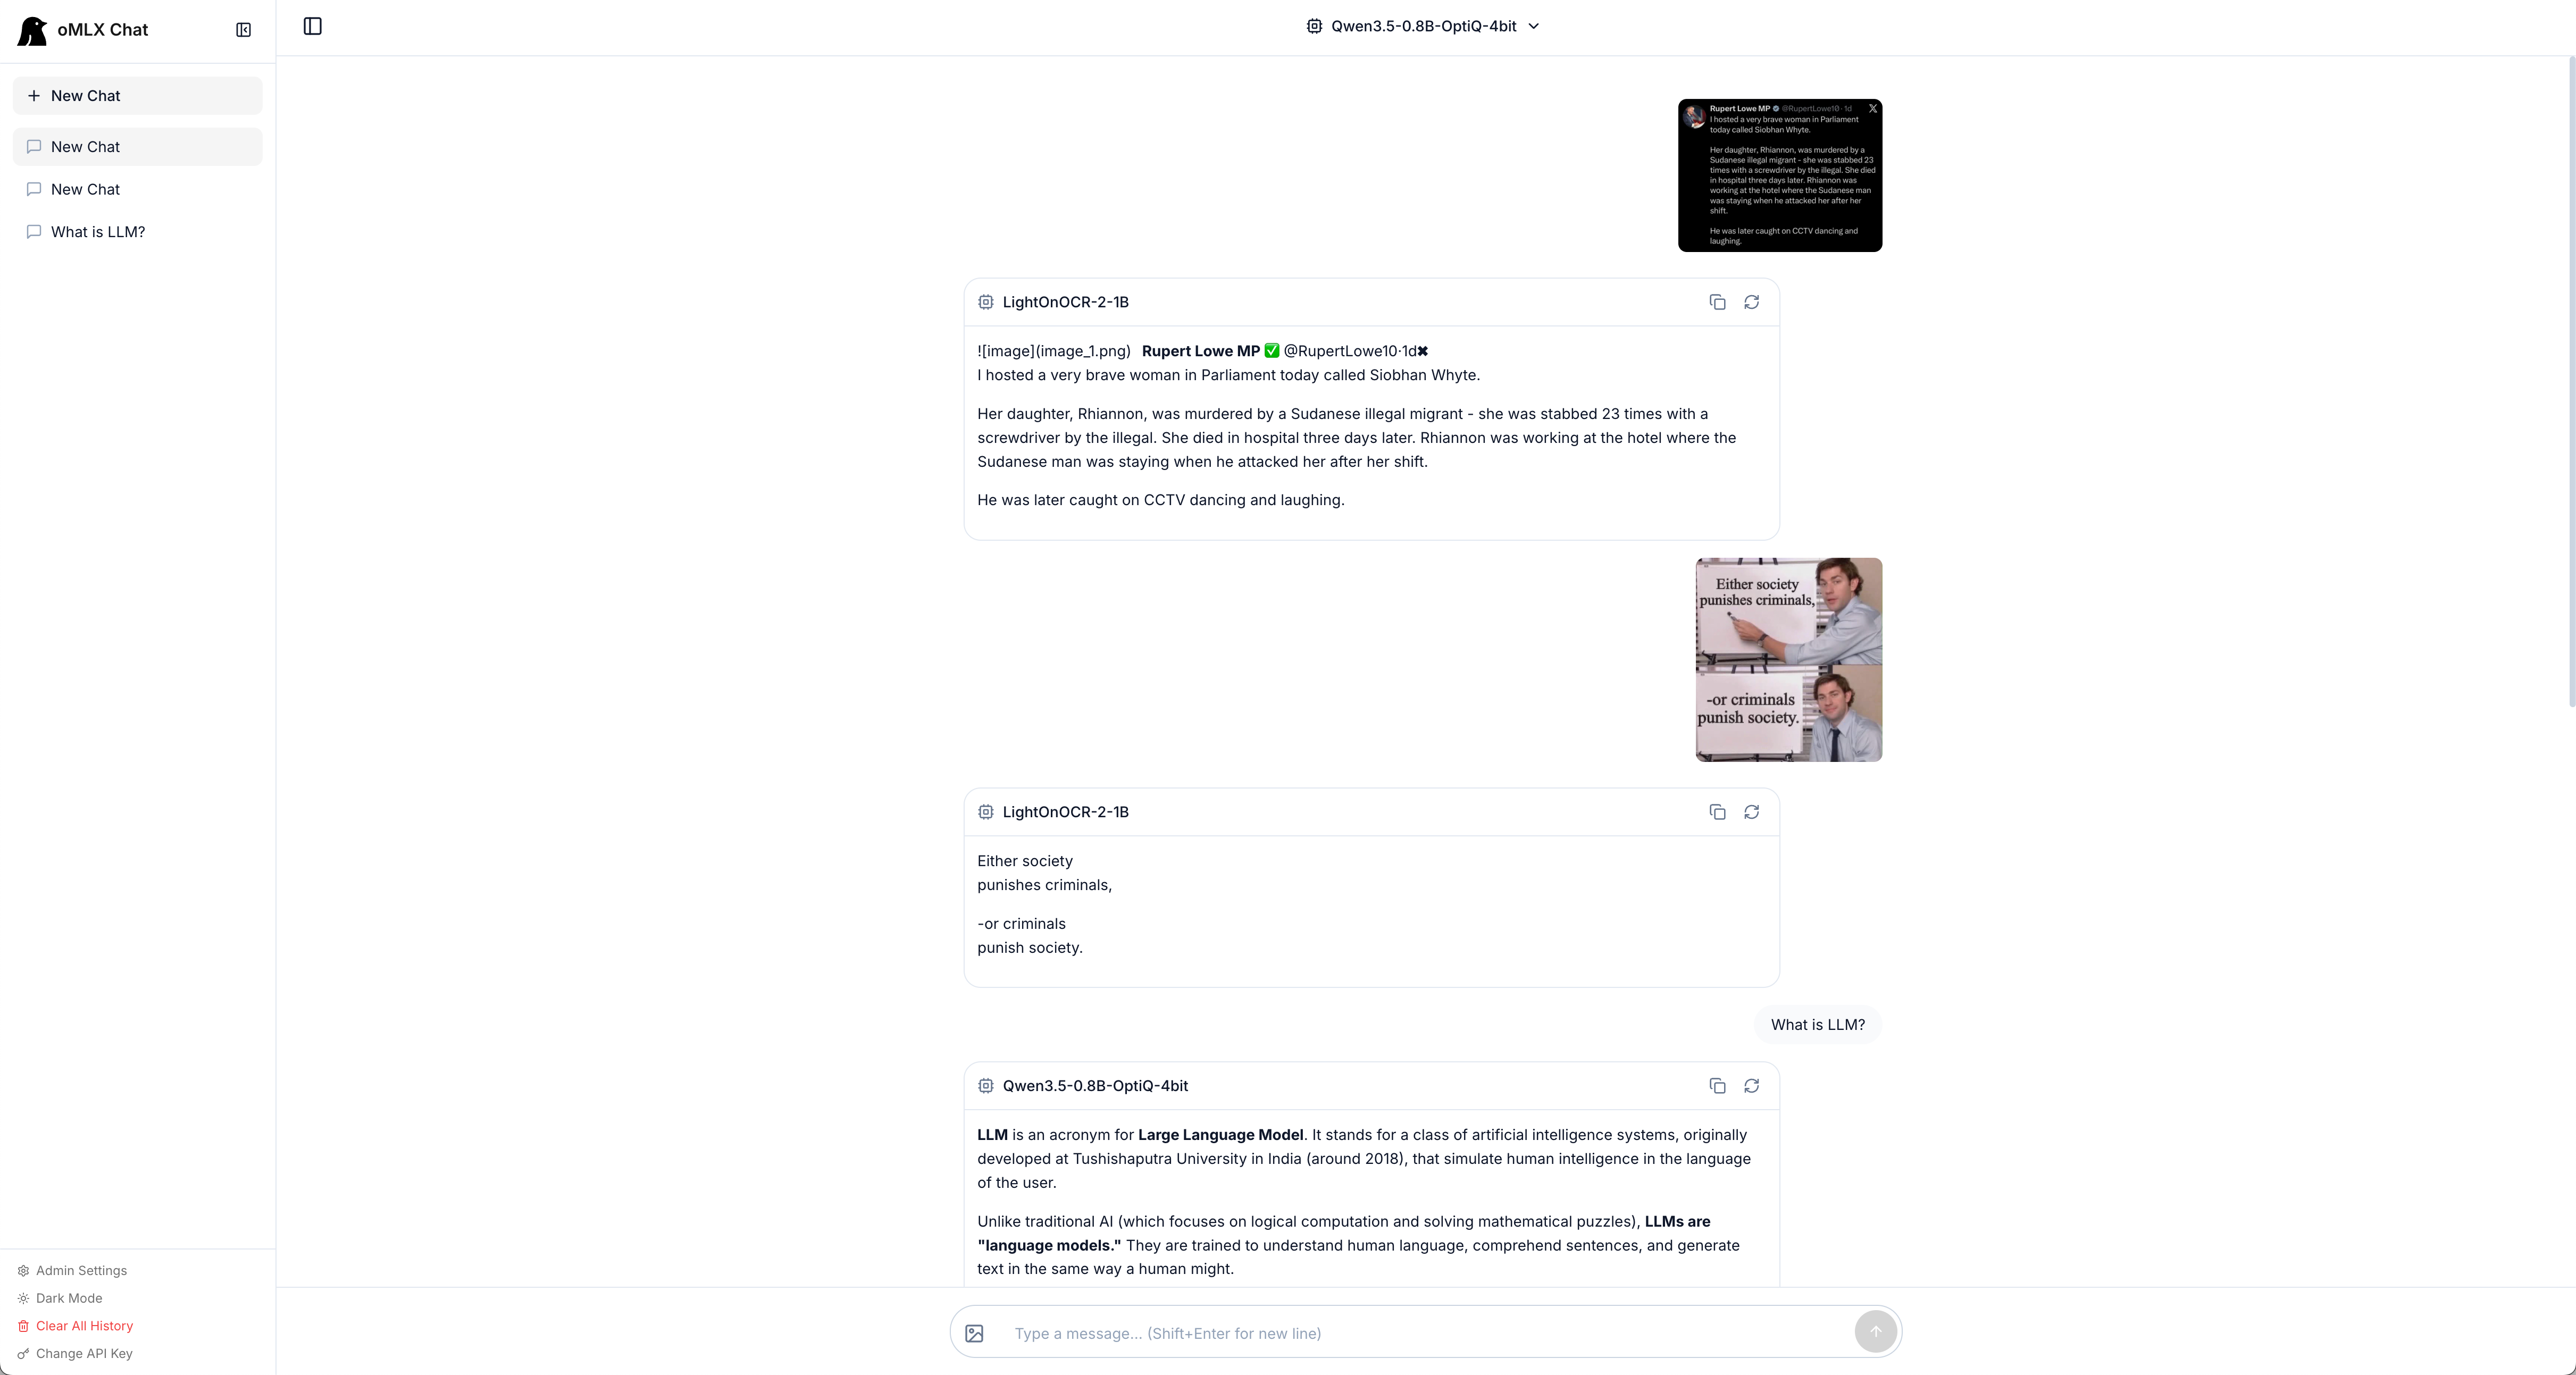
直接在管理面板与任何已加载的模型聊天。支持对话历史、模型切换、暗黑模式、推理模型输出以及VLM/OCR模型的图像上传。
模型下载器
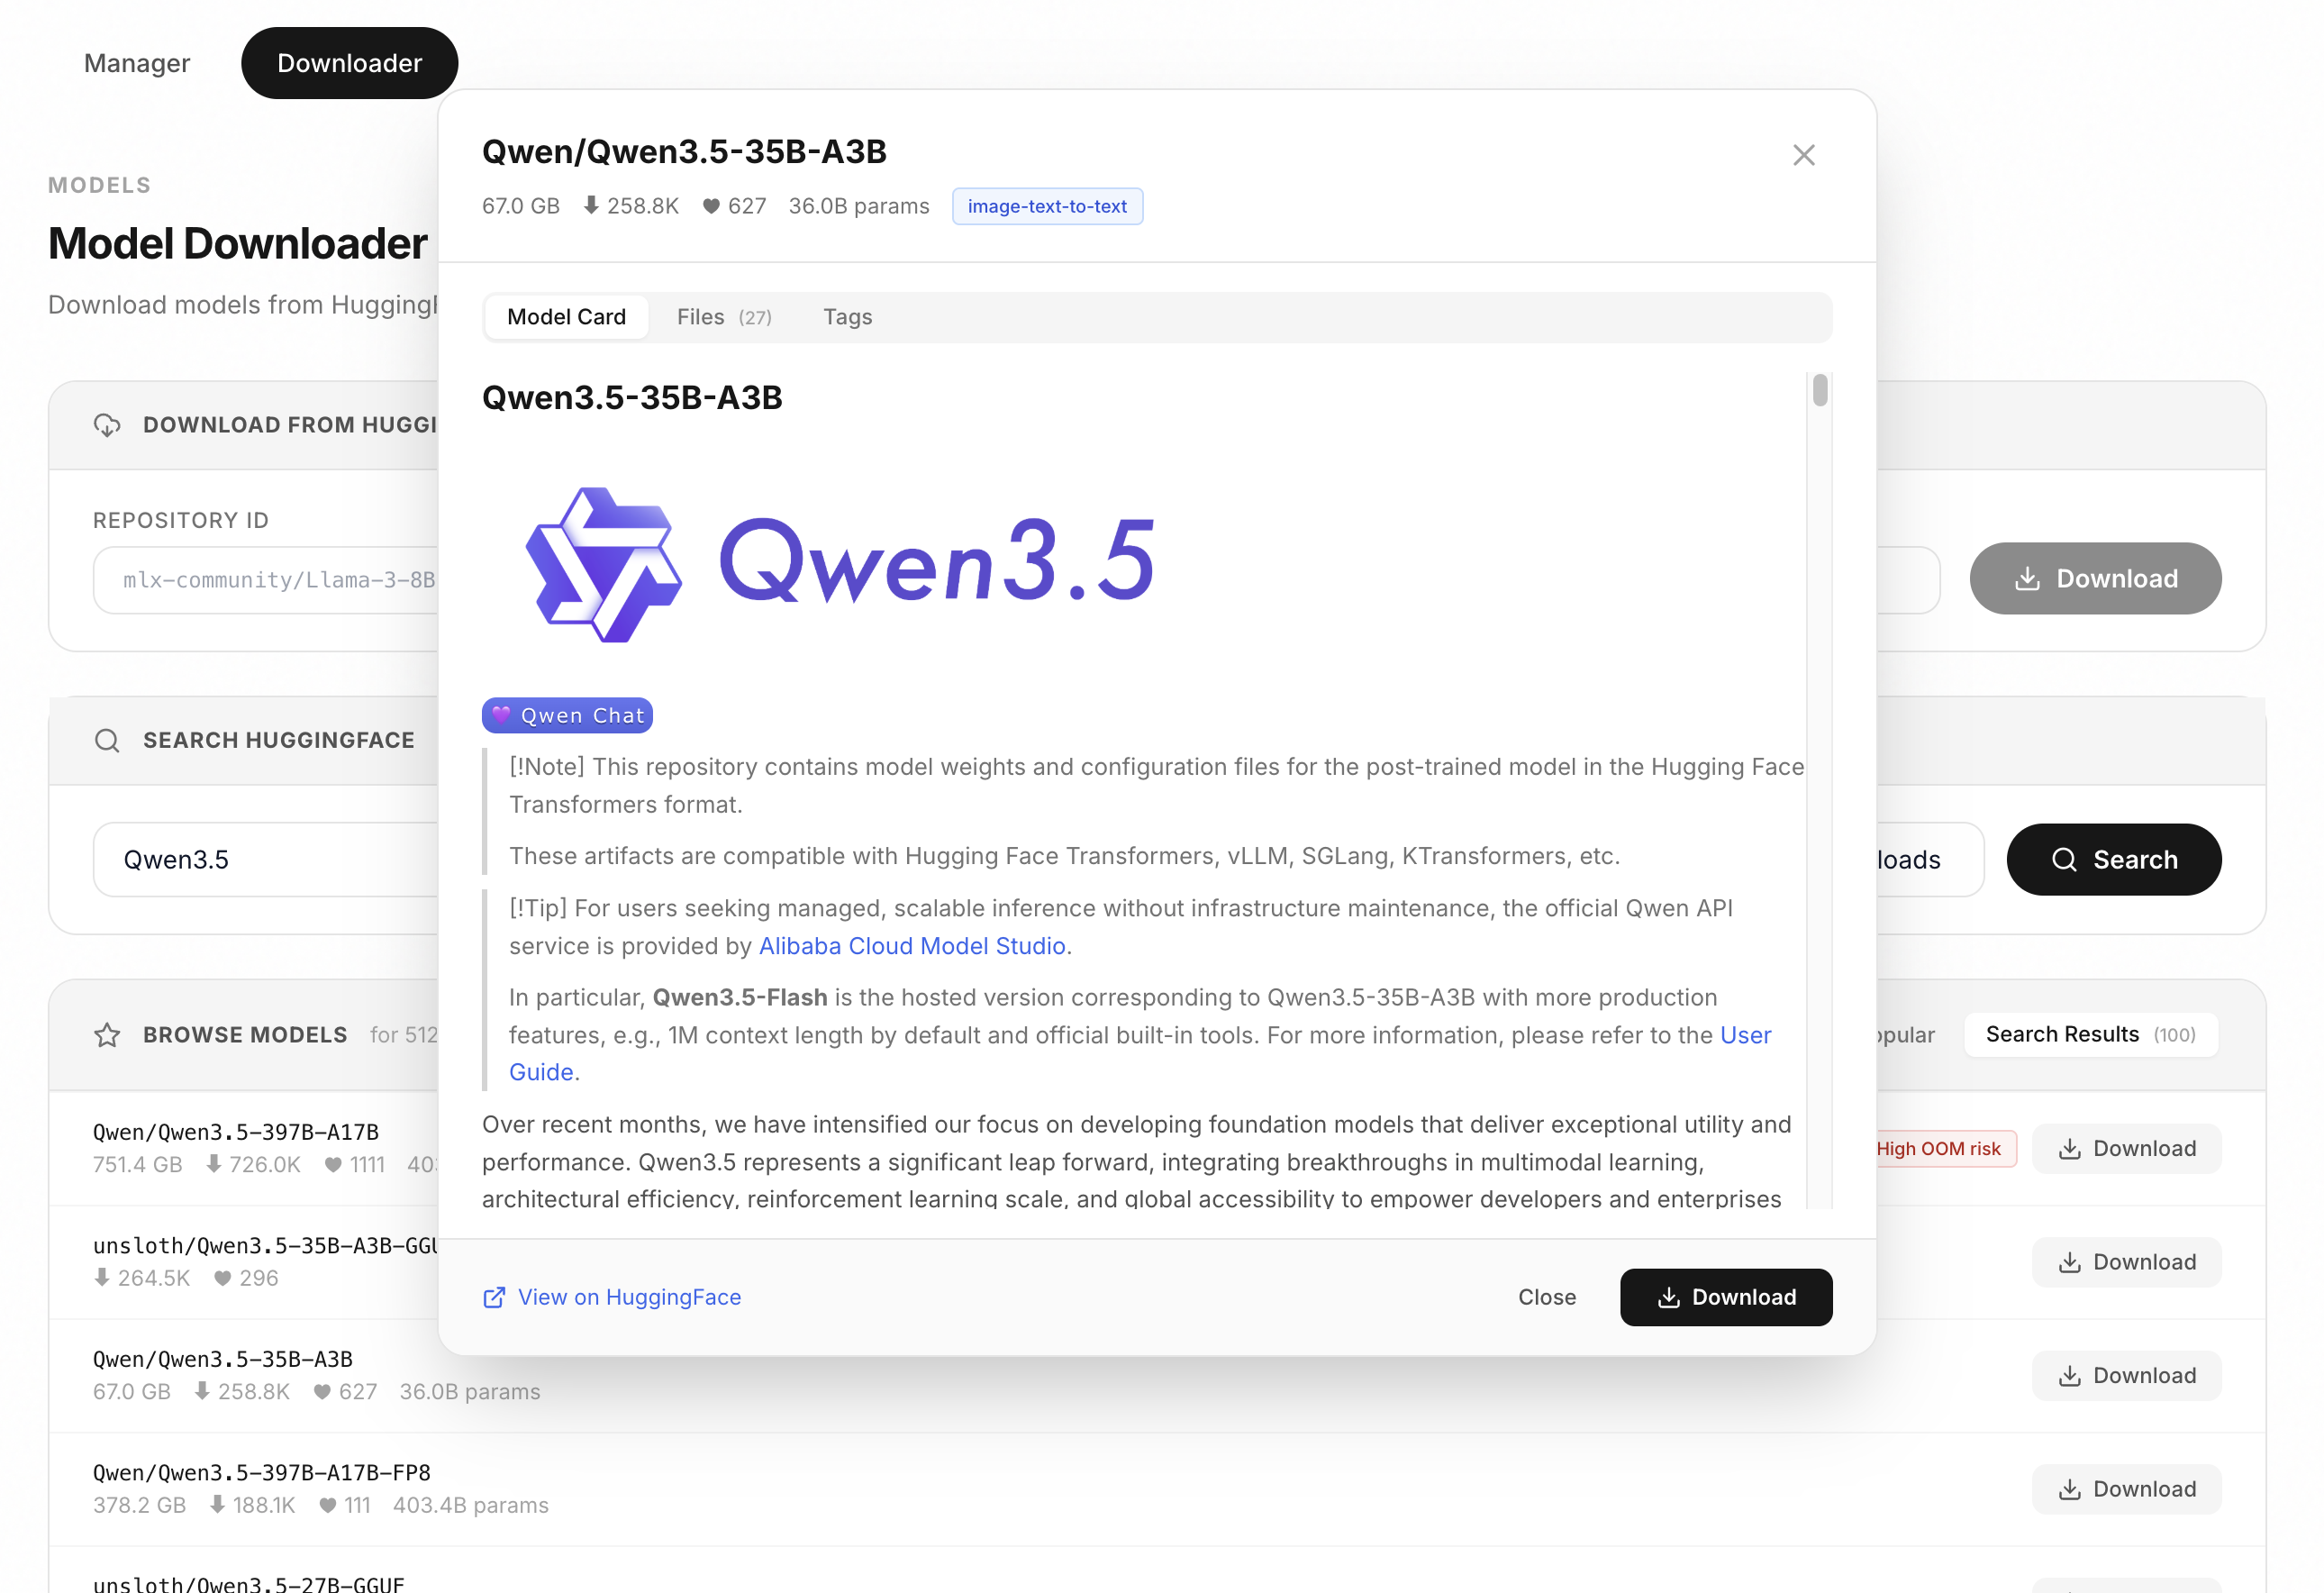
在管理后台直接从 HuggingFace 搜索并下载 MLX 模型。浏览模型卡,检查文件大小,一键下载。
集成
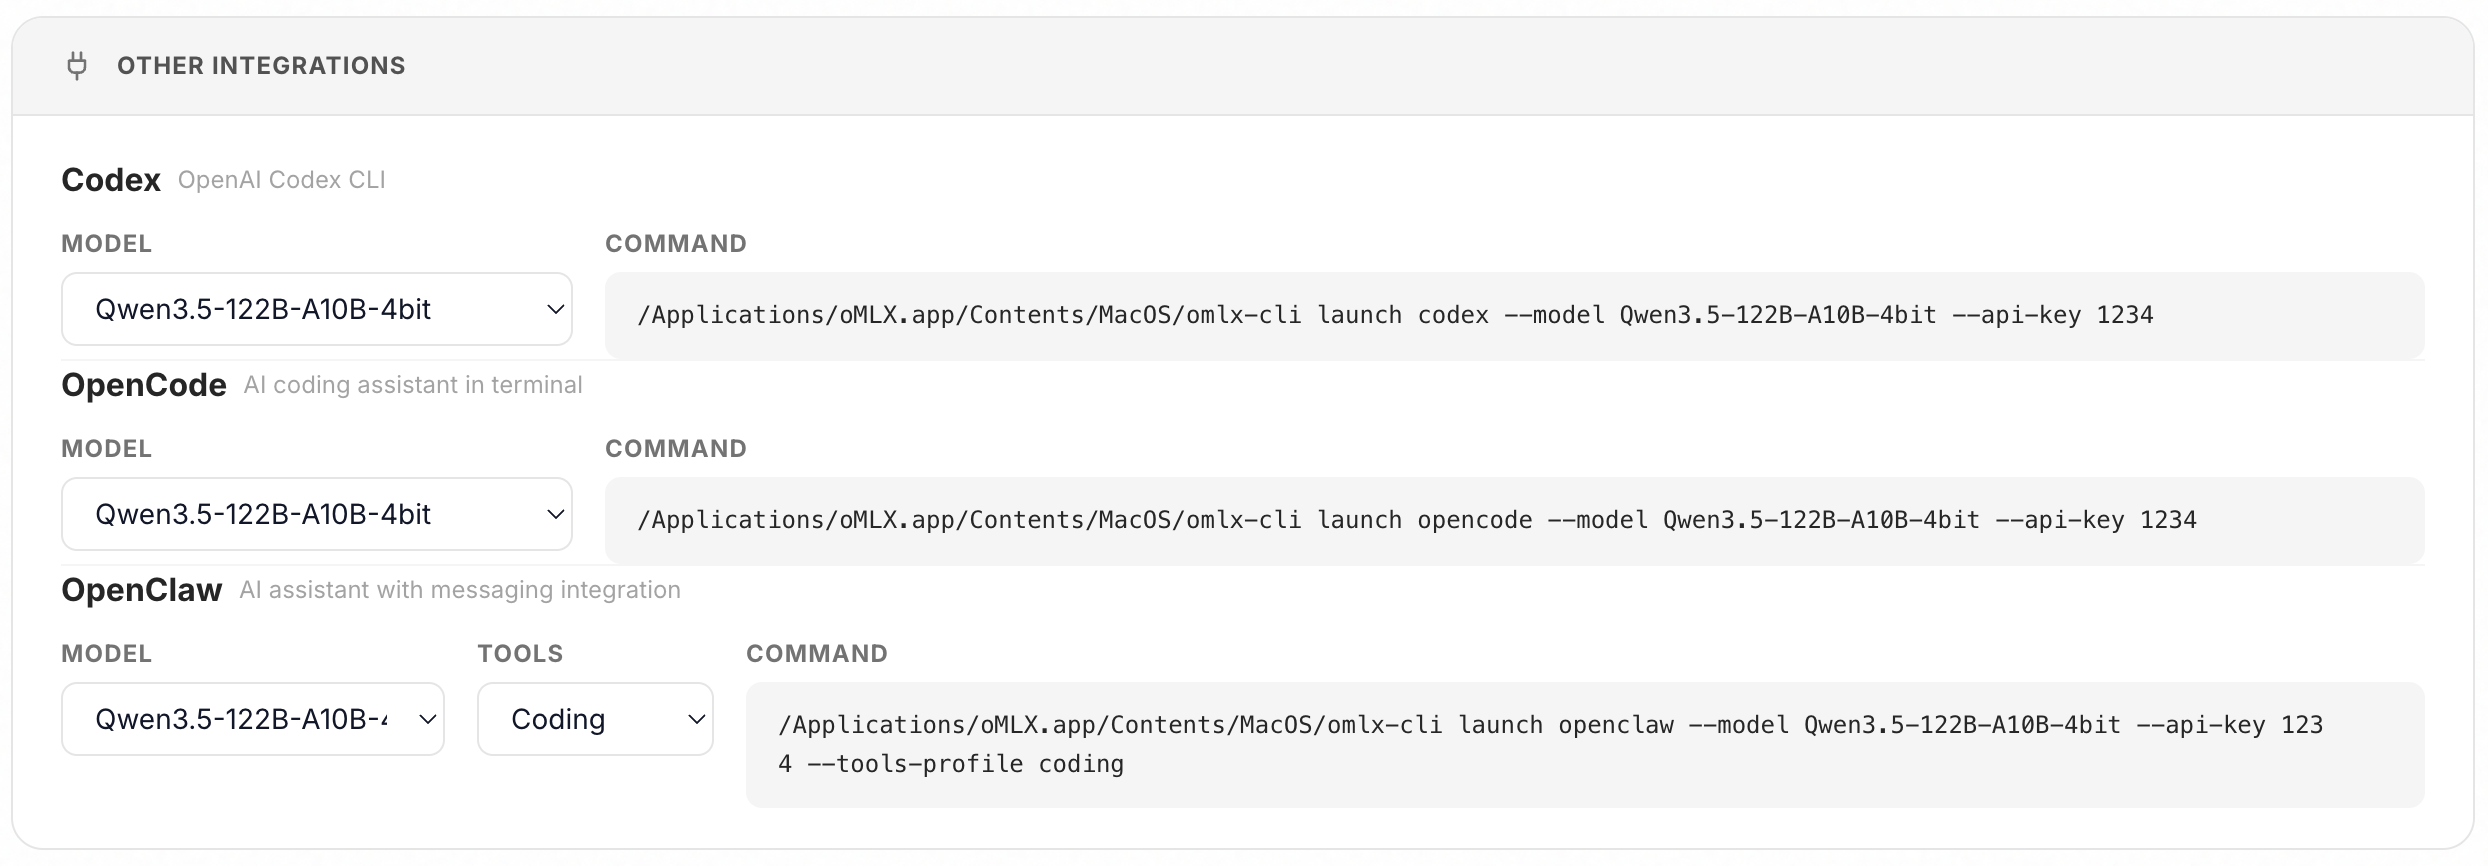
只需一键,即可直接在管理仪表盘设置OpenClaw、OpenCode、Codex、Hermes Agent、Copilot和Pi。不需要手动编辑配置。
性能基准测试
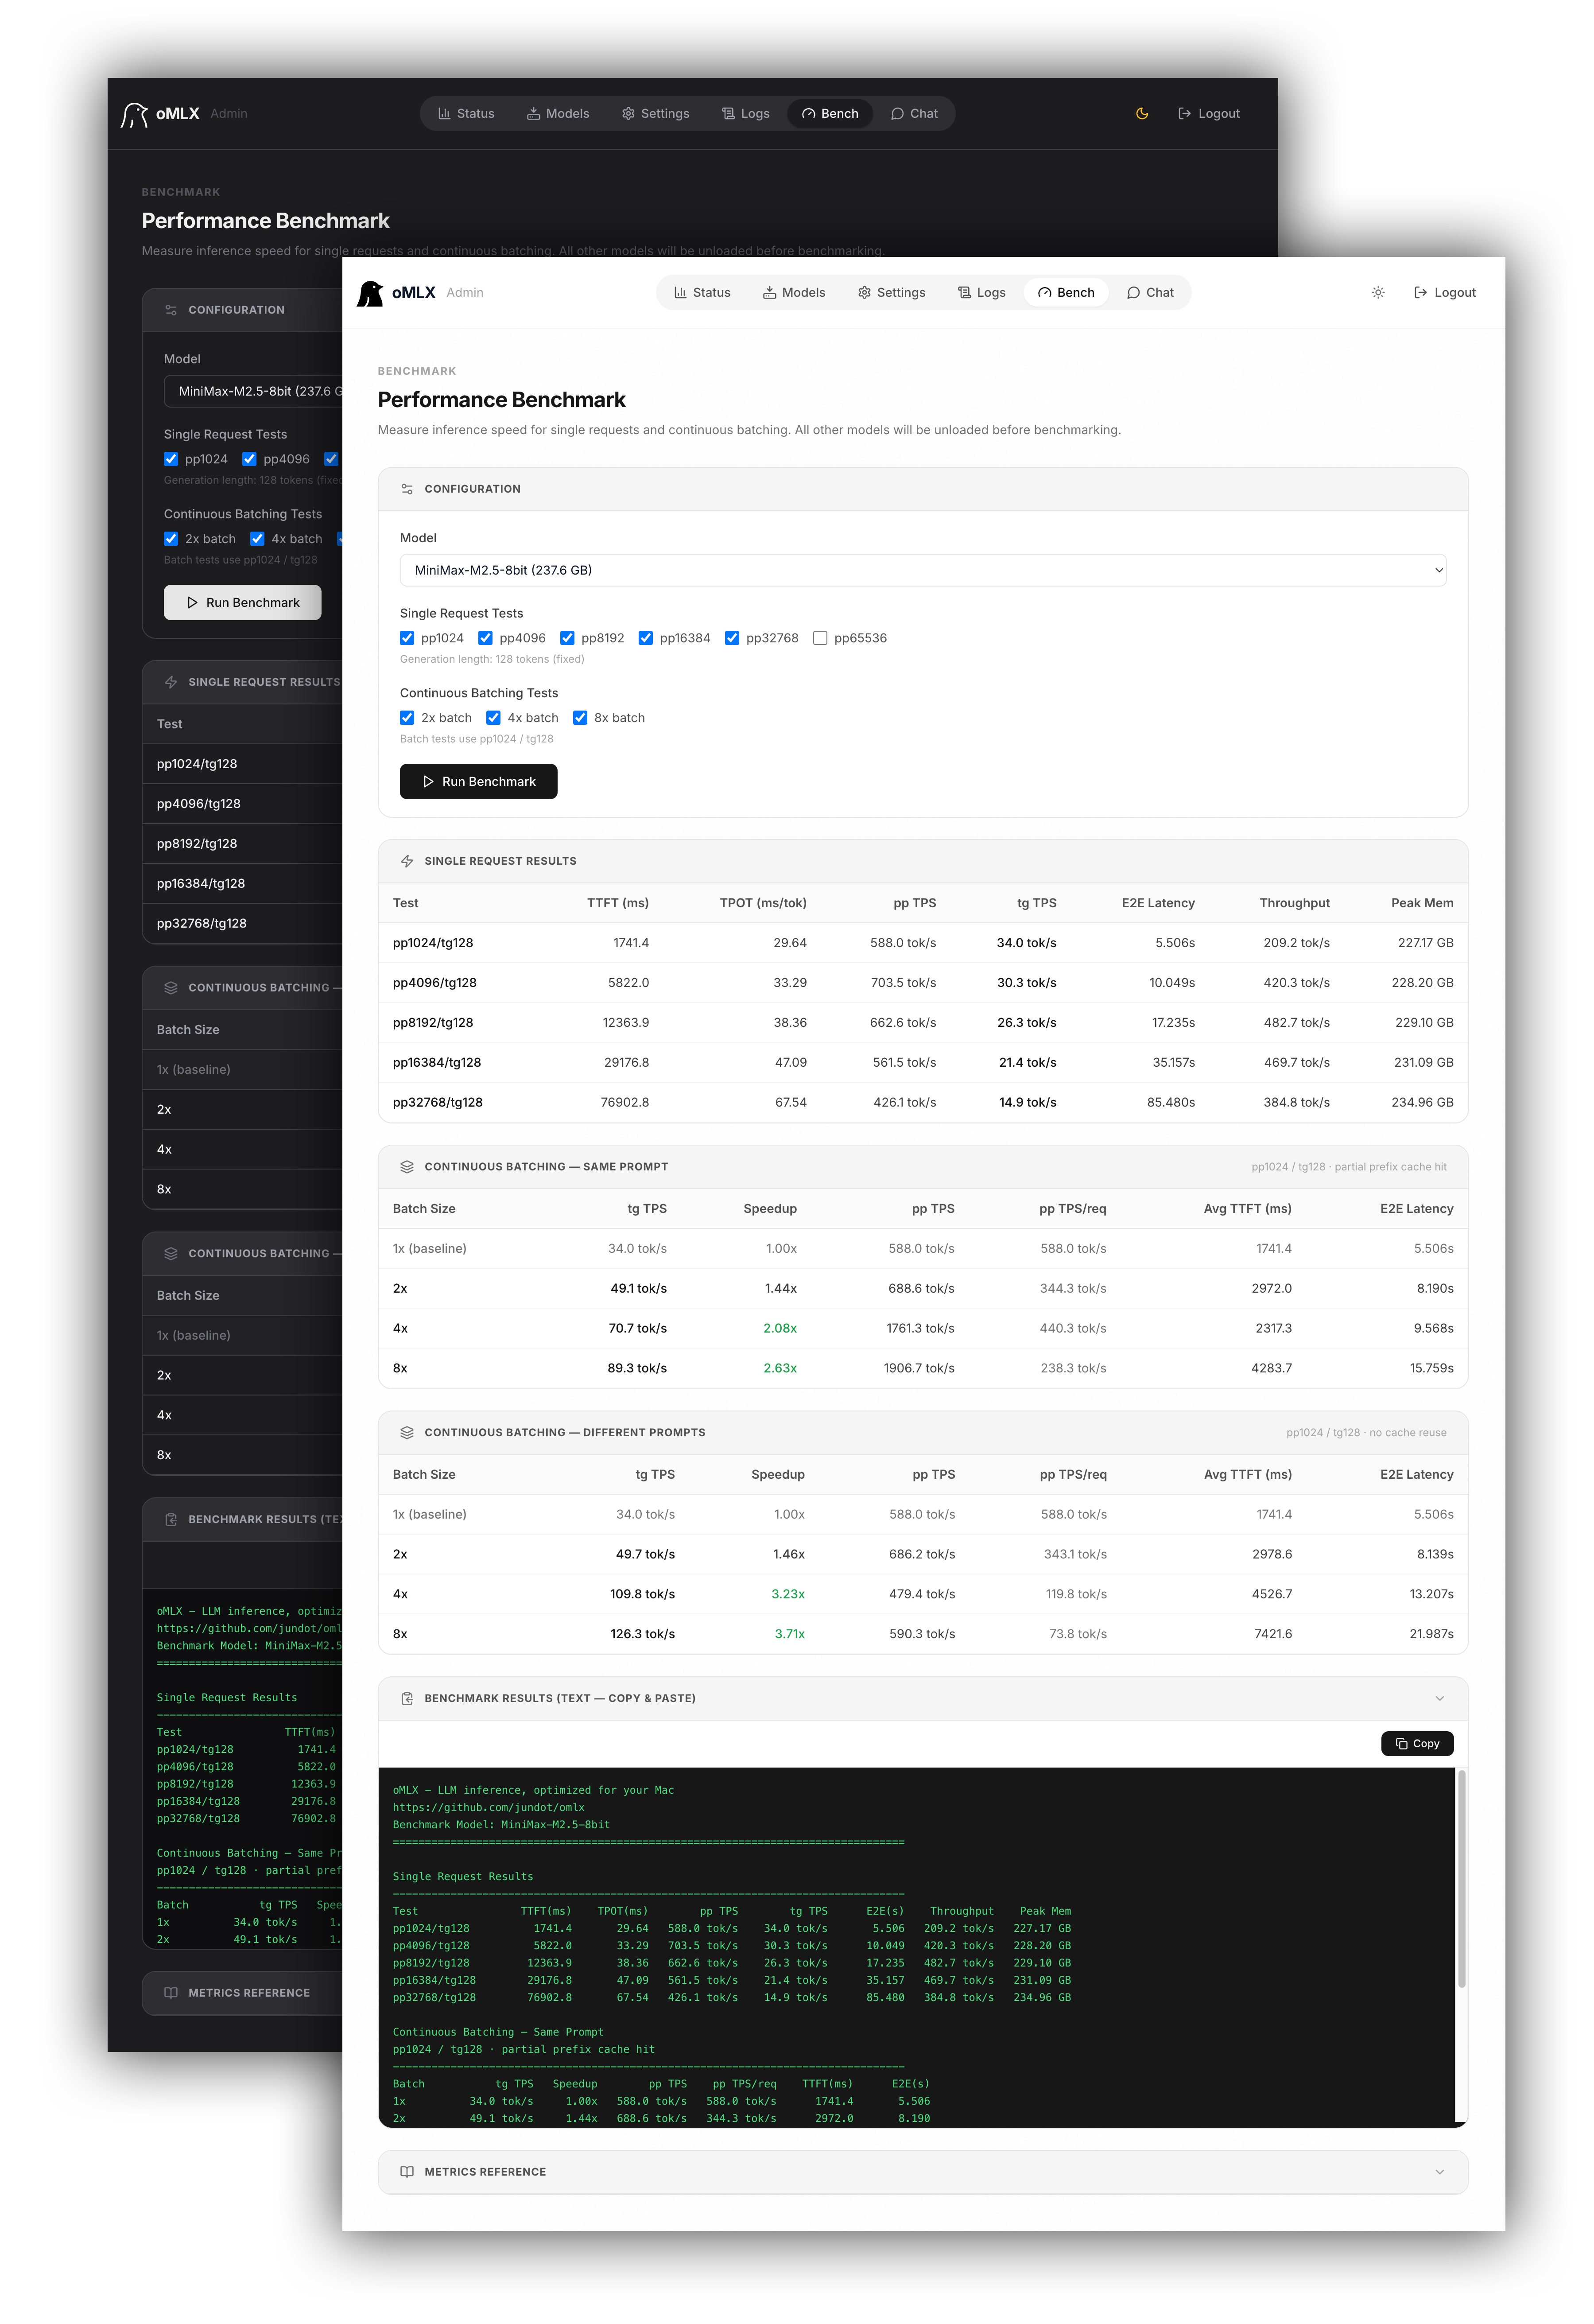
在管理面板进行一键基准测试。测量每秒预填充(PP)和文本生成(TG)令牌数,并通过部分前缀缓存命中测试以获得真实的性能数据。
macOS 菜单栏应用
原生Swift / SwiftUI菜单栏应用(不是Electron)。启动、停止并监控服务器,无需打开终端。包括持续的发球统计(能经受重启)、崩溃时自动重启和内置自动更新。

API 兼容性
OpenAI 和 Anthropic API 的可直接替代。支持流媒体使用统计数据(stream_options.include_usage)、人类适应性思维和视觉输入(base64,URL)。
| 终点 | 描述 |
|---|---|
POST /v1/chat/completions | 聊天完成(流媒体) |
POST /v1/completions | 文本补全(流式传输) |
POST /v1/messages | 人类信息 API |
POST /v1/embeddings | 文本嵌入 |
POST /v1/rerank | 文档重新排序 |
GET /v1/models | 可选车型列表 |
工具调用与结构化输出
支持mlx-lm中所有可用的函数调用格式、JSON模式验证和MCP工具集成。工具调用需要模型的聊天模板支持tools参数。以下型号系列通过mlx-lm内置的工具解析器自动检测:
| 型号家族 | 节目形式 |
|---|---|
| 比如Llama、Qwen、DeepSeek等。 | JSON |
| Qwen 3.5 系列 | XML |
| 杰玛 | |
| GLM(4.7,5分) | /XML |
| 迷你极限 | 命名空间 |
| 密斯特拉尔 | [TOOL_CALLS] |
| Kimi K2 | <|tool_calls_section_begin|> |
| 长猫 |
如果聊天模板支持,上面没列出的型号可能还能用tools其输出使用公认的XML格式。对于工具支持的流媒体,助理文本是逐步输出的,而已知的工具调用控制标记则被抑制在可见内容中;解析完成的回合后会发出结构化工具调用。
模型
要点--model-dir在包含MLX格式模型子目录的目录中。两级组织文件夹(例如,mlx-community/model-name/)也被支持。
~/models/
├── Step-3.5-Flash-8bit/
├── Qwen3-Coder-Next-8bit/
├── gpt-oss-120b-MXFP4-Q8/
├── Qwen3.5-122B-A10B-4bit/
└── bge-m3/
模型按类型自动检测。你也可以直接从管理仪表盘下载模型。
| 类型 | 模型 |
|---|---|
| 大型语言模型 | 任何支持 的模型MLX-LM |
| VLM | Qwen3.5系列、GLM-4V、Pixtral及其他MLX-VLM模型 |
| 光学字符识别 | DeepSeek-OCR,DOTS-OCR,GLM-OCR |
| 嵌入 | BERT,BGE-M3,现代BERT |
| 重新排名者 | 现代伯特,XLM-RoBERTa |
CLI 配置
# Managed background server (macOS app or Homebrew install)
omlx start
omlx stop
omlx restart

# Start with default settings (memory guard tier = balanced, manage via admin UI)
omlx serve --model-dir ~/models

# Choose a memory guard tier at startup
omlx serve --model-dir ~/models --memory-guard safe

# Set a custom memory guard ceiling in GB
omlx serve --model-dir ~/models --memory-guard-gb 48

# Enable SSD cache for KV blocks
omlx serve --model-dir ~/models --paged-ssd-cache-dir ~/.omlx/cache

# Set in-memory hot cache size
omlx serve --model-dir ~/models --hot-cache-max-size 20%

# Adjust max concurrent requests (default: 8)
omlx serve --model-dir ~/models --max-concurrent-requests 16

# With MCP tools
omlx serve --model-dir ~/models --mcp-config mcp.json

# HuggingFace mirror endpoint (for restricted regions)
omlx serve --model-dir ~/models --hf-endpoint https://hf-mirror.com

# API key authentication
omlx serve --model-dir ~/models --api-key your-secret-key
# Localhost-only: skip verification via admin panel global settings
所有设置也可以通过网页管理面板配置。/admin.设置被持久化为~/.omlx/settings.json,CLI标志优先。
建筑
FastAPI Server (OpenAI / Anthropic API)
    │
    ├── EnginePool (multi-model, LRU eviction, TTL, manual load/unload)
    │   ├── BatchedEngine (LLMs, continuous batching)
    │   ├── VLMEngine (vision-language models)
    │   ├── EmbeddingEngine
    │   └── RerankerEngine
    │
    ├── ProcessMemoryEnforcer (total memory limit, TTL checks)
    │
    ├── Scheduler (FCFS, configurable concurrency)
    │   └── mlx-lm BatchGenerator
    │
    └── Cache Stack
        ├── PagedCacheManager (GPU, block-based, CoW, prefix sharing)
        ├── Hot Cache (in-memory tier, write-back)
        └── PagedSSDCacheManager (SSD cold tier, safetensors format)
发展
CLI 服务器
git clone https://github.com/jundot/omlx.git
cd omlx
pip install -e ".[dev]"
pytest -m "not slow"
macOS 应用
原生的 SwiftUI 应用位于apps/omlx-mac/.需要Xcode 26.5+和Python 3.11+。venvstacks 被声明为开发依赖,所以pip install -e ".[dev]"(或uv sync --dev) 将置顶版本导入。
构建脚本也会回退到uvx venvstacks或pipx run venvstacks如果你更喜欢主机全局工具运行工具。
# Stage a runnable oMLX.app (xcodebuild + venvstacks Python layers + ad-hoc sign)
apps/omlx-mac/Scripts/build.sh release

# Result lands at apps/omlx-mac/build/Stage/oMLX.app
open apps/omlx-mac/build/Stage/oMLX.app

# Force a fresh venvstacks rebuild (otherwise it's cached by fingerprint)
apps/omlx-mac/Scripts/build.sh release --rebuild-donor

# Stage with optional GLM-5.2 / MiniMax M3 native custom kernels
apps/omlx-mac/Scripts/build.sh release --with-custom-kernel
第一次冷构建需要10到20分钟(venvstacks Python 层组装)。后续构建会重用缓存packaging/_export/大约4分钟内完成。参见包装/README.md对于层配置和应用/OMLX-MAC/为了斯威夫特的消息来源。
贡献
欢迎大家的贡献!参见贡献指南细节。
- 漏洞修复与改进
- 性能优化
- 文档改进
许可
致谢
- MLX以及MLX-LM作者:苹果
- MLX-VLM- 苹果硅片上的视觉语言模型推断
- VLLM-MLX- oMLX 从 vllm-MLX v0.1.0 起步,经过显著演进,支持多模型服务、分层 KV 缓存、支持全页缓存的 VLM、管理面板以及 macOS 菜单栏应用
- venvstacks- macOS 应用包的可移植 Python 环境分层
- MLX 嵌入- 苹果硅芯片的嵌入模型支持
- 闪电-MLX- 苹果硅上的块扩散推测解码
- MTPLX- Lightning MTP 的验证形状金属核由 Youssof Altoukhi 的 MTPLX 驱动,该系统也启发了 depth-k 管道
- MLX-SERVE- 融合后的GDN验证预工作内核改编自mlx-serve对mlxfast-challenge内核的移植qwen35_packed_gdn_prework
- 硅眼镜- 菜单栏统计数据采用了Kennt Kim的SiliconScope设计和渲染方法,该设计也启发了节能的重新渲染门控技术

 点赞
 收藏
 点踩
 分享