Colibri:纯C实现的千亿参数MoE推理引擎,在消费级硬件上跑大模型
 1


在你已有的硬件上运行 Frontierer MoE 模型——纯 C,零 deps,从磁盘流式专家。小引擎,庞大的模型。🐦
https://justvugg.github.io/colibri

小巧的发动机,庞大的模型。跑前沿MoE模型——744B至2.8T参数——在消费级和异构硬件上,纯C语言,零引擎依赖,通过将存储、内存和显存视为单一推理层级(AI内存多层化)。
今天有八个家庭参赛:GLM-5.2/5.3(744B),GLM-5.3-闪光灯(321B,附视力),墨水(975B),Kimi K3(2.8T),DeepSeek V4 闪光灯(284B),Qwen3.8-闪电-Next(125B + 51B n-gram),Qwen 3.6(35B-A3B)和OLMoE(7B)——每个C文件,相同coli chat/coli serve/coli web前端。
完整名单 ↓
Colibrì 是一个你现在可以运行的推理引擎,也是一个开放的研究平台。其主要目标是在整个软硬件边界——模型格式、内存层级、存储I/O、布局、调度、内核、推测以及CPU/GPU重叠——实现推理端性能,从而减少对稀缺硬件的依赖,降低运行成本。
Colibrì将显存、内存和存储视为单一的多层级结构,并故意成为测试激进系统理念的地方——所以确实存在速度没有标准等级,语义上有硬性保证实验必须通过可重复的端到端测量和默认策略来赢得其地位绝不会默契地更改模型精度或路由器语义.内存不够快可能会降低速度;但不能悄无声息地重新定义模型。
$ ./coli chat
  🐦 colibri v1.10.2 — GLM-5.2 · 744B MoE · int4 · streaming CPU
  ✓ ready in 32s · resident 9.9 GB
  › ciao!
  ◆ Ciao! 😊 Come posso aiutarti oggi?
看它跑起来
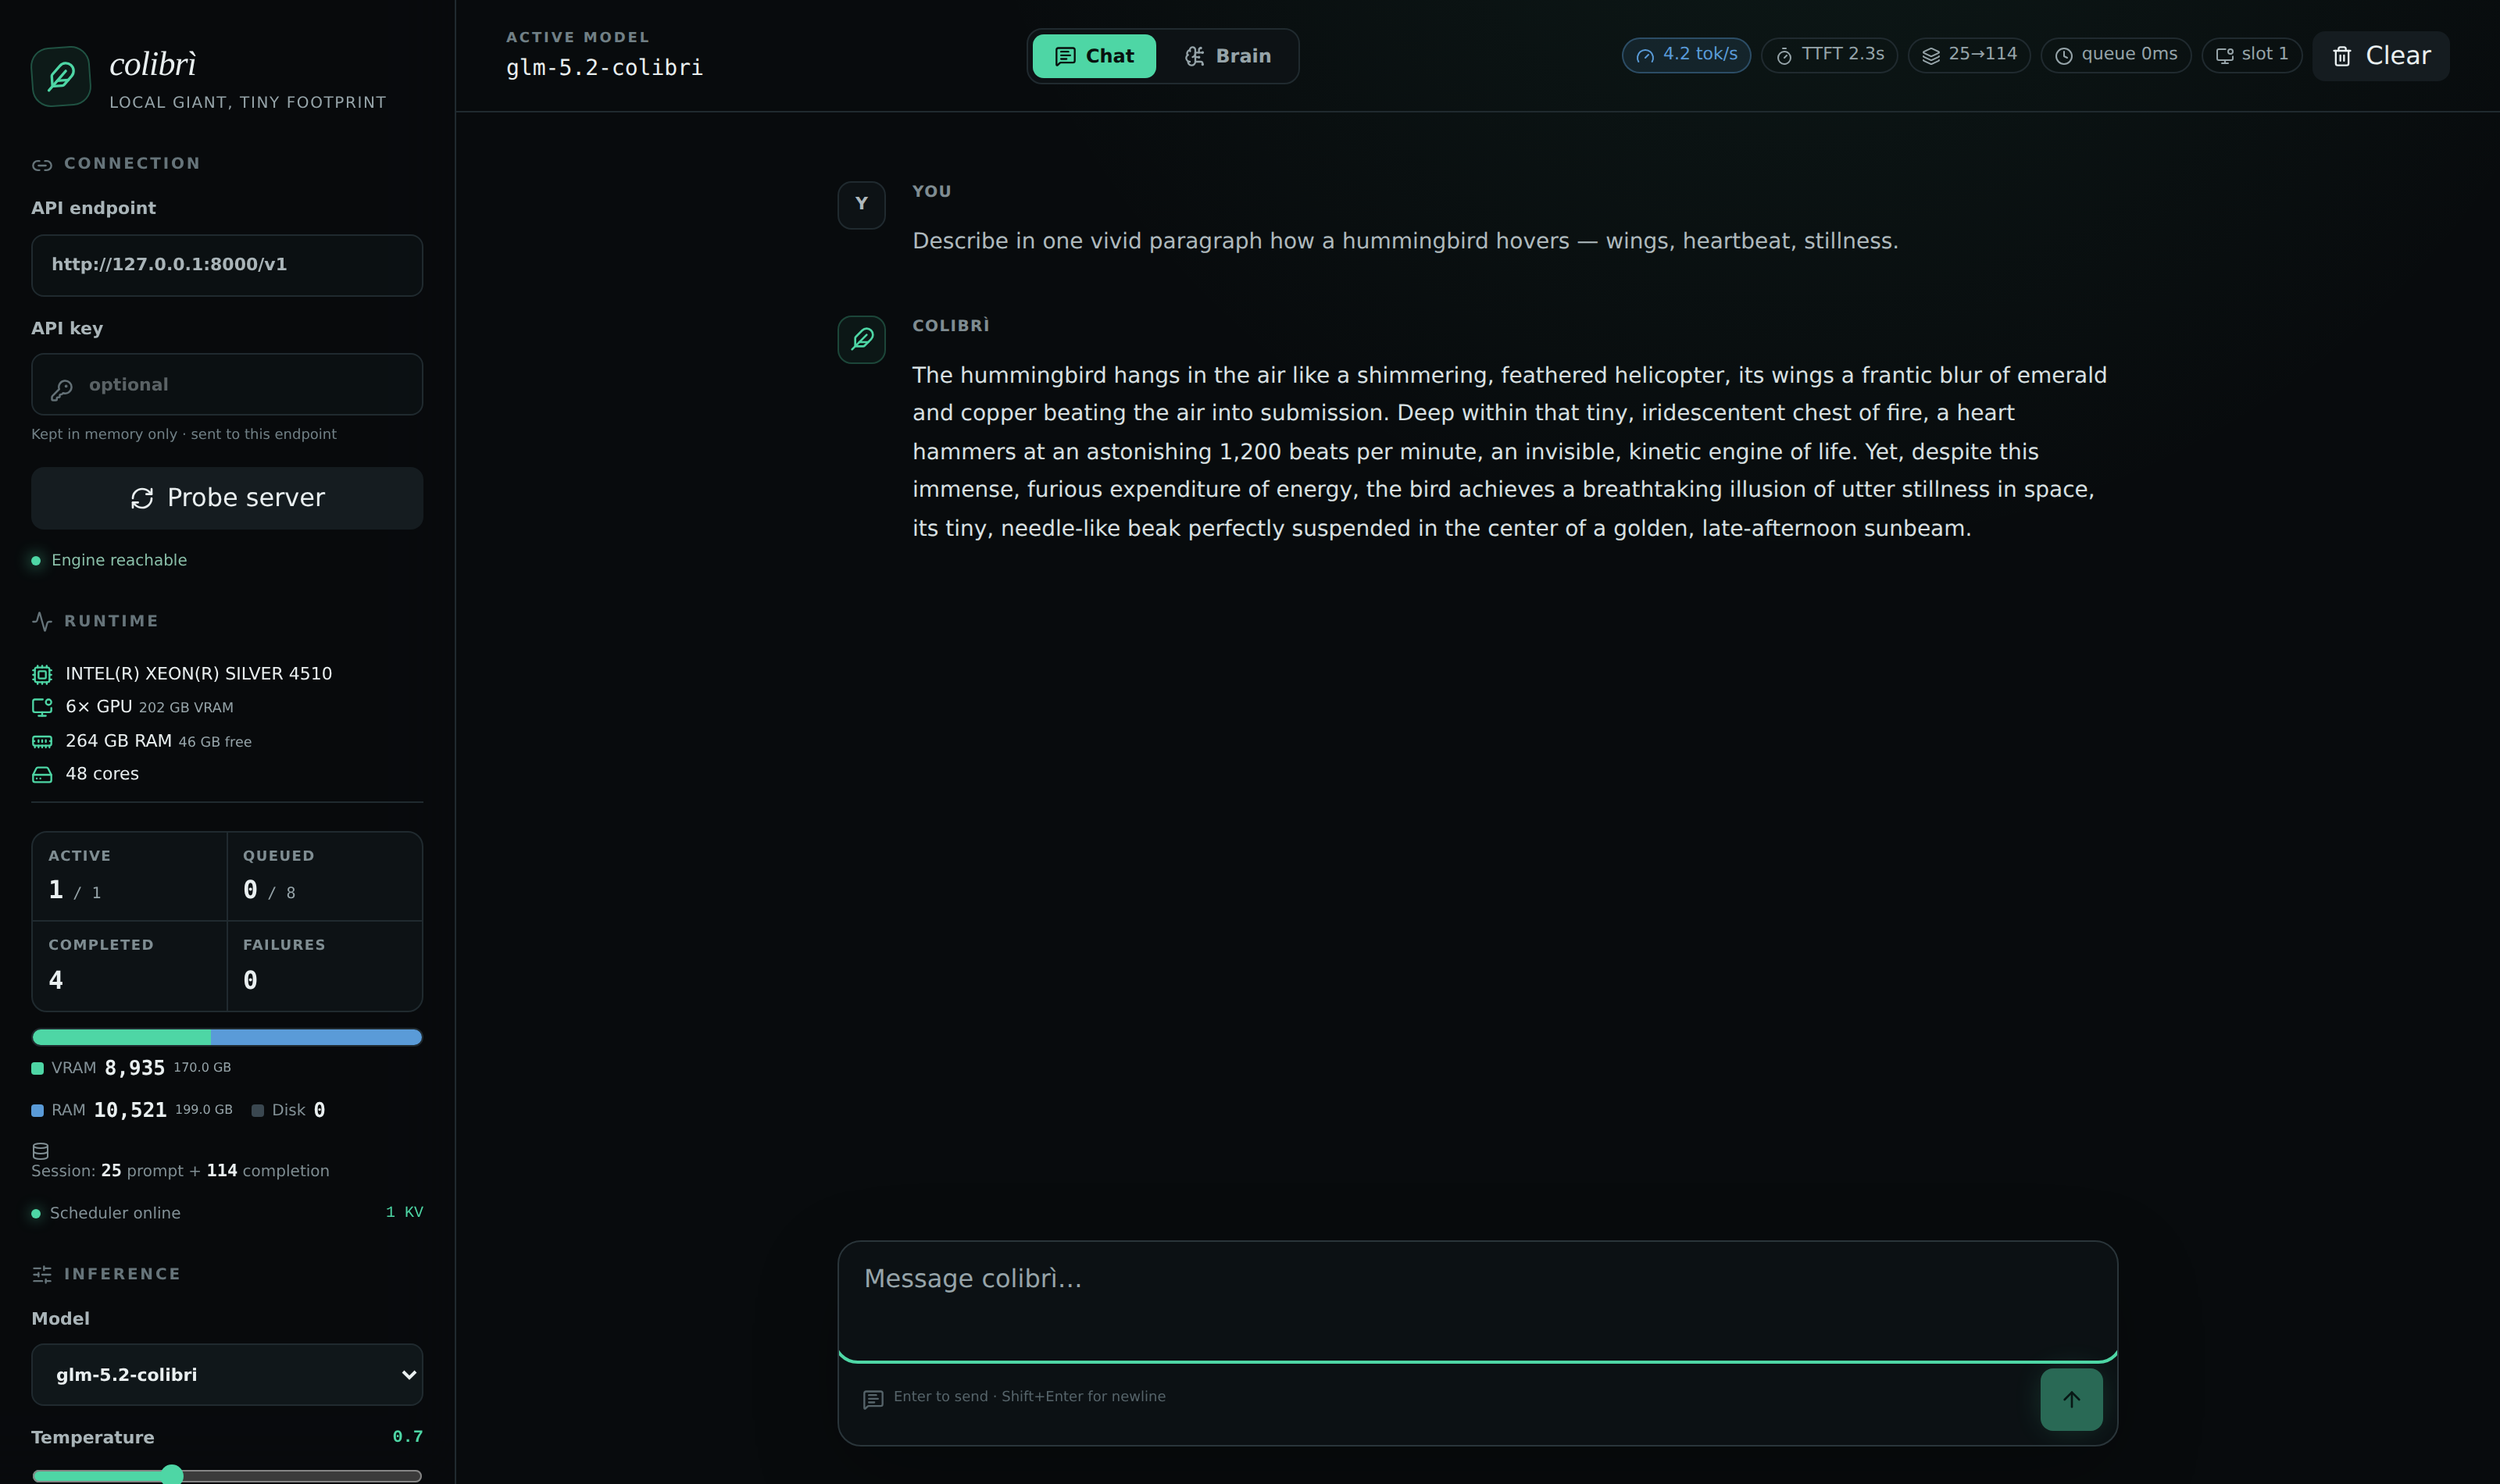
网页仪表盘(./coli web):一台744B型号4 tok/s,TTFT 1.6 秒,磁盘 0——在6× RTX 5090上提供完整的专家驻留,实时令牌指标、每回合时间分解、显存/内存/磁盘层级条以及角落的实时迷你大脑。
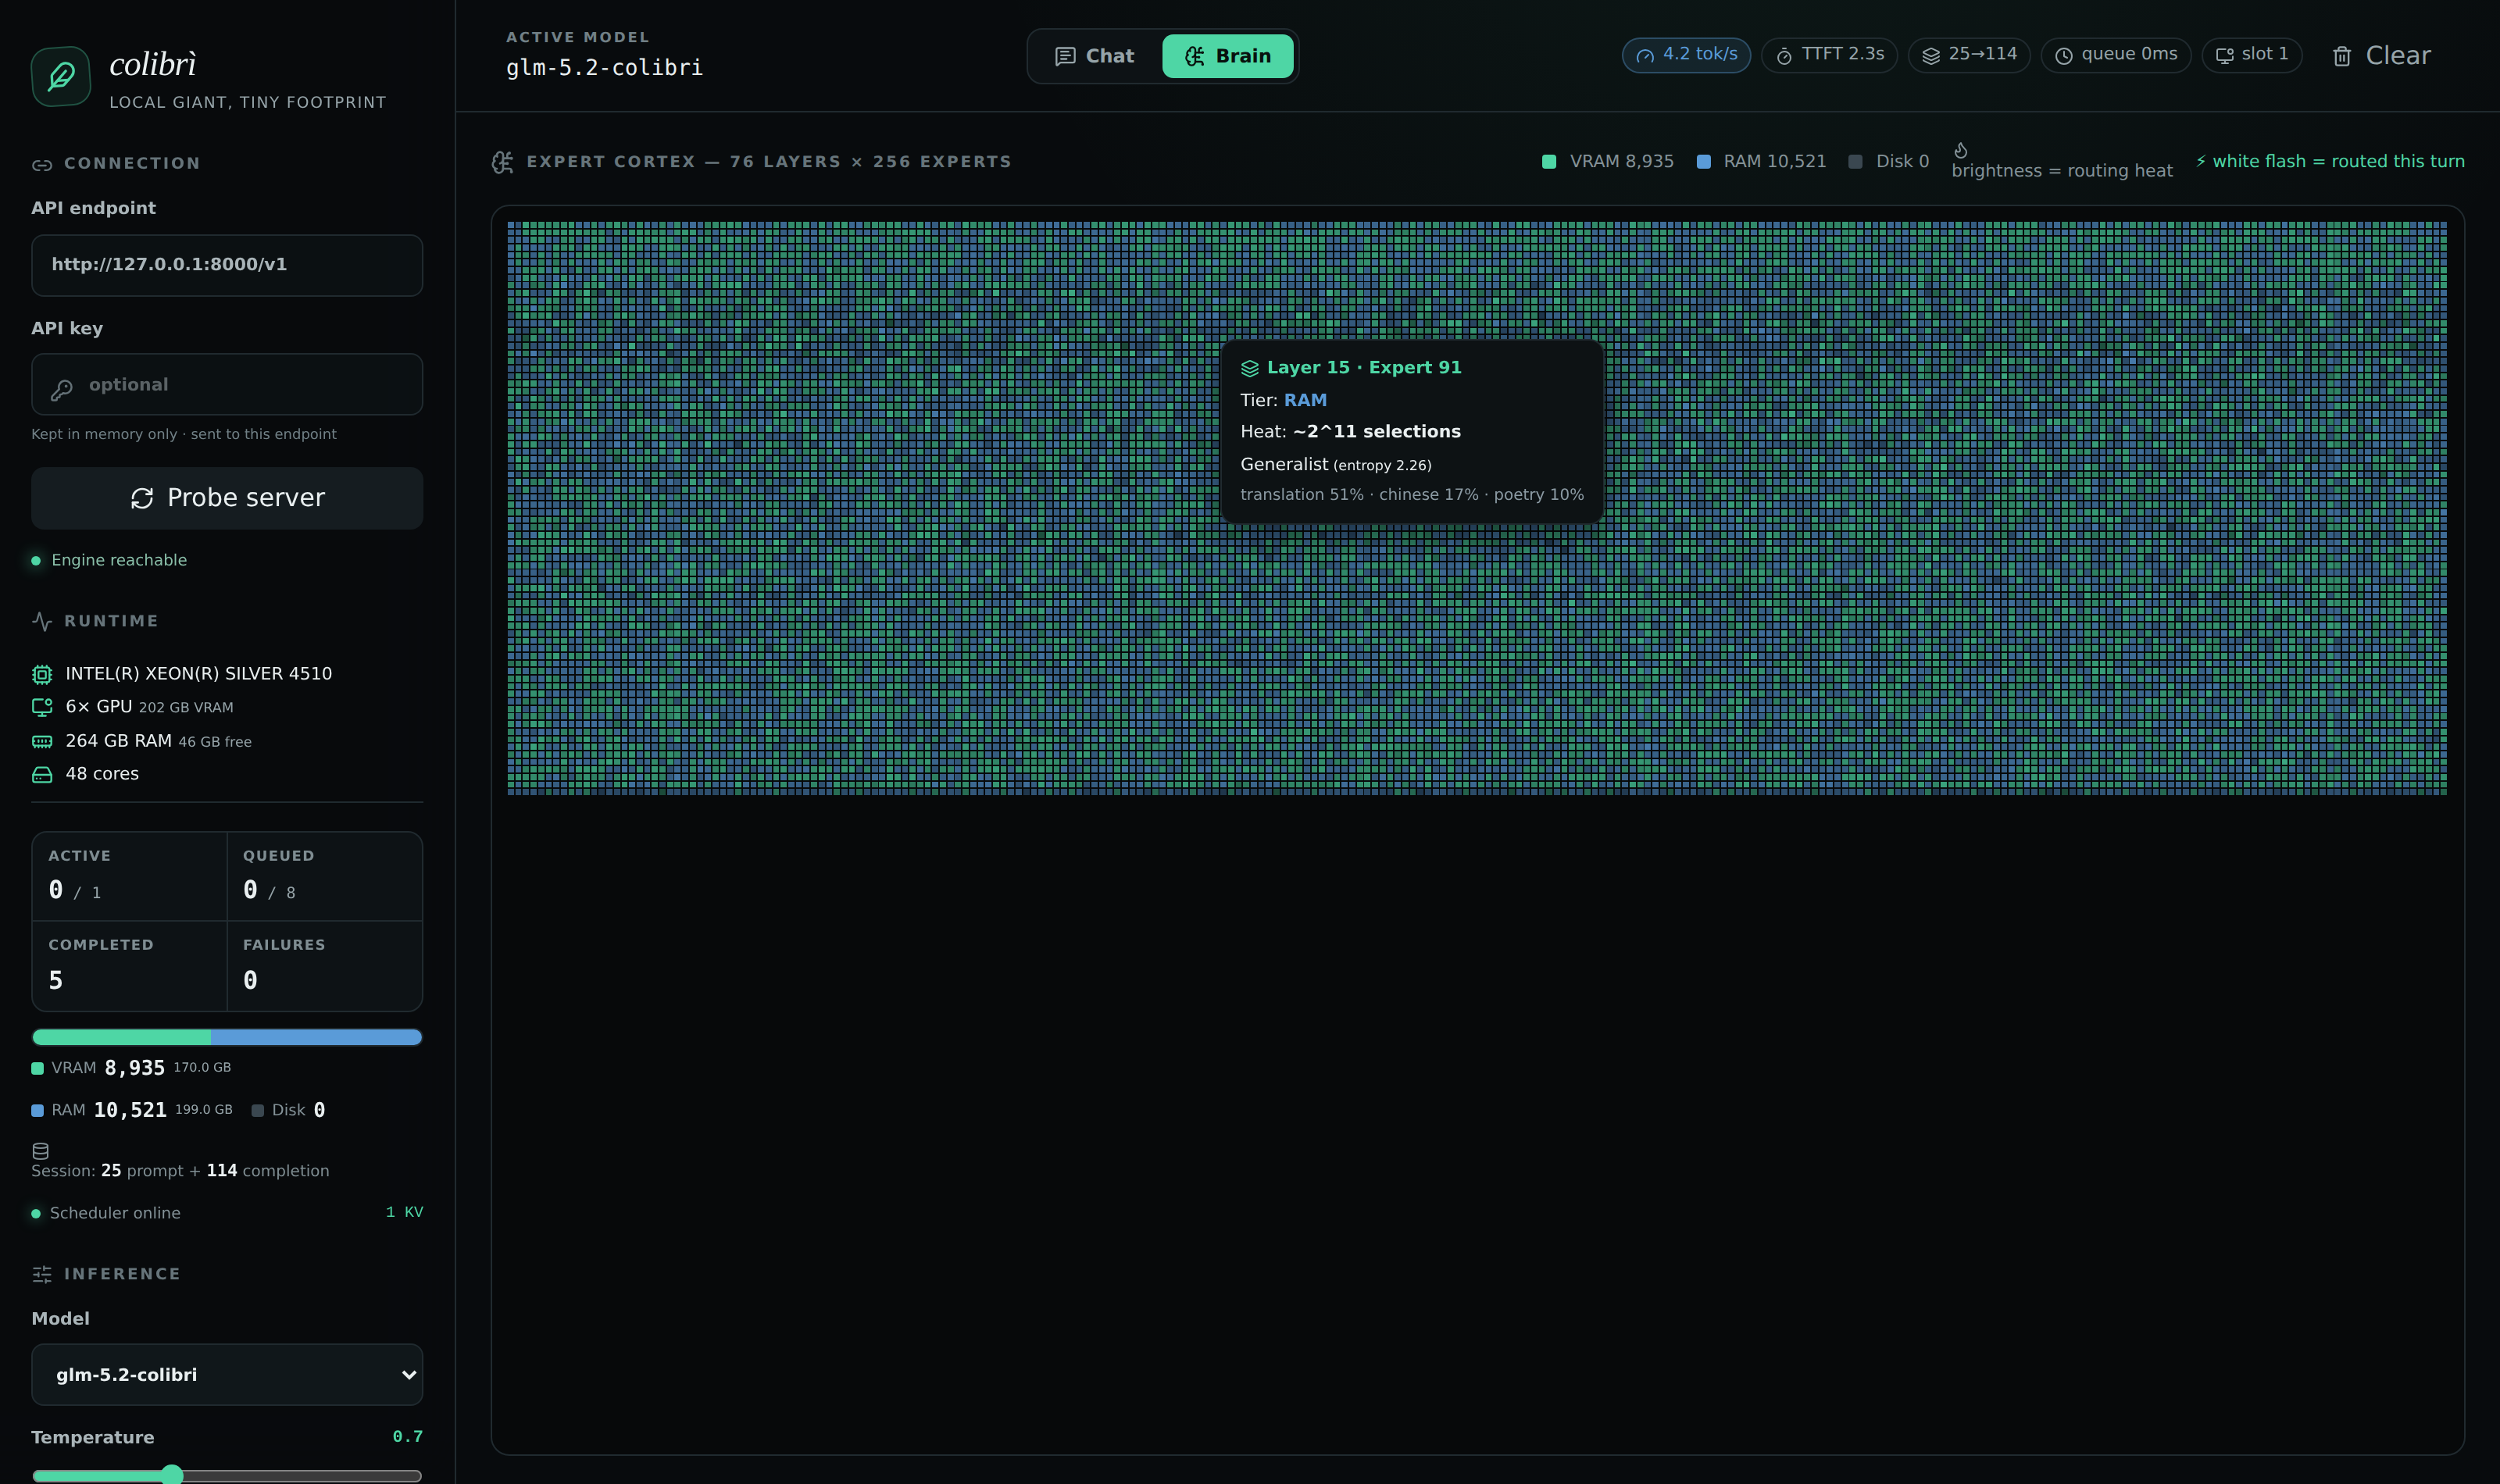
该大脑页面:所有19,456位专家作为活皮层——颜色是存储层,亮度是导热,每个在转弯中被引导的专家都会闪烁白色。悬停显示专家的测量主题亲和力.
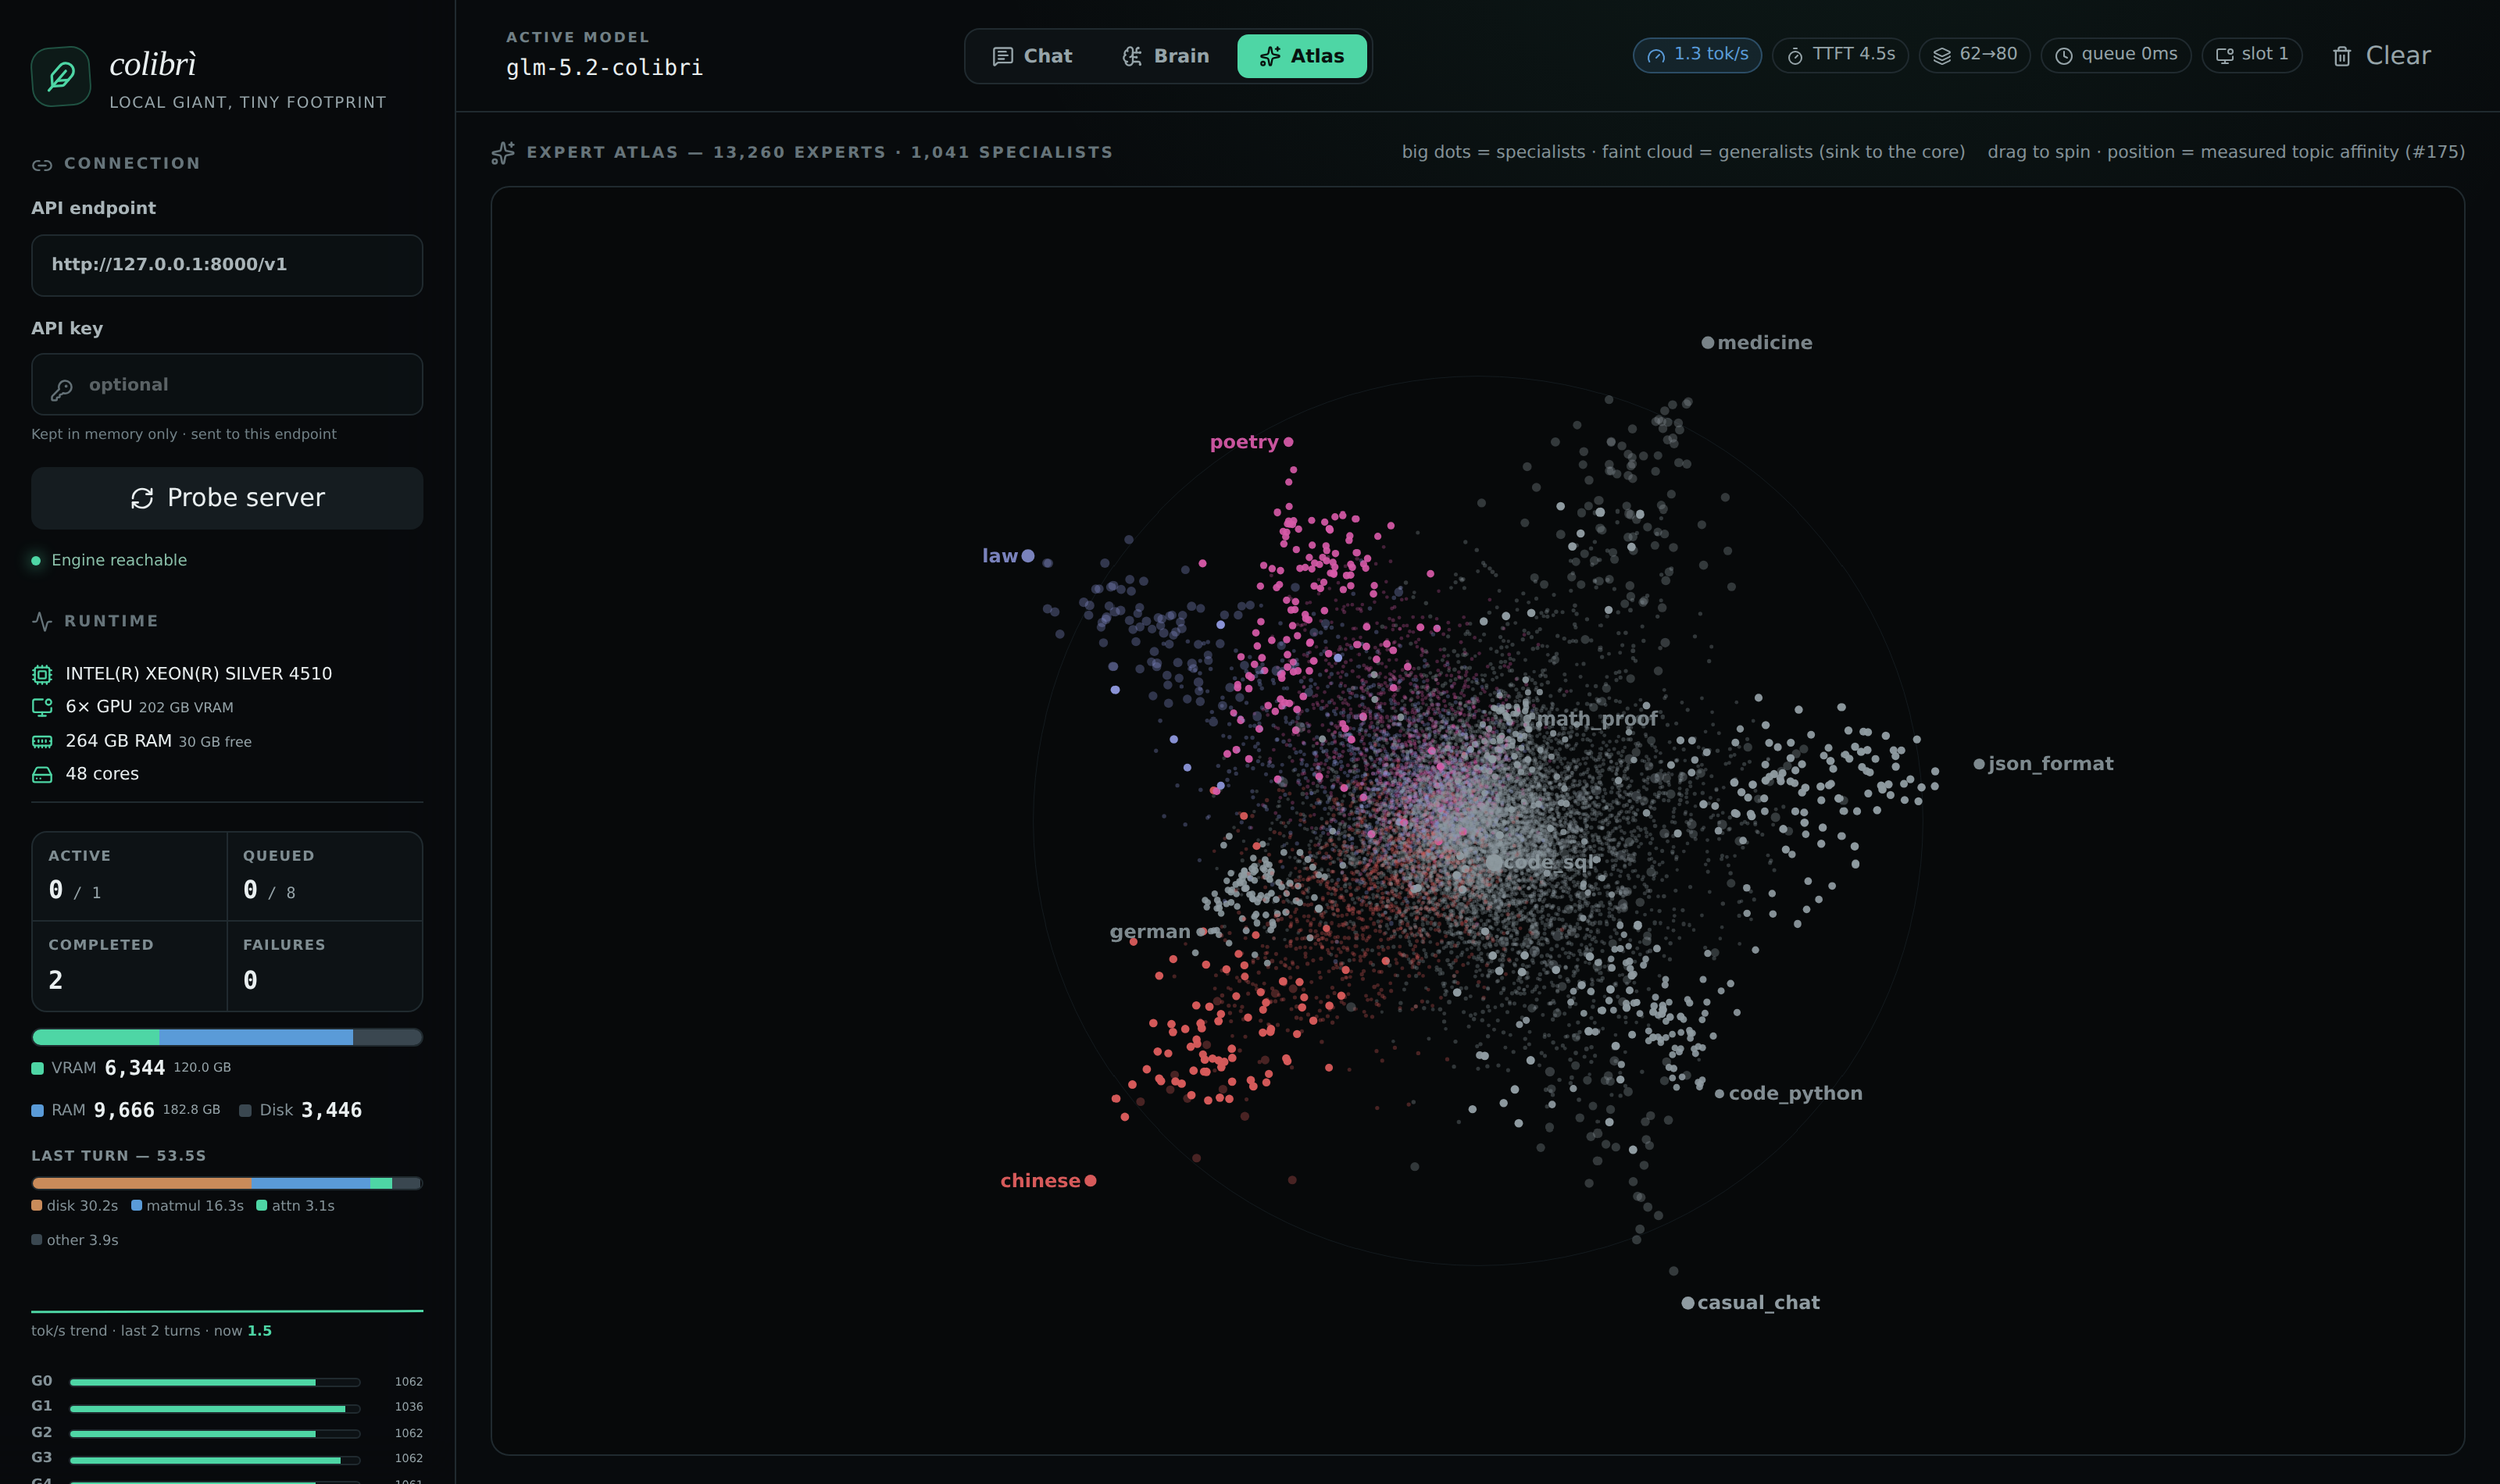
该阿特拉斯页面:the测量专家图谱作为一个三维星系——13,260名特征化专家,1,041名复制专家按主题(诗歌、法律、中文、SQL等)聚集。
位置是测量的路由亲和力,而非学习嵌入。拖拽到旋转。
研究使命
有了Colibrì,私有前沿模型的访问不受超大规模硬件可用性的限制。
凭借其多层次的功能,Colibrì移除专有硬件依赖,积极优化功能推理引擎流水线.
我们的运营使命包括改变权重的表示和移动方式,决定哪些内容存储在显存、内存或存储中,重叠异构计算,降低启动和同步开销,利用稀疏性和重用,并测试新的译码算法。
没有任何东西仅仅因为是传统而受到保护;没有什么是仅仅因为微基准看起来快就被采纳的。决定性的结果是在真实机器上进行端到端推断,正确性和质量与吞吐量、延迟、内存和成本并行衡量。
实际结果是交通便利:在你已有的硬件上运行一个744B参数模型,实时观看每位专家的发射,并修改执行这些任务的代码。不依赖API背后的智能——判决它:探测、测量、改进。
引擎刻意设计得足够小,下一个有用的优化可以来自任何愿意测量它的人。
核心技术与测量发现
- 一个层级结构,不限于等级容量。显存、内存和NVMe是相同权重的配置层级;有限的快速内存变化速度,而非模型语义问题。
- 一个用来做哑铃的JIT。测量路由热量驱动每层LRU、学习的固定热存储和一层预取,而不是加载每个专家。它在可重复工作负载上占优势;历史过载可能过拟合,前瞻在某些主机上可能失败,因此两者都只是可衡量的策略而非承诺。
- 输入输出是引擎的一部分。批量专家联工,重叠读取和计算,
O_DIRECT加权双SSD条带攻击流媒体路径,而不是假装存储延迟是免费的。O_DIRECT依赖硬盘,双SSD仍需更广泛的端到端社区A/B。 - 执行异质。CPU、CUDA、Metal、NUMA 内存以及部分或全部专家驻留共享一个运行时,可以根据机器类型组合;盈利的组合取决于计算量、带宽、驻留时间和工作负载。
- 压缩状态,但没有不同模型。令牌精确的前向验证、57×更小的MLA KV状态、持续的温暖对话以及忠实的DSA使优化与正确性挂钩。这些是内存、延迟和正确性属性,而非一概而论的吞吐量。
- 这些猜测必须值得它应得的价值。原生MTP和语法强制草稿是端到端测量的,当接受无法支付验证费用时可以被禁用。
开放假设、实验以及如何帮助
Colibrì将优化视为假设,直到受控端到端A/B结果显示相反。以下是目前的主要问题:
| 假说 | 目前的证据 | 实验还没完 |
|---|---|---|
| 路由历史可以比普通的LRU更能推荐专家 | 学习的针脚能提升重复工作量,但可能会过度拟合提示 | 跨编码、聊天、多语言和长上下文工作负载的跨会谈A/B进行持续保存 |
| 多块SSD可以将独立带宽转换为解码速度 | 加权镜像/分路已实现并验证;带宽模型是可靠的 | 冷缓存一驱与双驱GLM-5.2运行在真实独立控制器上 |
| 具备硬件感知的规划器可以自动接近每台机器的最佳配置 | 目前还能检测到内存/显存预算和多个后端 | 将生成的计划与受控参数扫描进行笔记本、工作站、NUMA主机和多GPU系统的比较 |
| 无损或质量有界表示可以减少权重移动,从而产生影响 | 存在格式化和量化消融,并带有正确性/质量门 | 重现质量、移动字节数、延迟和每个有效令牌成本一起重现——而非仅仅压缩比 |
| 有路由意识的投机可能在接近满户居住期前就有利可图 | MTP和语法草稿有效,但MTP也检测到专家命中率约85%的损失32% | 映射收支平衡面,涵盖验收率、专家命中率、批次合并和选秀深度 |
| CPU和GPU的重叠可以隐藏传输和同步,而不仅仅是移动瓶颈 | CUDA和Metal的胜利确实存在,但CPU速度快且驻留率低可能会抹去它们 | 每阶段配置文件和跨 PCIe、统一内存和全驻留机器的单变量 A/B 配置 |
想帮忙吗?选一行并发布负面结果。记录硬件、提交、模型/容器、精确命令、提示符、缓存状态、吞吐量、TTFT、专家命中率、读取字节和质量检查;更改一个变量,重复运行,并附加原始日志。
开始于CONTRIBUTING.md,比较基准协议,则开启实验议题.一个受控的故障比一个无法解释的快速数值更有价值。
理念
744B专家混合模型只激活每个代币的400亿参数——其中只有~11 GB在代币间(路由专家)之间发生变化:
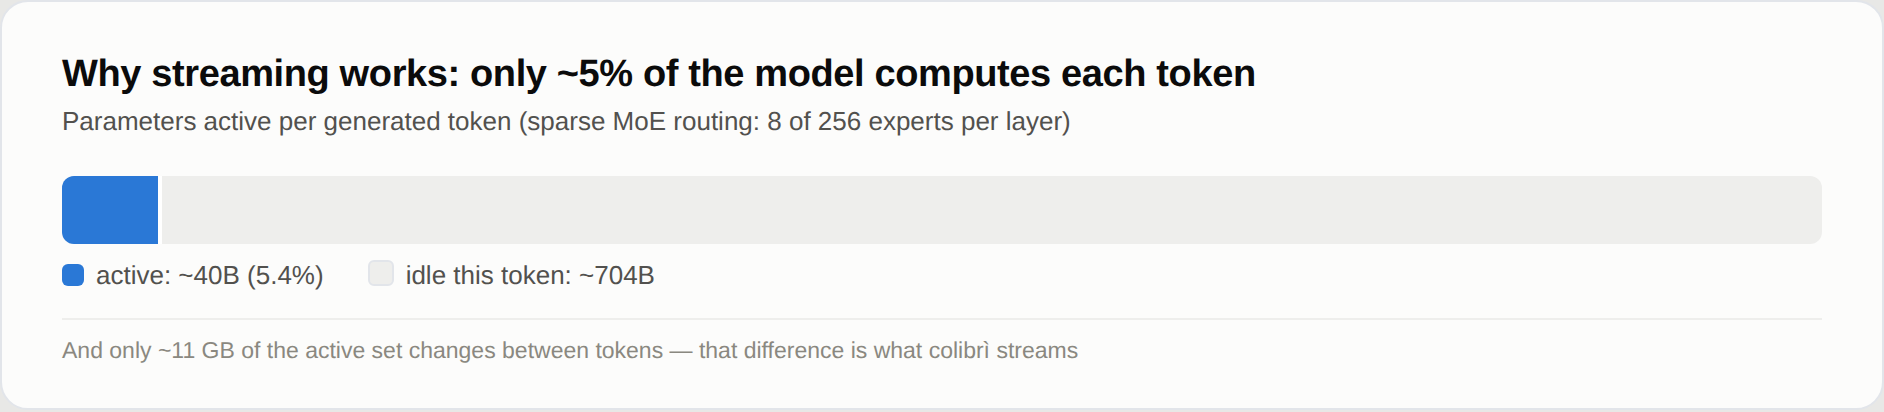
所以模型不需要合适度在快速记忆中——必须是位置:
- 该致密部分(注意,共享专家,嵌入 — ~17B 参数) 保持驻留在 RAM 中的 int4(~9.9 GB);
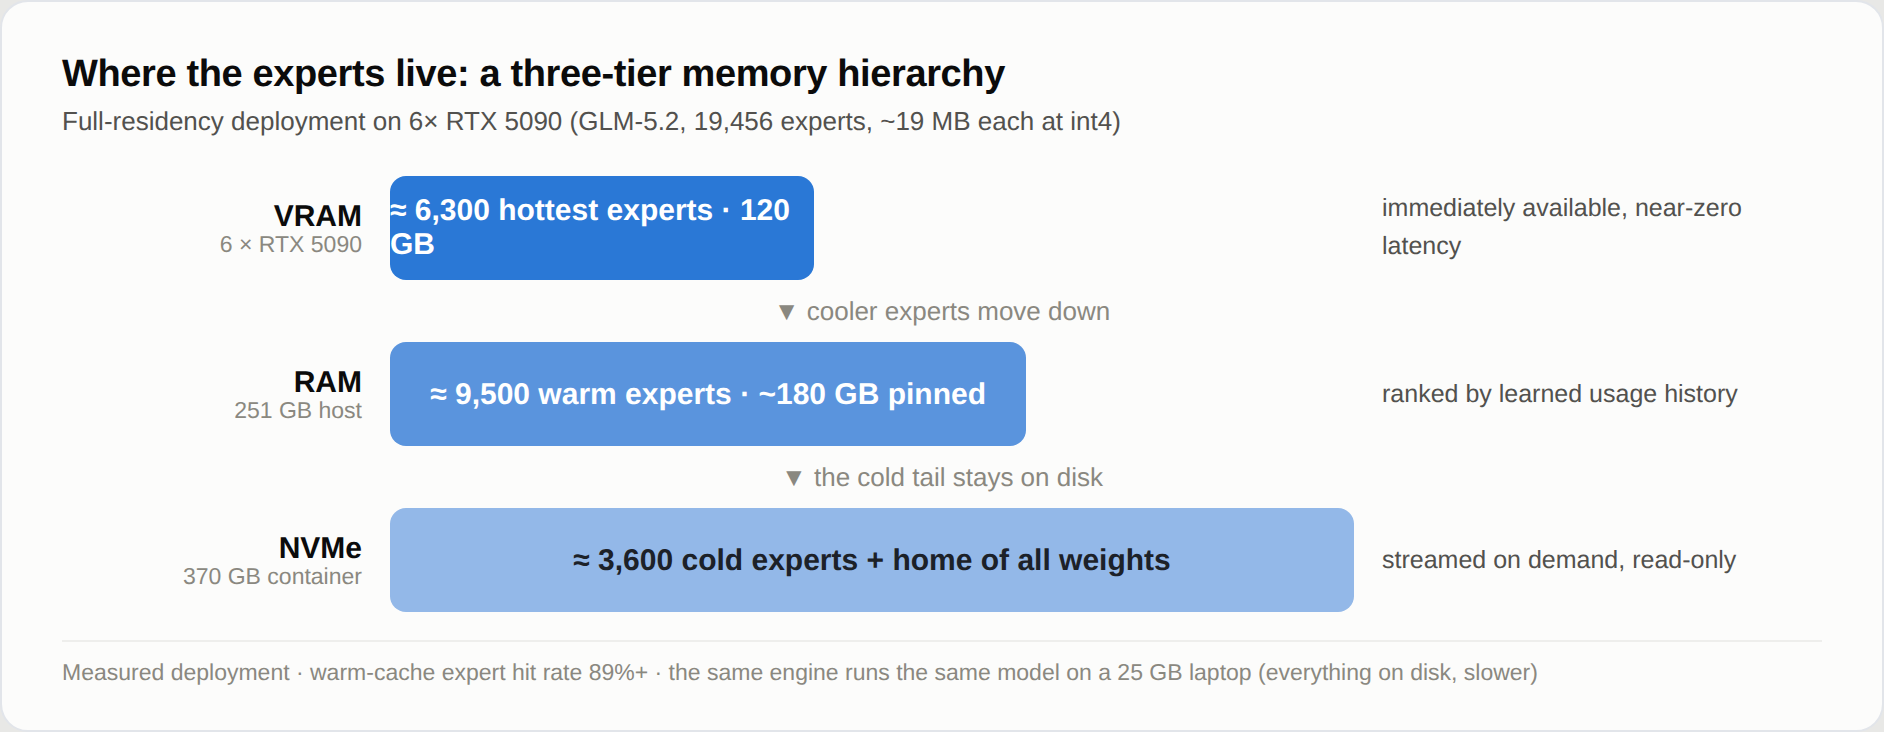
- 该19,456名专家被击溃(75 MoE 层 × 256 + MTP 头,int4 处每个 ~19 MB)实时运行在磁盘上(~370 GB)和点播流媒体,配备每层LRU缓存、学习钉顶热存储和可选显存层。
可以把核心算法想象成一个JIT,但用于权重.编译器 JIT 从不编译整个程序——它观察实际运行的内容,并及时编译热路径。Colibrì 对 744B 参数空间也打了同样的赌注:参数不是需要保留的常驻状态,而是待分阶段的数据在异构存储层级(显存 / 内存 / NVMe)上,路由器证明他们被需要时。
测量的路由热量决定专家获得哪个等级,路由器提前运行一层,预取隐藏分级延迟,且——像JIT一样——引擎学习你的工作负载:运行越多,合适的专家越热。
之所以有效,是因为路由具有可测量的结构(参见专家地图集)——且结构可缓存。
引擎是一个单一的 C 文件(c/colibri.c)加上小头部。没有BLAS,运行时没有Python,也不需要GPU。
局部集群模式
协调者将令牌生成、路由和KV状态保持本地,而磁盘支持的专家工作者则在其他Mac上执行路由FFN。层的路由批处理合并作为一个持久的TCP请求发送,因此令牌每个专家不会产生一次往返。
启动可选注册服务:
./coli cluster coordinator --host 0.0.0.0 --port 8765
在每个工人身上,使用本地可用的相同转换模型:
./coli cluster worker --model /nvme/glm52_i4 --port 9100 \
  --coordinator http://COORDINATOR:8765 --advertise-host WORKER_IP
用协调员进行证据披露,或者提供--cluster-workers HOST:PORT,...对于静态设置:
./coli serve --model /nvme/glm52_i4 \
  --cluster-coordinator http://127.0.0.1:8765
除非配置了工作者,否则传输被禁用,因此现有的单机路径保持不变。密集层分片和浏览器/WebGPU 工作者是独立的后续接缝。
工作原理
每个令牌路径
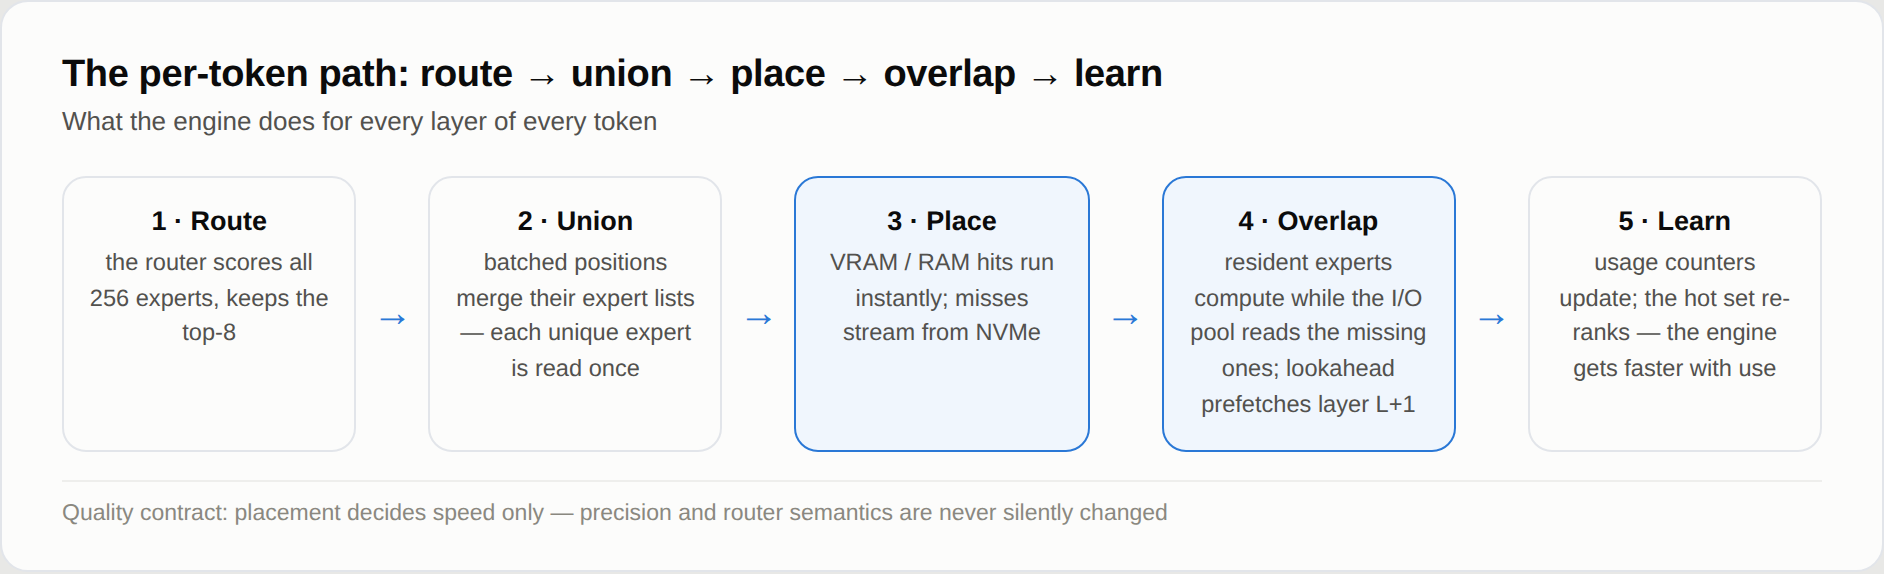
每个代币的每一层都走过相同的五个步骤。设计目标是位置决定速度——无论专家从显存还是磁盘回答,路由器的决策和权重精度都是相同的。
采用一个内存层级结构,而非一个内存需求
双SSD:两份该型号,读取带宽翻倍
大多数机器上解码是磁盘绑定的,专家读取是只读的——所以如果你有第二块固态硬盘,在上面放上完整的模型,然后让两个硬盘同时输出引擎:
COLI_MODEL=/fast/glm52_i4 COLI_MODEL_MIRROR=/second/glm52_i4 ./coli chat
COLI_DISK_WEIGHTS=9,3 ...   # optional: primary,mirror bandwidth ratio (else measured at startup)
每个 expert 通过确定性哈希路由到一个驱动器,该哈希根据两个驱动器测量(或声明)带宽加权,因此 readahead/PILOT 预取和需求读取总是到达同一驱动器,且不会缓存两次。
总带宽是两个驱动器的总和——9 GB/s + 3 GB/s 的对应读取专家的速度比单高速驱动器快 ~33%,同时 OMP 并行引脚/预热加载流来自两者。
值得了解的细节:
- 镜子是启动时验证(每个文件大小 + 安全张量头必须与主文件字节相同);发散或缺失文件静默留在主文件上,因此部分镜面没问题——一个只装有部分碎片的小型第二SSD依然有用;
- 镜子是未写作:
.coli_usage,.coli_kv所有边车都留在主车上; - 镜像读取错误会退回主硬盘(一次警告,无崩溃),因此在运行中拔掉第二个硬盘会降低性能,而不是导致服务器死机;
- 路由从不更改令牌——两个副本字节相同,且每次运行
MIRROR:统计显示每个硬盘服务的GB数据。
同一个引擎涵盖了整个系列:在25GB笔记本上,所有内容都从磁盘流式传输(虽然慢但正确);在大型主机上,整个专家设备会常驻(CUDA_EXPERT_GB=auto PIN_GB=all)而磁盘完全退出解码路径。
在两层之间放置了学习缓存:该发动机记录专家你的工作负载路由到 (.coli_usage,每回合更新),并自动钉住最热的节点——colibrì 使用越快。
在多插槽主机上,COLI_NUMA=1在内存控制器之间交错常驻权重(#82).
对于第二个无法保存整个模型的驱动器,Colibri可以从它已经学习到的专家历史中对部分镜像进行排序。先运行几个代表性的提示,这样.coli_usage反映工作负载,然后规划、分阶段并验证镜像:
./c/coli mirror plan  --model /fast/glm52_i4 --mirror /second/glm52_i4 \
  --budget-gib 200 --reserve-gib 20
./c/coli mirror stage --model /fast/glm52_i4 --mirror /second/glm52_i4 \
  --budget-gib 200 --reserve-gib 20
./c/coli mirror verify --model /fast/glm52_i4 --mirror /second/glm52_i4
规划器直接读取安全张量头,跟随从的分割模型目录COLI_MODEL_DIRS,并优先选择能够服务最热门路由专家的分片。分阶段从不改变主模型:它通过临时文件复制,保留请求的空闲空间预备,用SHA-256验证每个分片,从不删除现有的镜像分片,只有在选定镜像准备好后才原子发布收据。
永远不要等两次光盘
漏掉代价高昂,因此引擎大部分时间都在避免和重叠它们:每个专家的三个矩阵相邻存储,并合读于一个中pread;一个有界异步输入输出池(PIPE=1, 默认) 加载缺失专家,而常驻专家计算;批处理位置读取每个独特专家一次(批次联);以及一个路由器-前瞻线程(PILOT=1预取下一层的专家——路由是可测量的71.6%可预测,领先一层.在GPU上,常驻流水线(COLI_CUDA_PIPE=2)将残余流在设备上跨层保持,使CPU专家循环不中断;在苹果硅片上,一个实验性金属后端对统一内存GPU进行批量专家计算;以及Vulkan 后端它为任何搭载Vulkan 1.2驱动的GPU带来了专家级、密集投影和MLA关注核心——包括通过Mesa/RADV的AMD显卡(这是厂商堆栈不再支持的显卡唯一后端,如RX 580,且在RDNA4上与ROCm竞争——详见基准测试笔记).
在真实的NVMe上,测量DIRECT=1.O_DIRECT绕过页面缓存,且在拥有DRAM缓存和带宽余量(+34%解码,测量为PIPE=1在Blackwell/Windows设备上;在GB10的iobench中运行4.25→9.69 GB/s)——但这取决于驱动器:无QLC/DRAM或虚拟化的磁盘可能是中性到负极。先试试看;保留你的硬件所奖励的部分。
忠实模型,压缩状态
前传的经过验证时,会被验证为transformersoracle(教师强制,通常为30-32/32;两个微小oracle位置为浮点近平局且依赖工具链)。MLA关注存储压缩的KV状态——576个浮点数/令牌,而非32,768个(57×更小)——并且在重启时持续存在(.coli_kv):对话以温热状态重新开启,零重新填充,字节与未中断的会话完全相同。
DSA 稀疏注意力(GLM-5.2 的闪电索引器)忠实实现并通过强制全键选择精确重现密集注意力来验证。
说实话,这只是推测解码
GLM-5.2的原生MTP头会选秀代币,主模型会一次性批量转发验证——支付时每批验证2.2–2.8个代币。两个艰难获得的规则默认发布:MTP头必须是IN8(INT4 的接受度崩塌至 0–4%,#8),且draft和verify必须计算相同的功能—SPEC_PIN=1两者都指向一个内核家族(#163是完整的法医故事)。
语法强制草稿(GRAMMAR=file.gbnf对受限的JSON输出添加~免费接受度。是否推测是净赢取决于你的缓存温度——测量并使用DRAFT=0当它不值得时。
它的成就
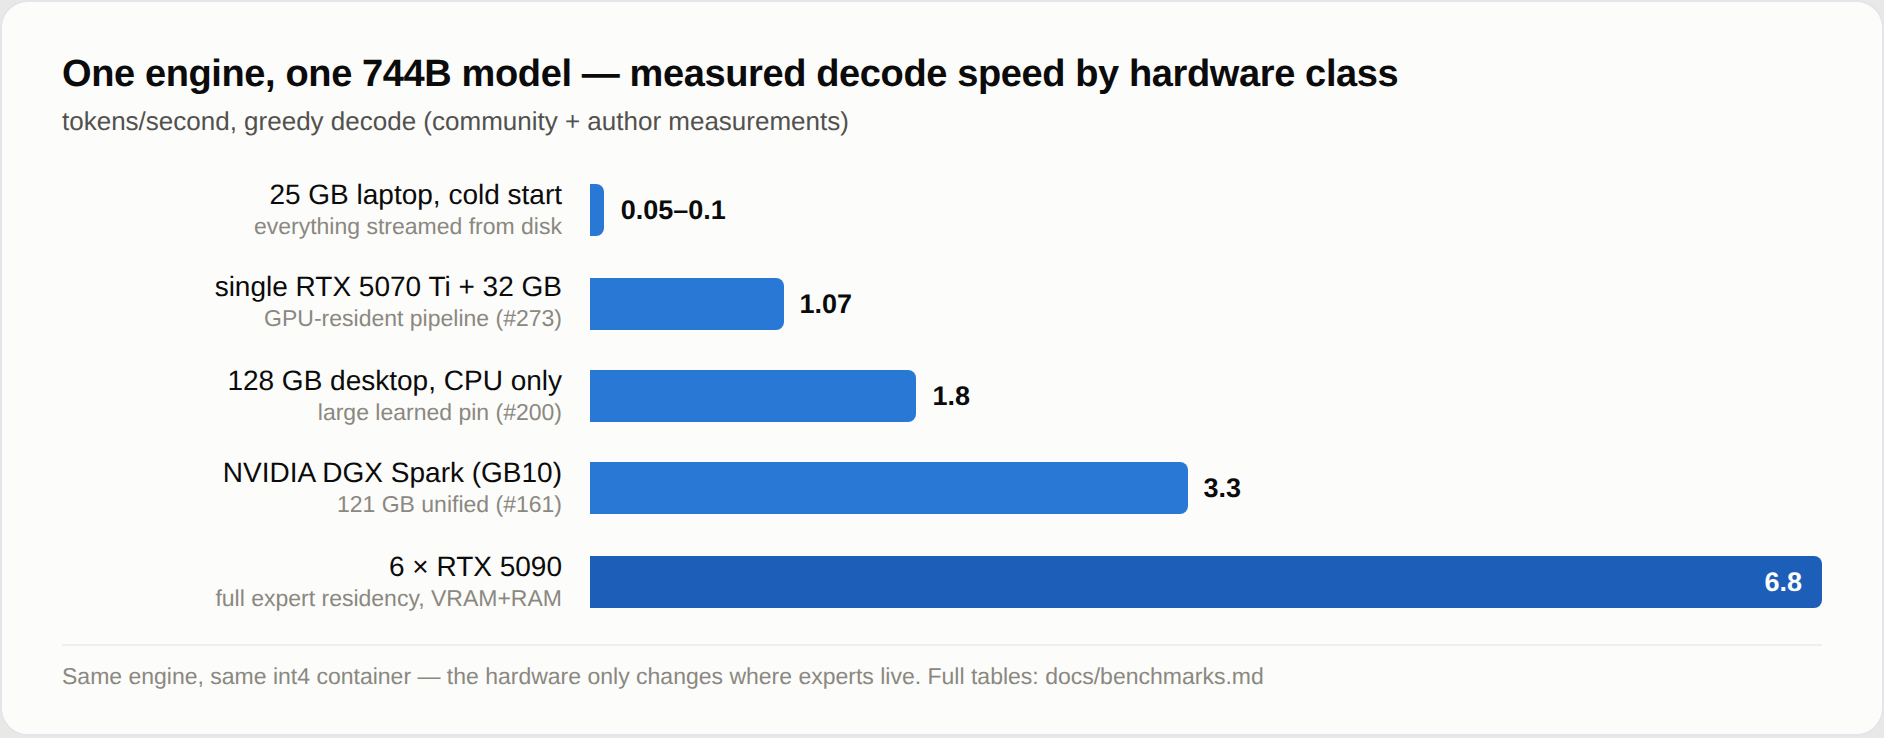
同一个引擎,同样的int4容器——硬件只有专家所在地才会变。精彩内容来自完整基准测试表:
- 6× RTX 5090,完整驻留:5.8–6.8 tok/s 译码,TTFT ~13 秒 (实验日志);
- 128 GB 仅 CPU 台式机:~1.8 tok/s 温热 (#200);
- 单台RTX 5070 Ti笔记本级机箱:通过GPU驻留流水线实现1.07 tok/s (#273);
- 25GB开发盒:0.05–0.1 tok/s 冷——这是该项目起点的验证底线,也是诚实的基线。
质量是测量的,而非假设:int4容器的量化成本和尺度粒度/旋转消融存在于docs/benchmarks.md以及#108/#81.
开始
你需要两样东西:项目介绍(几百KB)和模型(372 GB)。每个平台的逐步解析快速入门指南.
1. 获取colibri
下载预编版本—— Linux、macOS 和 Windows,无需编译器。获取你平台的档案发行作品然后拆解它:
mkdir colibri && tar xzf colibri-v1.8.0-linux-x86_64.tar.gz -C colibri && cd colibri
python3 coli info                         # engine ready ✓
里面是发动机 (colibri,colibri.exe在Windows上,以及coli启动器及其Python辅助工具。无需重命名或配置——coli找到发动机就在自己旁边。你只需要Python 3安装:启动器和 API 网关都是 Python 脚本,而引擎本身是纯 C 语言,没有任何依赖。
或者直接从源头构建—— 需要gcc(或称“咔哒”声)与OpenMP一起:
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh                                # checks gcc/OpenMP, builds, self-tests
想要coli在你的道路上?从结账处说,pip install -e .会被记录(发动机仍然存在于c/—— 从克隆中可编辑安装,而非轮子)。
2. 获取模型
一辆预装的GLM-5.2 int4容器在拥抱脸上——使用群体比例(GS64)用int8 MTP 头部.它关于372 GB,所以把它放到一个和房间一起的盘子里,最好是快速的:
https://huggingface.co/mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp
⚠️ 使用该GS64容器在上面,而不是老式的每行 int4 镜像 (mateogrgic/…,jlnsrk/…这些在质量上比 ~9pp 低,是原始思考模式循环和永不终止世代的根本原因。#455.gs64 容器修复了那些受控的每行 A/B 控制,但它不是通用的重复或 EOS 饥饿保护。MTP 头也必须是int8,不是int4(INT4 → 0% 选秀接受率,#8):ls -l /out-mtp-*— int8(正确)是3527131672 / 5366238584 / 1065950496.
或者自己从FP8源头转换——一个可恢复的命令,永远不需要一次使用完整的756 GB磁盘:
./coli convert --model /nvme/glm52_i4 # download+convert shard by shard (python, one-time)
其他支持的型号
GLM-5.2是参考模型,但同样的流式传输方法运行另外六个家族。每个家族都是兄弟机——一个C文件,它自己的架构,相同coli chat/coli serve/coli web前端(发射器从模型的二进制中选取config.json):
每个人的需求。这些要求差异很大,把其中两本放在一起读会让人误以为它们是互相矛盾的(#191).它们不是——它们是不同的模式。它们都不需要显卡。GPU只会让它更快。速度由你的磁盘决定,因为专家是从磁盘中流式传输的——慢速硬盘每秒只有几分之一的令牌,快硬盘且缓存热起来时每秒只有几分之一。
模型 用于权重的圆盘 内存 GPU OLMoE ~7 GB(int8 容器) 8 GB 不需要 GLM-5.2/5.3 ~372 GB 16GB 最小,24 GB 舒适 不需要 GLM-5.3-闪光灯 ~195 GB 转换 25 GB(int4 下 12 GB 权重 + 专家缓存) 不需要 墨水 ~469 GB 带int4密集容器时25 GB,不带时约120 GB 不需要 Kimi K3 ~1.6 TB 32 GB+ 不需要 DeepSeek V4 闪光灯 ~167 GB(REAP 150B:~85 GB) 16GB 最小,32 GB 舒适 可选;任何 NVIDIA 显卡,从GTX 10系列起(通过Pascal/图灵通过 CUDA_ARCH=portable-pre-ampere NO_TC=1(在RTX 50上表现最佳)可以实现5-10倍的预填充,解码速度大约2.5倍Qwen3.8-闪电-Next ~185.5 GB(官方FP8检查点) 默认情况下,16GB最宽松,24GB。 不支持;仅限 CPU Qwen3.6-35B-A3B ~20 GB(int4-gs64 容器) 24 GB(需要满载内存) 可选;CUDA 显存专家级1.44 -> 10.05 kps(7.0x)在两张8GB卡上,输出与CPU位相同
| 家庭 | 总/活跃 | 权重 | 建造 | 文档 |
|---|---|---|---|---|
| GLM-5.2/5.3 | 744B / 40B | mastouri/…-int4-g64-with-int8-mtp(372 GB) | make -C c glm | 本页 |
| 墨水(思考机器) | 975B / 41B | nbeerbower/Inkling-colibri-int4(469 GB) | make -C c inkling | inkling.md |
| GLM-5.3-闪光灯(Z.ai) | 321B / 40B | zai-org/GLM-5.3-Flash—— 转换为INT4-GS64路线专家、密集的BF16支架,精度是装载时的选择;视野包括 | make -C c glm53 | glm53-flash.md |
| Kimi K3(登月计划) | 2.8T / 104B | moonshotai/Kimi-K3——原始检查站,溃败的专家留下原生MXFP4 | make -C c kimi_k3 | kimi_k3.md |
| DeepSeek V4 闪光灯 | 284B / 13B | 官方碎片检查站——被淘汰的专家依然留守原生FP4,密集的支条 fp8-e4m3;该REAP修剪后的150B(puwaer/DeepSeek-V4-Flash-0731-reap-150b, 85 GB,256名专家中的132名)装载相同发动机且无改装 | make -C c deepseek-v4 | deepseek-v4.md |
| Qwen3.8-闪电-Next(阿里巴巴) | 125B + 51B n-gram / 6B | Qwen/Qwen3.8-Flash-Next-FP8——原始检查点;PLE保持可呼叫,专家保持原生块-FP8 | make -C c qwen38(仅限CPU) | qwen38.md |
| Qwen 3.6(阿里巴巴) | 35B / 3B | Kreuzzelg/qwen36-35b-a3b-colibri-i4-gs64(~20 GB,推荐)——混合门控注意力+门控DeltaNet | make -C c qwen36(CUDA=1适用于显存专家级) | qwen36.md |
| OLMoE(AW2) | 7B / 1B | 改装后c/tools/convert_olmoe_merged.py—IN8container, ~7 GB | make -C c olmoe | — |
Qwen3.6运输三只预装箱:INT4-GS64(推荐——测量int8锚点余弦值为0.98777→0.99313和KL0.109→0.080,即每行量化误差减少~44%)每行 int4作为A/B基线,KAT-Coder v2.5,同一引擎不更改地运行——任何架构相同的检查点都无需自己的代码路径即可工作。
其中CUDA=1显存专家级的测量1.44 → 10.05 tok/s(7.0×),两张8 GB卡,输出与CPU路径比特相同。
Kimi K3无需转换:其QAT训练的MXFP4专家直接从原始Hugging Face碎片中流式传输,bf16密集集在加载时量化。长代理会话可以选择进入循环状态检查点(COLI_K3_CKPT=N内存中的插槽,或存储在磁盘上COLI_K3_CKPT_DIR编辑或后续提示恢复最深的存活检查点,仅预填充尾部,而非通过SSM层重放整个对话。在Vulkan主机上K3_VK_UP=auto根据测量的带宽,计算专家层的上传规模。引擎的 KDA 和 MLA 路径在 CI 中与厂商实现进行令牌精确验证。
Inkling CP 是 int4 专家,但BF16 致密砝码(49.4 GB 驻留);在无法承载这些的主机上,inkling.md有一个一次性工具,可以将密集集扩展到15.3 GB,并且975B能在25 GB的机顶盒上运行——而且要把权衡写下来。
3. 运行它
COLI_MODEL=/nvme/glm52_i4 ./coli chat     # RAM budget, cache and MTP auto-detected
COLI_MODEL=/nvme/glm52_i4 ./coli plan     # inspect the planned VRAM/RAM/disk placement
COLI_MODEL=/nvme/glm52_i4 ./coli doctor   # read-only readiness check
COLI_MODEL=/nvme/glm52_i4 ./coli doctor --deep  # strict tensors/shards/index/mirror preflight
COLI_MODEL=/nvme/glm52_i4 ./coli tune     # measure and save this machine's fastest safe execution profile
./coli web  --model /nvme/glm52_i4        # API + dashboard, and opens a browser
./coli serve --model /nvme/glm52_i4       # API + dashboard, no browser (headless)
在Windows上,版本归档会发布coli.cmd:双击即可快速启动,或者直接跑coli.cmd chat --model D:\glm52_i4来自 cmd 或 PowerShell。
从 source 检查,同样的命令也适用于python coli chat --model D:\glm52_i4.该.exe文件是引擎,不是启动器:它们单独启动时没有模型需要立即加载和退出。
运行时的引擎是纯 C 语言——Python 只被一次性转换器和可选的 API 网关使用。
同样的命令适用于运行任何模型
coli模型的config.json选择匹配引擎二进制,渲染该家庭的聊天模板——没有关于不同型号命令行变化的事.先组装一次你想要的引擎,然后直接指向COLI_MODEL在正确的目录中:
make -C c glm                                     # GLM-5.2
make -C c inkling                                 # Inkling
make -C c kimi_k3                                 # Kimi K3

COLI_MODEL=/nvme/glm52_i4      ./coli chat        # TUI
COLI_MODEL=/nvme/inkling_i4    ./coli chat
COLI_MODEL=/nvme/kimi_k3       ./coli chat

./coli web --model /nvme/inkling_i4               # API + dashboard, opens a browser
./coli web --model /nvme/kimi_k3
./coli serve --model /nvme/inkling_i4             # API + dashboard, no browser
对于非GLM发动机coli chat在本地启动网关并附加 TUI,这样 TUI、API 和仪表盘都经过同一个 arch 感知的聊天模板——你永远不必自己传递模板。
有两点不同型号的区别,均在模型页面中详细说明:
- 关于RAM紧凑主机的Inkling需要int4密集容器和一个小型专家缓存:
./coli chat --model /nvme/inkling_i4 --cap 2(参见inkling.md—— 默认--cap 8需要在驻留集顶部加成~14 GB缓存)。 - Kimi K3从原始检查点流式传输MXFP4专家,因此无需转换——但快照容量为~1.6 TB(参见kimi_k3.md).
4. 深入挖掘
| 主题 | 医生 |
|---|---|
| 基准、社区数据点、质量衡量 | docs/benchmarks.md |
| 调优旋钮、策略、学习缓存、预取 | docs/tuning.md |
| Windows 11原生构建(+ CUDA DLL) | DOCS/Windows.MD |
| CUDA后端,显存专家级,全驻地 | docs/cuda.md |
| Vulkan后端(任何显卡:通过RADV的AMD,包括ROCm已下架的显卡) | docs/vulkan.md |
| 苹果硅金属后端 | docs/metal.md |
| 兼容OpenAI的API、KV插槽、网页仪表盘 | docs/api.md |
| 实验层段嵌入ABI | docs/segment-runtime.md |
| 实验性分词器/嵌入/头 Edge ABI | docs/edge-runtime.md |
| 语法强制草稿(结构化输出) | docs/grammar-draft.md |
| 环境变量清单 | docs/ENVIRONMENT.md |
深度搜寻 V4
DeepSeek V4 闪光灯官方检查点直播且无转换:被淘汰的专家留下原生FP4,稠密集保持FP8-E4M3支持UE8M0块缩放。MLA+DSA的稀疏关注,43层,256名路由专家及1名共享的前6名。
支持x86-64/aarch64 Linux和Windows/MSYS2(CPU),并可选CUDA层(Windows运行时DLL;LinuxCUDA=1直接链路,在WSL2下验证),保持每一阶段CPU规范,并每阶段回退。
cd c
make deepseek-v4
python ./coli chat --model /path/to/DeepSeek-V4-Flash --ram 32
# also: coli run / coli serve / coli web
# Windows CUDA tier: make cuda-dsv4-dll CUDA_ARCH=portable  (+ make cuda-dsv4-dg-dll on RTX 50)
两个可选的GPU拉杆是新的,正在寻找社区数字,既默认关闭,也在未设置时字节相同:DSV4_HYBRID=1利用运行时测量的带宽,将显存级未命中分配到GPU填充分支和CPU分支之间,COLI_CUDA_MOE_DOUBLE=1(在COLI_CUDA_MOE_BATCH=1)将下一层的完整专家集预取到第二个显存银行,当前层计算,显存不足时退回到单一银行。
CUDA层现在也运行在Pascal和图灵卡(GTX 10 / RTX 20系列)上:构建为CUDA_ARCH=portable-pre-ampere NO_TC=1.
贪婪的解码和一个KV插槽。工具调用通过HTTP网关有线连接,使用V4的原生提示符和DSML调用块;不支持语法。参见每个引擎的API矩阵.前缀检查点(内存中+磁盘上)使代理会话和后续回合在系统提示首次预填充后几秒内开始。
在RTX 5080 + 2 NVMe上测量:3324令牌预填充90秒,8.3k令牌首次轮~4分钟一次,后续会话/回合6-9秒,解码约1.6 tok/s,3k上下文 — 参见docs/deepseek-v4.md.
给它内存。43×256个路由专家在磁盘上占137 GiB,令牌触及其中301个,因此专家缓存命中率决定了 tok/s —--ram是最有价值的旋钮,它只改变速度,从不输出。
投机性选秀存在,且是不合适的。DSpark的马尔可夫生成器和完整的MTP都已实现并验证:选秀可以保存前传,但永远不会更改令牌,因为每个被接受的令牌仍然是目标自己的argmax。
在真实多回合聊天中,他们接受的次数为1/15,10个是24个,而该引擎重复注意力状态的拒绝后缀重放成本超过了选秀——一个14个令牌的答案耗时495秒。
所以V4_DRAFT以及V4_MTP默认为0代码和旁边的数字会保留,留给那些用更快存储重试的人。
参见docs/deepseek-v4.md用于CUDA层(构建、DLL选择、GPU覆盖)、环境参考、性能数据、检查点验证以及生成的微小独立预言机。
接下来是什么
- 推理系统研究是成果。当前的层级结构是LRU + 一个学习到的引脚集;主动工作涵盖模型格式、压缩、布局、调度、I/O、CPU/GPU内核、异构重叠、KV状态以及路由感知的推测。目标是降低硬件需求和降低每个有用令牌的成本。所有内容都按照本项目的工作方式进行:端到端测量、公开审查和开发。
- 更多开放模式。分层算法与模型无关:任何带有路由专家的 MoE 都可以以相同方式分级。目前运行八个家族(GLM-5.2、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash、Qwen3.8-Flash-Next、Qwen3.6、OLMoE);更多开权重系列——迷你极限在候选人中——像前八名那样获得引擎:当有人测量一台发动机的端对端。
支持项目
Colibrì最初是一个人项目,运行在一台配备25GB内存的12核笔记本上;如今,其数据来自一个真实机器社区。如果对你有用:
- ⭐ 给仓库加星并分享;
- 🐛 硬件基准数据的未解决问题——数据点对项目的推动力超过其他任何事;
- 💬 加入Discord社区讨论实验、硬件结果和研究方向;
- 💬 通过GitHub Issues联系我们,赞助开发或捐赠硬件。
仓库布局
Makefile                  root build/check entry point
c/
├── colibri.c             GLM-5.2 engine  (make glm)
├── inkling.c             Inkling engine  (make inkling)
├── kimi_k3.c             Kimi K3 engine  (make kimi_k3)
├── deepseek_v4.c         DeepSeek V4 Flash engine  (make deepseek-v4)
├── qwen38.c              Qwen3.8-Flash-Next text engine  (make qwen38)
├── qwen36.c              Qwen3.6 engine  (make qwen36)
├── olmoe.c               OLMoE engine  (make olmoe)
│
├── st.h                  safetensors index and range reads
├── quant.h               canonical container decoders
├── tok.h, json.h         tokenizer and JSON parser
├── compat.h              Windows/macOS shims (POSIX names, one place)
├── expert_store.h        streaming expert cache
├── route_trace.h         routing telemetry and .coli_usage, engine-agnostic
├── kv_prefix.h           KV prefix reuse across turns
│
├── backend_cuda.*        optional CUDA tier   (CUDA=1)
├── backend_metal.*       optional Metal tier  (METAL=1)
├── backend_vulkan.*      optional Vulkan tier (VULKAN=1)
│
├── Makefile              build and local checks
├── coli                  user-facing CLI
├── openai_server.py      OpenAI-compatible HTTP gateway
├── resource_plan.py      RAM/VRAM planner behind `coli plan` and `coli doctor`
├── tools/                offline conversion, fixtures and benchmarks
├── scripts/              long-running conversion helpers
└── tests/                dependency-free C and Python tests
web/                      browser UI (pure OpenAI-API client)
desktop/                  Tauri v2 desktop shell wrapping the web UI
docker/                   container images
docs/                     reference docs, experiments, media
一.c按型号系列,基于共享单头。引擎拥有其架构,其他不拥有;两个引擎都需要的东西——安全存储器读取器、容器解码器、分词器、专家缓存——都存在它们共同包含的头部中,因此修复可以同时到达所有引擎。
这条规则并非装饰性:这里反复出现的缺陷是机械落在一个引擎上却未到达其兄弟引擎的缺陷。
从仓库根开始,make,make check以及make clean将任务委托给Makefile机车。
为什么叫“colibrì”
蜂鸟体重只有几克,会停在原地,每天会拜访千百朵花。这个引擎靠着蜂鸟的配给维持着一个拥有7440亿参数的巨兽:25GB内存、12个CPU核心和大量磁盘耐心。
致谢
Colibrì是一台引擎;它驱动的大脑是一份礼物。感谢那些在公开场合释放边疆级重量的团队——Z.ai(GLM),登月计划 AI(有些),阿里巴巴Qwen,迷你极限, 和艾伦 AI(OLMoE)——以及所有对基准测试、分割、复制地图集运行或发送补丁的贡献者。
这个项目证明了开放权重带来的可能。
该项目的专业布置、压缩和布线实验也基于以下公开研究和系统工作的理念和证据:
- 收割以及EASY-EP因其输出感知和领域特定领域的专家重要性。
- 晚间对于基于相似度的专家重路由,ReMoE用于缓存局部感知路由器的微调。
- MC-SMoE用于路由引导的专家合并和压缩。
- MoBE以及D²-MoE用于共享专家基地和低阶专家三角洲。
- HybriMoE对于混合CPU/GPU专家调度,科学部用于与计算的专家通信重叠,OD-MoE用于分布式按需专家加载。
- vLLM,llama.cpp, 和k变形金刚对于开放推理系统和专家卸载工作,使比较变得可重复。
发动机不仅仅基于理念,还基于具体工程成果。这些成果至今都被应用或重新实现在树中:
- 安全张量器—— 每个发动机读取的容器 (
c/st.h),包括其FP8和I64 d型。 - tiktoken(提克代币)—
c/tok.h重新实现其byte_pair_encode没错,合并连接词汇ID最低的相邻对,因此Tiktoken衍生词汇不需要合并列表。 - llama.cpp—— 中的 GBNF 语法子集
c/grammar.h遵循其语法和栈集的PDA,金属路径借用了newBufferWithBytesNoCopy住院医师的技巧。 - vLLM——发动机逐位置匹配输出语义的参考(例如,最终范数相对于LM头部的着陆点)。
- 变压器—— oracle:CI 以 token 为其 Random-init 模型的 token 进行
- DietGPU—— 实验性压缩专家层背后的 GPU ANS 编解码器(
COLI_ANS). - rocWMMA——HIP后端映射CUDA的
nvcuda::wmma片段/mma_sync API (c/backend_gpu_compat.h),这使得一个.cu源代码可以同时编译两个厂商。
许可
Apache 2.0。GLM-5.2 权重由Z.ai在麻省理工学院。