NVIDIA Developer

RSS: https://developer.nvidia.com/blog/feed/
NVIDIA 开发者平台,为 GPU 加速开发、AI 模型训练等提供资源、工具与文档。

AI 原生设计:构建 NVIDIA TensorRT Model Connect 的经验教训

NVIDIA 开源项目 TensorRT Model Connect 提供 C++ 形式的 AI 模型参考实现,基于 TensorRT 构建。文章总结该项目围绕 coding agent 设计时形成的工程经验:并行开发、模型族隔离、可回滚变更、GPU 驱动验证等。 目标让 NVIDIA 推理栈的性能对更多开发者更友好,属于机构技术博客,视角偏官方复盘。
评论点赞收藏20 小时前

使用 NVIDIA VSS 蓝图 3.3 降低构建和运行视觉 AI 智能体的成本

NVIDIA 发布 Metropolis 视频搜索与摘要(VSS)蓝图 3.3 更新,面向基于视觉语言模型的视频 AI 智能体提供开箱即用的架构。重点解决视频数据接入、流处理、事件检测、检索、摘要和报告组合成的可维护系统问题,并附带 agent skills 帮助开发者降低构建和运维成本。 属于 NVIDIA 开发者博客的例行版本发布通稿,缺少具体 benchmark、成本对比或用户案例等一手信息。
评论点赞收藏20 小时前

NVIDIA DSX MaxLPS 如何最大化 AI 工厂的吞吐量与效率

NVIDIA 发布 DSX MaxLPS,通过策略驱动的动态功率共享机制,让 AI 工厂中多台设备协同使用电力预算,而非为每块 GPU 预留峰值功率缓冲。 目标是减少常态下未充分利用的电力容量,提高整体吞吐与能效。文章为 NVIDIA 官方开发者博客,偏产品功能说明,缺少第三方验证、具体能效数据或用户实测,讨论入口有限。
评论点赞收藏2 天前

生物基础模型的高效 MoE 训练

NVIDIA 开发者博客讨论用 Mixture-of-Experts (MoE) 架构降低生物基础模型训练成本:稠密 Transformer 每个 token 都过所有层,随规模扩大计算量线性增长;MoE 把网络拆成多个专家子网,每个 token 只激活一小部分专家,从而在增加能力时控制训练和推理开销。 文章聚焦生物领域基础模型的 MoE 训练效率,面向关注生物+AI 交叉的工程读者。
评论点赞收藏6 天前

介绍 NV-Reason-CT:面向放射科医生链式思维推理的开源 3D CT 视觉语言模型

NVIDIA 发布开源 3D CT 视觉语言模型 NV-Reason-CT,专门针对放射科医生链式思维推理场景。文章指出当前通用 VLM 在体积成像(3D CT)上表现差,开源医疗 AI 也普遍缺乏相关能力。 该模型面向临床最丰富、数据密度最高的 3D CT 模态,提供放射科医生风格的逐步推理输出。正文在截断处不完整。
评论点赞收藏6 天前

在 AI 工作负载落地前验证 GPU 集群的就绪状态

NVIDIA 开发者博客提出一个实操观点:GPU 集群可能通过所有健康检查(每张卡、网络链路、Pod 都显示正常),但在跑 512-GPU 训练任务时仍会性能不达标甚至失败。 常见根因包括单卡略慢、链路在负载下劣化、配置把流量悄悄走慢路径等问题,且往往要跑几小时甚至到任务失败后才暴露。文章主张在 AI 工作负载正式上线前做"就绪性验证",即模拟真实训练负载的端到端压测,而不是只依赖逐项健康检查。 文中提到 NVIDIA 相关的验证工具/方法,并给出排查思路:定位慢卡、检查链路带宽随负载的衰减、核对路由/配置是否走慢路径。对正在部署大模型训练集群的运维和平台工程师有直接参考价值,属于实操类指南。
评论点赞收藏6 天前

用 NodeWright 管理 Kubernetes 节点集群

NVIDIA Developer 博客介绍了 NodeWright,一款用于管理 Kubernetes 节点集群的工具。文章指出 Kubernetes 本身只管理节点上运行的工作负载,而节点层面的内核配置、系统包、存储布局、安全代理及 GPU 工作负载依赖的主机级调优仍依赖 Ansible、自定义脚本和人工手册,在跨区域新集群部署或内核升级影响 RDMA 时容易出问题。 NodeWright 旨在以声明式方式统一管理这些节点级配置,降低运维复杂度。内容偏产品宣传,但触及 GPU 集群运维的真实痛点,有一定讨论价值。
评论点赞收藏6 天前

SWE-Serve 如何揭示本地测试与线上服务之间的差距

NVIDIA 开发团队与 SGLang 团队合作推出 SWE-Serve,一套包含 53 项任务的评测框架,用于检验 AI 编程代理在修改推理服务(inference serving)软件时的真实可靠性。 核心发现:代理产出的补丁可能通过所有本地单元测试,但在服务端加载真实模型并处理实际请求时仍然失败——因为只测了函数层而没覆盖完整的 serving 路径和公共接口。 SWE-Serve 把评测粒度从"代码能否通过测试"提升到"系统在真实请求下能否返回正确结果",直指当前 AI coding agent 在基础设施类任务上的系统性盲区。 文章信息密度较高,对关注 Agent 评测和 LLM 推理服务的读者有实际参考价值;但内容为 NVIDIA 官方博客发布,叙事偏机构视角,缺乏个人踩坑经验或锐利观点,讨论入口相对有限。
评论点赞收藏6 天前

NVIDIA 机密计算:让生产级 AI 推理更快且更私密

NVIDIA 开发者博客介绍如何在生产环境中用 Confidential Computing 实现私有高性能 LLM 推理:通过内存加密的机密虚拟机(CVM)和机密 GPU,把敏感数据和专有模型上下文跑在受信任环境里,适用于个人、企业、受监管等场景。 文章偏方案介绍与架构说明,面向 AI infra 从业者,但缺少一手性能数据、踩坑经验或可争论观点,讨论入口有限。
评论点赞收藏7 天前

NVIDIA Topograph:拓扑感知的 AI 工作负载调度

NVIDIA 推出 Topograph,面向 AI 工厂的拓扑感知工作负载调度工具。核心问题是 GPU 集群受功耗上限约束,工作负载放错位置会割裂拓扑域、让数据跨共享链路,导致吞吐下降、成本上升,GPU 空耗电力却只等数据。 Topograph 通过理解 GPU 互联拓扑(如 NVLink 域)做放置优化,把通信密集的任务放在拓扑相邻的 GPU 上,减少跨域流量。对自建 GPU 集群做调度优化的工程师有实用价值,但内容偏产品介绍,缺少一手实测数据或踩坑经验,讨论入口有限。
评论点赞收藏7 天前

游戏开发者新动态:DLSS 5 3D 引导神经渲染、NVIDIA ACE 更新及 RTX Kit 新能力

NVIDIA 开发者博客发布面向游戏开发者的多项更新:DLSS 5 引入 3D 引导神经渲染,允许开发者在保留艺术意图的同时为游戏添加更逼真的光照和材质细节,并提供更细粒度控制;同时介绍 NVIDIA ACE 在角色 AI 方面的更新、RTX Mega Geometry 2.0 的高密度几何处理,以及 RTX Kit 在渲染工作流中的新能力。 属于 NVIDIA 官方产品发布公告,信息集中在功能概述层面,缺乏深度技术拆解或开发者实操经验。
评论点赞收藏8 天前

用 AI 智能体与 NVIDIA Isaac ROS 加速 ROS 2 节点

文章指出,仅靠高速 CUDA kernel 并不能保证整个 ROS 2 图执行高效:节点间消息仍在 CPU 内存中反复序列化与拷贝,会削弱感知/AI 负载留在 GPU 上的收益。 NVIDIA 借助上游抽象与新的 CUDA buffer backend,并引入 AI Agent,帮助开发者把 ROS 2 节点性能瓶颈从 GPU 算子转移到数据搬运层,让 Isaac ROS 上的计算图更流畅。 对正在做机器人感知/实时推理的工程者,这是把 GPU 加速真正落地的实操方向,讨论点在于 ROS 2 中间层开销与 CUDA 缓冲共享的工程细节。
评论点赞收藏8 天前

NVIDIA TensorRT 多设备推理:在多 GPU 上简化模型服务

NVIDIA 在 TensorRT 11.0 中引入多设备推理能力,允许单个 TensorRT 网络跨多张 GPU 执行,底层使用 NCCL 分布式集合通信,同时保留 TensorRT 的推理优化。 该功能面向生成式 AI 计算和内存需求超出单卡场景,并集成到 Dynamo-Triton 服务框架中。属于 NVIDIA 官方技术发布,信息具体但视角单一,对做多卡推理部署的工程师有参考价值,讨论入口有限。
评论点赞收藏8 天前

如何评估 AI Agent:从工具调用到任务完成

NVIDIA Developer 博客讨论 AI Agent 评估方法论。核心观点:真正部署 Agent 时,关键不是单次函数调用是否"说得对",而是它能否在真实环境中完成数十步顺序工具调用,并在某步失败后恢复。 "模型回答听起来合理"与实际"工作是否完成"之间存在显著差距,因此 Agent 评估必须从单步函数调用评分转向整条任务链的最终完成度评分。 内容偏框架性介绍,具体方法和指标细节在正文展开。
评论点赞收藏8 天前

用 AIPerf 对 LLM 推理进行大规模基准测试

NVIDIA 发布 AIPerf,用于在部署 LLM 时做大规模推理基准测试。文章先指出常见做法——手写 curl、asyncio 脚本或一次性压测工具——受限于单进程、GIL 和缺乏标准化对照。 AIPerf 提供分布式压测能力,支持大规模并发、标准化指标采集,帮助判断模型在特定硬件与配置下的真实性能表现,减少因测试方法不一致导致的误判。 适合需要生产级 LLM 推理性能评估的工程师。
评论点赞收藏11 天前

如何用 AI Agent 为仿真准备 3D 场景

NVIDIA 开发者博客介绍用 agentic AI 工作流为物理 AI 系统准备和验证数字孪生的流程:AI Agent 可以检查 3D 场景、在 OpenUSD 中写入仿真相关数据、添加物理属性、渲染预检视图,并按 SimReady 要求校验结果。 文章展示从 Blender 场景到 NVIDIA 仿真就绪 OpenUSD 交付的完整链路,面向做机器人/仿真 pipeline 的工程读者。
评论点赞收藏13 天前

TensorRT Edge-LLM 在 Jetson AGX Thor 上将 MLPerf Edge Agentic 基准任务速度提升 6.4 倍

NVIDIA 开发者博客介绍 TensorRT Edge-LLM 在 Jetson AGX Thor 上运行 MLPerf Edge Agentic Benchmark 的结果,称比基线快约 6.4 倍。 文章把 AI 智能体(agent)从云端推向边缘设备作为背景:agent 不是单次问答,而是在多步流程中调用工具、评估结果并持续推理,对边缘推理的 token 生成速度和长上下文维护提出更高要求。 内容偏产品能力与基准性能展示,主要面向 Jetson/Edge 部署的技术读者。
评论点赞收藏13 天前

用 Agentic AI 把 CUDA Tile 操作从 Python 翻译成 Rust

NVIDIA 开发者博客介绍 cuTile Rust(cutile-rs),一个面向 Rust 的 tile 化 GPU kernel 编写系统。它把 Rust 所有权模型扩展到 tile 化 GPU kernel,将可变输出拆成互不重叠的片段,并在 kernel 启动时保留 host 端所有权契约;需要更低层控制时可以局部退出该约束。 文章的核心场景是用 Agentic AI 把 CUDA tile 操作从 Python 翻译到 Rust,属于 GPU 编程工具链与 Rust 生态交叉方向。对关注 Rust GPU 开发、CUDA 工具链演进或 AI 辅助代码迁移的读者有信息增量,但内容偏官方技术发布,缺少个人踩坑或强争议点。
评论点赞收藏13 天前

NVIDIA 发布 Rust 原生 GPU 编程:两条轨道写 GPU 内核

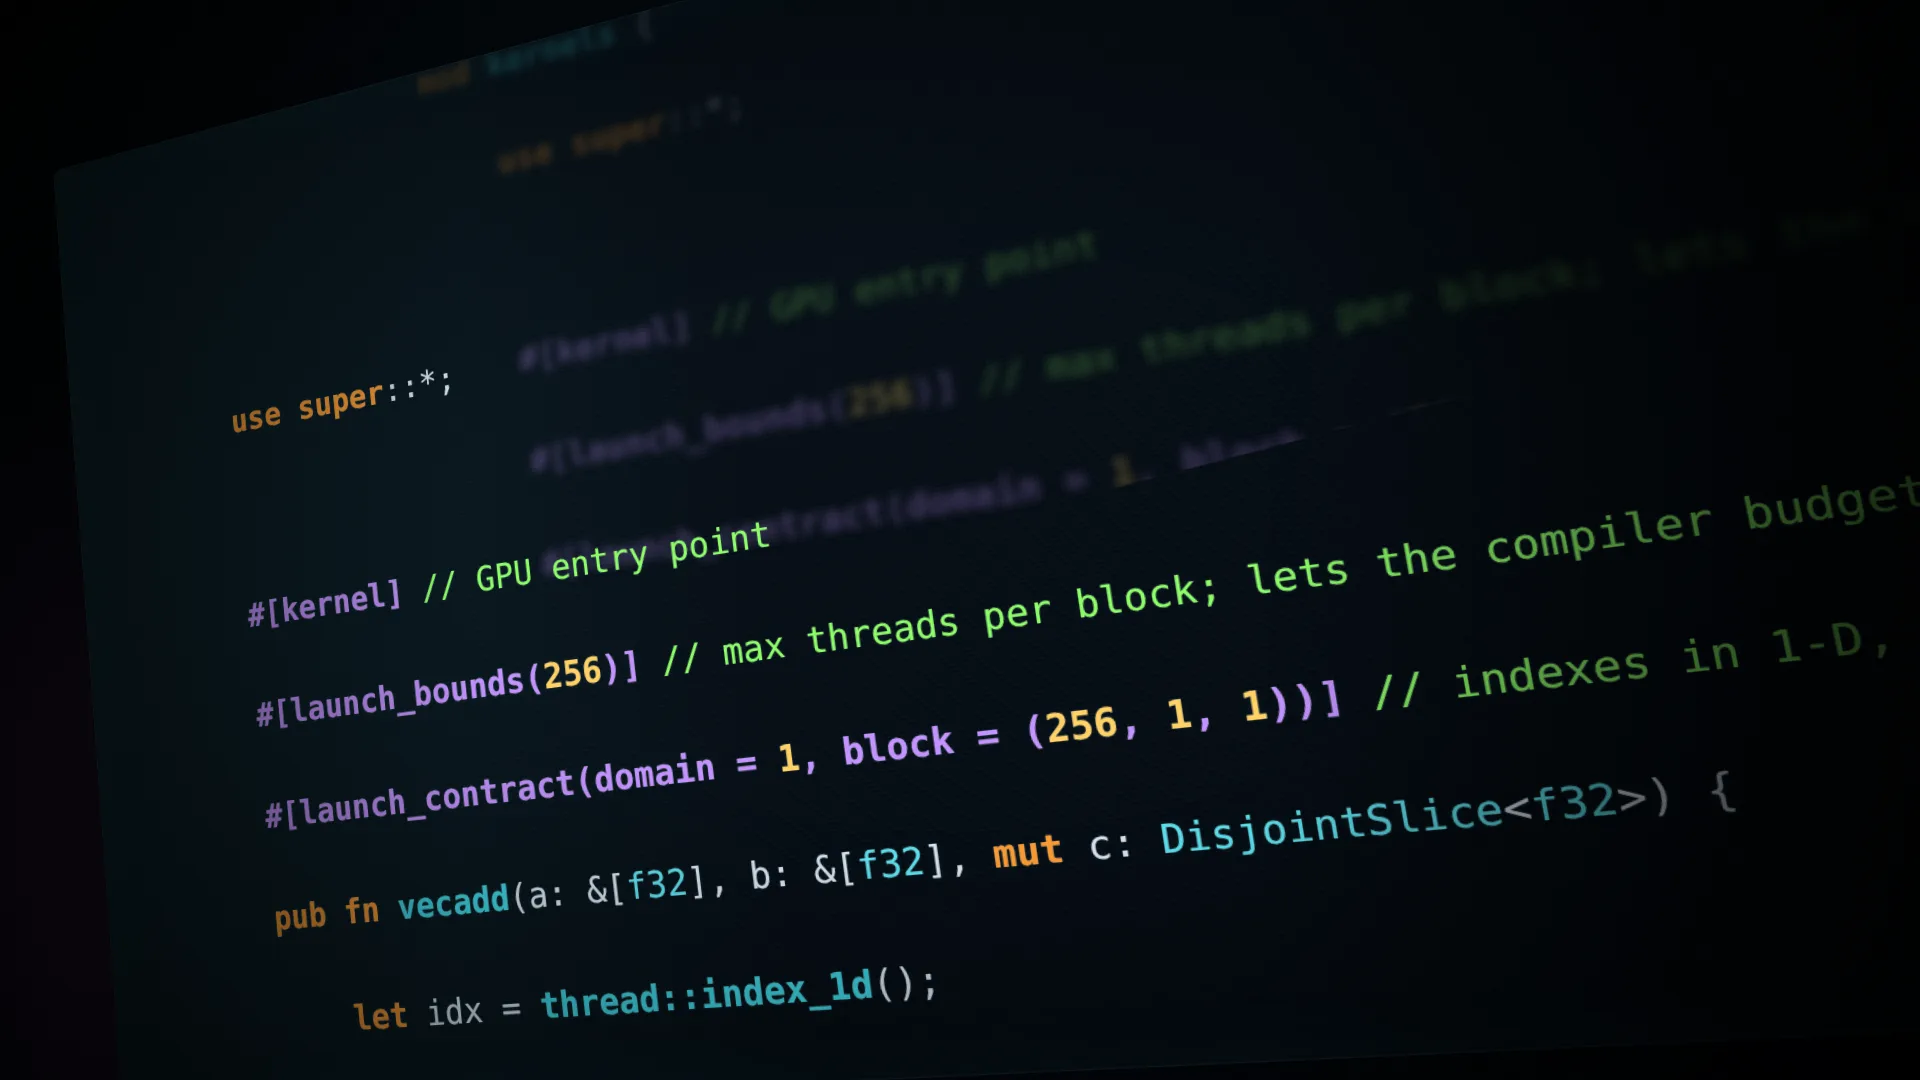
NVIDIA 宣布推出 CUDA Rust,让 GPU 内核可以直接用 Rust 编写并原生编译为 PTX,不再只是 C++/Python 的封装。方案分两条轨道:SIMT 轨由 cuda-oxide 实现,基于自定义 rustc codegen 后端(Rust MIR → Pliron IR → LLVM IR → PTX),需要 nightly 工具链;Tile 轨由 cutile-rs 实现,在 stable Rust 上操作 tile 级张量,编译器决定线程映射,依赖更轻。 文章给出同一个 1024 元素向量加法在两条轨道下的完整可运行示例,重点讲安全模型:DisjointSlice 把可变借用拆成每线程独占片段,Tile 轨靠 partition 保证独占所有权,编译器在编译期拦截 aliasing 错误。 目前两者都还是早期(cuda-oxide 早 alpha,cutile-rs 已发布到,被 HuggingFace Grout 和 使用),API 会变动,作者邀请社区提交 issue 和共建。
评论点赞收藏14 天前

Dense 模型 vs MoE 模型:激活参数、吞吐与选型时机

NVIDIA 开发者博客用 Nemotron 3.5 Lightning 作为例子,讲清 Dense 模型和 Mixture-of-Experts(MoE)架构在“每个 token 实际激活多少参数”上的差异:MoE 可以拥有 30B 总参数但每 token 只激活约 3B,从而在推理吞吐和算力成本上获得优势,同时保留大模型的容量。 文章面向工程/推理部署场景,讨论两种架构在吞吐、延迟、显存占用和适用场景上的取舍,适合正在选型或评估本地/边缘部署 LLM 的读者。 属于厂商技术科普,立场偏 NVIDIA 产品生态,但机制解释清晰,有实际参数对比,适合作为 MoE vs Dense 选型的入门参考。
评论点赞收藏14 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。