语言模型用于文本分类:从词袋到 Jev
<p>最近发布的过去两周,人工智能模型在技术社区中成为了一种相当大的文化现象。</p><p>虽然Jev旨在对事物进行分类,但人们很容易把Jev当作“只是一个分类器”,而我对Jev的看法在过去几天里发生了很大变化。特别是,我的想法从“分类器曾经是我的拿手好戏;我可以轻松自己构建这个”(稍后会详细说到)变成了“哇,这实际上比我想象的还要好用。”</p><p>当然,最新的GPT和开放权重LLM可以完成与Jev相同的分类任务,同时还能进行更广泛的决策。但Jev的优势在于它能更快更低成本地处理这些分类任务。</p><p>在另一端,对于一个狭窄且明确的问题,Jev可能不会给任何比专用分类器更好、更快或更便宜的分类。但它的卖点在于它比那些任务专用模型更通用。</p><p>那么,Jev(基于有根据的猜测)背后的方法论是什么?它能做什么,为什么它如此受欢迎?我打算在文章后面回答这些问题。不过,我认为从简要的语言模型决策模型历史开始是个很好的起点。<br><br>希望这能帮助揭开一些炒作的神秘面纱,展示Jev的出色之处(“Jev本质上是一个文本分类器”,但“Jev也不仅仅是一个文本分类器”)。</p><p><em>附言:我与Jev没有任何关联。另外,我没有免费获得Jev的访问权限,这也不是产品推荐,只是一篇技术文章,旨在提供一些关于文本分类历史的见解,帮助你理解最近的炒作。</em></p><p>既然这是一篇较长的文章,<strong>我推荐,</strong>你可以在左侧访问目录菜单。</p><h2>1. 变换器出现前时代的语言建模与分类</h2><p>为了完整起见,在我们把Jev…</p> 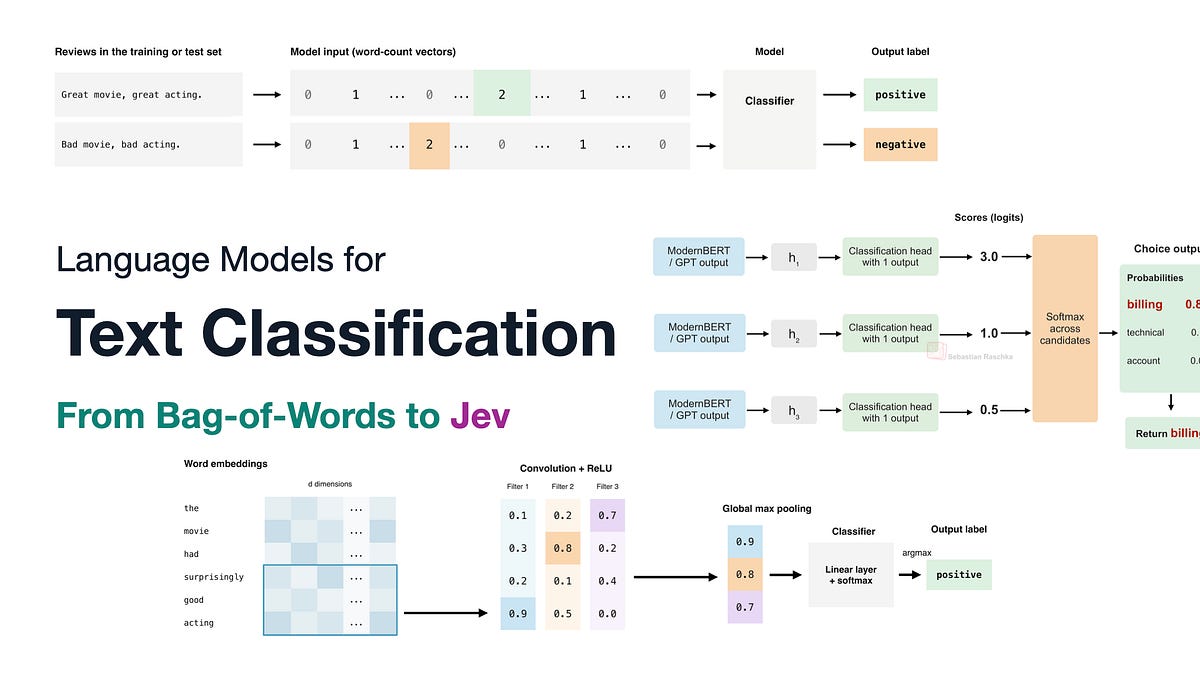
 评论
 点赞
 收藏


