语言模型用于文本分类:从词袋到 Jev
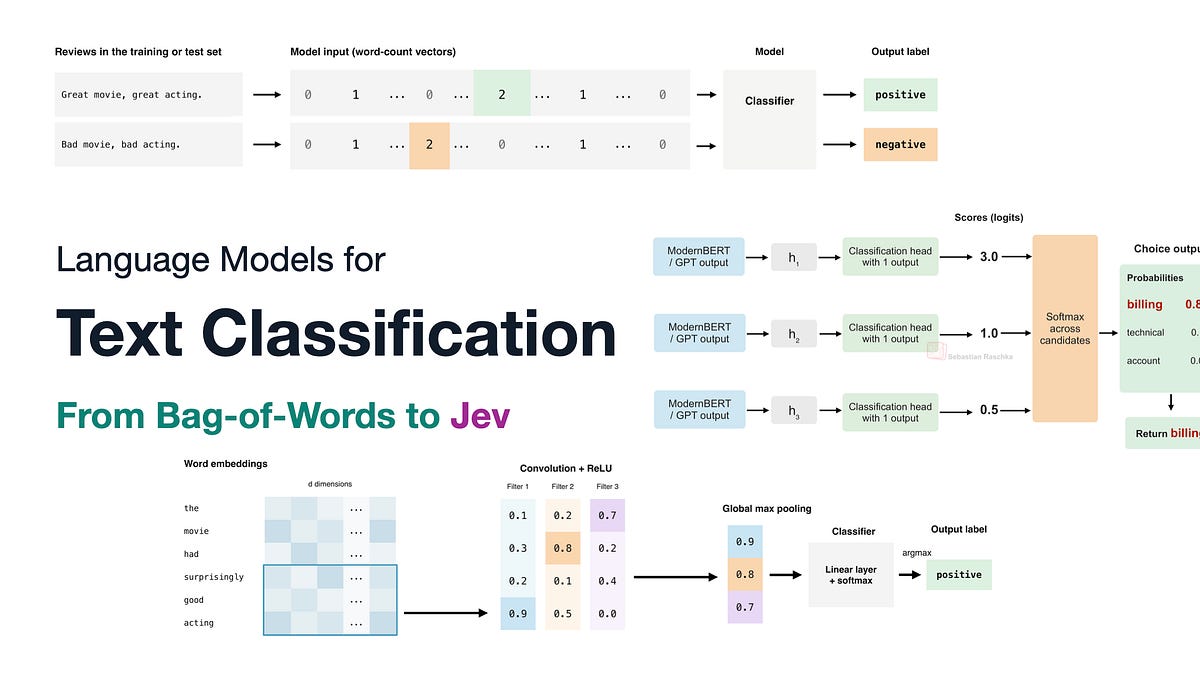
最近发布的紫杉过去两周,人工智能模型在技术社区中成为了一种相当大的文化现象。
虽然Jev旨在对事物进行分类,但人们很容易把Jev当作“只是一个分类器”,而我对Jev的看法在过去几天里发生了很大变化。特别是,我的想法从“分类器曾经是我的拿手好戏;我可以轻松自己构建这个”(稍后会详细说到)变成了“哇,这实际上比我想象的还要好用。”
当然,最新的GPT和开放权重LLM可以完成与Jev相同的分类任务,同时还能进行更广泛的决策。但Jev的优势在于它能更快更低成本地处理这些分类任务。
在另一端,对于一个狭窄且明确的问题,Jev可能不会给任何比专用分类器更好、更快或更便宜的分类。但它的卖点在于它比那些任务专用模型更通用。
那么,Jev(基于有根据的猜测)背后的方法论是什么?它能做什么,为什么它如此受欢迎?我打算在文章后面回答这些问题。不过,我认为从简要的语言模型决策模型历史开始是个很好的起点。
希望这能帮助揭开一些炒作的神秘面纱,展示Jev的出色之处(“Jev本质上是一个文本分类器”,但“Jev也不仅仅是一个文本分类器”)。
附言:我与Jev没有任何关联。另外,我没有免费获得Jev的访问权限,这也不是产品推荐,只是一篇技术文章,旨在提供一些关于文本分类历史的见解,帮助你理解最近的炒作。
既然这是一篇较长的文章,我推荐,你可以在左侧访问目录菜单。
1. 变换器出现前时代的语言建模与分类
为了完整起见,在我们把Jev放进上下文中(无意双关),我认为按时间顺序开始最合理。在本节中,我想简要介绍通过朴素贝叶斯、逻辑回归以及更经典的(深度)神经网络进行分类,直到基于变换器的模型出现。
1.1 词袋:朴素贝叶斯、逻辑回归与XGBoost
15年前我还是研究生时,尽管循环神经网络已经存在(后面会详细说),文本分类通常用单词袋表示,因为这很简单,也能在中等规模的数据集上得到不错的结果。
简而言之,我们可以把词袋表示看作一种方法,使不同长度的自由文本输入能够兼容经典分类器(如朴素贝叶斯、逻辑回归、单变量表、随机森林、XGBoost等),而这些分类器期望输入向量是固定大小的。
流行的现实应用包括新闻文章分类到邮件垃圾邮件过滤等各种功能。据说,Gmail最初的垃圾邮件过滤器也采用了带有词袋表示的朴素贝叶斯模型。
顺便说一句,我写过这件事正好是12年前。这是我在arXiv上分享的第一件事之一。
那么,这个单词袋表示法到底是什么?这是一种转换不同长度自由文本的方法,例如,
- 训练示例1:“《Zentropa》是我近年来看过的最原创的电影。如果你喜欢受黑色电影影响的独特惊悚片,那么这部电影正是解决如今那些充斥影院的好莱坞夏季大片的最佳良方。冯·提尔的续作如《破浪而出》获得了更多赞誉,但这才是他最出色的作品。”
- 培训示例2:“这部电影简直糟糕透顶。约翰·里特做了笨拙的跌倒,75%的演员说台词时像是在念提示卡,剪辑糟糕,音效混音糟糕。”
- 训练示例3:“《Zentropa》与《第三人》有许多相似之处,后者同样是一部设定在战后欧洲废墟中的黑色电影风格。”
转换为上述“经典”分类器的固定大小表示。(上述示例摘自常见的IMDb电影评论分类数据集.)
词袋模型从构建词汇开始,词汇表包含训练集中的所有独特词(可选地,可以去除所谓的停字,如“a”和“the”,这些词在大多数语境中几乎没有语义意义)。
单词袋表示法通过赋予词汇表中的每个词在向量中的位置,从而产生这些固定大小的输入。然后我们计算每个词在文档中的出现频率。例如,如果词汇表有5万个独立词汇,它生成一个固定大小的向量,包含5万个词条,无论输入是十个单词还是30万个词。
注意大多数词条为零,因为每个文档只包含词汇的一小部分。(除了表示原始计数,还有如TF-IDF这样的规范化方案。)
然后,一旦有了这些词频向量,我们可以在带标签的训练集上训练分类器,比如标注为垃圾邮件或非垃圾邮件的邮件。例如,逻辑回归模型会学习特征权重,将某些词(和字数)与特定标签相关联。
例如,某些词可能增加预测的垃圾邮件概率,而其他词语可能会降低。
这种方法计算成本低,当特定词汇能提供关于标签的强烈线索时效果良好。在简单的分类任务如垃圾邮件分类中,这通常足以获得快速且相对准确的结果。
但这种方法最大的缺点之一是,由于词袋表示的特性,它会丢失词序。例如,“the dog bites the man”和“the man bites the dog”虽然描述不同事件,但产生的向量是完全相同的。
(有一些变通方法可以通过添加词对或更长的序列(称为n-gram)作为特征来保持局部顺序,尽管这会增加词汇量。)
尽管存在不足,我仍然认为词袋在某些低风险应用中有其用处,因为它非常便宜,词袋表示 + 逻辑回归仍然是我处理每个文本分类问题的首选基线,因为它非常容易实现。
1.2 用于文本分类的深度神经网络
前面提到的词袋模型也可以用(简单的)深度神经网络,比如多层感知器。但缺点仍然是我们会失去句子结构和词序。
然而,更复杂的神经网络架构避免了单词包式的变通方法:卷积神经网络(CNN)和循环神经网络(RNN),它们可以将词嵌入作为输入。
1.2.1 词嵌入
首先,在将输入文本输入模型之前,我们必须将它们转换为合适的表示。其中一种表示是单词袋。另一种是单词嵌入向量。区别在于,单词袋向量通过计算每个词汇出现的频率来表示整个文本,而单词嵌入则将单个单词表示为密集的学习数字向量。
- 词嵌入的工作原理类似于大型语言模型中的嵌入层,即将输入词转换为密集向量。嵌入可以在模型之外进行(例如,两种经典且流行的学习方法包括Word2Vec以及格洛夫),或者嵌入层可以作为神经网络架构的一部分,在模型训练过程中被学习和调整。这些经典嵌入在查找时是上下文无关的。例如,单词“bank”在“river bank”和“bank account”中获得相同的向量(你可能知道,上下文可以通过注意力等概念来处理)。关于嵌入的更多资源,你可能会觉得以下内容有帮助:
- 第二章:文本数据的处理(这是一章大型语言模型,但应该能让你了解嵌入单词或词号的要点;在大型语言模型分词器中,我们会将词分成子词词;在Word2Vec中,1个词通常就是1个词。)
- 理解嵌入层和线性层的区别(这是一个示意图,展示了嵌入向量在数学上等价于线性层和矩阵乘法。)
1.2.2 循环神经网络(RNN)
由于你们中许多人可能熟悉循环神经网络(RNN),我将本节简短说明。RNN是自然语言处理中经典的神经网络架构,流行的变体可追溯到20世纪80年代和90年代初。
变换器,于2017年引入(使用RNN首次引入的注意力机制;参见我的理解大型语言模型仅有一段时间),随后逐渐在许多自然语言处理应用中取代了它们。
RNN一次只读一个单词,像读文本一样。每一步,它们将当前的单词嵌入(前一节讨论)与前一步的隐藏状态结合起来。我们可以把隐藏状态看作一个固定大小的向量,用来总结目前处理的文本,因此词序变得重要,因为重新排列单词会改变状态更新顺序。
注意,上图展示了展开表示中的RNN。也就是说,RNN为每个输入重复使用相同的层栈,因此称为“循环”。而且因为它是“循环”,输入文本的长度可以任意。
下图并排展示了“递现”与展开表示的过程。注意两者展示了相同的架构,只是可视化不同。
RNNs以难以训练而闻名,RNN有一些重要的改进,比如长短期记忆(LSTM)网络,于1997年引入,以及门禁循环单元(GRU),于2014年引入,利用学习门控制信息的保留和更新方式。
(还有较新的xLSTM:延长的长短期记忆,于2024年推出)。
此外,状态空间模型的灵感来自于固定大小的隐藏状态顺序更新的理念,这比变换器注意力更便宜。然而,瓶颈仍然是隐藏状态能保留多少信息,而且仍然需要顺序处理。
(趣闻:注意力最初是在变换器架构出现之前为RNN开发的,但这是另一个故事;我在我的理解大型语言模型文章。)
归根结底,RNN可以用来训练文本分类器。回到IMDb电影评论数据集,带逻辑回归的词袋分类器在平衡数据集下约有89.9%的准确率,而LSTM的RNN仅达到85.66%。
是的,RNN可能更难训练(请关注下方ULMFiT方法,它能以更高的精度训练RNN)。
需要注意的是,这个RNN是从零开始训练的。更好的方法是先在更大的数据集上预训练模型,然后在这个目标数据集上进行微调(传统上,我们称这种方法为“迁移学习”)。
在自然语言处理领域,提出这种方法的最具影响力的论文之一是ULMFiT(2018年),该书在IMDb上取得了令人印象深刻的95.4%测试准确率。
1.2.3 卷积神经网络(CNN)
你可能知道卷积神经网络(CNN)是因为它们在计算机视觉中的应用。不过,虽然历史上较少见,但也可以用卷积神经网络来获取文本。
如上图图像分类示例所示,CNN对图像补丁(窗口)应用学习滤波器。同样,在自然语言领域,我们可以对相邻词嵌入的窗口应用学习滤波器。
如上图所示,一个窗口大小为三的卷积滤波器对相邻的三个词组使用相同的权重。然后,当它滑过输入时,它会逐个词移动滤波器,在“电影表演出乎意料地好”的部分。
这样就有四个窗口(为了简化不考虑填充):
- 1:“电影曾经”
- 2:“电影出乎意料地”
- 3:“出乎意料地好”
- 4:“出乎意料的好演技”
所以,在最后一层,在分类头之前,我们可以先把结果进行平坦化或全局最大池,然后再连接到分类头。虽然扁平化保留了所有信息,但根据文本输入长度,产生的矢量大小会不同。
(例如,如果“电影的表演出乎意料地好”更长,我们会得到更长的特征图。)所以,为了实现输入长度无关,全局最大池会是更好的选择。
简而言之,我们可以将文本CNN可视化如下图所示。
另外,好处是不同位置的滤波器计算可以并行运行,避免了RNN的逐步依赖。
为了快速对比,在前面提到的IMDb数据集上,我的实验显示这样的CNN大约有90.07%的准确率(但请注意,这高度依赖于架构;例如,你可能从计算机视觉领域知道准确度差异很大)。
(例如,老牌AlexNet在ImageNet上的前一准确率有~62.5%,而ConvNeXt V2-H的准确率为88.9%。)
2. 变压金刚
2017年,原始变压器架构被引入注意力就是你所需要的全部论文。由于这个话题已经被广泛讨论(包括我和其他人),我将重点关注与分类相关的方面。
但对于对注意力机制及其他架构细节感兴趣的人,请参见我的相关文章:
关键点在于,最初的变换器架构是一个用于语言翻译的编码-解码器结构,但它也可以轻松地用于文本分类任务,正如我在后续章节中展示的那样。
2.1 编码器风格语言模型
我对原版变革金刚架构发布后的最初几年记忆犹新。那段时间基本上是两种不同方法之间的竞争所定义的:
- 编码器风格模型,如BERT,主要由谷歌开发;
- 像GPT这样的解码器风格模型,主要由OpenAI开发。
编码器式模型是自然的文本分类器,而GPT模型可以作为一种涌现特性进行零样本和少数样本分类,但它们的优势更多体现在生成任务上。
但我们先从编码器式模型开始,了解如何微调和利用它们来分类文本。
使用变换器(无论是编码器还是解码器)的一个普遍特点是,我们使用在大文本语料库上预训练的模型,除了将它们用作零样本或少数样本分类器外,还可以在目标数据集上进行微调(类似于之前RNN部分提到的ULMFiT)。
如图所示,摘自BERT论文(2018)下文,BERT/编码器风格模型在第一位置有一个分类标记,我们可以方便地微调它。
虽然BERT模型远不如自回归GPT式变换器流行,但幸运的是,仍有人偶尔更新和现代化它们。最近我常用的一个分类任务例子是2024现代伯特模特。
如下所示,IMDb电影评论显示,ModernBERT几乎无需微调就能获得约95%的准确率。
2.2 解码器风格的大型语言模型
像GPT这样的大型语言模型是解码式的自回归变换器,是生成文本和代码的全部注意力中心(无意双关)。
然而,正如我在第6章中解释的从零开始构建大型语言模型作为对微调的温和入门(在涉及指令微调之前),我们也可以将其重新用于文本分类。
当然,我们也可以直接提示LLM,如下图所示。
然而,如果我们想要结构化输出,并且有特定的目标领域,这种做法就变得不必要地脆弱且效率低下。
相反,我们可以用更精简的分类头替换输出层,如下图所示:
微调有一些注意点。例如,由于自回归注意力掩膜,我们必须谨慎设计微调,使分类标记包含序列中所有其他标记的信息。
如果你对更多技术细节感兴趣,请参阅我最近的端到端介绍从零开始构建AI文本检测器文章:
总体来说,使用GPT风格的大型语言模型相较于BERT变体的优势在于有许多现代的开权重架构可供采用。从小型Qwen 3 0.6B模型到最新的Kimi、GLM或DeepSeek模型。
(当然,从效率角度看,使用这些>1B参数模型分类可能有点过头,但这也是可能的。)
图20:在上述IMDb电影评论数据集中,一个相对较小的GPT-2 1.24亿模型准确率约为92%;更大且更新的大型语言模型(如最近的Qwen3变体)表现可能更好。
2.3 编码-解码器风格架构
虽然最初的变换器架构(编码器-解码器)分为两种范式:编码器式模型如BERT和解码式LLM如GPT,但也曾尝试使用编码器-解码器式变体,最近的变体(有些意外地)是DeepSeek V4.1 闪存.(不过,在这种情况下,它是因果编码器,而不是像T5那样的双向编码器。)
继续聚焦编码-解码器结构用于分类,最突出的候选可能是谷歌2019年的产品T5(文本对文本传输转换器).
在架构上,T5 与原始变换器之间的差异包括架构更新(如下总结)以及训练方式的变化。原始变换器被训练为进行语言翻译(以监督方式);T5 使用未标记文本的预训练,带有间距损坏,编码器接收缺失的文本,译码器生成缺失的显距。
现在,我们可以通过添加分类头,类似于上述其他RNN、CNN和变压器方法使用T5。
此外,我们还可以通过训练让解码器输出类别标签的预测(类似于IMDb电影评论数据集中的“正”或“负”),类似于普通大型语言模型。我们称这种方法为文本对文本分类。
虽然GPT风格的LLM训练于大量文本,但它们通常能在开箱即读的情况下完成文本对文本的分类,如前所述(下图为方便再次插入此处)。
然而,对于T5来说,通常会进一步微调解码器,以便在特定目标域内更好地处理这类任务。
对于T5,两种方法都有效。以下是总结:
3. Jev概述
到目前为止,我们看到文本分类方法有很多种,从传统的逻辑回归和带有词袋表示的朴素贝叶斯方法,到提示最新的前沿大型语言模型如GPT-6,或是用分类头微调任何开权重的大语言模型(或文本对文本分类)。
起初,我(几乎)把它当作“只是一个分类器”,这是我经常为带有自然语言输入的分类任务编写的(例如,参见我的人工智能检测器文章作为最近的公开例子)。
3.1 Jev 与现有文本间分类
不过在继续讨论之前,我们先简单介绍一下Jev。Jev 是 TypeSafe AI 发布的新模型几周前刚从隐形中亮相,引起了大量关注(起初看起来有点奇怪,因为它看起来就像一个分类器)。
Jev 是一个专有模型(尽管发布后有大量快速的开源克隆,但我们稍后会详细说明),使用成本相对较低,声称在决策方面与 GPT-5.6 Luna 相当,同时速度和成本都快上几个数量级:
这里,关于GPT-Luna,可以把它看作之前讨论的文本对文本分类方法。
那么,为什么会有这么大的炒作?我觉得部分原因是它的 API 很不错,而且它在各种任务上表现都很好,所以不需要自定义微调。
例如,我可以用它来分类支持工单/邮件(我做了一个视频版本来展示回复时间):
或者,我可以让同一个模型实时玩俄罗斯方块(这里我用的是Choice API):
也许在进入技术细节之前,简明扼要地解释一下:就像2022年的ChatGPT令人兴奋,因为它是一个通用的聊天模型,能够生成各种文本,而科技界对Jev充满热情的原因之一,是因为它是ChatGPT分类的时刻,它可以廉价地分类各种文本输入,而无需为每个任务微调自定义分类器。
(截至目前为止,关于其架构和具体训练算法知之甚少,只知道一位创始人说它是通过“校准决策的强化学习”训练的,但稍后会详细说明。)
3.2 Jev API
过去几年,我们已经习惯了用更大、更好、更昂贵的GPT风格LLM来应对各种问题,对于有针对性的决策或分类任务,像Jev这样廉价快速的方法对大多数人来说可能很新鲜。
尤其是对于一次性任务,收集训练数据和微调定制ModernBERT听起来太繁琐,我们可能会直接用类似Luna的模型来处理。
但除了因其多功能性(即开箱即用的不同目标域表现良好)而受欢迎外,Jev 还有一个相对不错的 API,我们可以通过终端的 curl 或其 Python API 使用。
简而言之,下面展示了三种主要的 API 类型。我们先从 Choice API 说起,它方便于多类分类。
接下来是Noul API,它更简单,会为问题赋予“是”的概率。
最后,Score API根据评分标准等级(如下例中为0、1、2)分配分数。
总结来说,不同的API和使用场景如下。
3.3 Jev对IMDb的分类
为了让这些API更具体,并回答Jev在上述IMDb数据集上的表现如何,我们可以用Choice或Noul API运行。
我们先从Choice API说起。每篇评测的格式如下:
export TYPESAFE_API_KEY="YOUR_API_KEY"

curl -sS https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
    "questions": {
      "sentiment": {
        "type": "choice",
        "instructions": "What is the overall sentiment of this movie review?",
        "criteria": {
          "negative": "An overall unfavorable opinion of the movie",
          "positive": "An overall favorable opinion of the movie"
        }
      }
    }
  }'
如果我们想为二进制(这里)或多类问题使用显式标签,这个 Choice API 非常方便。
实际的回应可能如下:
{
  "model": "jev-1.13.0",
  "answers": {
    "sentiment": {
      "type": "choice",
      "choice": "positive",
      "confidence": 1.0,
      "probabilities": {
        "negative": 0.0,
        "positive": 1.0
      }
    }
  },
  "usage": {
    "input_tokens": 342,
    "output_tokens": 32
  }
}同时"choice": "positive"标签,我们还获得了该预测的置信度,这在现实应用中非常有用,以及每个类别的概率。(置信度场总结了概率分布的集中度。它与分配给获胜类别的概率不同。)Jev 的一个卖点是,根据文档,这些概率已经过良好校准(但校准后面会详细说明)。
另外,我们也可以在这里使用Noul API来分类影评。使用相同的电影影评分类语境,格式如下:
curl -sS https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "The acting was excellent and the story kept me engaged throughout. I would happily watch this movie again.",
    "questions": {
      "is_positive": {
        "type": "noul",
        "instructions": "Does this review express an overall positive opinion of the movie?",
        "criteria": {
          "true": "An overall favorable opinion of the movie",
          "false": "An overall unfavorable opinion of the movie"
        }
      }
    }
  }'
通过Noul API的答案是:
{
  "model": "jev-1.13.0",
  "answers": {
    "is_positive": {
      "type": "noul",
      "noul": 0.98
    }
  },
  "usage": {
    "input_tokens": 328,
    "output_tokens": 21
  }
}
(有趣的是,尽管是同一文本,正类的得出是0.98而非1.0。)
我们也可以通过每个类别提出一个问题来应用 Noul API,例如:
- “这篇文章是关于金融的吗?”
- “这篇文章是关于政治的吗?”
- “这篇文章是关于科技的吗?”
这里,每个问题(彼此独立)返回一个概率,且这些概率不必和为1。因此,对于多类分类且每条文本可以有多个标签,我们可能偏好Noul;对于只有一个最终答案的分类问题,选择法则增加了便利性。
现在,将Jev与Choice或Noul一起运行在测试集中的25,000条电影评论中,得到以下结果:
- 选择:
- 准确率96.47%(答对24,117条)
- 总时长:22分24秒
- 15,456,663个输入代币,总成本0.6492美元
- 新内容:
- 准确率96.20%(答对24,050题)
- 总时长:23分3秒
- 15,106,663个输入代币,总成本0.6345美元
注意,Choice 和 Noul 之间性能和运行时间的微小差异可能是由于随机波动,因为与其他大型语言模型类似,这些运行并非完全确定性的。
例如,我在同一测试集中第二次运行了Choice API,结果略有不同,如下所示。
(大规模服务LLM和其他模型时的非确定性,很可能是因为依赖批处理的GPU内核执行改变了浮点运算的顺序,正如一份好文档所述博客文章由何豪勒斯于去年完成。)
总之,整体结果看起来相当不错(需要注意的是:我们不知道IMDb测试集是否包含在训练集里)。
供参考,ModernBERT模型
- 训练台微调时间为23分钟;
- 7分钟用于测试组评估。
作为对比,最好的ModernBERT模型精度类似,如下所示(我预计通过额外的超参数调优仍能提高1-2%的精度)。注意,这是在DGX Spark上运行的,通过量化和更快的硬件,可以获得更快的推理性能。
但我们的ModernBERT模型,比如说,不能玩俄罗斯方块,或者除了电影分类外做其他事情,除非我们为新任务微调它。但我们可以给它用GPT-5.6或GPT-6的Luna模型(速度稍慢,成本也更高)。
一个经典的经验法则是:
- 一次性决策任务使用廉价的大语言模型(如GPT-6 Luna);
- 如果想反复做这个任务,就微调一个自定义分类器。
现在,像Jev这样的工具可以取代上述,a)降低延迟,节省比Luna省钱,b)省去微调定制模型的工作。(不过如果我们处理的是非常高的任务,想在非常具体的任务上最大化速度和精度,当然微调仍然有意义。)
4. 带有Jev API的BERT和GPT风格模型
当然,我们也可以在(现代)BERT或任何GPT风格模型上添加类似Jev的API。添加类似Jev的API相当直接。事实上,Jev一发布,我就构建了一个类似Jev的ModernBERT模型,展示构建自己Jev模型的简单性。
我决定不发布我的Jev克隆版,因为我改变了主意。也就是说,在ModernBERT上加一个类似Jev的API很简单,在很多分类任务上微调也很容易。
但要让这个模型在各种任务(比如俄罗斯方块)上都能顺利运行,除非经过大量培训和测试,这并非易事。(而且,现在已经有足够多快速的Jev克隆版在热度上升;世界不需要另一个快速克隆,但一个强力的开放权重版本当然会更好。)
不过,如果你对这种改造如何工作感兴趣,这里有一个简要概述。例如,我们可以通过向任何BERT、GPT或T5风格模型添加一个小分类头来实现类似Jev的Choice API,如前所述。
但该头部的输出节点并非与类别数量匹配,而是只有一个输出节点,如下面修改后的GPT模型所示。
之前,我们讨论过如何针对特定任务(如电影评论分类)进行微调这些模型,并预设多个类别标签(这里是“正”和“负”)。通过这种“1个输出节点”的设置,我们实际上可以将其扩展到灵活且任意数量的类别。
为了将其扩展到任意数量的类别(我们考虑将客户工单分为“计费”、“技术”、“账户”三类的三类情况),我们可以如图所示进行分类。
如上图所示,对于每个候选选项,我们向模型输入文本、任务指令和候选人描述。分类(评分)头将输出表示映射到单一标量分数。然后我们对候选分数应用软最大值,获得概率分布并返回最高概率选项。
这里的主要观点是,所提出的首脑每个类只有一个输出。每个类描述会产生自己的表示,同一头通过输出层(本质上是一个逻辑回归模型)进行评分:
其中
- 是的是类别标签的标量分数i;
- w是一个可学习的权重;
- b是一个可学习的偏置单元;
- 嗨是变压器在分类头之前的输出。
对于N候选人,这会产生N得分。Softmax随后回归N概率。学习到的参数和保持不变,当N变化。
注意对于嗨:
- BERT风格编码器模型使用最终隐藏状态
[CLS]令牌(可选择通过池层传递); - GPT风格的自回归模型通常使用最后一个非填充令牌的隐藏状态,这是因为前述的自回归性质(最后一个非填充令牌可以处理前述文本、指令和候选描述)。
然后,我们结合对正确选项的交叉熵损失对模型和评分头进行微调。由于所有候选者共享相同的评分头,我们可以在不改变架构的情况下更改选项数量和描述。
但同样,这种方法在不熟悉任务中的效果取决于训练数据。
顺便问一句,为什么选择基于BERT或GPT风格的变换器模型,而不是前面提到的更简单的RNN和CNN架构?从技术角度看,上述方法适用于这两种结构。
但基于变换器模型的扩展性非常好,意味着它们可以在更大的数据集上进行预训练,受益比其他模型更大。此外,它们还能很好地利用上下文中提供的信息(多亏了关注度)。
所以,如果我们希望模型能够很好地推广到不同的目标任务,而不必对每个任务都进行显式微调,那么在高质量数据集上预训练基于Transformer的模型,可能比基于RNN或CNN的模型更接近目标。
5. Jev 架构与训练算法
那么,为什么Jev在这么多不同任务上表现如此出色(从影评到玩俄罗斯方块这种随意的事情)?遗憾的是,架构、算法和训练数据的细节都没有公开。
另外,请记住,背后有一个专门团队和数百万美元的公司专门研发并投入了大量努力;我们不能指望通过在开放数据集上训练一个类似ModernBERT的模型一周就能达到那个水平的性能。
话虽如此,如果让我做出有根据的猜测,架构上我猜他们用的是类似ModernBERT的小型设备,因此延迟较低。
关于训练数据,如前所述,TypeSafe AI CEO说以下内容:
我们100%的数据都是合成的(但显然不是那种从大型语言模型里直接吐出来的垃圾)
所以,是的,我认为大部分精力都投入到了整理这个数据集上。这也是我多年来一直向学生和合作者宣传的理念。作为一个简短的轶事,大约八年前,我和社会科学系的另一位教授合作,帮助设计了一个文本分类问题的实验装置。
她的学生花了好几天时间对单词袋基线和BERT模型进行超参数调优,勉强获得约2-5%的准确率。然后我建议我们各自坐下来手工标记更多数据(我记得我们最初的数据集大约有300个样本,而且样本量翻倍了),结果准确率提升了>10-20%。
是的,这很重要剧情学习曲线为此:)。
最后是训练算法。同样,细节尚不清楚,但TypeSafe AI的博客文章州份他们使用的是一种名为校准决策强化学习(Reinforcement Learning for Calibrated Decisions,RLCD)的新算法:
“我们构建了一个全新的自动化技术栈:采用新的模型架构、并行采样器以实现最高效率,以及我们称之为校准决策强化学习(RLCD)的训练方法。”
该方法未公开。一项具有类似校准目标的已发表方法是RLCR(校准奖励强化学习),发表于2025年的论文超越二元奖励:培训LM们理性思考他们的不确定性.在提供更多细节之前,下一节简要介绍了校准的整体情况。
5.1 关于校准
校准并不是新话题,我建议任何生产模型使用并评估类成员概率时都要这样做。简而言之,校准会调整模型的概率估计,使其更符合观察到的类频率。
例如,再考虑我们的IMDb电影分类问题。模型可能给评论评级74%正面和26%负面。这些是概率估计,但模型可能过于自信或不足。我们不能在不评估校准的情况下假设数值可靠。
即74%阳性和54%阳性预测在50%阈值时均给出“正向”类别标签,尽管模型在74%情况下表达更强的置信度。
校准技术使用单独的标记数据集,例如保留验证集,来调整这些概率估计。在成功校准后,许多综述给出约74%的正面概率,实际上大约74%应为正面。
关于更多信息,我建议使用传统方法SCIKIT-Learn 文档。
对此有很多方法。例如,我在我的...中使用过的一种方法人工智能检测器项目是温度缩放。温度缩放通过一个温度除以模型的 logits (T) 在应用 softmax 之前的值。
我们学习T(一个正数)通过在校准数据集上最小化交叉熵损失来实现,同时保持模型权重固定。温度大于1会降低对最高概率类别的信心,而温度介于0和1之间会增加信心。
然后我们使用相同的温度进行新的预测。由于这种缩放保持了 logits 的顺序,因此在选择最高概率类别时,预测的类别保持不变。
5.2 带校准奖励的强化学习 (RLCR)
Jev 的 RLCD 培训方法仍然是专有的,但我们可以讨论一个相关的想法是带校准奖励的强化学习(RLCR),该计划于2025年推出超越二元奖励:培训LM们理性思考他们的不确定性论文。
(注意,这两种方法之间没有官方确立的联系,但我假设它们可能相关。)
带有可验证奖励的强化学习(RLVR)通常对答1,错误答复0。(想要全面的解释和实现,我建议参考我的从零开始构建推理模型书:)).
简而言之,RLCR对不准确的置信度估计增加了额外惩罚。
因此,在传统的RLVR方法中,奖励R根据答案正确性,是0或1(这里我们忽略了可选的格式奖励和长度惩罚,以简化起见)。
在RLCR中,模型生成推理和答案,随后进行不确定性分析和数值置信(q).这个修改后的奖励是
其中正确答案为1,否则为0。例如,置信度为90%(0.9)的错误答案将获得-0.81的奖励,因为
置信度为20%时,奖励为-0.04。而在90%置信度下正确回答则得0.99分。(熟悉校准模型评估的读者可能会注意到,误差平方项是对答正确概率的布赖尔惩罚。)
注意,同一(此处为Qwen2.5-7B)模型生成不确定性分析和q作为其响应的一部分。
不确定性分析是对答案可能错误之处的书面评估。回答后,模型会检查缺失的证据、模糊措辞、可疑假设或可能的推理错误。论文提示要求其识别具体的不确定性,而不是提出修正建议。
另外,系统提示明确要求q,标签内的数字介于0到1之间。它代表模型估计其答案正确的可能性。系统在同一响应中依次生成所有这些部分。
为了说明,模型答案可以如下:
...reasoning about the question...
positive

The passage mentions a positive movie review, but the connection to the second paragraph is unclear.

0.6
下面是论文中的注释图,展示了它如何通过温度尺度改善预期校准误差相较普通RLVR的方法。
在HotpotQA中,RLCR将预期校准误差(ECE)从0.37降至0.03,准确率相近(62.1%对63.0%)。在另外六个数据集中,平均ECE从0.46降至0.21,准确率从53.9%升至56.2%。
这些结果见论文表1(a)。
从概念上讲,“RLVR + 分类器”中的“分类器”是一个监督式二元分类器,用于预测生成的答案是否正确。
对于Jev,我可以直接对已输入的决策应用校准奖励,而无需生成推理文本。例如,我们可以为一个带有第2.2节所示分类头的GPT风格模型配备,并调整强化学习训练目标以奖励准确决策和校准概率。
我们将共同训练骨干和分类头。这将是受RLCR启发的适应,目前尚不清楚Jev的RLCD是否能以这种方式工作。
另外,由于直接策略优化(DPO)是人类反馈强化学习(RLHF)的交叉熵替代方案,我们也可以直接最小化分类器概率中的CE + Brier损失。
我用ModernBERT模型做了这件事,结果比常规温度尺度略有提升。
6. Jev是为谁而作?
既然我们已经对Jev做了相当详细的介绍,Jev是面向谁的?根据我的评估,这是一个相当大的目标群体,他们有:a)想节省时间,不用为每个决策任务都微调自定义分类器,b)想省钱,而不是用GPT-6等“大武器”等大型语言模型。
还有许多有趣的应用场景值得考虑。下面部分列出了一些简短的思路。
6.1 Jev 使用场景
用例似乎无穷无尽。当然,有些炫酷的例子,比如让它玩俄罗斯方块等电子游戏(正如我在之前视频中展示的,用来展示API的低延迟)。
然而,对大多数人来说,分拣邮件更为实用。例如,可以使用Jev作为额外的垃圾邮件过滤器、优先级排序等功能。
但除此之外,它还可以作为增强LLM代理工具的工具。在这里它可以用作
- 常规LLM代理工具的预筛器,用于扫描上下文以实现即时注入;
- 选择模型的推理努力水平;
- 选择Askill.md来自你注册的技能库;
- 将其作为评估或自我完善的评判;
- 查找相关文件以构建背景。
这个列表几乎无穷无尽。甚至有人发帖说arXiv 上的调查分析了最近几天内涌现的2170个与Jev相关的项目。
6.2 关于Jev克隆体和本地Jevs
自 Jev 推出以来,成百上千的快速 Jev 克隆项目涌现出来。我看过的大多数只是快速示例,用 SFT 微调 ModernBERT 或 Qwen 模型,并添加了类似 Jev 的 API。
据我所知,没有一个能在如此广泛的任务中达到Jev的表现水平。将这些项目与Jev相比,就像把Alpaca(基于原始LLaMA开权模型的早期指令微调LLM)与GPT-6相比一样。
当然,它在精神上可能类似,但实际任务的体验因人而异。
无意冒犯,但它们看起来是快速炒作的项目,我不想在这里推荐某个具体项目。
这里有一个例外,可能是光辉项目,已经存在了~3年,虽然本质上不完全相同,但可以用于类似的事情。然而,基于一个基准测试,杰夫绝对更强。
总之,确实有真正的需求和渴望,需要一个好的开放重量替代品来替代Jev。原因不一定是成本(因为Jev太便宜了),而是隐私问题。(另外,如果Jev在互联网上已经这么快,想象一下在强大本地硬件上能有多快。)
所以,我当然希望Jev能有个DeepSeek(或Kimi、GLM或MiMo)时刻。我相信有人正在做这件事,但需要时间。TypeSafe AI和一支专门的专家团队合作了几个月。
期望在一周内复制这些开发和评估工作是不现实的。(不过,由于这个模型比1万亿参数模型更小更高效,希望不会花太长时间。)
结论
总的来说,乍一看,Jev 似乎并没有带来什么根本性的创新。毕竟,有人可能会说“它只是一个分类器”(上面还带着一个不错的 API)。
然而,它在大量任务中表现出奇地好。从这个意义上说,它是专用分类器的即插即用版本。
当然,专家们仍会对专业型号进行微调,但现在要对专用车型进行微调的门槛更高了,因为只需用Jev或类似Jev就能获得足够好的效果。
此外,我不指望Jev和Jev-likes能解锁新功能或解决之前无法解决的任务。然而,如果我们将这些模型纳入代理工具,以辅助昂贵的GPT-6或Opus 5.5模型在该框架内的决策,未来使用智能体框架将会变得更快更便宜。
如果你觉得这篇文章有用,考虑成为人工智能的付费先驱。你的支持让我能花更多时间在这类文章背后的实验和详细插图上。
你也可以通过我的书籍支持我的工作,从零开始构建大型语言模型以及从零开始构建推理模型如果你想自己实现这些概念,可以试试。
感谢阅读并支持我的独立研究!

 点赞
 收藏
 点踩
 分享