
为什么华尔街开始重估AI大模型的资本回报


2026年入秋以来,全球科技资本市场出现了一道耐人寻味的裂痕。一方面,北美云巨头与头部AI大模型的账面营收仍在以罕见的斜率扩张;另一方面,作为算力景气度先行指标的费城半导体指数却步入持续阴跌,上游芯片龙头哪怕交出翻倍增长的财报,换来的往往也是机构资金的逢高派发。与此同时,一级市场的估值狂热正在遇冷:年化收入跑率(ARR)已触及500亿美元的OpenAI将上市计划推迟至2027年,而10月下旬刚刚递交S-1招股书、市场传闻目标估值高达1.5万亿至2万亿美元的Anthropic,则在机构路演中引发了一场关于算力负债与盈利质量的激烈辩论。
过去三年,硅谷与华尔街撰写了一个建立在“算力稀缺”与“参数垄断”之上的宏大叙事;而今天盘面走势的背离表明,长期资金似乎已经意识到一个结构性逆转:当万亿美元级别的硬件重资产刚刚落地,下游的算法蒸馏、开源生态与工程脚手架(Harness)却在以更快的速度消灭算力溢价。“硬件资本通胀”与“软件定价通缩”的正面相撞,使得市场必须重估AI产业链的回报周期。
万亿分母下的回报是所有投资分析的基础
一场基建狂潮的可持续性,需要分子与分母的量级匹配。
在这轮AI周期的分母端,资本开支的膨胀速度已经超越了上世纪末的电信光纤泡沫。以微软、亚马逊、谷歌、Meta和甲骨文为核心的北美超大规模云厂商,其年度资本开支从2025年的约3500亿美元跃升至2026年的8000亿至9000亿美元,华尔街共识预期2027年这一数字将突破1.1万亿美元,仅英伟达一家公司在2027财年(自然年2026年)的数据中心年化营收便已逼近4000亿美元大关。
然而在分子端,商业化现金流的归集却呈现出滞后。如果剔除用单月峰值乘以12得出的“年化跑率”口径,严格按会计准则计算全年落袋的确认收入(GAAP Revenue),全行业纯AI模型厂商在2026年的实际入账规模仅在700亿至850亿美元之间——其中OpenAI预计全年确认收入约为300亿至400亿美元,Anthropic上半年确认收入162.9亿美元、全年预计约300亿美元,被SpaceX并入的xAI及其他初创企业合计不足百亿美元。CNBC 即便采用最宽泛的统计口径,将AWS、Azure与Google Cloud云业务中高于前AI时代趋势线的增量收入全部囊括进来,2027年全行业广义AI总收入的基准中枢也仅在4000亿美元上下。
面对“1.1万亿年度投入”与“4000亿广义收入”之间的巨大缺口,多头常见的逻辑是重构资产的折旧久期。早期空头常犯的一个错误,是将万亿资本开支全部视作寿命仅4年的GPU芯片,从而得出行业每年需计提数千亿折旧的悲观结论。但真实的工程账本要复杂得多:在2026年一座AI数据中心每兆瓦3000万至4000万美元的全包造价中,约有一半资金沉淀在厂房外壳、变电站、冷机与配电网络等基础设施上,这类资产的物理与经济寿命长达20至30年。
与此同时,占另一半投资的IT算力设备也并非到期即废,而是遵循“价值级联”(Value Cascade)规律:最新一代集群在完成前两年的前沿模型训练后,会逐级下放至常规在线推理与延迟不敏感的批处理业务,从而将经济寿命延伸至5到6年。
如果将30年寿命的电力外壳与5至6年寿命的算力设备按对半权重混合,整个AI资本开支资产包的综合折旧年限确实可以拉长至7到8年,对应年化综合折旧率(d)降至12.5%左右。在财务模型中,用资本开支(I)乘以折旧率与加权资本成本(r,科技巨头约为9%)之和,再除以增量业务毛利率(m),即可得出行业维持经济盈亏平衡所需的最低收入:
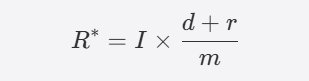
这意味一旦综合折旧年限成功拉长到8年(d+r =21.5%),只要AI业务能维持55%左右的稳态毛利率,回本倍数【(d+r)/m】就会从早期的0.55以上大幅下移至0.39。这意味着,面对2027年1.1万亿美元的资本开支,全行业只需产生约4300亿美元的广义收入即可覆盖全部折旧与资本成本;若仅考核覆盖折旧的现金流平衡(不计资本占用成本),门槛更是低至2500亿美元左右。
换言之,通过拉长资产久期,多头确实在账面上抚平了“投入与产出”的剪刀差。但这种处理方式也体现了AI估值体系最脆弱的部分:当折旧率被推到极限之后,万亿资本开支能否赚回成本,几乎完全取决于分母上的毛利率(m)能否守在55%以上。一旦毛利率从55%滑向45%甚至更低,回本所需收入就会回升至5300亿至6000亿美元上方,缺口将重新撕裂。而过去一年发生在AI工程领域的技术演进,恰恰正在从内部冲击这个决定生死的毛利率。
从参数垄断到路由分流:工程进化自然瓦解定价权
在软件与互联网的商业史上,高毛利率的前提永远是供给侧的排他性壁垒。2023至2024年间,市场之所以愿意给闭源大模型赋予软件般的远期毛利预期,是因为彼时行业普遍信仰“规模定律”(Scaling Laws):谁砸下最多的算力训练出参数最大的模型,谁就拥有不可替代的智力代差与定价权。然而到了2026年,随着预训练边际收益递减,技术演进的重心全面转向了后训练、模型蒸馏与系统工程,这一转向在提高应用效率的同时,也彻底打破了头部厂商的垄断溢价。
瓦解定价权的第一个冲击因素,是顶级模型自我博弈与知识蒸馏带来的“算法性通缩”。当下的前沿模型已经能够生成极高质量的合成数据与思维链轨迹,并用这些数据去训练体量小一个数量级的轻量级模型。生产环境的实测表明,通过“教师—学生”蒸馏架构训练出的小尺寸模型,不仅推理速度提升4倍、单次调用成本骤降5至30倍,还能保留前沿教师模型95%至97%的任务准确率。这种技术演进产生了一个极具讽刺意味的经济后果:前沿模型实验室耗费数十亿美元训练出的顶级智力,在几个月内就会沦为训练廉价小模型的“燃料”,模型厂商自己成了自己高价API的掘墓人。
第二个冲击因素,来自开源模型与工程脚手架(Harness)的深度合流。根据研究机构的追踪,2026年全球顶尖开源权重模型落后于闭源前沿模型的时间差,已经收窄并稳定在3到4个月的极窄窗口内。在短短一个季度的代差之内,企业级应用不再依赖单一模型“裸奔”,而是普遍在模型外围构建起严密的Harness体系,包括标准化的工具调用接口、代码执行沙箱、多步验证循环、结构化输出约束以及高精度检索引擎。当工作流被拆解并嵌入确定性的工程护栏后,底层模型在极限推理上的微小分差被系统容错能力完全抹平。对于绝大多数企业而言,“四个月前的开源模型加上一套成熟的Harness”,在工程可靠性上已经足以替代最昂贵的闭源模型。
第三个冲击因素,则源于模型路由(Model Routing)的全面普及。在2026年的生产架构中,超过四分之三的企业研发团队已不再将全部流量绑定在单一模型上,而是在应用层前部署智能路由网关。只有最复杂的全局规划、模糊意图拆解与最终质量仲裁(通常仅占总Token流量的10%至20%),才会被路由至每百万输出Token售价20至50美元的闭源前沿模型;而占工作量70%至80%的明确子任务——如代码片段补全、数据清洗、格式转换与常规检索——被路由器自动分发至每百万Token仅售0.5至2美元的微调小模型或私有化开源模型上,叠加软件层面对冗余提示词与无效上下文的裁剪,单次复杂业务流程的综合推理成本被直接砍去了80%至95%。
面对这种成本坍塌,乐观派常引述“杰文斯悖论”(Jevons Paradox)作为护身符:单次推理成本的暴跌会激发多智能体并发(Multi-agent Orchestration)等复杂工作流,使总Token消耗量呈指数级扩张,从而填补单价下跌的损失。这一逻辑在物理算力消耗上确实成立:2026年推理负载已占据全球AI总算力的三分之二,GPU机房的整体稼动率依然饱满。但物理上的忙碌并不能直接折算为财务上的高毛利。
模型路由的本质,是将AI的商业模式从“按Token总量收取高额租金”,强行拆解为“少量的高价总控调用”与“海量的平价大宗商品执行”。当80%的执行流量被开源与小模型以接近电费的边际成本承接,闭源模型厂商要么接受自己退化为仅占一两成流量的“调度器”,要么被迫大幅调降主力模型价格以争夺执行层份额,一如OpenAI在2026年夏季将旗下轻量级模型GPT-5.6 Luna的价格一次性下调80%。这种结构性降价直接导致了2026年下半年行业显著的“价格剪刀差”。企业实际支付的Token加权均价在半年内下跌了约40%,而同期受制于电力、机房与折旧刚性,H100等主流算力的租赁价格却依然停留在每小时2.7美元的高位。
更深远的冲击正在沿着产业链向上游传导。当70%至80%的业务负载固定在经过蒸馏的小模型与确定性子任务上时,这部分算力根本不需要依赖英伟达最新一代、配备昂贵高带宽内存(HBM)与高速互联网络的旗舰训练集群;上一代退下来的旧款GPU、云厂商自研的低功耗推理ASIC芯片,乃至边缘端芯片即可高效处理。算力需求的总量或许因为杰文斯悖论而未见萎缩,但结构却发生了不可逆的降级——恰恰是“前沿训练集群与顶级互联芯片”这一金字塔尖的品类,支撑了半导体板块过去三年高达75%的毛利率与估值溢价。当路由与蒸馏联手削平了金字塔尖的增长斜率,半导体指数的估值中枢下移便成了必然的金融结果。
招股书里的会计考量:持续研发吞噬毛利
上述所有关于定价权侵蚀与成本刚性的逻辑推演,在2026年10月26日Anthropic向美国证监会递交的S-1招股书中,得到了迄今为止最完整的财务数据。
作为目前企业级市场势头最猛、在直接竞标中对OpenAI胜率接近七成的头部实验室,Anthropic的财报本应是证明AI盈利能力的最佳样本。表面上看,其数据确实惊艳:2026年上半年公司确认营收达162.9亿美元,同比暴增逾13倍;如果仅将财务附注中服务外部客户的推理算力(23.8亿美元)列为营业成本,其账面“服务毛利率”高达85.4%。这一数字一度让市场欢呼,认为大模型终于展现出堪比顶级SaaS软件的印钞能力。
然而,一旦剥开会计科目重分类的外衣,这85.4%的毛利率就会经历两次剧烈的折损。
第一次折损发生在分发渠道的过路费。Anthropic本身并不拥有云基础设施,其近四分之一的营收需要借助亚马逊和谷歌等云巨头的市场进行分发。拆解业务线可以发现,公司自有API与企业席位订阅的毛利率确实能达到64%至69%,但在云合作伙伴渠道上,由于云厂商抽取了高额的平台分成与算力溢价,该渠道的毛利率骤降至34%,仅2026年上半年支付给渠道伙伴的费用就激增了27亿美元。将全部渠道加权合并后,Anthropic在经营层面的真实业务毛利率立刻回落至50%至52%区间,而客户结构更偏消费端的OpenAI在同口径下的毛利率更是仅有41%。这证明在模型同质化与路由普及的背景下,掌握客户入口、数据底座与算力网络的云平台,正在抽走模型层近三分之一的利润池。
第二次、也是更根本的折损,隐藏在高达97亿美元的研发费用(R&D)之中。2026年上半年,Anthropic的研发支出占到了当期总营收的59.8%,其中绝大部分并非人员薪酬,而是用于预训练下一代基座模型、后训练强化学习以及合成数据生成的算力消耗。
这里触及了评估AI公司价值最核心的会计学争议:大模型公司的训练算力支出,究竟是面向未来的“研发投资”,还是维持当期收入的“准营业成本”(Quasi-COGS)?
在传统软件或医药行业,研发与当期生产是解耦的——停止研发新药,现有的专利药依然能在未来十年维持90%的毛利率。但在大模型行业,由于开源权重模型仅落后闭源前沿3到4个月,且下游企业已经普遍部署了可以随时切换接口的模型路由器,闭源实验室所谓的“护城河”保质期只有短短一个季度。如果Anthropic或OpenAI今天停止投入那笔占营收60%的训练算力,四个月后,开源模型配合Harness就能在绝大多数任务上追平其现有主力模型,企业客户的路由器会自动将原本留给它的那10%至20%高价总控流量也一并切走。
因此,为了跑在开源模型前面四个月而持续燃烧的巨额训练算力,根本不是可自由裁量的远期投资,而是防止当期API价格崩盘所必须支付的维持性成本。一旦将这部分实为维持性成本的训练算力与服务算力合并计算,Anthropic在2026年上半年的纯算力与基础设施总支出就高达89亿美元,占营收比重达55%——这意味着,还原经济实质后的全算力口径毛利率其实只有45%。
如果将这个经过招股书检验的45%真实毛利率,重新代回前文的行业回本公式(21.5%45%≈0.48),并考虑至少15%至20%的销售与管理费用后,全行业要消化2027年1.1万亿美元的资本开支,所需的盈亏平衡收入立刻反弹至5500亿至6000亿美元以上。
除此之外,更严峻的是资产负债表的久期错配。为了锁定算力供给,Anthropic在S-1中披露了截至2026年年中高达6370亿美元的长期算力采购承诺,其中约三分之二为不可撤销的刚性支付义务;而在收入端,无论是API调用还是企业订阅,客户签署的都是按量计费、缺乏长期锁定期、且随时可通过路由架构降级消费的短久期合同。
用长达五到十年的千亿级刚性算力负债,去匹配保质期只有四个月、转换成本极低的按Token计费收入,这种商业模式在金融结构上的脆弱性,正是导致OpenAI推迟上市、并让二级市场机构对万亿级IPO估值望而却步的深层原因。
概率统计:万亿估值需要多少假设同时成立
至此,我们可以将宏观资本开支、中观工程演进与微观财报解剖拼合成一幅完整的图景。华尔街当下对半导体与AI估值的犹疑,并非源于对技术前景的怀疑,而是源于一种清醒的概率计算:要让当前每年超万亿美元的硬件投资与动辄上万亿的企业估值实现财务自洽,投资者必须同时相信一连串极其苛刻的前提假设,而这些假设之间存在着深刻的内生矛盾。
要让这笔账算平,首先必须假设数据中心里的算力硬件能够安然度过6到8年的漫长折旧周期而不发生经济性减值,哪怕亚马逊已经在财报中以“AI硬件迭代过快”为由,反向将部分服务器的会计折旧年限从6年缩短至5年。
其次,必须假设杰文斯悖论带来的调用量爆发,能够在速度上十倍于算法蒸馏与模型路由带来的单价通缩——在80%的子任务被分流至廉价模型、单次任务成本下降90%的背景下,下游企业的实际业务调用量必须呈数量级暴增,才能仅仅维持模型厂商原有的收入预期不掉队。
再次,还必须假设闭源模型厂商能够一面在激烈的价格战中守住“总控调度层”的高额溢价,一面在未来两年内奇迹般地停下吞噬60%营收的“训练跑步机”,将全口径毛利率从目前的45%推升至传统软件业70%的水平;同时,云巨头账面上超过1.5万亿美元的积压订单,还必须在企业CFO普遍引入路由架构严控预算的环境下,不打折扣地按期转化为高毛利现金。
在概率论中,即便每一个独立假设各自有60%的乐观实现可能,五个假设同时成立的联合概率也仅有7.8%。更何况,这些假设在产业逻辑上是互相排斥的:如果寄希望于技术迭代放缓,从而让旧显卡平稳折旧8年、让模型厂得以大幅削减训练研发开支,那么开源模型与工程Harness就会利用这段停滞期彻底抹平与闭源前沿的最后一点代差,进而把模型层的毛利率压向大宗商品的水平;反过来,如果闭源巨头为了保住毛利率和总控地位而继续全速推进算法与架构迭代,那么不仅每年数百亿美元的训练算力无法削减,存量GPU集群的经济寿命也会被新一代硬件加速淘汰,6到8年的长折旧假设便会当场失效。
综合上述分析,可以看出美国半导体指数的回调与独角兽IPO进程的波折,不是人工智能技术浪潮退却的标志,恰恰相反,它是技术向工程实用主义加速演进的必然产物。
蒸馏、开源、Harness与模型路由的成熟,极大地降低了全社会获取智能的门槛,却也拆除了早期建立在算力垄断上的护城河。当一项技术从“少数巨头独占的炼金术”演变为“可被拆解、可被路由、可被替代的工业基础设施”时,全社会的生产力无疑将迎来长远的繁荣;但在资本市场上,那个仅凭资本开支指引就能推升万亿市值、无视现金流折现铁律的估值蜜月期,已经画上了句号。
雪球是一个投资者的社交网络,聪明的投资者都在这里。
点击下载雪球手机客户端 http://xueqiu.com/xz]]>