刚刚,GPT-6.1 Terra 骨折价发布,Agent 时代的打工模型来了


OpenAI 又卷起了大模型的性价比。
就在刚刚,OpenAI 正式发布新一代模型 GPT-6.1 Terra,主打更快的响应速度、更强的视觉理解和电脑操作能力,以及更低的使用成本。
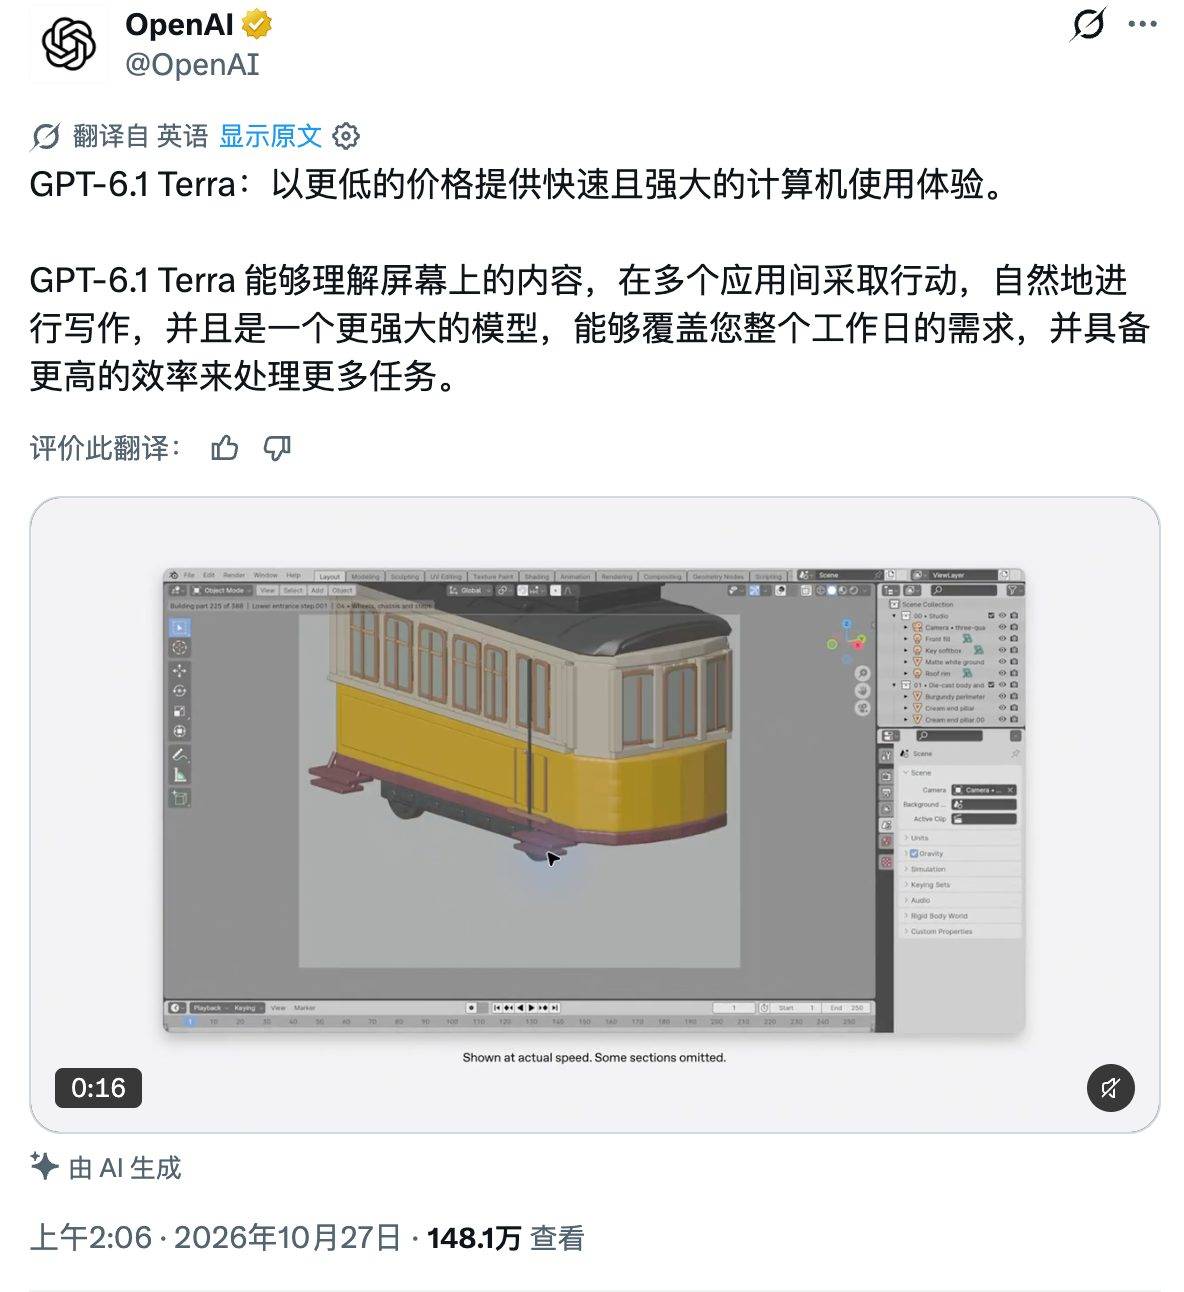
图|博客 https://openai.com/index/introducing-gpt-6-1-terra/
相比上一代 GPT-5.6 Terra,新模型的标准 API 价格直接降低 50%,但在复杂任务执行、事实准确率和编程能力上均有明显提升。尤其是在部分专业任务测试中,GPT-6.1 Terra 已经能够接近旗舰模型 GPT-6 Astra 的表现,Token 价格却只有后者的十分之一。
OpenAI 将其定位为一款面向高频工作场景的高效模型,希望让更多企业和开发者能够以更低的成本,将 AI Agent 真正应用到日常工作中。
性能直追 Sol,执行任务速度快 3 倍
GPT-6.1 Terra 最值得关注的变化,是视觉理解与电脑操作能力的进一步结合。
过去,AI 可以理解图片、分析文档,但要让它真正操作电脑、跨应用完成复杂任务,依然需要较高的模型能力和推理成本。
如今,GPT-6.1 Terra 已经能够处理从阅读技术图纸、填写表格,到编辑视频、操作桌面软件等一系列专业任务。
例如,用户可以让它根据建筑设计图纸创建 3D 模型,或者逐帧检查动画影片,为修复团队制作带有时间码的镜头记录。企业还可以利用它读取收到的发票,并将相关信息自动录入财务软件。
在衡量 AI Agent 完成专业工作能力的 Agents’ Last Exam 测试中,GPT-6.1 Terra 的表现相当突出。
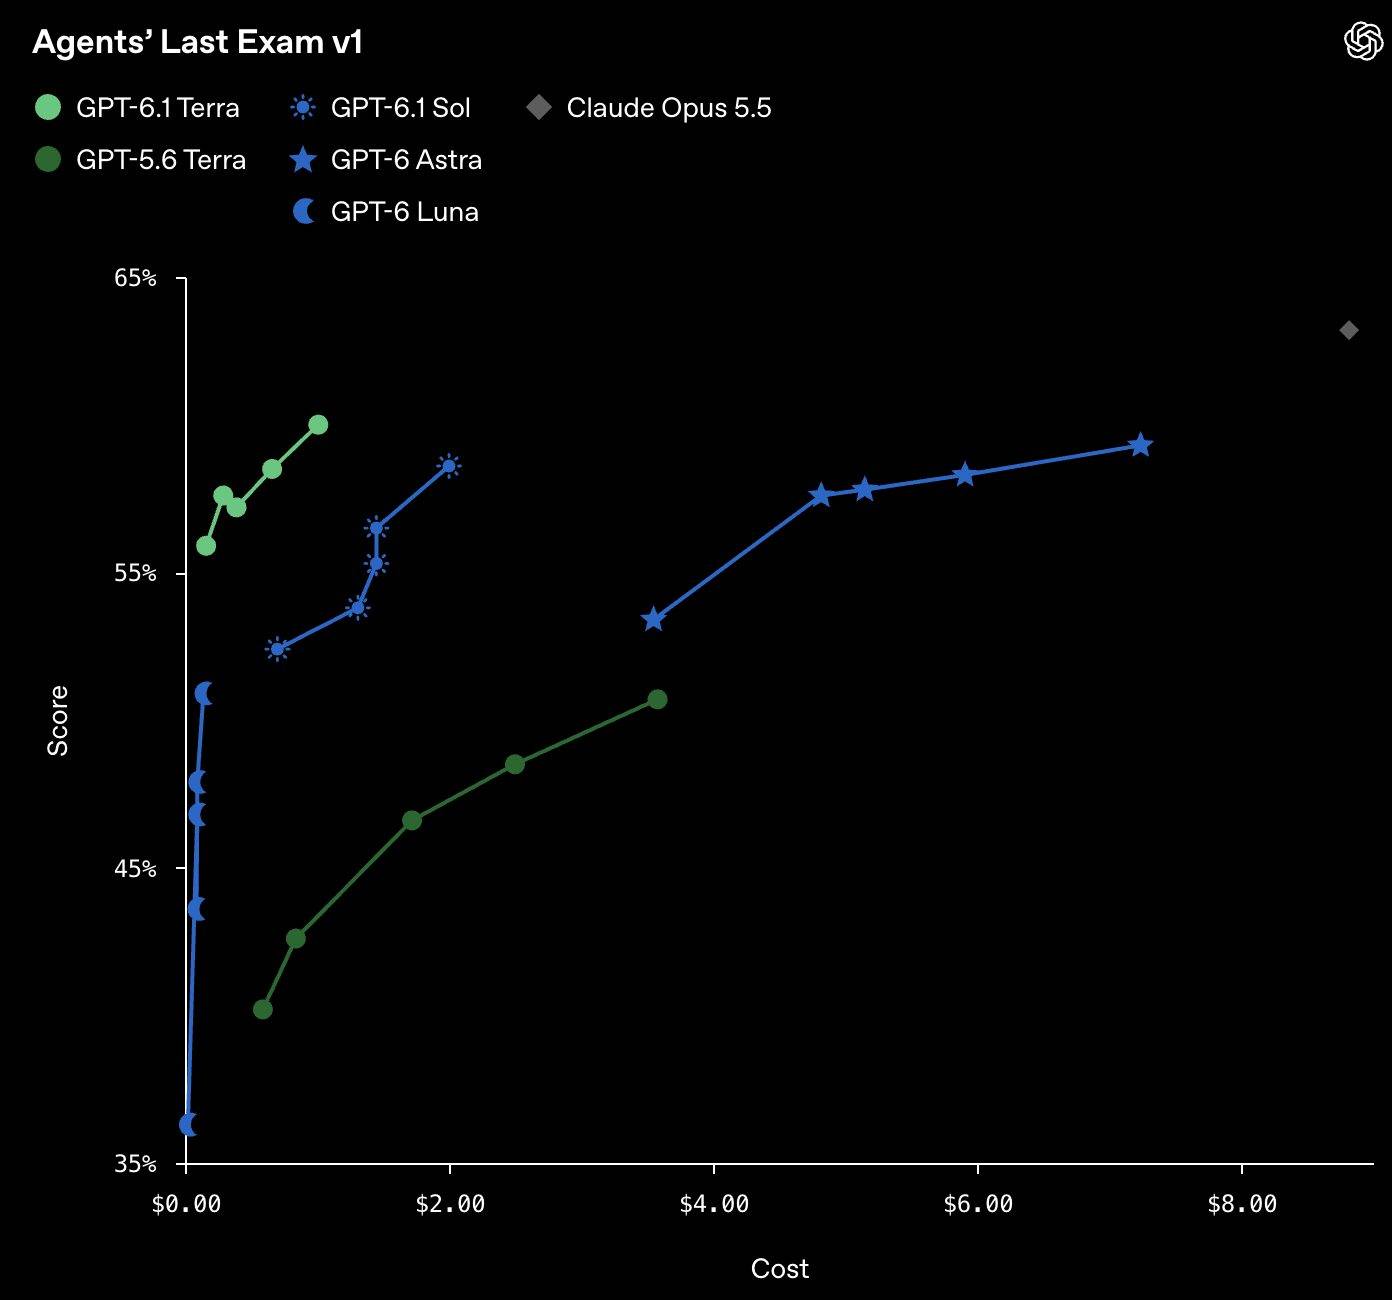
在中等推理强度下,新模型的得分比 GPT-5.6 Terra 提高了 15 个百分点,单次任务成本却降低至约三分之一。
更值得关注的是,同样在这一测试中,GPT-6.1 Terra 已经能够达到 GPT-6 Astra 的水平,而标准 API 的 Token 单价仅为后者的十分之一。
与 Anthropic 的 Claude Opus 5.5 相比,在最高推理强度下,GPT-6.1 Terra 的 Token 使用效率超过其 3 倍,Token 单价只有其四分之一,最终完成同类任务的成本约低 9 倍。
速度方面,GPT-6.1 Terra 完成任务的速度也超过 GPT-6 Astra 和 GPT-6.1 Sol 的 3 倍。
有开发者晒出的测试结果显示,GPT-6.1 Terra 单次请求的生成速度可以达到每秒 450 Token,低推理强度下甚至有望达到每秒 600 Token,不过后者尚未得到验证。
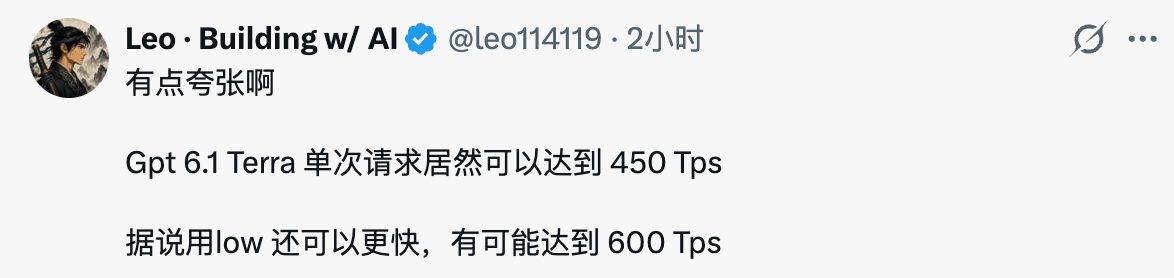
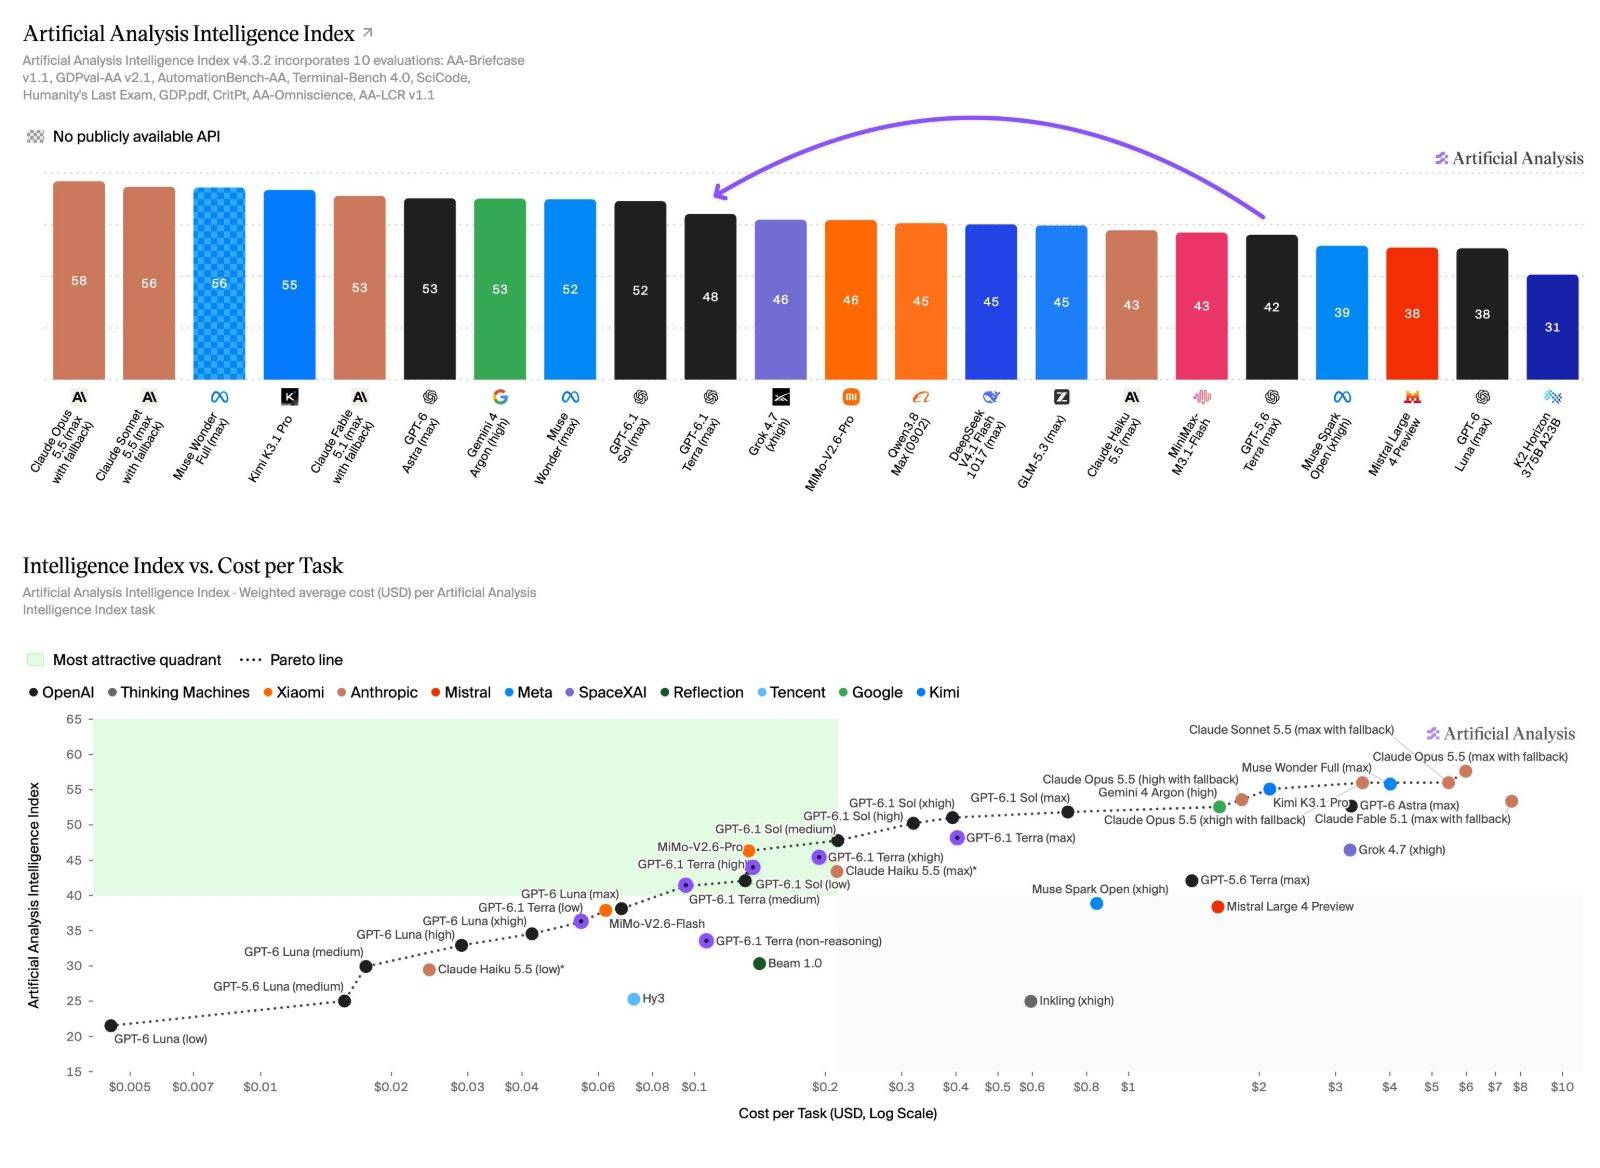
第三方评测机构 Artificial Analysis 的智力指数榜单也给出了一个有意思的参照,GPT-6.1 Terra(Max)拿到 48 分,超过除 Kimi K3.1 Pro(55 分)之外的中国开放权重模型。
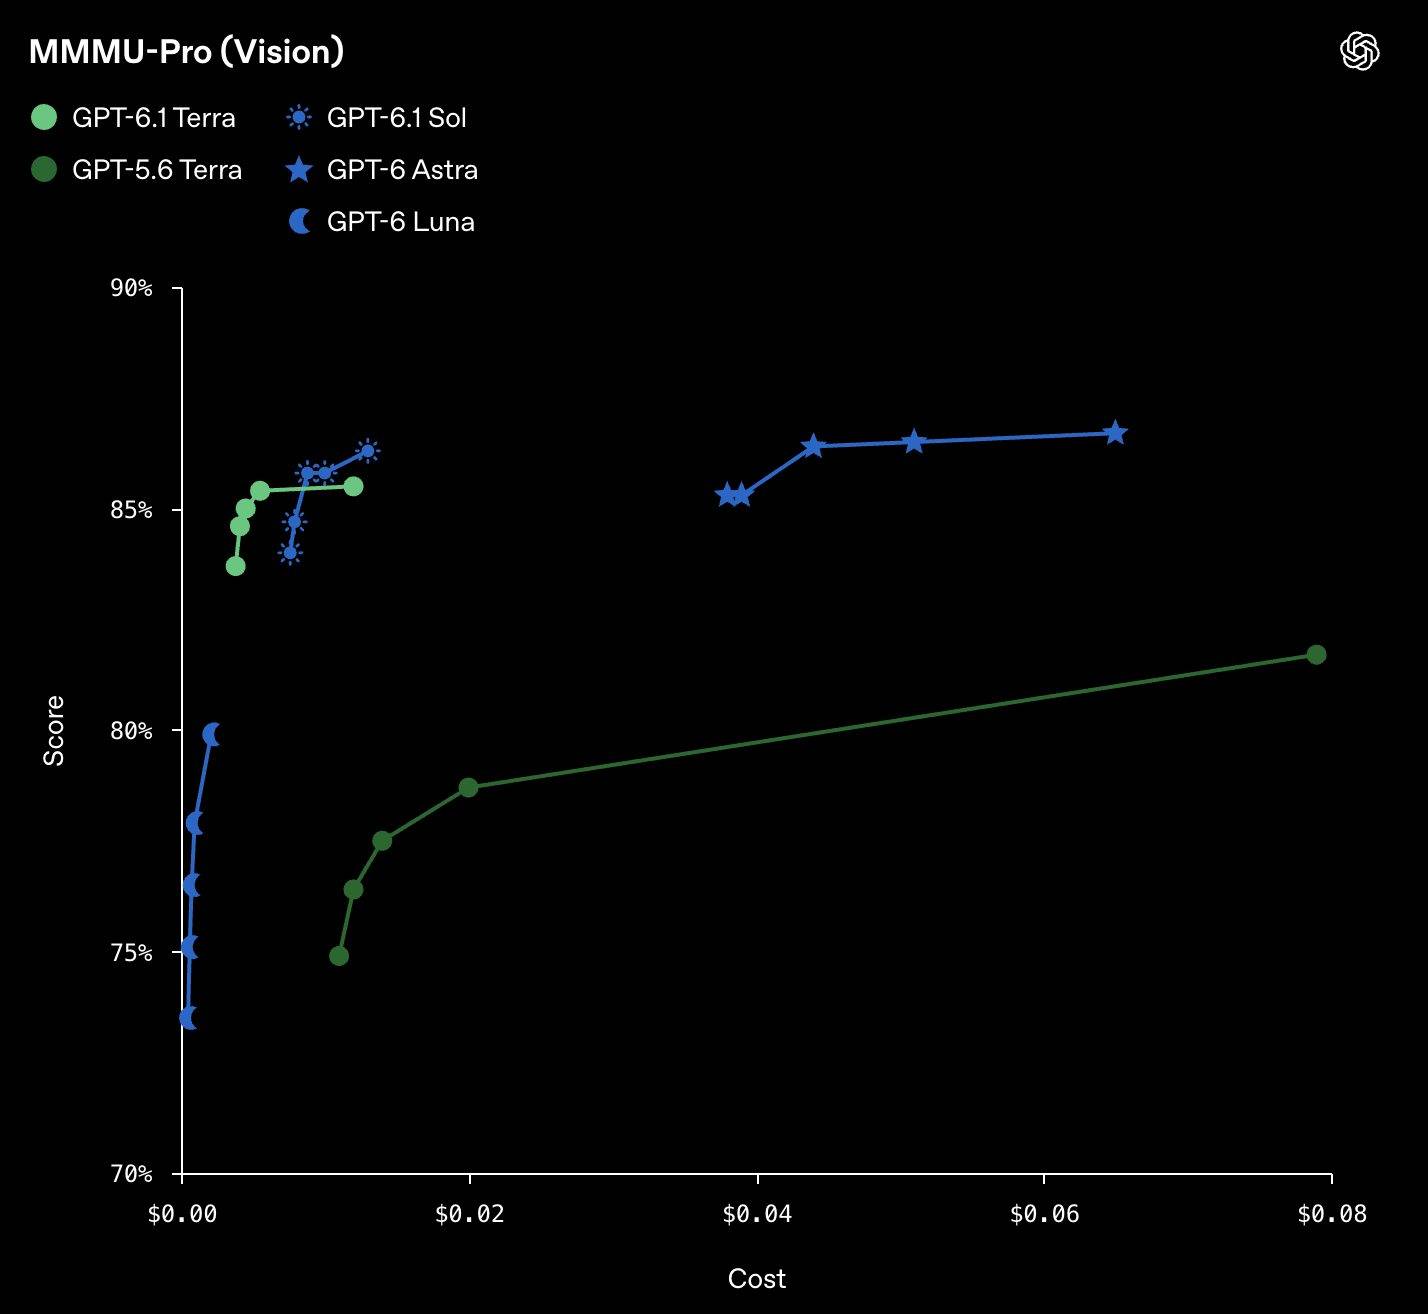
另外,在考察视觉推理能力的 MMMU-Pro 测试中,GPT-6.1 Terra 在所有推理强度下均超过上一代模型,并以明显更低的成本,取得接近 GPT-6 Astra 和 GPT-6.1 Sol 的成绩。
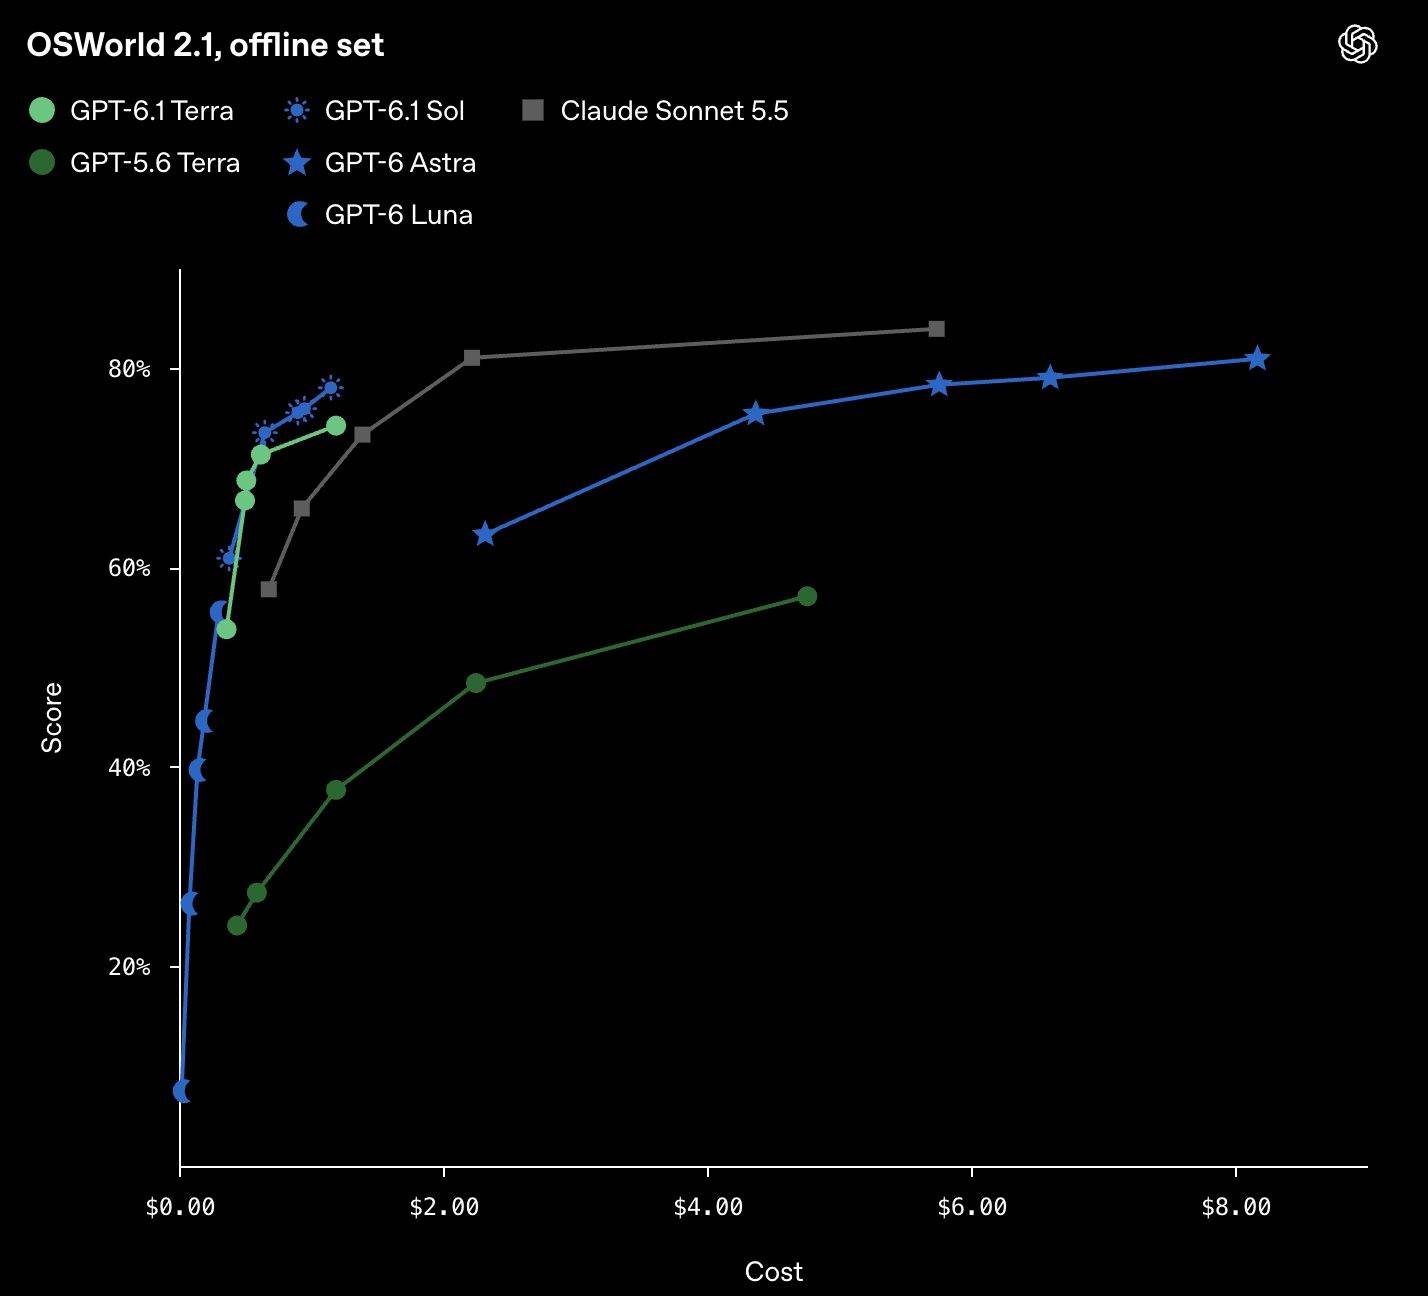
在专门测试 AI 操作桌面应用能力的 OSWorld 2.1 中,新模型仅使用中等推理强度,就已经超过 GPT-5.6 Terra 在最高推理强度下的成绩,同时显著降低了单次任务成本。
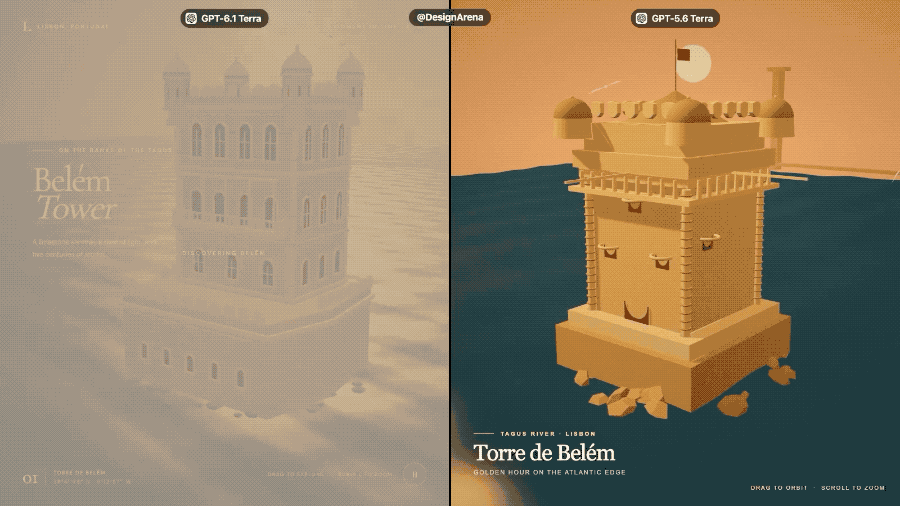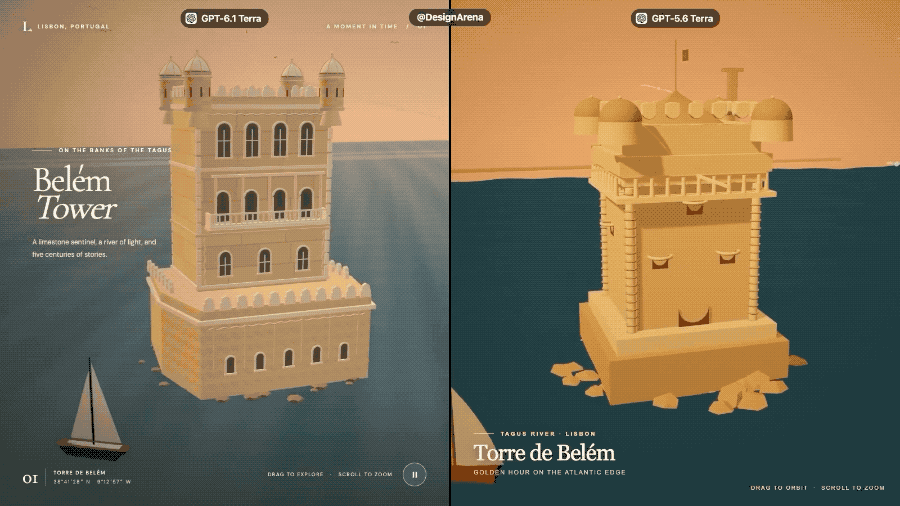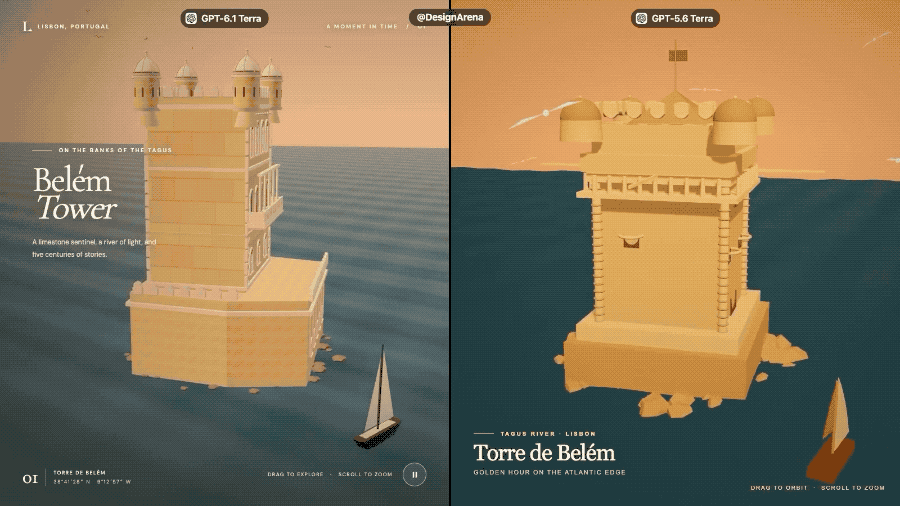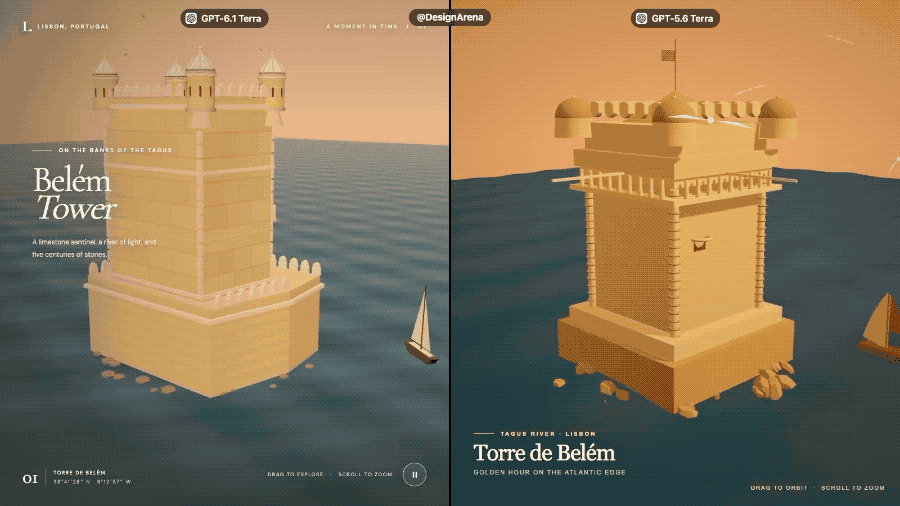
实际体验也印证了部分提升,DesignArena 让两代 Terra 重现日落时分的里斯本贝伦塔,6.1 版本生成了更精细的建筑与水面光影,虽然耗时接近上一代的 4 倍、Token 消耗增加 48%,单次成本却从 0.077 美元降至 0.047 美元。
而 atomic.chat 使用相同提示词让两款模型分别以 8 个 Agent 开发游戏,Terra 只用 6 分钟、花费 1.06 美元就完成任务,而 Claude Sonnet 5.5 花费约一小时和 18.10 美元,却交出了明显更好的游戏作品。
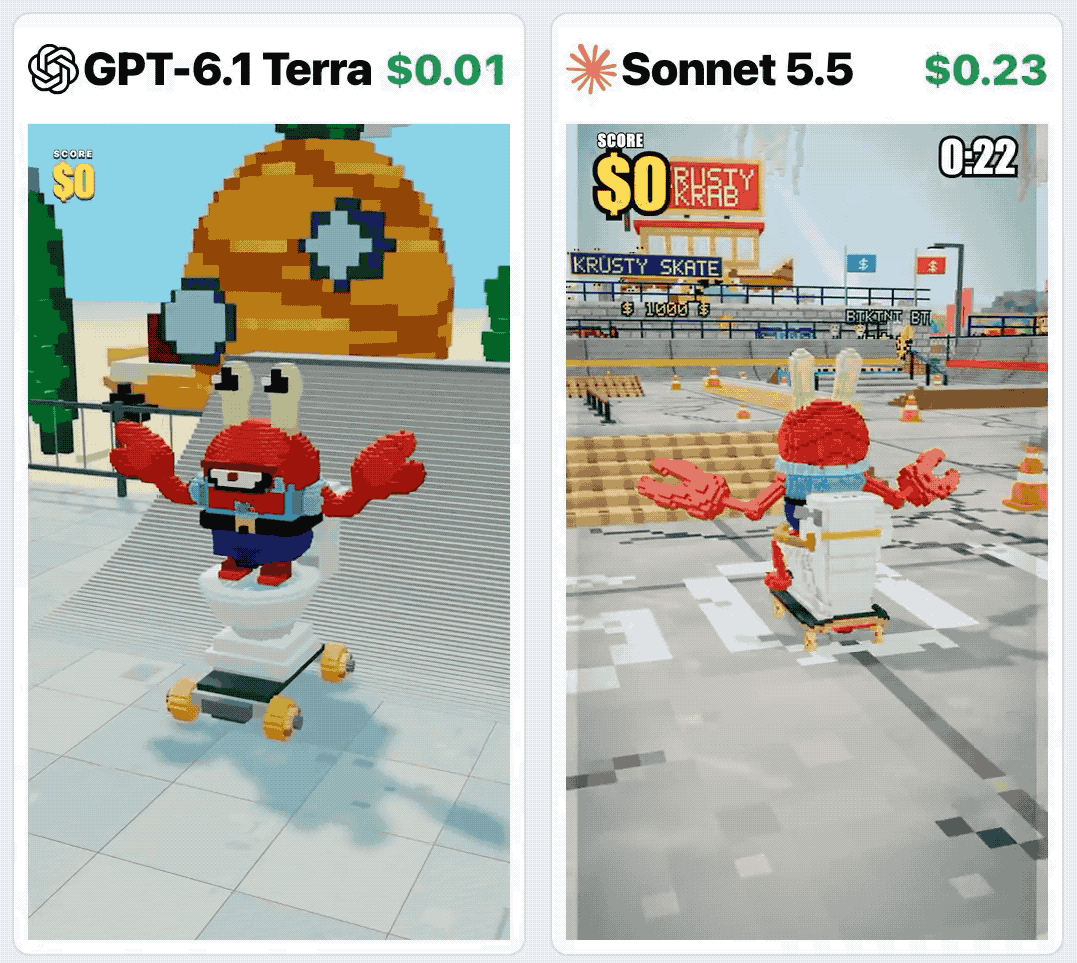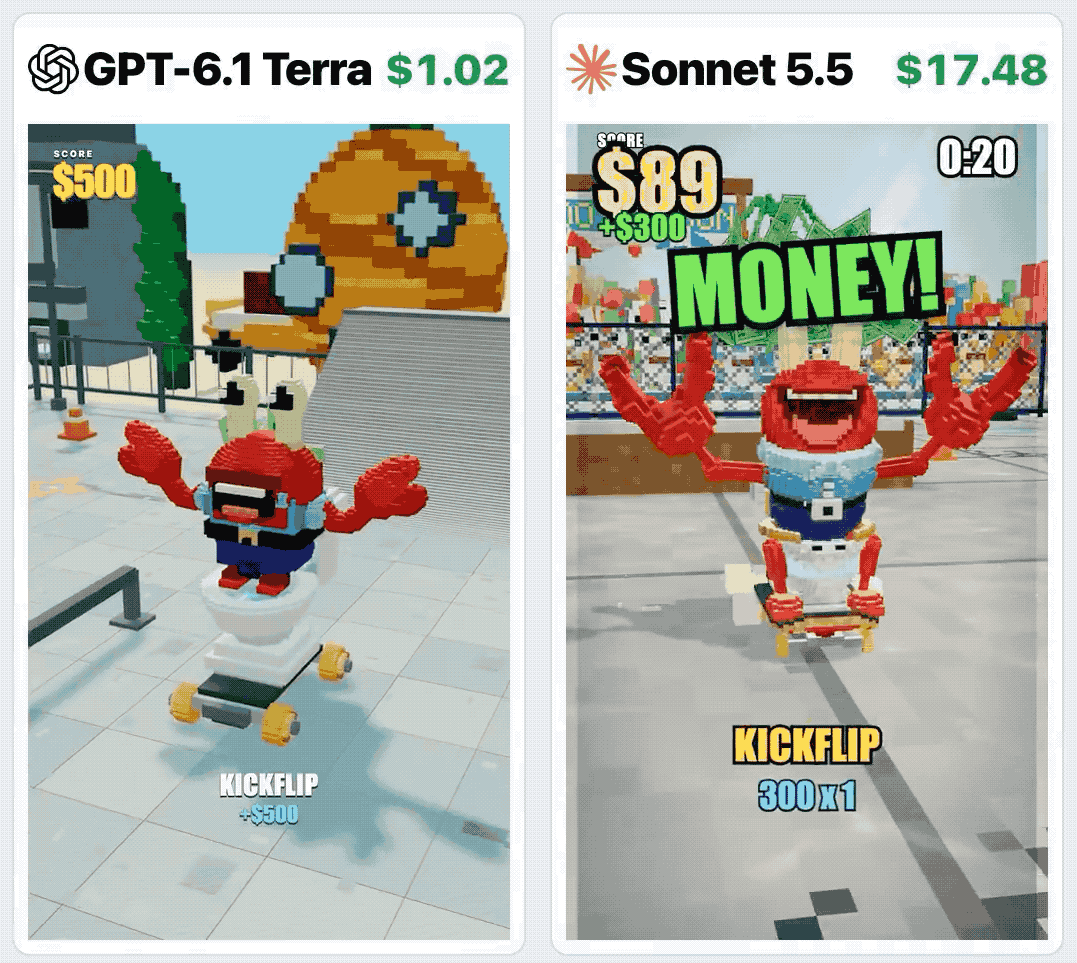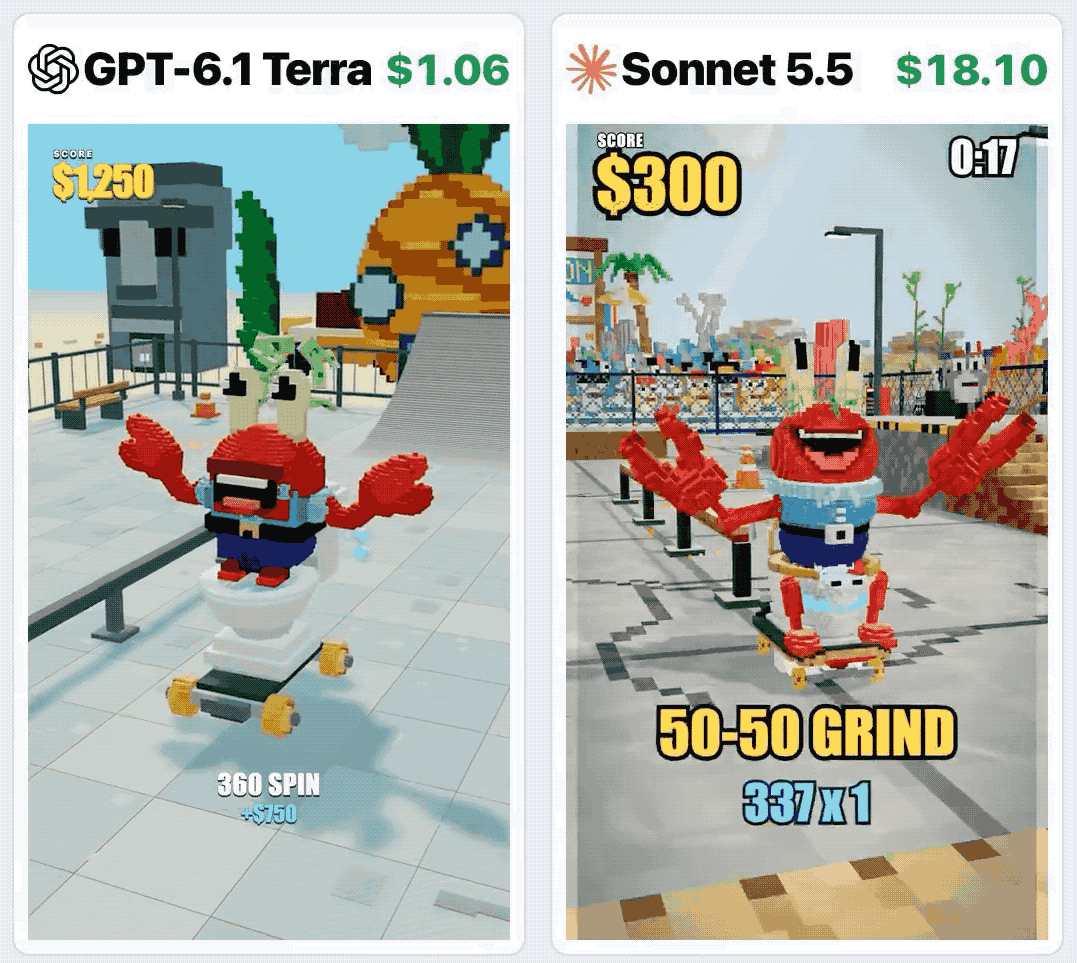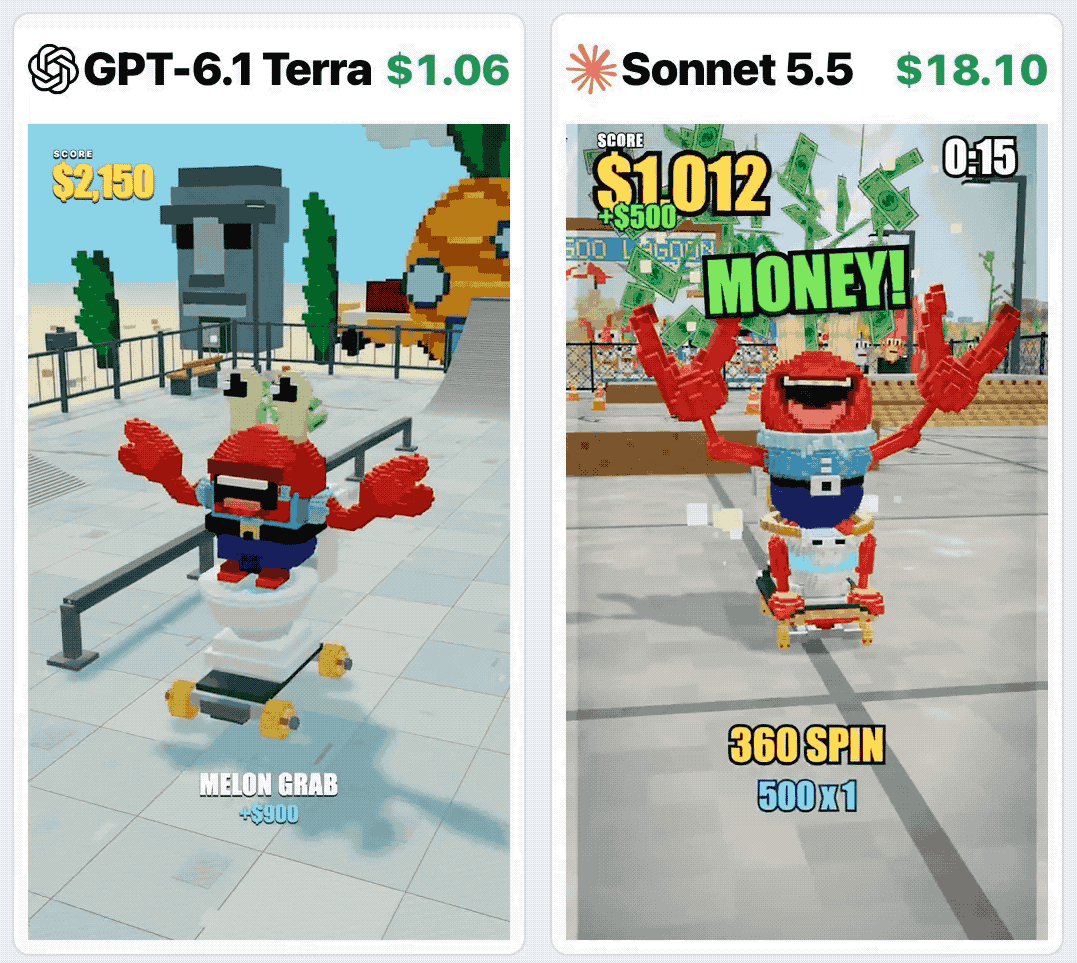
此外,从现有测试来看,GPT-6.1 Terra 在高难度任务的最终交付质量上,恐怕仍然比不上 Claude Opus 5.5,但考虑到它更低的价格和更快的执行速度,依然有不小的生存空间。毕竟,现实中有大量工作只需要 AI 把事情做完,并不值得每次都请出最贵的旗舰模型。
幻觉率大幅下降,编程成绩翻倍
除了视觉理解和电脑操作,GPT-6.1 Terra 在事实准确率与编程方面的进步同样明显。
OpenAI 表示,今年一直在重点解决模型产生幻觉和事实性错误的问题。
在其内部设计的高难度事实准确率测试中,GPT-5.6 Terra 在低推理强度下的错误率高达 53.6%,而 GPT-6.1 Terra 已将其降低至 16.7%,下降 36.9 个百分点。
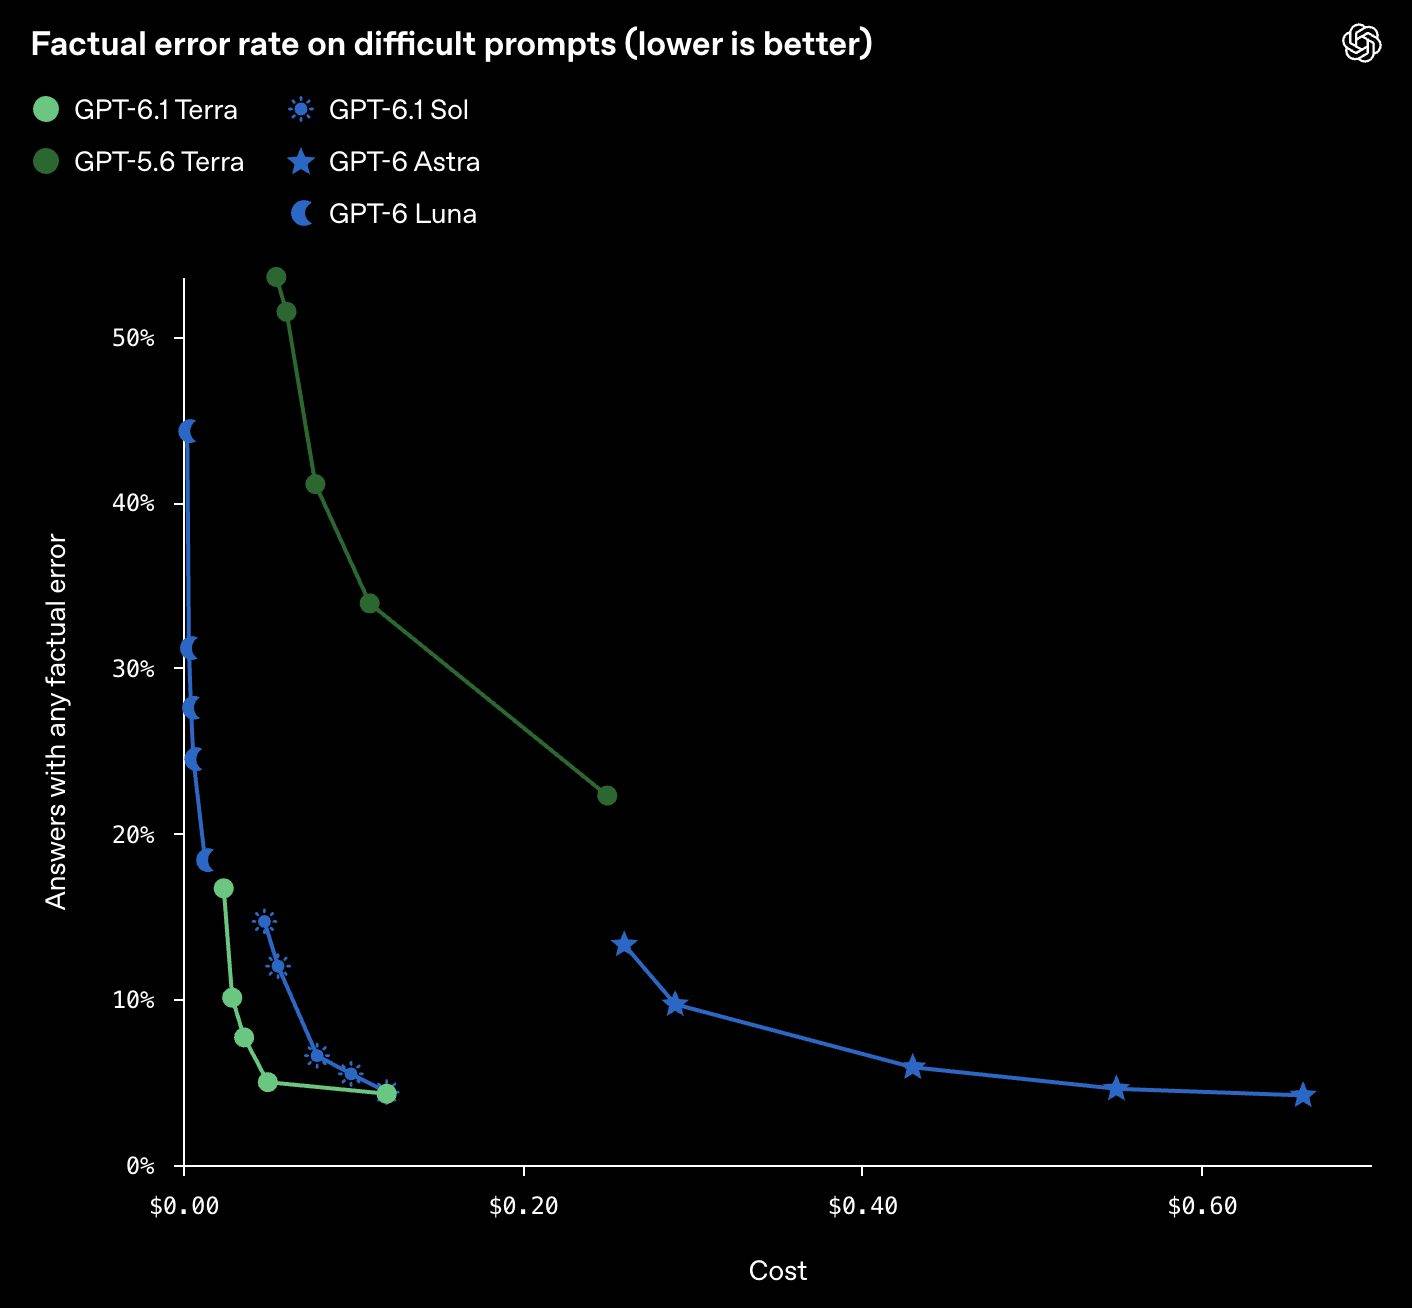
当推理强度提升至最高档时,新模型的错误率进一步下降至 4.3%,接近 GPT-6 Astra 和 GPT-6.1 Sol 的水平。
对于需要处理合同、技术文档和企业内部数据的 AI Agent 来说,事实错误率的下降尤其重要。毕竟,模型能够完成任务只是基础,执行过程中能否持续保持准确,直接决定了用户能否放心将更多工作交给 AI。
编程能力方面,GPT-6.1 Terra 也迎来大幅提升。
在测试 AI Agent 命令行编程能力的 Terminal-Bench 4.0 中,GPT-6.1 Terra 在最高推理强度下取得了 50.3% 的任务解决率,上一代 GPT-5.6 Terra 的公开成绩仅为 21.5%。
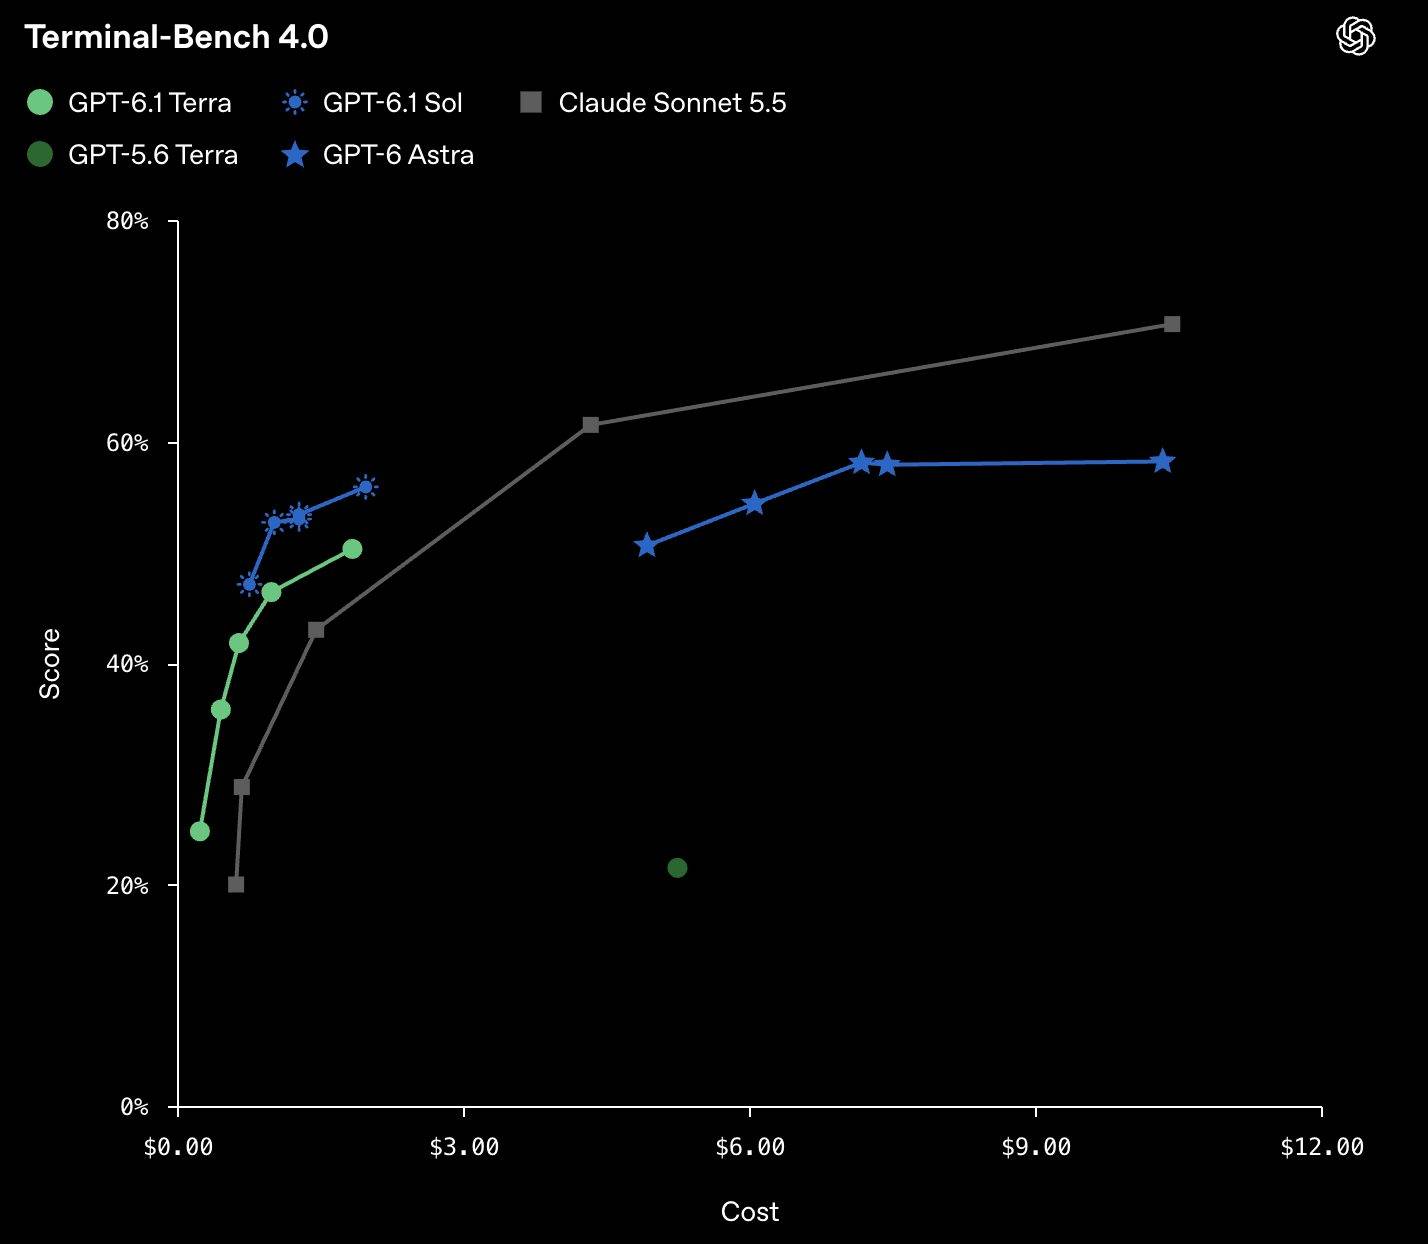
换句话说,新模型的编程测试成绩已经达到上一代的两倍以上。
在科学研究编程测试 Terminal-Bench-Science 0.1 中,GPT-6.1 Terra 甚至超过了定位更高的 GPT-6.1 Sol。
该测试包含利用代码分析延时摄影视频中的细胞分裂等科学研究任务。OpenAI 表示,GPT-6.1 Terra 的得分距离 Claude Opus 5.5 不足 5 个百分点,估算成本却低于后者的五分之一。
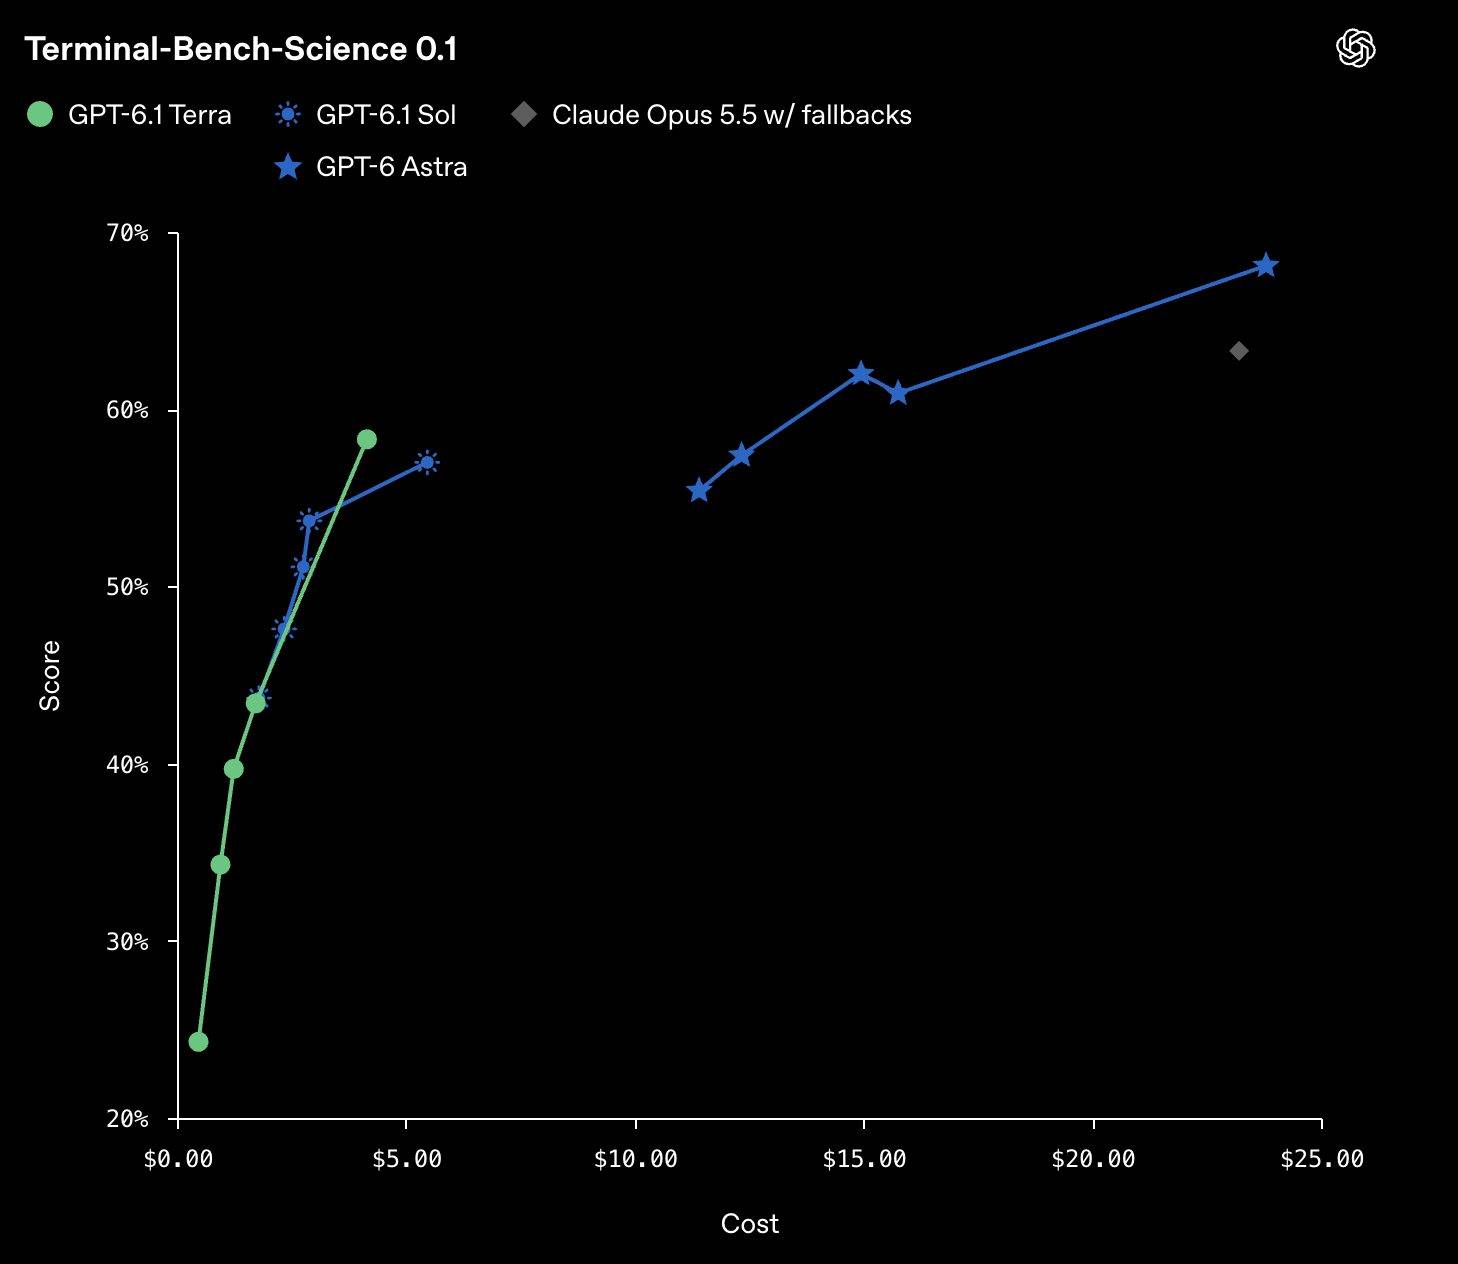
当然,OpenAI 也明确表示,对于最复杂的软件工程和深度研究任务,GPT-6.1 Sol 和 GPT-6 Astra 依然是更合适的选择。
API 价格腰斩,正式进入 ChatGPT Work 和 Codex
相比性能提升,GPT-6.1 Terra 的价格调整可能对开发者更有吸引力。
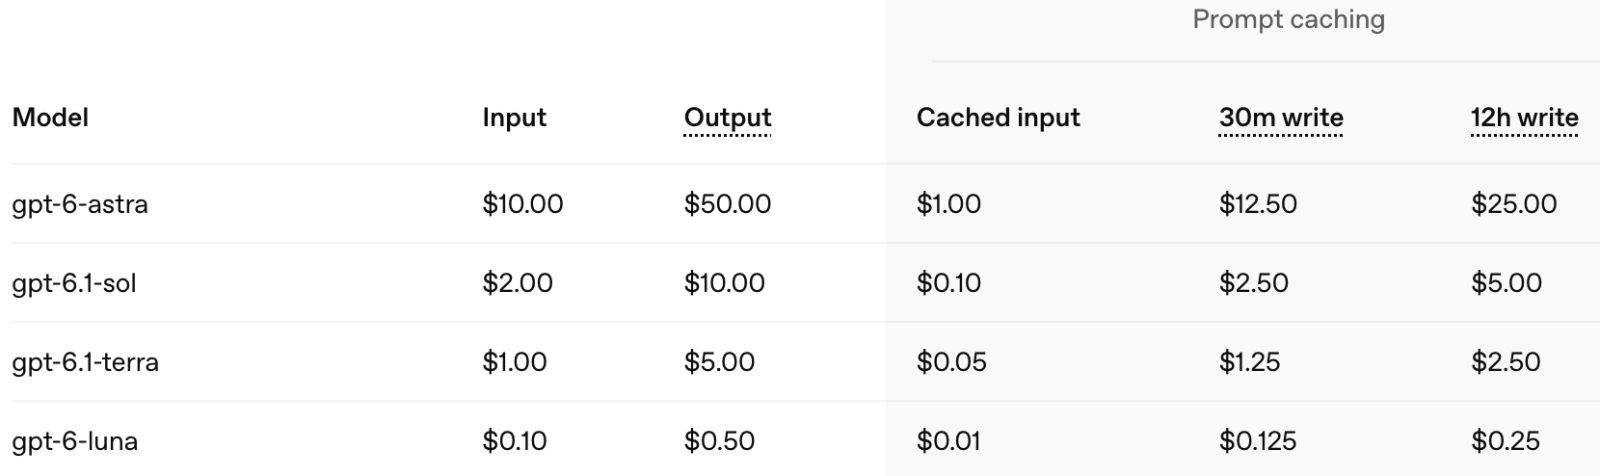
根据 OpenAI 公布的信息,新模型的标准 API 定价如下。
- 输入价格为每百万 Token 1 美元
- 缓存输入价格为每百万 Token 0.05 美元
- 输出价格为每百万 Token 5 美元
相比 GPT-5.6 Terra 和 GPT-6.1 Sol,GPT-6.1 Terra 的标准 API 价格降低了 50%。如果与旗舰模型 GPT-6 Astra 相比,其输入和输出 Token 的价格均只有后者的十分之一。
在产品层面,GPT-6.1 Terra 已经面向 ChatGPT Plus、Pro、Enterprise 和 Edu 用户开放,可以在 ChatGPT Work 和 Codex 中使用。
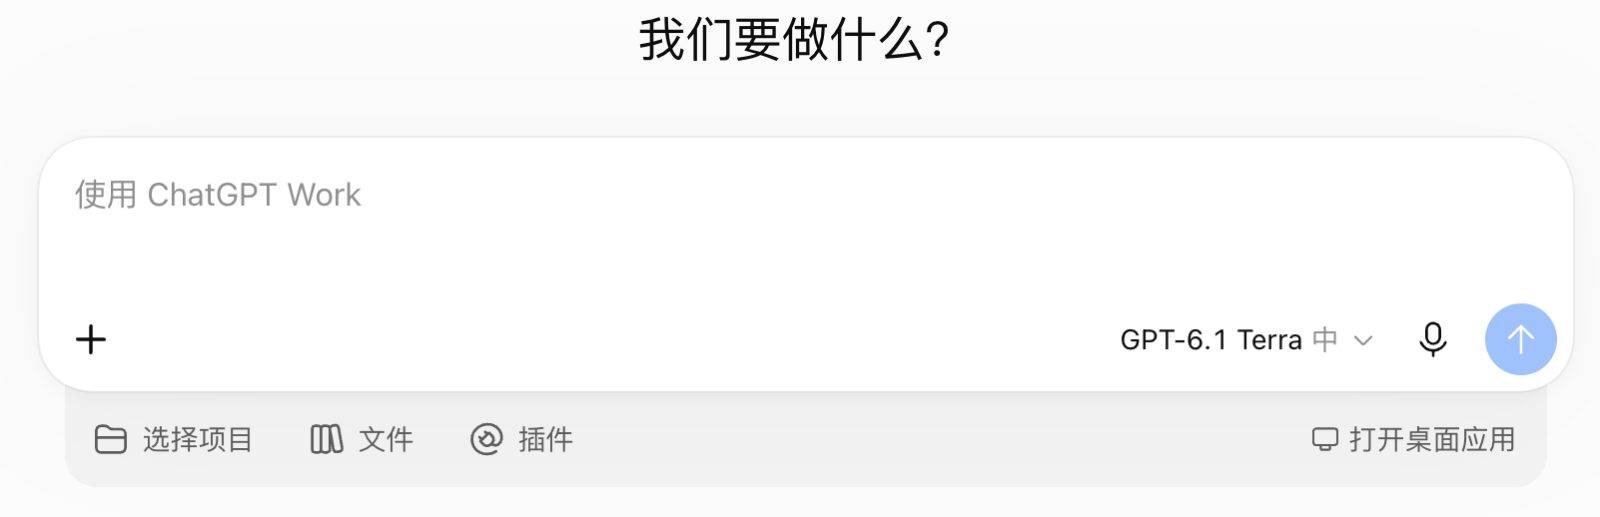
OpenAI 表示,在相同的使用额度下,用户能够通过 GPT-6.1 Terra 完成比 GPT-5.6 Terra 更多的任务,相较 GPT-6.1 Sol 和 GPT-6 Astra,额度使用效率的提升则更加明显。
开发者也可以通过 OpenAI API 调用该模型,模型名称为 gpt-6.1-terra。
安全方面,OpenAI 表示,GPT-6.1 Terra 在其 Preparedness Framework 中达到网络安全能力的 Critical 风险等级,因此沿用了 GPT-6 Astra 等模型的相关安全防护措施。
与此同时,新模型继承了 GPT-6 系列的对齐改进,在遵守用户授权范围、主动说明自身能力限制,以及抵御恶意提示词注入方面,相比上一代有所提升。
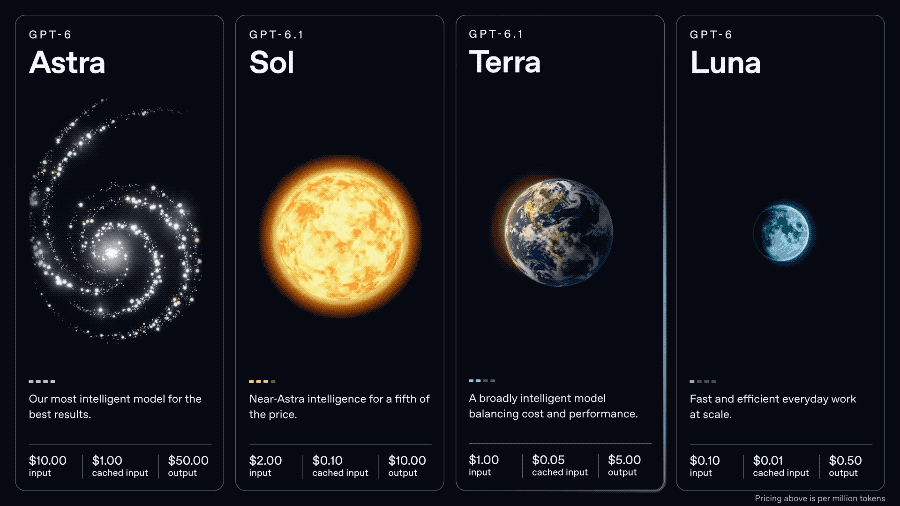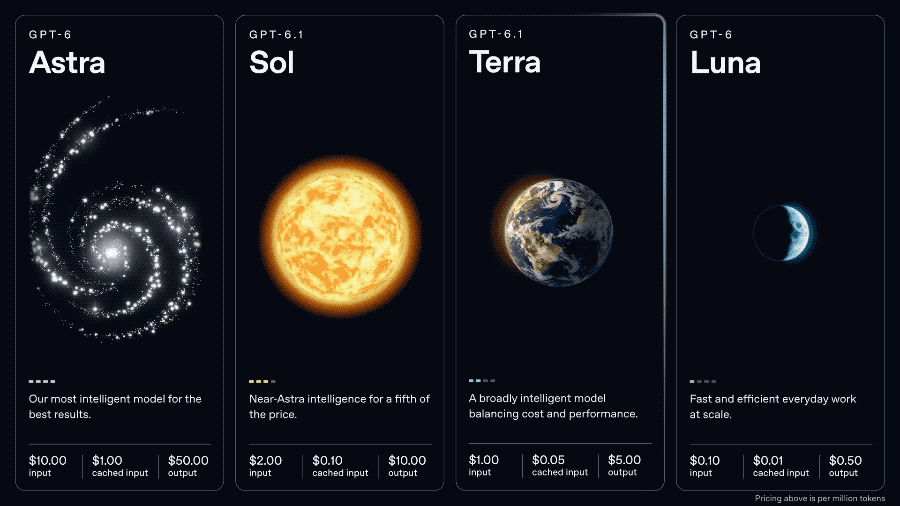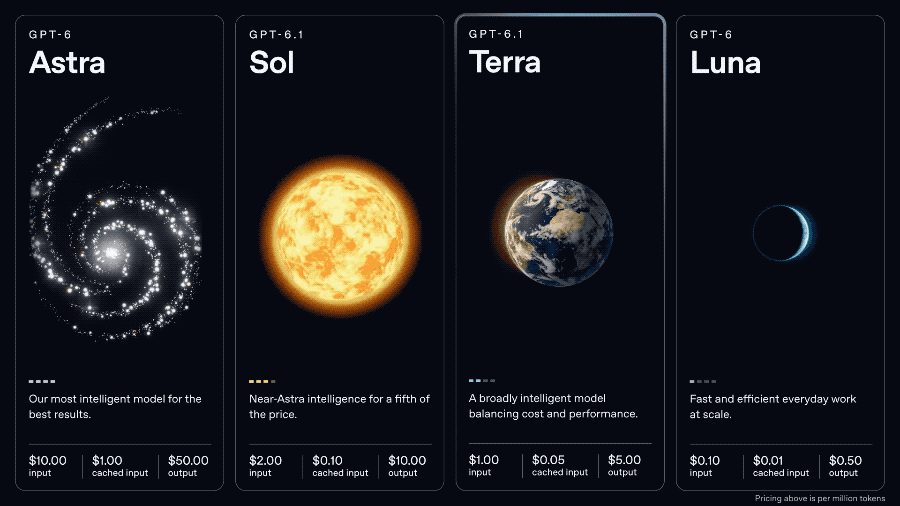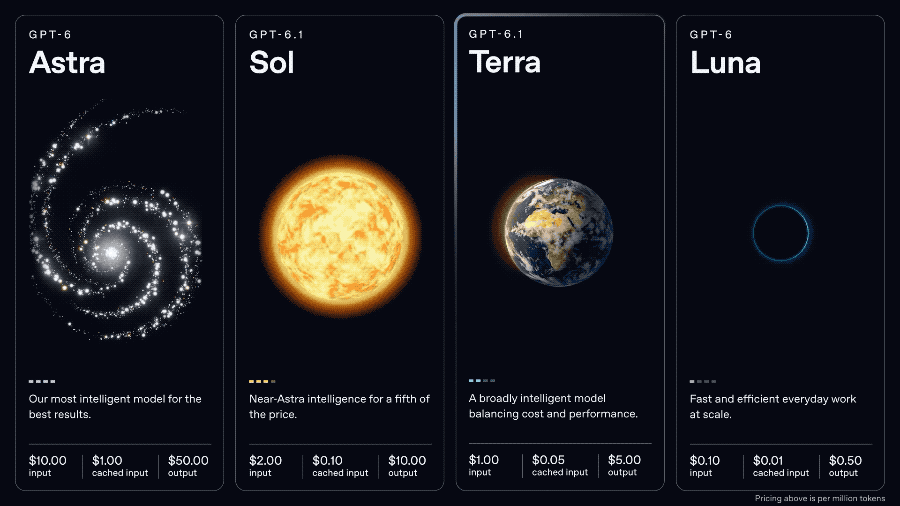
回看 OpenAI 今年的产品更新,从旗舰模型 Astra 到强调综合能力的 Sol,再到如今主打高效执行的 Terra,产品之间的分工正在变得越来越明确。
尤其是在 AI Agent 加速进入真实工作场景的背景下,模型竞争也开始从单纯追求更高的 Benchmark 分数,延伸到完成同一项任务究竟需要花多少钱、多少时间,以及能否持续可靠地执行。
过去,企业想让 AI 自动处理大量办公任务,往往需要在模型能力、速度和成本之间反复权衡。
GPT-6.1 Terra 的出现,正在降低这种权衡的代价。
当一个能够看懂屏幕、操作软件、理解复杂文档的模型,已经具备接近旗舰级的能力,却只需要十分之一的 Token 成本,AI Agent 也就有了从少数高价值任务走向大规模日常应用的现实条件。
对于 OpenAI 来说,让越来越强的 AI 变得越来越便宜,或许与发布下一款最强模型同样重要。
#欢迎关注爱范儿官方微信公众号:爱范儿(微信号:ifanr),更多精彩内容第一时间为您奉上。