100 万字还能流畅打字吗:给留白做一次性能体检


留白是我做的 Markdown 写作应用。后端是 Go,前端是 TypeScript 加 CodeMirror 6,用 MyGo 打包成桌面应用。在 macOS 上,界面跑在系统自带的 WebKit 里。
10 月 16 日晚上发了 0.1.0,10 月 23 日发了 0.6.3。这一周里加了很多东西:块手柄,表格和图片原地编辑,公式、Mermaid 图表、提示块、折叠块、脚注,Word 导出,Windows 预览版,11 套主题。功能加得这么快,我想知道编辑器有没有被拖慢。上一轮性能测试只测到 0.1.0 的阅读器基础,于是我让 Claude Code 再做一轮,把 0.6.3 和 0.1.0 对着测。
先说结论。普通长文没有变慢:只用加粗、链接、列表、表格和图片的文稿,各项都和 0.1.0 持平或更快。用到新语法的文稿变慢了:30 万字时移动一次光标,从约 5 ms 变成约 20 ms,超过了一帧。打开首屏有 Mermaid 图的文稿,慢了 0.2–0.3 秒。另外还查出一个功能问题:右侧大纲打开文稿后只列出首屏的标题,从 0.1.6 起就是这样。
修复分三批,随 0.6.4 在 10 月 26 日发布,CI 里也加了性能卡点。下面按顺序讲测法、问题和修法,也讲测量本身踩过的坑。
怎么测才可信
上一轮留下了三组基准:编辑器的状态更新在 Bun 里测,预览渲染在 Chrome 里测,存储在 Go 里测。它们离真实应用都有距离,编辑器那组只装了语法扩展和状态字段,没有视图,也没有渲染。
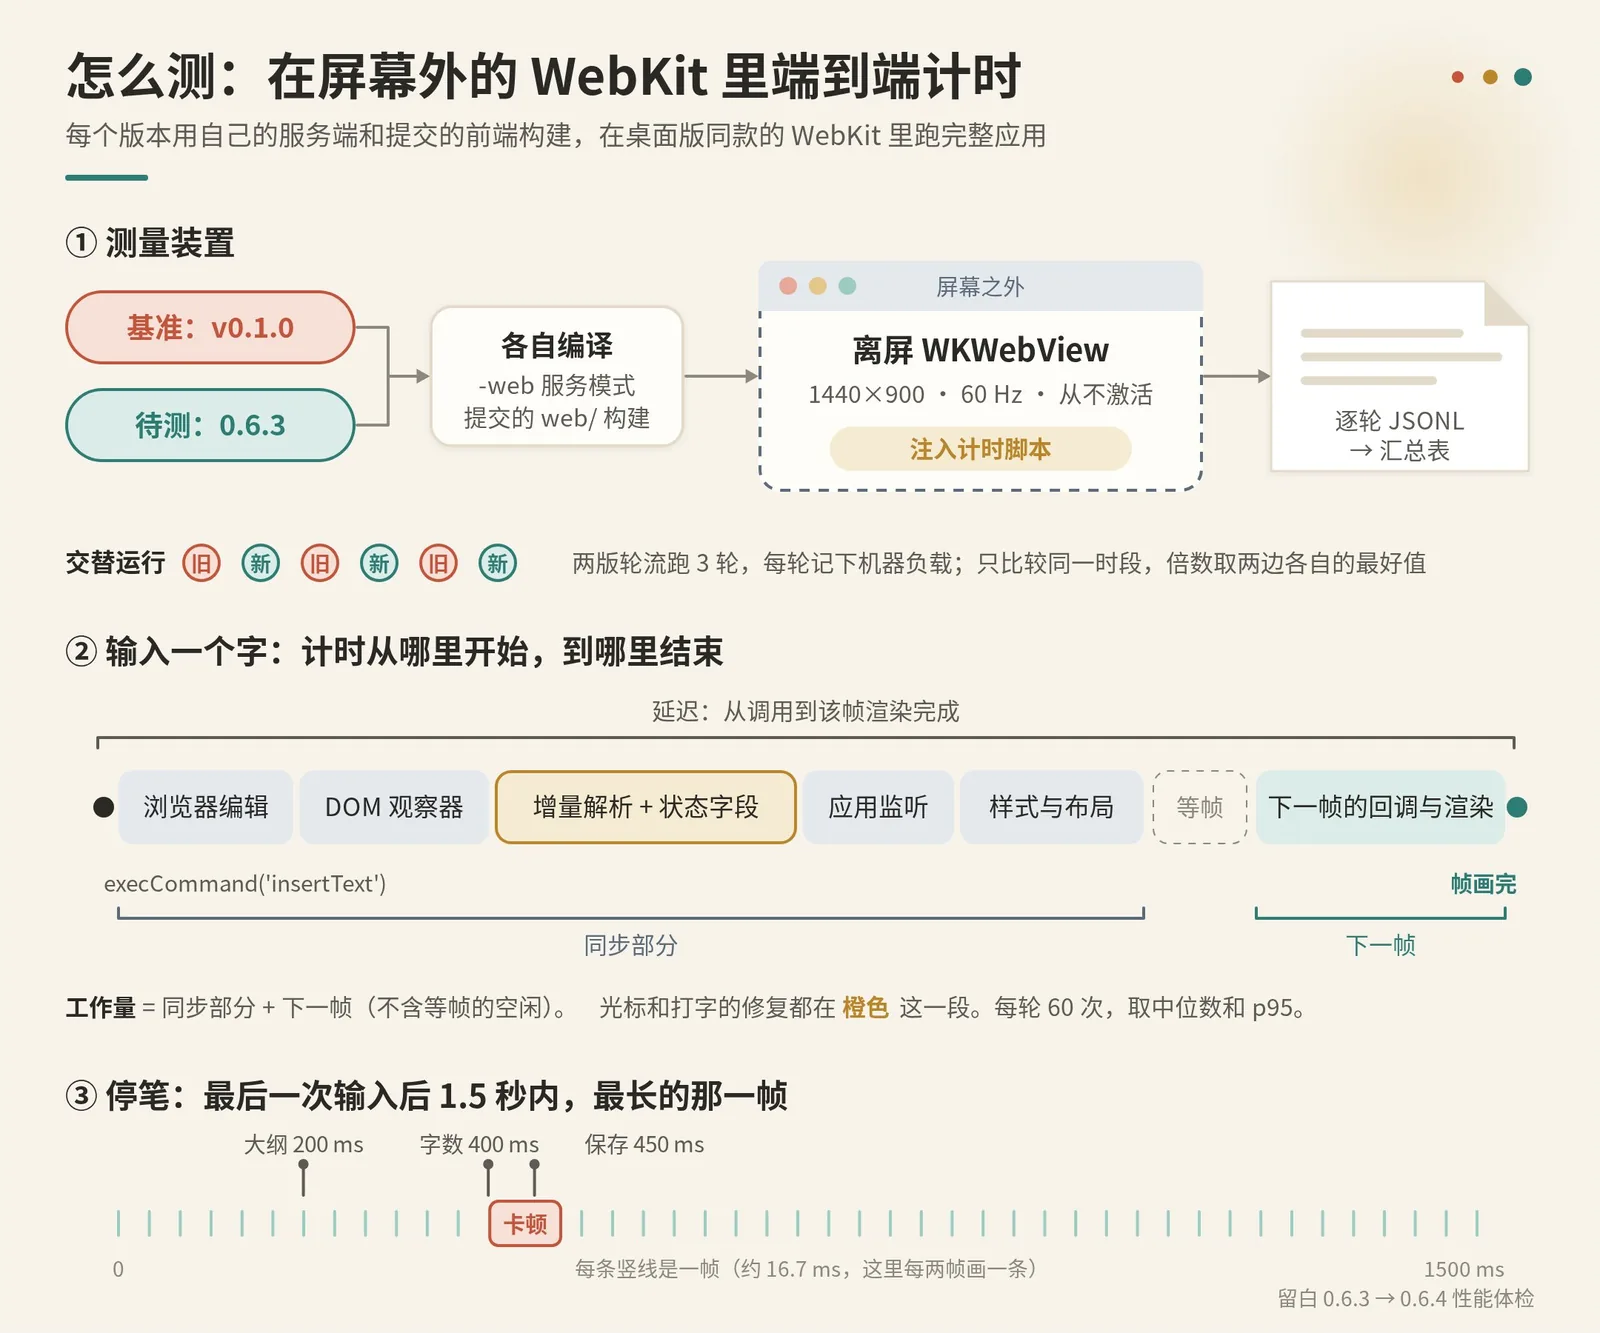
这次新加了一组 WebKit 端到端测试。每个版本用自己的服务端(-web 模式)和提交在仓库里的前端构建,在一个屏幕外的 WKWebView 里跑完整应用。WKWebView 就是桌面版用的引擎。窗口 1440×900,从不激活,不抢焦点,因为测试的时候我还在用这台 Mac。
输入一个字用的是 execCommand('insertText')。它和真实按键一样,要经过浏览器的编辑处理和 CodeMirror 的 DOM 观察器。计时分两种:「延迟」从调用算到该帧画完;「工作量」是同步部分加上下一帧的回调与渲染,不含等帧的空闲。每轮输入 60 次,取中位数和 p95。「停笔」量的是最后一次输入后 1.5 秒内最长的帧间隔,大纲(200 ms 后)、字数统计(400 ms 后)、保存(450 ms 后)都落在这段时间里。
还新加了一份「富文稿」:每节约 500 字,各有一个标题、行内公式、公式块、高亮、提示块、表格、图片、折叠块和一个脚注,每 4 节一张 Mermaid 图。这比一般笔记密集得多,是压力测试。
可信度靠三件事。一是两个版本交替跑,每轮都记下机器负载,只比较同一时段的数据。这台 Mac 平时的负载就有十几到几十,跨时段比较没有意义。二是承认精度:WebKit 的 performance.now() 只精确到 1 ms,相差 1–2 ms 不算差异。三是分清指标的可靠程度:「停笔后最长卡顿」每轮只有一个样本,内存读数受垃圾回收时机影响,同一场景轮间能差 30%,这两类只看大的变化。
富文稿慢了 3–4 倍
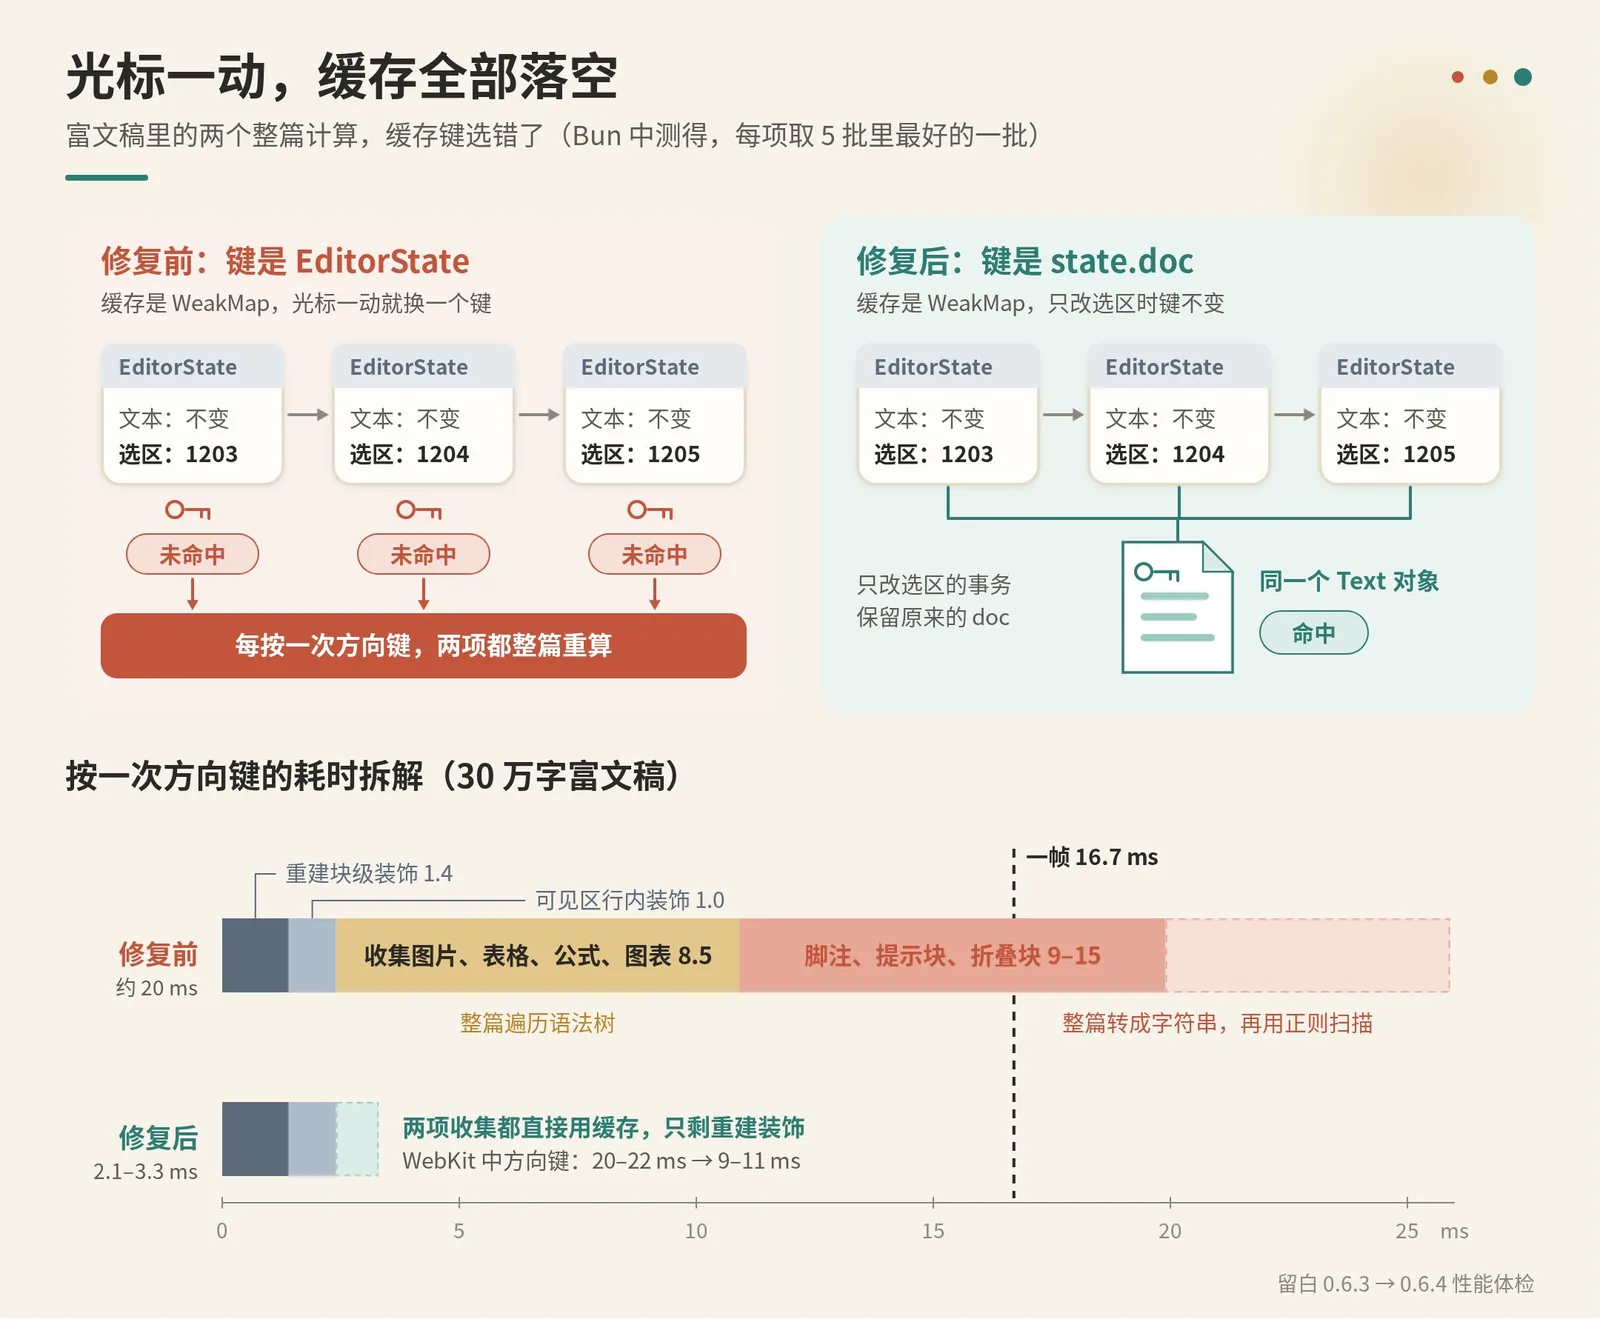
富文稿上移动光标,2 万、10 万、30 万字都慢了 3–4 倍。Claude Code 把 30 万字富文稿上的一次移动拆开来看:收集图片、表格、公式和图表的范围,要整篇遍历语法树,约 8.5 ms;收集脚注、提示块和折叠块,要把整篇转成字符串再用正则扫描,约 9–15 ms;重建块级装饰约 1.4 ms,可见区的行内装饰约 1 ms。
这两个收集函数的结果只取决于文本和语法树,移动光标时这两样都不变。它们本来有缓存,问题出在缓存的键上:用的是以 EditorState 为键的 WeakMap。CodeMirror 的状态是不可变的,光标每动一下都会产生一个新的 EditorState,缓存次次落空。0.1.0 在选区变化时也会整篇遍历,但只收集表格和图片,也没有脚注扫描,所以没这么慢。
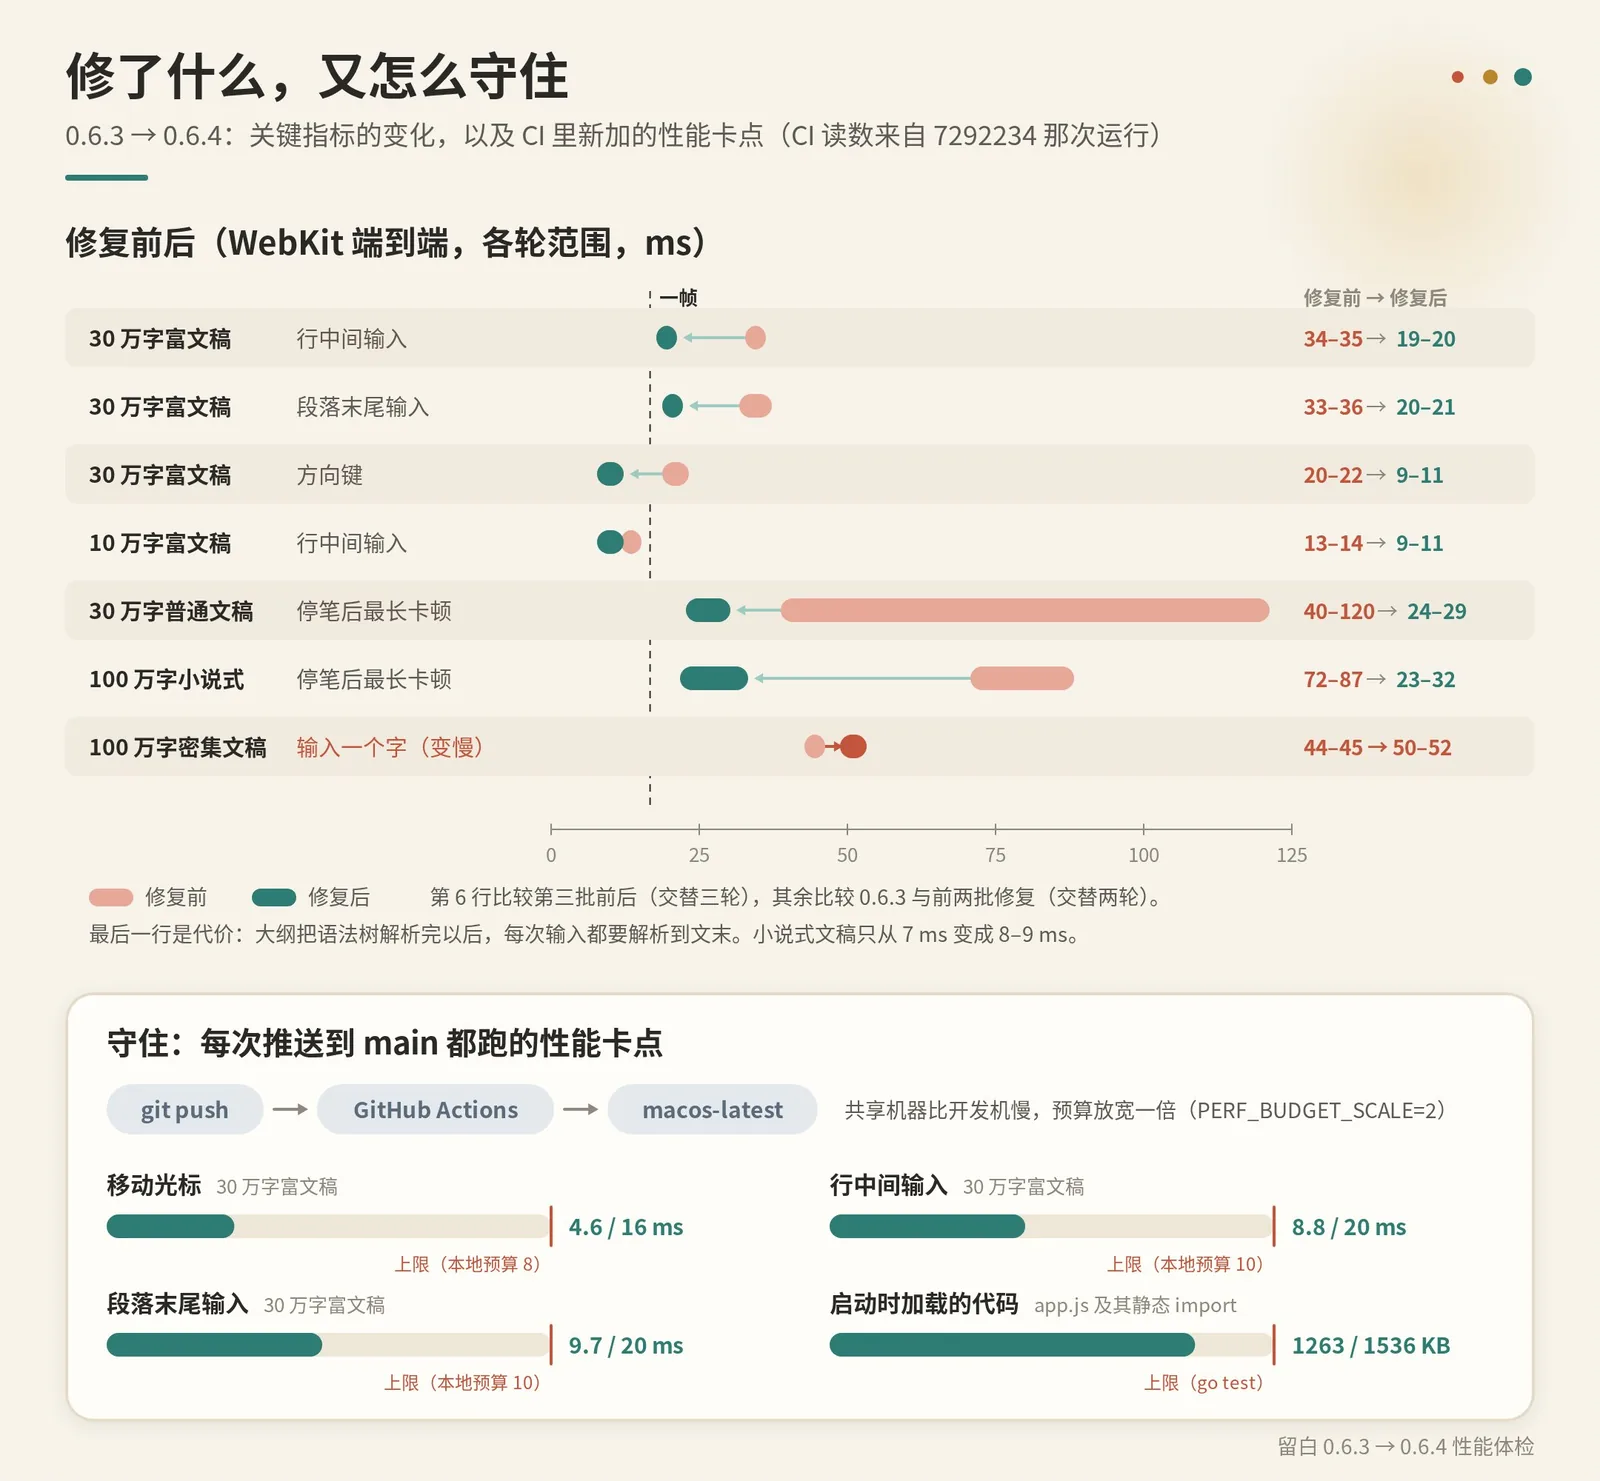
改法只有几行:键换成 state.doc。它是 Text 对象,只改选区的事务会原样保留它。同一时段对比,30 万字富文稿移动一次光标从 16.5 ms 降到 2.1–3.3 ms(Bun),WebKit 里按一次方向键从 20–22 ms 降到 9–11 ms。
打字也慢了 2–2.5 倍,原因是每次改动都要整篇重扫脚注、提示块和折叠块。在普通段落里打字改变不了它们,可以像图片等小部件一样只平移位置。难点在于「改变不了」要判断准。最后定下的条件是:改动所在的行,改前改后都不含 [ ] < > $ ` ~ \ 这几个字符,不以空白开头,也不在文首的属性区里。测试用 5 个定向编辑和 400 个随机编辑,逐项比较平移的结果和重新扫描的结果。去掉任何一个条件,测试都会失败。每条新测试也都先看着它失败一次,再写修复。
改这一项时,又查出一个更早的问题。0.6.3 本来有一条快路径:在普通段落里打字,图片、表格、公式和图表的位置只做平移,不再整篇重新收集。可它判断「光标在不在段落里」用的是 resolveInner(pos, 1),只看光标右边。光标在段落末尾时,右边已经不属于这个段落,于是找不到段落,每打一个字都整篇重新收集小部件、重扫脚注。偏偏段落末尾是写作时最常打字的地方,而前面的基准都是在行中间输入的,正好把这一项漏掉了。改成左右都看以后,30 万字富文稿在段落末尾输入一个字,从 23.6 ms 降到 5.9 ms(Bun)。
大纲只列首屏的标题
停笔后的卡顿也变长了:10 万字普通文稿从 18–26 ms 变成 33–37 ms。多出来的主要是右侧大纲。0.1.0 的大纲只在打开侧栏时生成;0.6.3 的大纲默认显示在右侧,每次停笔 200 ms 后清空列表,再给每个标题新建一个按钮。10 万字、374 个标题,整列重建一次约 9 ms。
测这个耗时的时候,发现了一个功能问题。打开 2 万字、75 个标题的文稿,大纲只列出 11 个;等 5 秒,还是 11 个;编辑一次,才补全到 75 个。30 万字、1123 个标题的文稿更糟,编辑一次以后也只到 377 个。
原因在 CodeMirror 的解析方式。打开文稿时,它只把语法树解析到可见区附近,其余放到后台慢慢解析,而且最多解析到可见区之后 10 万字(MaxParseAhead)。大纲在打开时生成一次,之后只在编辑时刷新,后台解析的进展它看不到。30 万字文稿的后三分之二,除非滚过去,否则一直不在树里。0.1.6 加入右侧大纲时就是这样,之后每个版本都如此。按代码推断,按标题跳转也有同样的问题,因为它也是在当时的树上找标题。
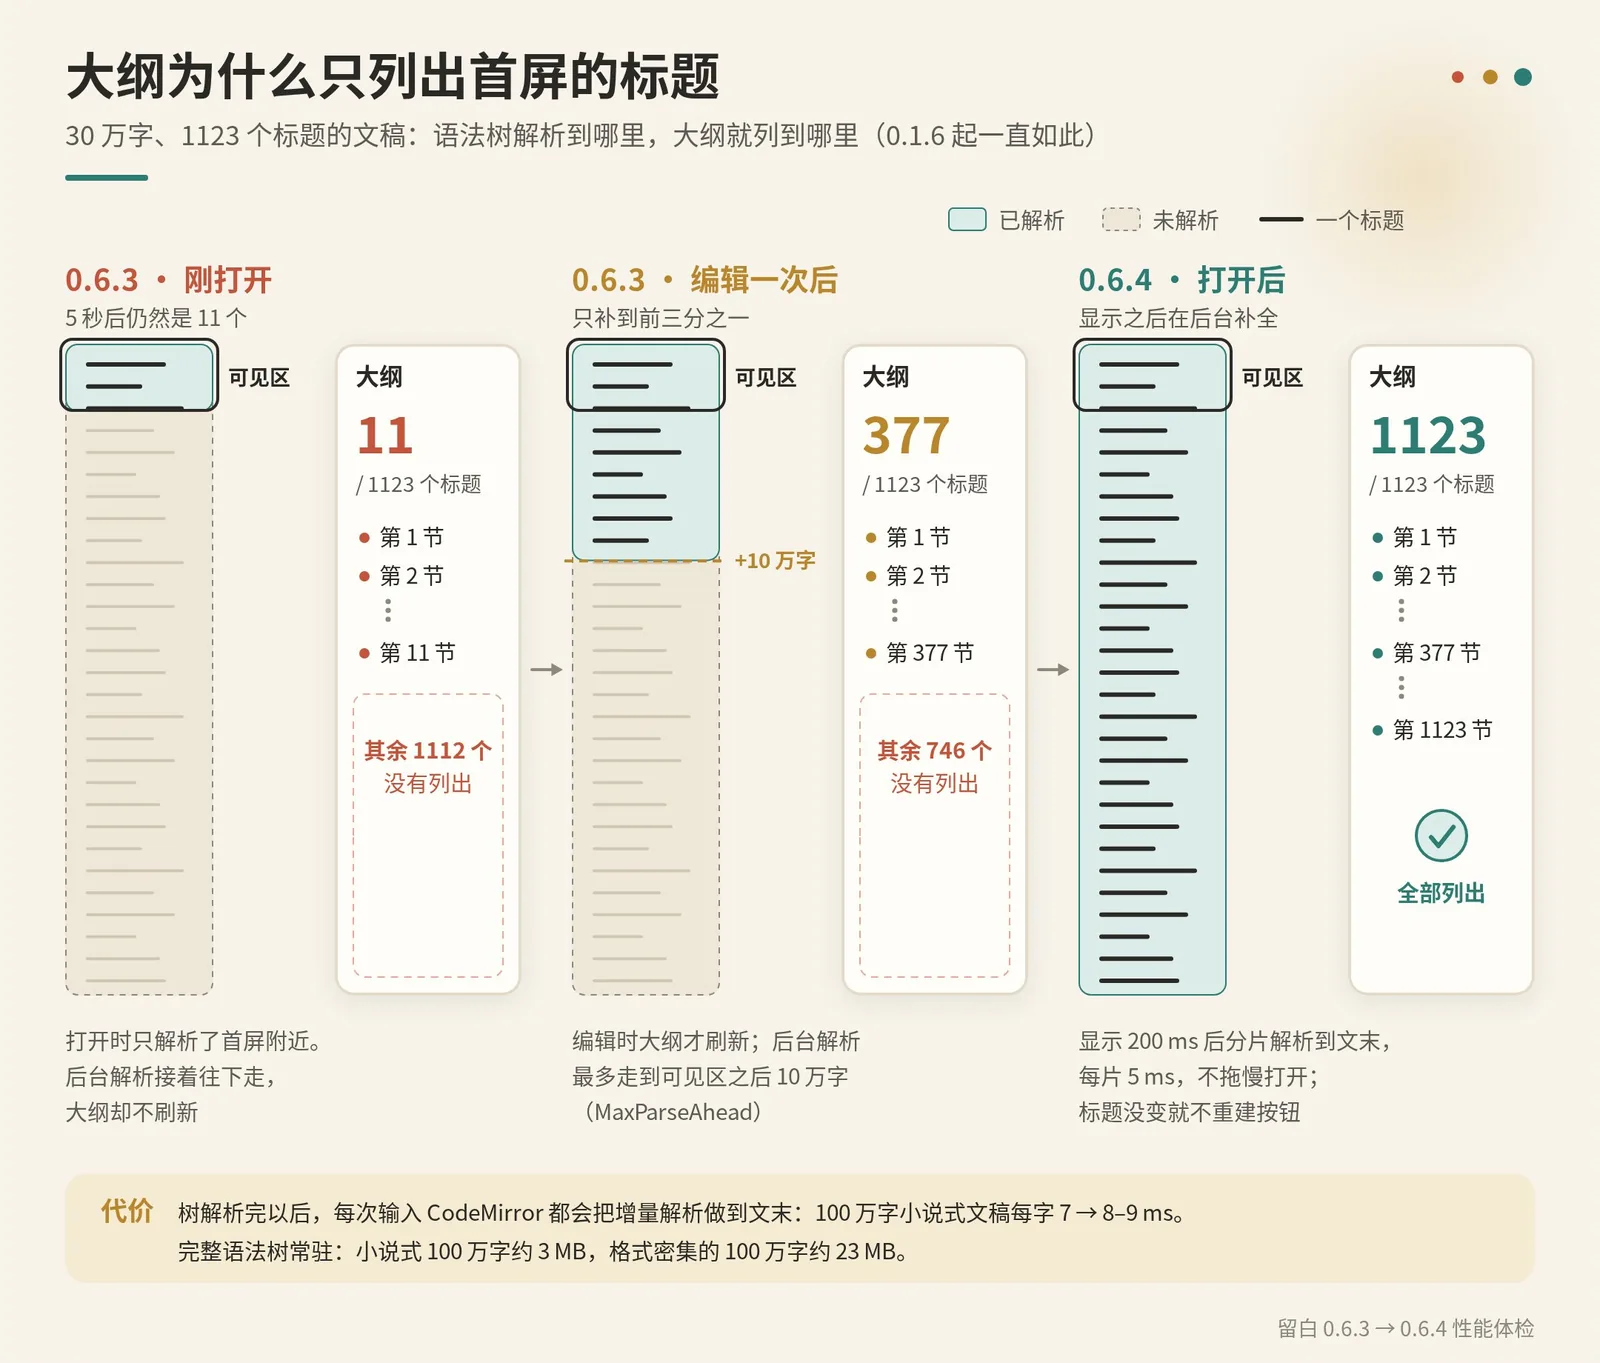
修法是:文稿显示出来 200 ms 后,用 ensureSyntaxTree 分片把树解析完,每片 5 ms,再列出全部标题。标题没变时不再重建按钮,跳转也改用解析完的树。
第一版不是这样写的。它在打开时同步解析,每片 20 ms,结果 10 万字普通文稿打开慢了 30–100 ms,这才改成显示之后再补。这个改动也有代价:树一旦解析完整,此后每次输入,CodeMirror 都会把增量解析做到文末。小说式文稿影响很小,100 万字从 7 ms 变成 8–9 ms;格式极密的 100 万字文稿从 44–45 ms 变成 50–52 ms。其实在 0.6.3 里,只要用户滚到过文末,也是这样。完整的语法树还要常驻内存,小说式 100 万字约 3 MB,密集文稿约 23 MB。
上限看块数,不看字数
报告写完,我问了一句:输入上限呢?
Claude Code 拿那份普通测试文稿从 5 万字扫到 200 万字,结论是:普通文稿在一帧以内大约能撑到 20 万字,公式和图表多的约 10 万字。它还加了一句判断:「在 CodeMirror 6 加 Markdown 这条技术路线上,我们离下限已经不远。」
我回了一句:听说有款编辑器,100 万字都能高效渲染。
它没搜到我说的那款编辑器,但回头查了自己的结论。那份「普通测试文稿」每 230 字就有一组标题、列表、表格和图片,真实的长稿不会这么写。它按小说的结构另造了一份:每章约 5000 字,段落 50–300 字,偶尔有对话和加粗。结果 30 万字输入一个字约 6 ms,100 万字约 7 ms,200 万字约 10 ms,都在一帧以内。
差别来自 Markdown 的增量解析。它的开销跟着顶层块的数量走,不跟字数走,每个块约 0.4 µs。同样 100 万字,测试文稿有近 3 万个块,每输入一个字光解析就要 12.4 ms;段落约 200 字的只有 4588 个块,1.1 ms;段落约 1000 字的 991 个块,0.45 ms。唯一的例外是段落长达 5000 字的那份,只有 200 个块却要 2.1 ms,因为正在改的那一段本身太长,行内解析要重做。小说式的 100 万字约有 6000 个块,解析不是瓶颈。
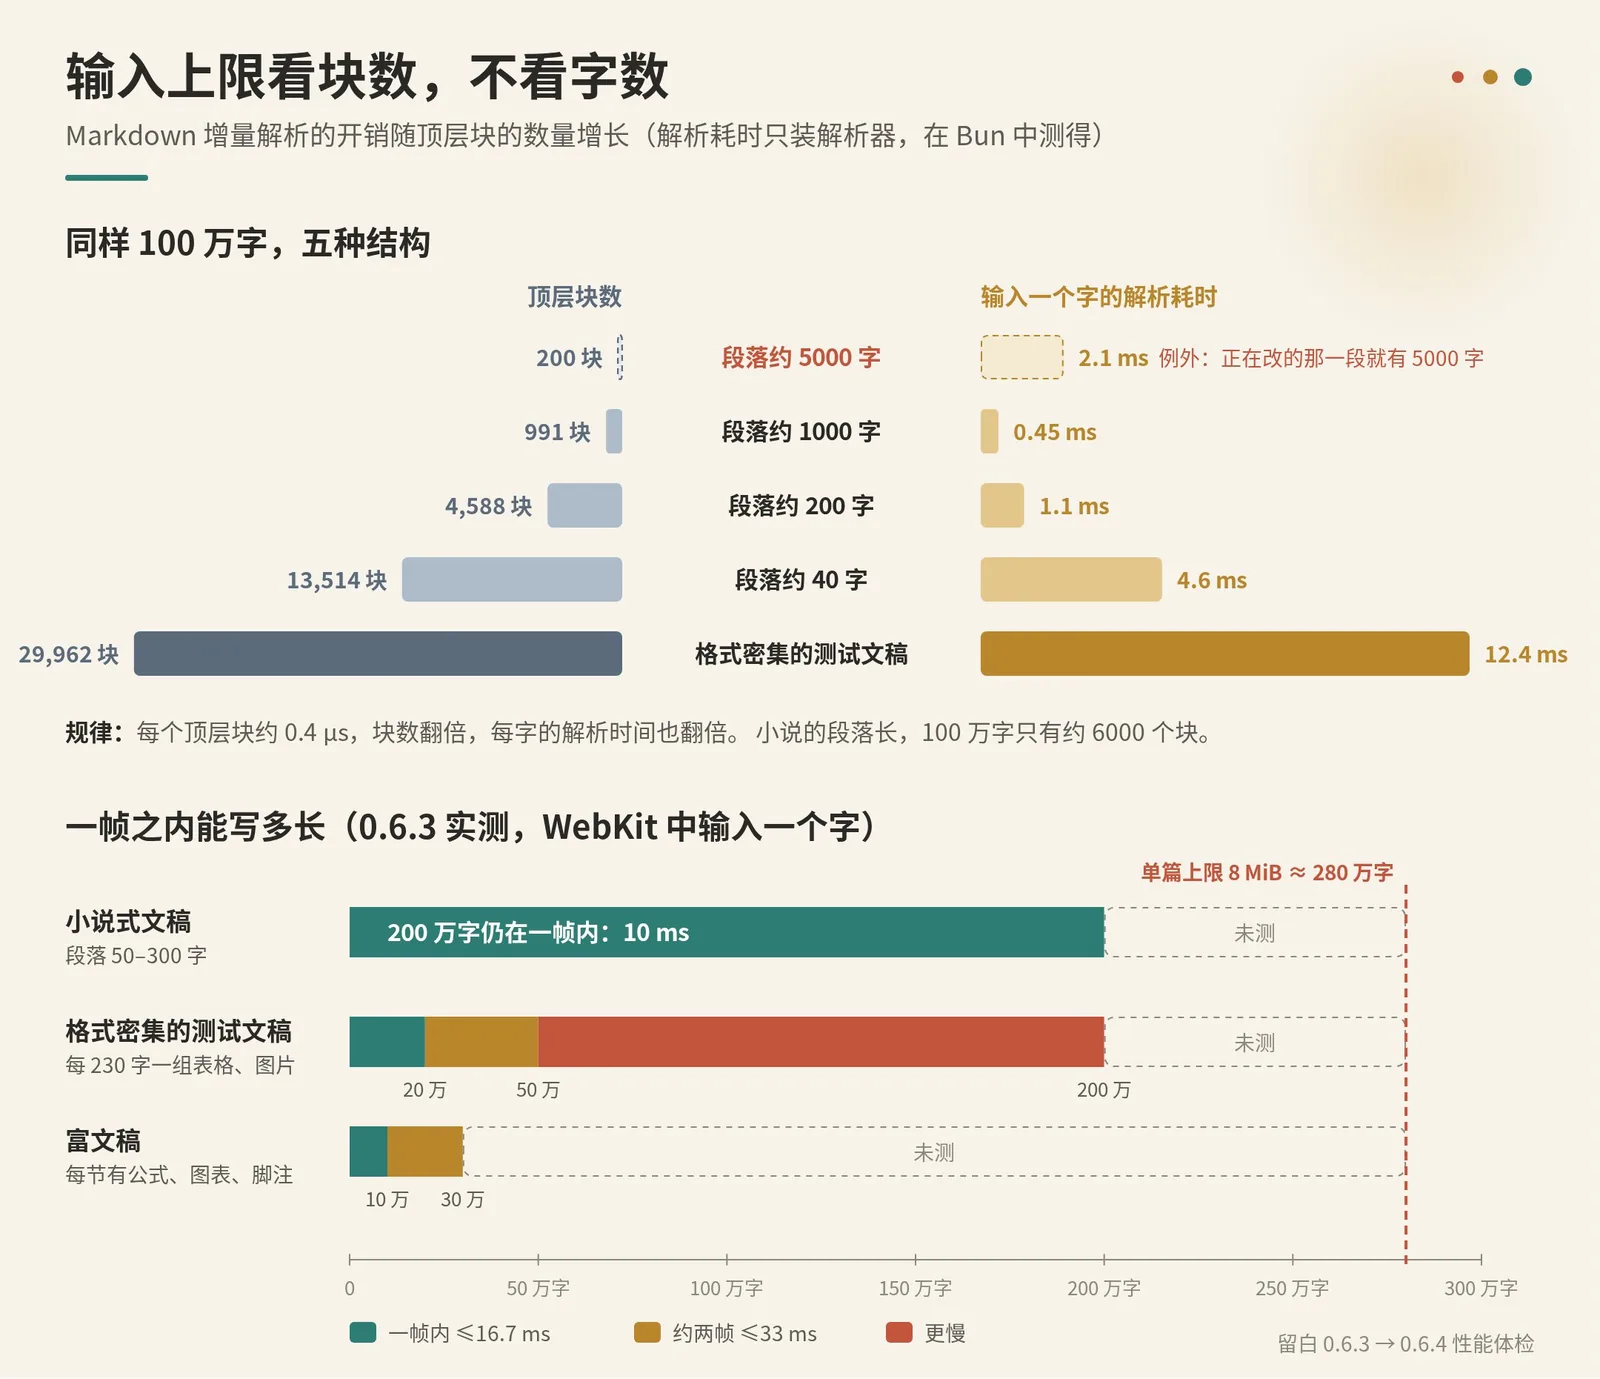
所以「20 万字上限」是错的,那只是一份极端密集的文稿的上限。报告里这一节按新结果改了过来,标题就叫「输入上限取决于文稿结构,而不是字数」。在密集文稿上,一次输入有七成时间花在 CodeMirror 的 Markdown 解析器本身,应用这一层还能省的,是每次都重建全部表格和图片小部件的那两成。单篇文稿的硬上限是 8 MiB,纯中文约 280 万字。
这次纠错是我追问、它重测出来的。如果我没回那一句「100 万字」,报告里会一直留着一个错的上限。
把主线程让出来
超长文稿剩下的问题,是停笔后的卡顿。0.6.3 里,100 万字小说式文稿停笔后最长卡约 70 ms,200 万字约 150 ms。来源有三个:整篇统计字数,重建大纲,整篇保存。大纲已经改成标题不变就不重建,第三批先处理字数。
字数统计挪进了 Web Worker:一个约 1 KB 的经典 worker,统计函数不变,结果完全一致。只采用最新一次请求的结果;文本没变时,比如切换界面语言,直接沿用上次的结果;worker 起不来或出错时,回到页面上统计。
这里有一处没把握:MyGo 在 macOS 上用 WKURLSchemeHandler 以自定义协议 mygo://localhost/ 提供前端,worker 能不能从这种协议加载?Claude Code 写了一个屏幕外的 WKWebView 小程序,用同样的方式注册协议,加载打包后的 worker,结果正确。Windows 的 WebView2 走 http://mygo.localhost/,本来就支持 worker。
100 万字小说式文稿停笔后的最长卡顿,从 72–87 ms 降到 23–32 ms。作为对照,同一个版本关掉 worker,又回到 86–113 ms。
Mermaid 的问题是:首屏有图时,打开要先加载、执行 5.3 MB 的 Mermaid 模块,这段时间里主线程画不了第一帧。现在改成先等一帧画完再加载运行时,页面隐藏时没有帧,最多等 200 ms。正文先出来,图随后出现。
最后是代码分割。启动时要加载的代码原来是一个 2290 KB 的 app.js,大头是代码块各语言的语法分析器。开启 esbuild 的代码分割以后,启动时只加载 9 个文件,共 1263 KB,另外约 125 个分块用到时才加载。分析器必须和编辑器共用同一份 CodeMirror,所以不能像 Mermaid 那样单独打包,只能用 esbuild 自带的分割。
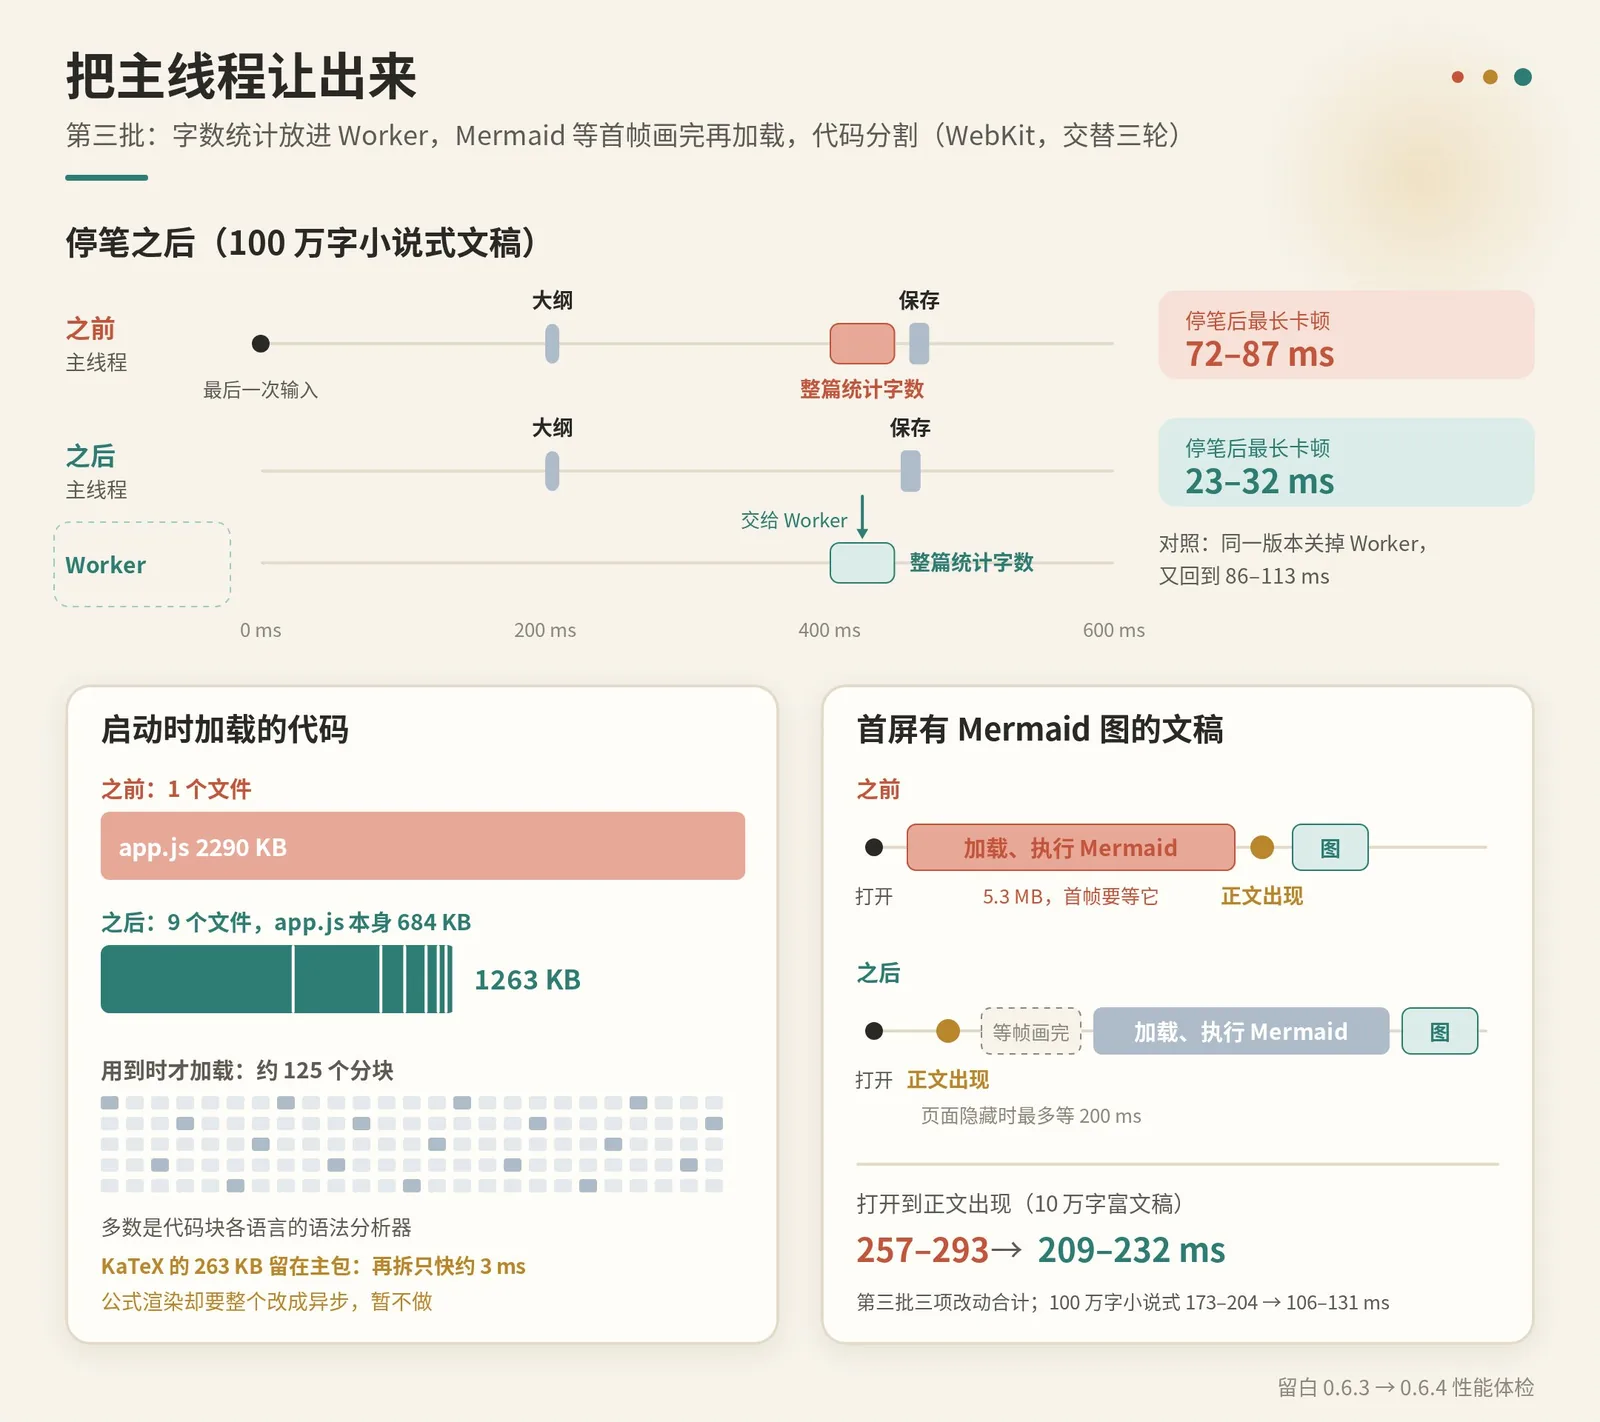
三项合起来,10 万字富文稿打开到正文出现,从 257–293 ms 降到 209–232 ms;100 万字小说式文稿从 173–204 ms 降到 106–131 ms,其中一部分来自 worker,打开时的那次整篇统计不再占用主线程。
KaTeX 没有改成按需加载。按代码分割的实测推算,主包再少它的 263 KB,打开只能快约 3 ms;代价是公式渲染要改成异步,牵涉编辑器、预览、HTML、PDF、Word 导出和复制富文本。Claude Code 把它列为待定,我决定先不做。
测量本身的坑
这一轮花在「测准」上的时间,不比修 bug 少。有几件值得记下来。
负载 178 的那天。 10 月 25 日,这台 Mac 的 1 分钟平均负载一度到 75–178。那段时间连没改过的代码都跑不过回归测试,当时的结果全部作废,之后先看负载再跑。
「打开」的口径错过一次。 最初记录的是第一个显示正文的帧之后、再下一帧画完的时间。Mermaid 推迟到首帧之后才加载,正好落在这两帧之间,被算进了打开时间,看上去像是没变快。后来改成第一个显示正文的帧本身画完的时间,也就是用户看到正文的那一刻。
内存读数看不出东西。 大纲补全以后,10 万字富文稿编辑后的 WebKit 进程内存读数高了约 100 MB,看着像泄漏。在 Chrome 里强制回收后再比,两边的 JS 堆都在 22 MB 左右。多出来的是还没回收、或还没还给系统的内存,不是常驻的数据。
符号链接改了分块的哈希。 改动最后拆成 9 个提交,每个提交都要在 worktree 里重新构建,核对提交进去的 web/。worktree 里的 node_modules 起初是指向主仓库的符号链接,结果代码分割出来的分块哈希和正常构建的不一样。换成真实目录以后,每个提交里的 web/ 都和重新构建的结果一致。
还有一件小事:显示器休眠时 WebKit 不绘制,测试会一直等下一帧。后来测试框架改成,显示器休眠时每 30 秒重试一次。
守住成果
修好的东西,下次加功能时很容易又慢回去。所以这次在 CI 里加了性能卡点:每次推送到 main,GitHub Actions 都在 macOS 上跑两项检查。
一项是即时排版的性能预算(check-performance),新加了 30 万字富文稿的三条:移动光标低于 8 ms,行中间和段落末尾输入都低于 10 ms。CI 用的共享机器比开发用的 Mac 慢,所以 CI 里预算放宽一倍(PERF_BUDGET_SCALE=2),这样仍然能抓住成倍的退化。0.6.4 那次提交在 CI 上的读数是 4.6、8.8、9.7 ms,预算是 16、20、20 ms。
另一项是启动时加载的代码大小(TestStartupBundleStaysSmall):从 app.js 沿着静态 import 收集启动时必须加载的文件,总和不能超过 1536 KB,而且必须真的存在按需加载的分块。
测试工具和数据也都提交进了仓库:scripts/bench/ 是整套基准,docs/performance/ 里是两份报告和逐轮的原始数据。下一轮只要跑 ROUNDS=3 scripts/bench/run.sh <基准版本>,约 25 分钟出结果。
谁做了什么
这一轮从测试到发版,动手的几乎都是 Claude Code:写测试框架,交替跑数据,把每一毫秒拆开,写原型,写带测试的修复,写报告,再签名、公证、发布 0.6.4,更新官网。
我做的是几个判断:要不要做这一轮;追问「输入上限」,又拿「100 万字」反问回去,把一个错的结论问了出来;KaTeX 先不拆;工具和报告要提交,README 要写清长文档该有什么预期,CI 要加卡点。
还没做的有三件,都记在报告里。一是在普通段落里打字时不再重建全部块级小部件,100 万字的密集文稿每个字能省约 3 ms。二是保存时不在主线程整篇序列化,这是超长文稿停笔后剩下的主要开销。三是密集超长文稿的解析,这要从解析器本身下手。另外,这几轮都没有在打包好的原生应用里实测,也没有在 Windows 真机上测。
回到标题的问题:100 万字还能流畅打字吗?结构像小说的话,能,每个字约 8 ms。每两三百字就有表格和图片的话,20 万字以内。