
从通用大模型到具身智能,还有多远


近期围绕物理AI与具身智能,产业界有几项进展。OA的Astra展现出跨界控制机器人能力,在物理动作测试中超越多款专门训练的具身模型,同时以三倍薪酬招募执行器、齿轮设计与数据运营人才,重启硬件研发;AMD以82亿美元收购李飞飞的World Labs,英伟达持续完善Cosmos与Groot工具链。
过去两年,市场看具身智能主要沿用制造业零部件的视角,例如丝杠、减速器和电机等。近期的信号表明重心正向具身大脑与物理数据转移。特别是当通用大模型介入机器人任务,原有技术路线和商业分工都会受到影响。
通用大模型能否替代专用机器人模型、走向商业化还隔着哪些物理与经济门槛?简单谈谈看法。
提示:本文仅为学习思考记录,不构成任何投资建议。
一、从通用大模型切入具身智能说起
要理解通用大模型对行业的影响,可以先把具身智能任务按难度拆分为三个层级:
第一类是导航:解决二维平面移动,如扫地机和L4自动驾驶,已进入商业化放量期;
第二类是移动:解决三维空间的动态平衡与步态控制,随着强化学习在四足机器狗和双足机器人上的成熟,巡检、展示等场景已跑通早期闭环,宇树、智元等头部厂商已借此实现正向利润;
第三类是操作:让机械臂与物理世界发生真实接触并完成作业。操作任务占到工业与家庭场景的80%至90%,也是目前算法尚未收敛、制约产业化的核心卡点。
此次Astra引发关注正是因为它在最难的操作环节展现出泛化潜力。过去未经专门训练的语言模型在物理动作榜单上成功率不足2%,而Astra依靠预训练引入的第一视角数据以及空间推理与代码编写能力,将单模型成功率推高到22%以上。
做个类比,专用具身模型像刷了三年题库的高中生,在熟悉题型上反应快,遇到陌生环境容易卡壳;通用大模型像逻辑强的竞赛生,虽没练过具体动作,但能把指令拆解成规划步骤并写代码驱动机械臂。
不过,把通用大模型直接用于控制动作,在工程落地中还面临三道物理约束:
1. 推理延迟与动作输出频率的矛盾:人类完成几秒钟的流畅操作,手部包含数十个细微动作,要求控制系统的动作输出频率达到20至30赫兹,单步延迟控制在20毫秒以内。而通用大模型参数量达万亿级,每次行动都要在云端长链条推理。
比如倒水任务,专用小模型1分钟内可完成,万亿大模型从思考到执行往往耗时3-4分钟。至于流传的流畅演示视频,大多都经过10-20倍的快放处理。
2. 单次任务的算力调用成本过高:在云端持续调用万亿参数模型并配合语言引导来执行一项完整操作,单次算力成本高达数百美元。
相比之下,30B至50B以内的专用机器人模型在预训练后微调成本显著更低,小于7B的模型甚至可以直接部署在端侧消费级显卡上离线运行。
3. 缺乏力觉感知与底层控制的确定性。通用大模型主要通过二维图像推断三维空间,擅长输出宏观指令或末端位置坐标,但丢失了接触瞬间的力觉信号。因此在“积木入碗”这种粗放任务中表现好,一旦遇到把“拼图插进凹槽”或柔性装配这些需要精细力控的场景,成功率便大幅下滑。
同时,底层的关节电机信号噪声很大,而且运动学逆解本有精确的数学公式。在已经有确定性公式的底层引入随机性神经网络黑箱,不仅消耗算力,还容易引发失控。
二、架构收敛和对产业的影响
通用大模型长于规划而短于高频控制,专用VLA模型与世界模型又各有优劣,系统架构正向大脑+小脑+底层运控的分层协同收敛:
1. 上层慢系统(云端大脑):由通用大模型与世界模型组成。通用大模型负责指令拆解与监督;10B至40B以上的世界模型负责三维空间的反事实预演。例如桌面有障碍物遮挡时,基于模仿学习的VLA若同时学过左绕和右绕,容易将两条轨迹取平均值而撞上障碍物;世界模型能预判动作后果,选出绕行路径。
2. 中层快系统(端侧小脑):以轻量化端到端VLA加上封装好的基元技能库(类似游戏固定连招,如英伟达Aspire框架)为主。大脑只需每隔几步做一次类似抽帧的关键帧预测,中间动作由小脑通过插值拟合平滑补全。
3. 底层运控与硬件本体:保留传统物理控制算法与标准接口。硬件精度很大程度上决定了算法上限。在相同模型下,低精度机械臂每步产生的物理误差会在神经网络闭环反馈中逐级放大,导致长程任务失败;更换高精度机械臂后,算法表现往往会有跃升。此外,受限于电机发热与应力疲劳,当前机器人可靠执行的单次长程任务通常在30-60分钟以内,热力学与机械鲁棒性是硬性约束。
随着架构向分层靠拢,且OA等大厂开始基于通用基座提炼30B—50B的机器人专用小模型,产业链格局正在分化:
第一,纯算法与独立具身大脑初创公司。上半年具身智能一级市场融资超900亿,过半投向软件与模型公司。当通用大模型团队凭借万亿基座和算力向下兼容时,初创公司生存空间会被压缩。而且物理模型与传感器位置、自由度、动力学深度绑定,所以缺乏自有硬件和数据闭环的纯算法公司,很难靠单卖API做大规模。
第二,具备制造与成本优势的本体及硬件厂商。在大脑研发上保持克制、专注运动控制与降本的本体企业,通用大模型进步反而降低了它们软件补足的成本,未来可通过接入成熟底座快速切入操作场景。比如OA自研硬件重在补齐数据采集标准并瞄准家庭场景;另一些聚焦工业制造降本,产线设备与执行器、灵巧手、传感器的采购会率先兑现为订单。
三、数据是落地最大的卡点
算法架构清晰后,制约具身智能的最大瓶颈在数据上。语言模型所需的文本原本存在于互联网,而带有力觉、关节状态和碰撞因果的具身数据自然界并不存在,必须靠物理实体生成。
由于视频与力控信号信息密度低于文本,具身基座模型要涌现出决定性的泛化能力,至少需要100万小时以上高质量真机交互数据(含广义预训练样本则需千万至上亿小时)。目前全球真正包含本体状态与力觉标签的高质量真机数据仅60万至70万小时左右。
这接近两个数量级的缺口,让仅80名员工、零收入、但沉淀了约1万小时跨本体真机数据的Physical Intelligence近期拿到超110亿美元估值。
行业目前采用真机遥操作(约20%)+第一视角真人示范(约50%)+仿真合成(约30%)的混合路径:
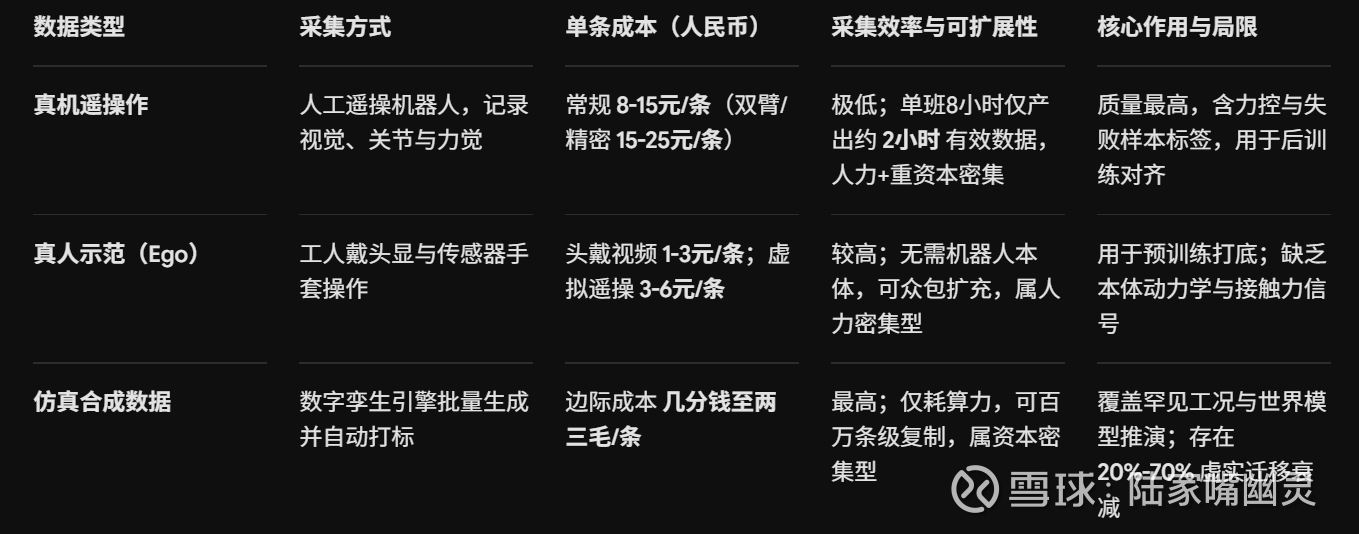
几个产业事实:
1. 劣质低价数据反而有害。报价1—2元/条的粗放数据缺乏校验与失败样本标注,喂入模型反而拉低准确率。实验显示,500小时多样化高质数据的泛化表现是2000小时同质数据的3倍(单小时效率差12倍),所以高质量真机数据价格会保持坚挺。
2. 数据平台与采集硬件。单靠本体厂自建团队难以覆盖海量垂类场景(数据清洗标注仍有约60%需人工处理)。这会拉动两类需求:一是采集设备中的传感器增量,例如如五指采集方案中惯性测量单元、3D视觉与MEMS触觉传感器等;二是提前布局真机采集场的第三方平台。
3. 工业场景的闭环优势。2025年国内工业机器人产量增长20%,占全球近60%。我们拥有最完整的制造门类,汽车、3C和物流车间是天然的最佳采集场。谁先送机器人进产线,谁就能通过现场运行—失败样本回流—微调转起来,而车间极高的替换成本会构筑稳固的粘性。
四、总结
通用大模型的跨界抬升了任务规划上限,加速行业向云端通用大脑/世界模型+端侧VLA小脑+底层确定性运控的分层架构收敛。这会挤压纯算法初创公司,但提高了精密本体硬件、传感器及真机数据平台的产业地位。
至于物理AI何时迈入业绩兑现,几个指标值得关注:
第一,真实工况的任务成功率与节拍:大模型+VLA在汽车、3C产线中,能否将操作成功率从50%左右提升至工业要求的90%以上,并将动作频率推向20Hz;
第二,连续运行时长与维护成本:执行器与灵巧手在散热和抗疲劳上的改进,单次可靠作业能否突破30—60分钟的物理上限;
第三,真机数据越过百万小时拐点:整机厂与数据平台的采集推进,以及海外大厂端侧硬件定型对国内企业的订单拉动。
还是总结一个链条:
通用大模型与世界模型突破高层规划——端侧VLA与高精度硬件解决实时控制——百万小时真机数据填补缺口——工业场景跑通回本周期并开启批量复购。
大模型给了机器人理解世界的大脑,而决定这颗大脑能否创造商业价值的,依然是传感器里的力控精度、产线上的真实数据,以及硬件成本回收的账本。
$宇树科技-W(SH688836)$ $英伟达(NVDA)$ $超威半导体(AMD)$
雪球是一个投资者的社交网络,聪明的投资者都在这里。
点击下载雪球手机客户端 http://xueqiu.com/xz]]>