Coffee Break Clojure, Vol.3
上一篇 我们讨论了不同类型的形式,了解了函数、Lambda、宏和特殊形式的皮毛,也学会了用一些基本的运算符、let 和 if 等等。今天的文章要讨论集合数据类型。不过在此之前,我们还是先看看普通的数据类型有哪些。
今天的文章有点长,所以读的时候,呃…… 准备一杯大号的咖啡?
你已经知道和你可能不知道的
和大部分编程语言一样,Clojure 支持数字、浮点数、字符串和布尔值。
由于 Clojure 是运行在 JVM 上的,所以这些数据类型都对应一个 Java 类。数字是 Long 不是 Int,前者能表示的最大数是 2 的 63 次方减 1,也就是有 64 位,第一位是符号位,后者是 32 位。
和 Java 一样,Clojure 没有无符号数(unsigned int)。
Clojure 还能在这些类型上调用 Java 的方法,比如 String.getBytes()。
(seq (.getBytes "Hello"))
;; => (72 101 108 108 111)
(type (first (seq (.getBytes "Hello"))))
;; => java.lang.Byte
Clojure 也没有用更小的 Float,而是用了双精度浮点数 Double。
(type 1.1)
;; => java.lang.Double
Clojure 是门动态类型语言,一般不需要考虑太多类型问题,不过知道这些类型底层是什么样的也挺好。
值得注意的是 Clojure 还有个很常用的自定义类型,叫作关键词(keyword)。
(type :keyword)
;; => clojure.lang.Keyword
关键词类似字符串,不过是以 : 开头,中间不能有空格。其实他更像其他语言里的枚举类型(enums),但无需提前定义。关键词不能像字符串一样做裁剪、找子串、当作字符数组遍历之类的操作,就是一个整体。
必要的时候,可以用 name 函数将它转换为字符串。
(name :keyword)
;; => "keyword"
关键词可以用在大部分需要枚举的场合,也用来表示映射里的键(key)。
其他的非集合类型还有我们上一篇讨论过的符号(Symbol)。
集合数据类型与序列类型
集合数据类型统称 Collections,一般缩写做 coll,你会在 Clojure 的文档和各种函数里见到这个缩写。要判断一个数据是否是集合,可以用谓词函数 coll?:
(coll? 1) ;; => false
(coll? "string") ;; => false

(coll? '(1 2 3)) ;; => true
(coll? [1 2 3]) ;; => true
(coll? {:key "value"}) ;; => true
(coll? #{1 2 3}) ;; => true

;; 当然,代码即数据
(coll? '(println "Hello World")) ;; => true
你之后还会见到很多 ? 结尾的谓词函数。谓词函数(predicate)是指返回布尔值的函数,在编写自己的函数时,最好也按照这种规则命名。这就像…… Java 的 IsXXX() 方法一样。
上面见到的四种有不同括号标记的集合数据类型就是今天的主角。在正式介绍他们之前,我还想讲讲序列(sequence)。序列和集合分别对应两个 Java 接口:ISeq 和 IPersistentCollection。下面是 ISeq 的定义:
public interface ISeq extends IPersistentCollection {
 Object first();
 ISeq next();
 ISeq more();
 ISeq cons(Object o);
}
ISeq 继承了 IPersistentCollection,可以理解为:序列是集合的子集。可以看到这个接口里的访问方法只有 first()、next() 和 more(),也就是说序列只支持线性访问,不能随机访问,也就是没有索引(index)和键(key)。
可以用 seq? 判断一个集合数据是不是序列。
(seq? '(1 2 3)) ;; => true
(seq? [1 2 3]) ;; => false
(seq? {:key "value"}) ;; => false
(seq? #{1 2 3}) ;; => false
只有列表是序列,不过其他数据类型都能转换为序列。
;; 没有 ? 的 seq 用于把集合转换为序列
(seq [1 2 3]) ;; => (1 2 3)
(seq {:key "value"}) ;; => ([:key "value"])
(seq #{1 2 3}) ;; => (1 3 2)
;; 字符串可以变成字符序列
(seq "hello") ;; => (\h \e \l \l \o)
只有序列才能够遍历,Clojure 中许多集合相关的操作都会自动把集合数据转换为序列。注意看,映射被转换为序列后,每个元素都是一个包含键和值的向量,所以之后我们遍历映射的时候,其实是在遍历向量序列。
序列并不是具体的数据类型,集合(collection)也不是,它们是对列表、向量、映射、集(set)以及惰性序列(lazy seq)的抽象。只不过许多操作都基于抽象的类型进行,这样很多函数就能通用。
圆括号和列表
我们在之前就见过列表(list),最普通的集合数据类型。
(list "string" 1 :item true)
;; or
'("string" 1 :item true)
和许多动态类型语言一样,列表可以包含不同类型的数据。
注意,上面这个例子中两种创建列表的方式有区别,我在 第零篇 留了个习题,现在公布答案:
(list 1 (+ 1 1) 3)
;; => (1 2 3)
'(1 (+ 1 1) 3)
;; 猜猜这段代码会得到什么结果?
;; (1 (+ 1 1) 3)
quote 会「冻结」列表内的一切,嵌套的形式也不会被求值。我们在上一篇讲到,调用函数前需要把所有参数都求值。list 就是个函数,(+ 1 1) 求值得到 2 才会被传入 list。
在更「原教旨」的 Lisp 中,list 是 cons 的一种简便写法。cons 的意思是 construct,被称作「列表构造函数」。一个 cons 只能造一个有序对,(cons 1 2) 会返回 (1 . 2),中间的点标记表示这是个 cons 对(叫 cons pair 或者 cons cell)。
cons 构造列表的方式有点像个链表,cons 左边存放的是列表的一个元素,右边存放的是下一个 cons 对,如果列表结束了,右边存的就是 NIL。
(cons 42 (cons 69 (cons 613 nil)))
;; 等价于
(list 42 69 613)
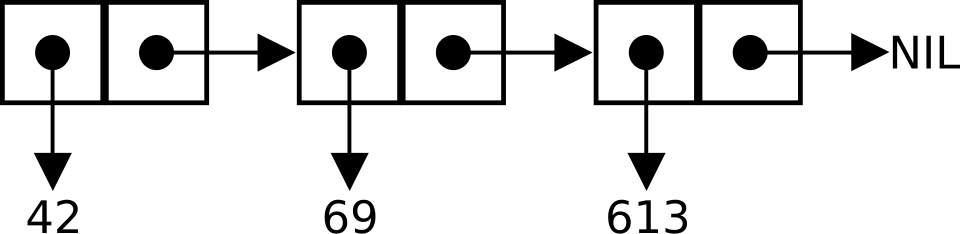
虽然 Clojure 的 cons 也可以用相同的方式构造列表,但 cons 对却不存在。cons 的第二个函数只能是序列或者 nil。
(cons 1 2)
;; Execution error (IllegalArgumentException) at user/eval30 (REPL:1).
;; Don't know how to create ISeq from: java.lang.Long
可以说 Clojure 弱化了 cons 作为列表构造函数的身份,cons 只被用来「把数据放进列表的前面」。
(cons 1 '(2 3))
;; => (1 2 3)
Clojure 的列表叫作持久化列表(PersistentList),Clojure 的所有集合数据类型都是持久化(Persistent)且不可变(Immutable)的。
(type '(1))
;; => clojure.lang.PersistentList
不可变很好理解,对数据做操作只会产生新的数据,而不会修改原来的数据,原来的数据还保存在内存的同一个地方。那什么是 持久化 呢?意思是数据被修改后,历史的版本还保留着并且还能被访问。
不妨看看 Clojure 是怎么实现 PersistentList 的:
public class PersistentList extends ASeq implements IPersistentList, IReduce, List, Counted {

private final Object _first;
private final IPersistentList _rest;
private final int _count;
注意看 _first 和 _rest 这两个私有变量。_first 的类型是 Object,在 Java 中,这是所有类的基类,作用类似于 Go 的 any,任何类型传入都能通过类型检查。_rest 的类型是 IPersistentList,这是持久化列表的接口,PersistentList 就实现了这个接口。
不难看出这和 cons 非常类似:_first 存的是列表节点的值,_rest 存的是下一个值的「指针」。在原教旨 Lisp 里,_first 和 _rest 分别对应 car 和 cdr(读作 coulder)。
我们来看看 PersistentList 是怎么实现 add() 的:
public void add(int index, Object element){
 throw new UnsupportedOperationException();
}
嗯?直接抛出异常了?
令人费解,而且违反了里氏替换原则。仔细想想,Clojure 的确没有给列表直接添加元素的方法,因为列表不可变,我们用的是 cons 和 conj(后者与 cons 相反,是在序列的尾部添加元素)。那 cons 是怎么实现的?
public Cons(Object first, ISeq _more){
	this._first = first;
	this._more = _more;
}
这下就清晰了,求值 (cons 1 '(2 3)) 得到 (1 2 3),原来的 (2 3) 留在原地,我们只是创建了一个 Cons 存放 1,指向 (2 3) 这个序列,而 Cons 本身也是个序列,可以再用它创建新的 Cons,新的 Cons 也会就会指向它。
这种构造持久化列表的方式叫作结构共享(Structural Sharing),既做到了不可变,又没有在内存中管理大量的数据副本。本质上,一切都是指针。
由于不可变,所以列表的大小可以作为不变的属性保存起来,回去看 PersistentList 的 Java 代码,_first 和 _rest 下面就是 _count。Clojure 的所有集合数据类型都能用 count 函数获取其长度,并且这个算法的时间复杂度是 O(1),因为只需要 return _count。此外,有很多操作都因为结构共享变得非常高效,Clojure 的性能在 Lisp 中算很好的那一类。
至于不可变还有什么好处,我们之后谈函数式编程再提。
方括号和向量
理解一门 Lisp 中的列表如何构造,可以说就理解了它的核心。我们知道列表是持久化且不可变的,由 Cons 和指向其他 Cons 的「指针」构成。
向量基本上和列表一致,但向量中所有元素都有索引(index),这点和 JavaScript 的数组很像,写起来也和 JavaScript 数组很像,也可以存放不同类型的数据。
[1 "I'm a vector" :vector true]
向量和列表最大的不同点在于,可以用索引访问向量的元素,但列表没有索引。
(get [1 2 3 4] 2) ;; => 3
(get '(1 2 3 4) 2) ;; => nil
向量和列表的另一个区别,尽管他们都是连续的(sequential),但只有列表是序列(sequence)。用 seq? 检查数据是不是序列的时候,向量会返回 false。
(seq? '(1 2)) ;; => true
(seq? [1 2]) ;;=> false
如果希望向量也返回 true,就要检查一个集合有没有实现 Sequential 接口。
(sequential? '(1 2)) ;; => true
(sequential? [1 2]) ;; => true
有意思的是,把 seq? 的问号去掉,你也能让向量返回一个真值。
(if (seq [1 2])
 "I can be a seq"
 "I can not be a seq")
;; => "I can be a seq"
seq 的作用是把可以转换为序列的数据结构转换为序列,集合只要不是空的,都会返回一个正常的序列,会被条件判断当作真值。因此 seq 经常被用来检查一个集合是否不为空;相反,emtpy? 用来检查一个集合是否为空。
要注意的是,如果对向量做了序列操作,比如用 rest 函数获取向量的第一个元素之后的所有元素,就会得到一个序列,向量的索引就不可用了:
(rest [1 2 3])
;; => (2 3)
(get (rest [1 2 3]) 1)
;; => nil
可以用 vec 把序列变成向量
(get (vec (rest [1 2 3])) 1)
;; => 3
可以用 vector? 检查数据是不是向量。
(vector? [1 2 3])
;; => true
(vector? (seq [1 2 3]))
;; => false
最后,向量其实还继承了 AFn 类,可以当成函数使用。
([1 2 3] 0) ;; => 1
;; 等价于:
(get [1 2 3] 0) ;; => 1
这样就省掉了写 get 的工夫。
花括号和映射
Clojure 的映射(map)写起来和 JSON 很像。
{:key1 "val1"
 :key2 {:subkey1 2
 :subkey2 [1 2 3]}
 :key3 nil}
映射和向量也很像,映射不过是可以自定义索引的向量。向量只能用从 0 开始自增的整数索引,但映射可以自定义键。键一般是关键词类型,但也可以是别的类型,比如这是 HTTP 响应头的映射表示:
{"Content-Type" "text/html; charset=utf-8"
 "Cache-Control" "no-cache"
 "Date" "Sat, 26 Sep 2026 07:06:35 GMT"}
一般而言,推荐使用关键词表示键,一方面是看起来更清晰,另一方面是,关键词和向量一样,可以当作函数使用,从映射里取出值:
(:key1 {:key1 "val1"})
;; => "val1"

;; 等价于
(get {:key1 "val1"} :key1)
;; => "val1"
其他类型却不行:
(let [data {"Content-Type" "text/html; charset=utf-8"
 "Cache-Control" "no-cache"
 "Date" "Sat, 26 Sep 2026 07:06:35 GMT"}]
 ("Content-Type" data))
;; Execution error (ClassCastException) at user/eval194 (REPL:4).
;; class java.lang.String cannot be cast to class clojure.lang.IFn (java.lang.String is in module java.base of loader 'bootstrap'; clojure.lang.IFn is in unnamed module of loader 'app')

;; 只能写作:
(get data "Content-Type")
可以引入 clojure.walk 标准库,用这个库里的 keywordize-keys 方法,把不是关键词类型的键全部转换为关键词。
(require '[clojure.walk :as walk])
(walk/keywordize-keys {"Content-Type" "text/html; charset=utf-8"
 "Cache-Control" "no-cache"
 "Date" "Sat, 26 Sep 2026 07:06:35 GMT"})
;;=> {:Content-Type "text/html; charset=utf-8",
;; :Cache-Control "no-cache",
;; :Date "Sat, 26 Sep 2026 07:06:35 GMT"}
其实把关键词和映射反过来也能达到一样的效果,因为映射和向量一样,也继承了 AFn 类,可以当作函数用。
({:key1 1 :key2 2} :key2)
;; => 2
(:key2 {:key1 1 :key2 2})
;; => 2
由于映射可以嵌套,你可能会遇到需要获取一连串键值对的情况,这时候就用 get-in。比方说,我们可能要处理结构非常反人类的 microformats 。
{:webmention {:source "https://alice.blog"
 :target "https://bob.net"
 :microformats [{:type ["h-card"]
 :properties {:photo [{:alt "Photo of Alice"
 :value "https://alice.blog/photo.avif"}]
 :name "alice"
 :url "https://alice.blog"}}]}}
(get-in data [:webmention :microformats 0 :properties :photo 0 :value])
;; => "https://alice.blog/photo.avif"
和其他集合类型一样,映射不需要写逗号分隔元素,但写了也不会报错。如果你觉得这样更清晰,可以在每个键值对后面写上逗号。不过无论有没有逗号,奇数个元素都是键,偶数个元素都是值。如果映射里的元素没有成对,就会报错。
{:key nil :key2}
;; Syntax error reading source at (REPL:51:17).
;; Map literal must contain an even number of forms
键也不能重复:
{:key nil :key nil}
;; Syntax error reading source at (REPL:52:20).
;; Duplicate key: :key
试图用 cons 或 conj 把一个键值对放进映射里,就算键重复也不会报错,因为 cons 返回的是个序列,并非映射。
(cons [:key1 nil] {:key1 nil})
;; => ([:key1 nil] [:key1 nil])
要往映射里添加键值对,或者覆盖某个键的值,要用 assoc(associate)。
(assoc {:key1 nil} :key2 nil)
;; => {:key1 nil, :key2 nil}

(assoc {:key1 nil} :key1 1)
;; => {:key1 1}
如果要移除某个映射,就用 dissoc(dissociate)。
(dissoc {:key1 nil} :key1)
;; => {}
井号和集
在 {} 前面加上 #,就会得到集(set)。Set 其实应该叫集合,但我担心和 Collections 混淆,所以称作「集」。顾名思义,集就是不能有重复数据的集合。
#{1 1 2 3}
;; Syntax error reading source at (REPL:61:11).
;; Duplicate key: 1
注意看,这里的报错是 Duplicate key(重复的键)。实际上,集就是把键和值合二为一的映射,不妨试试用关键词作为函数,取出集合里的关键词。
(:key1 #{:key1 :key2 :key3})
;; => :key1
向量和列表都不能这么干,因为向量的键是整数,而列表没有键。
(:key1 [:key1 :key2])
;; => nil
(:key1 '(:key1 :key2))
;; => nil
向量和映射都可以作为函数,集合也可以。
(#{1 2 3} 2)
;; => 2
(#{1 2 3} 100)
;; => nil
如果参数存在于集合中,就会返回集合中的这个元素;如果不存在,就会返回 nil。由于 nil 是假值,所以可以用这种方式判断某个元素是否存在于集合中。
(let [allowed-domains #{"kagi.com" "duckduckgo.com"}]
 (if (allowed-domains "google.com")
 "Domain allowed"
 "Domain not allowed"))
;; => "Domain not allowed"
检查集合
我们已经知道,可以用 seq 检查集合是否非空,用 empty? 检查集合是否为空;可以用 seq?、vector?、list?、sequential?、map? 和 set? 检查数据是否为序列、向量、列表、连续的、映射或集合。
除了对集合数据本身做检查,我们可能还想要对集合里面的元素做检查。
用 every? 检查集合里的每个元素是否都满足条件。
(every? even? [2 4 6])
;; => true
(every? odd? [1 2 4])
;; => false
every? 接收两个参数,第一个参数 pred 是直接接收一个变量的谓词函数,第二个参数 coll 是要检查的集合。这个函数对每个元素求值一次 (pred element),只要有一个是 false,就返回 false,否则返回 true。
even? 和 odd? 分别检查数字是否为奇数和是否为偶数。
第二个参数可以是匿名函数 fn:
(every? (fn [x] (= x 1)) [1 1 1])
;; => true
匿名函数可以简写为 #(),用 % 表示参数:
(every? #(= % 1) [1 1 1])
;; => true
如果不要求所有元素,只要求某一些元素符合要求,就用 some。
(some #(= % 1) [1 2 3])
;; => true
(some #(= % 1) [2 3 4])
;; => false
为什么 some 没有 ? 呢?那是因为 some? 是另一个函数,用来判断某个值是否不是 nil。
(some? 0)
;; => true
(some? [1 2 3])
;; => true
(some? nil)
;; => false
用来判断某个值是 nil 的函数是 nil?,其实 some? 就是 (not (nil? x)), 源代码 就是这么写的。
有点绕,对吧?还有更绕的。
Clojure 新手常见的问题是搞不清楚 contains? 的作用。一般人会下意识地以为这个函数用来检查集合是否包含某个元素,但很快发现并非如此。
(contains? [5 7 8] 5)
;; => false
(contains? [5 7 8] 0)
;; => true
contains? 用于检查集合中是否包含某个键(key)。我们知道向量就是键为自增整数的映射,[5 7 8] 中各个元素的键或者说索引分别是 0 1 2,所以用 contains? 查找 5 会返回 false,但查找 0 会返回 true。
contains? 可以用来测试映射中是否包含某个键,集是否包含某个元素:
(contains? {:key1 "value"} :key1)
;; => true
(contains? #{1 4 2} 4)
;; => true
如果要检查列表和向量中是否包含某个值(而非键),应该用什么呢?其实你已经会了。仔细想想,用上面提到过的哪些函数可以做到这点?
答案揭晓
如果你的答案是:
(some #(= % :want) [:some :element :here])
;; => false
(some #(= % :want) [:i :want :to :learn :clojure])
;; => true
恭喜你对了一半!更 Idiomatic 的写法是:
(some #{:want} [:some :element :here])
;; => nil
(some #{:want} [:i :want :to :learn :clojure])
;; => :want
还记得吗?集也可以当作函数用。
操作集合
如果你第一时间想到的是用 for 循环遍历和操作集合,那你可得好好反思一下。别担心,我刚开始也一直试图弄懂怎么在 Clojure 里写循环结构(也就是 for、while、do ... while),后来发现,我根本不需要。至少在我目前写 Clojure 的一百多个小时里,我一次也没有用过 for 和 while。
filter 和 remove
假设我们有这样一个列表。
(def numbers
 '(1 43 231 64 23 99))
我希望删除里面的偶数,我该怎么办?这样吗?
;; (take n coll) 返回由 coll 前 n 个元素组成的序列
;; (drop n coll) 返回丢弃 coll 前 n 个元素后的序列
;; (concat coll coll) 把两个集合拼接起来
;; (inc n) 相当于 (+ 1 n)
(for [n numbers]
 (if (even? n)
 (let [i (.indexOf numbers n)]
 (concat (take i numbers) (drop (inc i) numbers)))
 numbers))
;; => ((1 43 231 64 23 99)
;; (1 43 231 64 23 99)
;; (1 43 231 64 23 99)
;; (1 43 231 23 99)
;; (1 43 231 64 23 99)
;; (1 43 231 64 23 99))
欸?不对,Clojure 数据是不可变的,我只是返回了很多个新的列表,其中有一些是去除了一个偶数的。照理来说,我应该声明一个空列表,然后把不是偶数的元素放进去…… 欸?Clojure 的赋值语句是什么?嗯?Clojure 是函数式语言,那是什么意思?啊?没有赋值语句,绑定了符号就不能改了?
我的朋友,你的问题,只需要一行代码解决:
(remove even? numbers)
;; => (1 43 231 23 99)
或者这样:
(filter odd? numbers)
;; => (1 43 231 23 99)
和刚才的 every? 和 some 一样,remove 和 filter 接收一个谓词函数和一个集合,分别用来移除符合条件的元素,或保留符合条件的元素。
reduce
现在我又有新的需求了,我要把这些数字累加起来,应该怎么做?
(reduce + numbers)
;; => 461
reduce 接收函数 f 和集合 coll,其中 f 应该要能接收两个参数。它先对前两个元素求值 (f x y),然后对下一个元素求值 (f (f x y) z),以此类推。这里我们用的是 +,所以就实现了累加。
还可以传入初始值,这样 reduce 就不会从 (f x y) 开始求值了。我们能用它来拼接集合。
(reduce conj [1 2] [3 4])
;; => [1 2 3 4]

;; 直接用 conj 的话,第二个参数会被当作一整个元素放进去
(conj [1 2] [3 4])
;; => [1 2 [3 4]]
(reduce conj a b) 的简便写法是 into:
(into [1 2] [3 4])
;; => [1 2 3 4]

;; concat 也能拼接集合,但返回的是序列
(concat [1 2] [3 4])
;; => (1 2 3 4)

;; 操作向量时,最好用 into
练习一下,如果要把下面这个向量打平(flatten)然后去重,应该怎么做?
(def flatten-me
 [[1 2] [53 13 5] [2] [12 53 55]])
答案揭晓
(reduce into [] flatten-me)
;; => [1 2 53 13 5 2 12 53 55]
去重只需要把向量变成集合,然后再变回来。
(vec (set (reduce into [] flatten-me)))
;; => [1 55 13 12 2 5 53]
map
如果我想要把列表里的数字全部翻倍,应该怎么做?
map 函数接收一个函数 f 和一个集合 coll,把 f 作用在每个元素上之后,返回新的集合。
(map #(* % 2) numbers)
;; => (2 86 462 128 46 198)
要注意的是,map 返回的是个序列(准确来说是惰性序列,后面再讲)。如果想要返回向量,就换成 mapv。
(map #(* % 2) (vec numbers))
;; => (2 86 462 128 46 198)
(mapv #(* % 2) (vec numbers))
;; => [2 86 462 128 46 198]
箭头宏
单用上面这些函数中的任何一个是无法实现复杂需求的。假设我想要把列表中的偶数删掉,然后对剩下的奇数求平方,最后过滤掉超过 1000 的数,再累加起来。你可能就能感受到什么是 Lost In Stupid Parentheses 了:
(reduce + (filter #(<= % 1000) (map #(* % %) (remove even? numbers))))
;; => 530
可以发现这些函数全都是类似的形式:(func f coll)。函数放在中间,集合放在最后面。有一个宏,可以自动把他的参数嵌套在一起,把上一个参数放进下一个参数的末尾。
(->> numbers
 (remove even?)
 (map #(* % %))
 (filter #(<= % 1000))
 (reduce +))
;; => 530
->> 叫作 thread-last,似乎也有翻译成「线程宏」的,但 thread 只是把层层嵌套的函数调用比喻成一条线而已,或许可以叫「线宏」,但我更喜欢叫它「箭头宏」。
thread-last 是说,把上一个函数形式放进下一个函数形式的最后一个参数的位置。自然还有 thread-first,写作 ->。如果要传递和操作的数据都在第一个参数的位置,或者这条线上的函数都只接收一个参数,就可以用 ->。
学会使用箭头宏,在 Clojure 里你经常需要把数据在函数之间传来传去,它能帮你少写很多括号,而且代码会更简单易读。
最后
我已经写了五千多字,还没写到惰性。我也犯懒了,读者如果着急,可以先阅读我今年年初写的《 计算无穷 》来了解惰性是什么。
另外,最近有不少读者表达了对这个系列的喜爱,很高兴看到有人对 Clojure 感兴趣!希望我突然写这么长一篇文章没有把你们吓到。没掌握也没关系,可以随时会来查阅。之后需要用到集合的地方很多,有很多机会练习。
回见!
- 可参考:《 Just A Common Lisper 》

 点赞
 收藏
 点踩
 分享