
AI Infra Summit:NVIDIA Vera Rubin 与 DSX 平台展示 AI 工厂"每瓦 Tokens"能效优化


英伟达超大规模与高性能计算业务副总裁伊恩·巴克于周二在AI基础设施峰会上发表了关于AI工厂效率的演讲。该峰会是圣克拉拉会议中心举办的一项活动,如今已演变为一场基础设施技术领域的“科切拉音乐节”。
在座无虚席的会场上——今年参会人数超过8,000人,较去年的3,500人大幅增长——巴克介绍了英伟达各平台之间的全新合作及其他内容。
- 亚马逊旗下的安纳普尔纳实验室正与英伟达合作开发NVHBM定制高带宽内存技术。
- d-Matrix正在与NVLink Fusion集成,将英伟达Vera CPU与d-Matrix Raptor XPU相结合,以实现大规模、超低延迟的推理能力。
英伟达及其合作伙伴还发布了多项新成果:
- Emerald AI与英伟达联合展示了面向商用的AI工厂柔性负载项目,并与硅谷电力公司开展合作。
- Lambda借助英伟达DSX MaxLPS,将每瓦性能提升了23%。
- Pinterest正利用英伟达Blackwell平台及Dynamo推理软件,为视觉发现引入对话式AI。
这些消息发布之际,代理式AI正催生一类新的工作负载,对AI基础设施提出了更高的性能、效率与规模要求。
英伟达通过全栈式AI工厂平台应对这一挑战,该平台涵盖Vera Rubin系统、Dynamo推理软件、NeMo库以及英伟达网络产品——包括用于纵向扩展计算的NVIDIA NVLink、用于连接数千个节点的Spectrum-X以太网与ConnectX SuperNIC,以及由BlueField驱动的上下文感知存储和用于基础设施安全的BlueField DPU。
当前,衡量AI基础设施的标准正从峰值性能快速转向每兆瓦可验证的代理式令牌产出量。如今,AI工厂必须从芯片到电网进行协同设计。
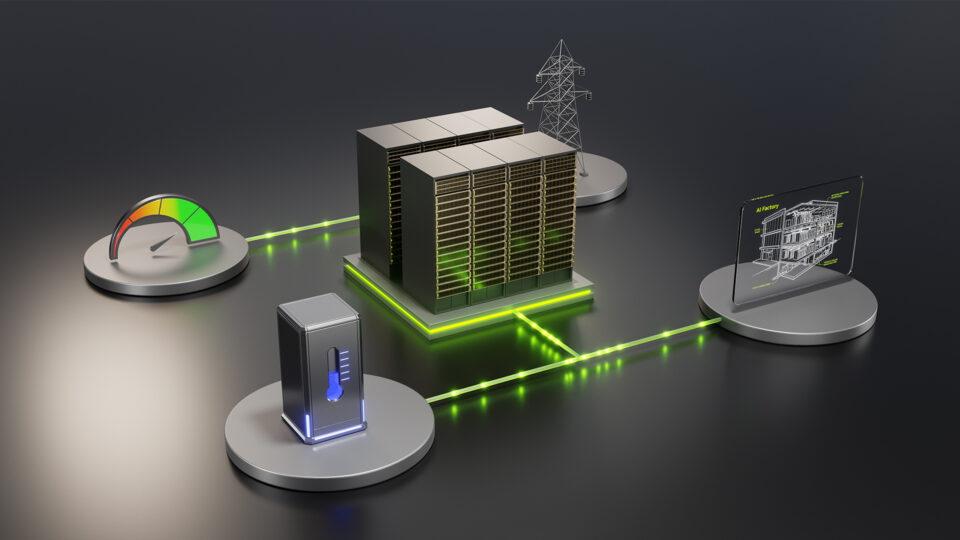
英伟达DSX MaxLPS可通过全厂级电源优化,使每兆瓦令牌产出提升多达1.4倍;而NVLink则有助于将大规模加速计算整合为单一高性能系统。
由此打造的AI基础设施旨在产生更多令牌、提升能效,并帮助客户从每一兆瓦电力中获取更大价值。
9月15日星期二,太平洋时间上午9:55
AI工厂柔性负载项目释放更多电网容量
硅谷电力公司运营着一项柔性负载互联计划,使AI工厂能够支持电网灵活性。
借助该计划,Emerald AI与英伟达合作,在硅谷电力公司实现了自动负荷削减的演示。该系统成功响应了来自硅谷电力公司的数百次需求信号,同时保障了AI工作负载的性能。
英伟达合作伙伴Emerald AI计划在其Conductor电网响应型电源管理软件中使用NVIDIA DSX Flex,该软件可根据实时电网信号及混合能源动态调整AI工厂的能耗。
借助DSX Flex实现自主负载均衡,Emerald AI能够展示其自动降低低优先级AI任务功率并随后恢复至正常水平的能力。
DSX Flex可接收电网信号——如减载请求、需求响应事件及电价信号——并在预定义的工作负载层级内自动作出响应。最关键的任务持续运行,其余任务则暂时暂停并随后恢复。
借此,数据中心可参与电网的能效管理。
这一能力使AI工厂能够作为灵活的电网资源运行:在电网需要缓解压力时降低用电需求,同时保障优先级AI工作负载,并证明可控的AI负载有助于释放更多电网容量以支持增长。
了解更多关于Emerald AI与硅谷电力公司的合作。
9月15日星期二,太平洋时间上午9:55
Lambda借助NVIDIA DSX MaxLPS最大化每瓦性能
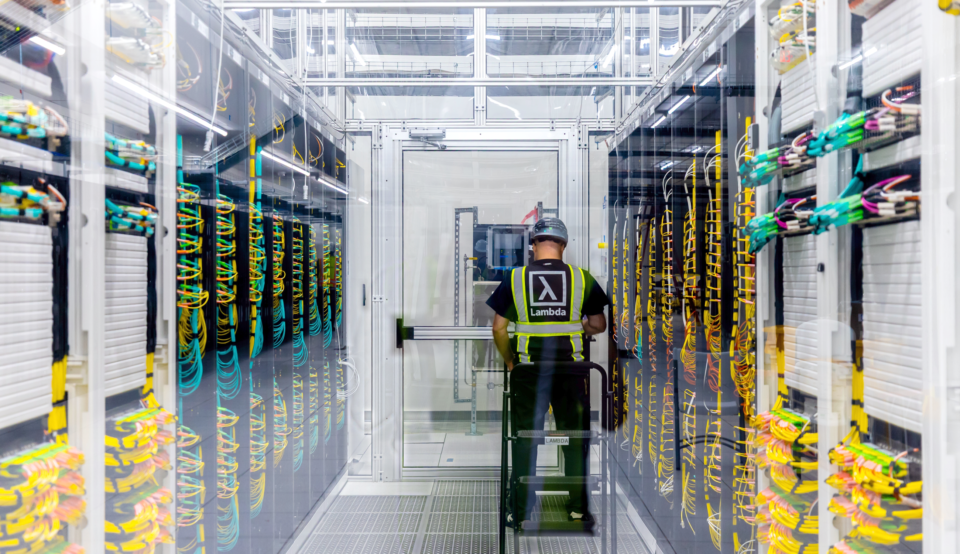
AI云服务提供商Lambda在AI基础设施峰会上公布了测试结果,首次验证了NVIDIA DSX MaxLPS在英伟达Blackwell服务器上的应用效果。
DSX MaxLPS持续监测GPU与机架的功耗,根据需求动态调配可用电力,并回收静态配置下被闲置的容量。由于训练与推理工作负载的功耗特征不同,MaxLPS可在混合负载的AI工厂中优化电力分配。
测试结果显著:Lambda在原仅够16台满功率节点使用的电力预算内运行了19个节点,使集群整体令牌吞吐量提升了24%——从约400万提升至500万令牌/秒——同时将每瓦性能提高了23%。
对于下一代英伟达Vera Rubin NVL72 AI工厂,在合适的部署环境下,DSX MaxLPS可在相同的兆瓦预算内释放多达40%的额外GPU算力。
这意味着AI工厂运营商可以在既定的电力约束内提升AI算力与令牌产出,从而最大化每一兆瓦的生产效率与经济价值。
了解更多关于Lambda的测试结果。
9月15日星期二,太平洋时间上午9:55
Vera Rubin与Groq 3 LPX将更多电力转化为令牌
在AI工厂中,电力是最关键的约束。每一瓦都至关重要,因此如何从每一兆瓦电力中榨出更多令牌,成为AI基础设施的核心目标。
英伟达通过基于Vera Rubin NVL72的全栈式AI工厂来实现这一目标:系统、网络、软件与电源管理协同运作。在工厂层面,NVIDIA DSX MaxLPS会随负载波动动态调配各机架的供电。
收益十分显著:
- 在相同的场地功率预算内,GPU 数量最多可增加 40%
- 每秒处理的 token 数量最多可提高 35%——无需新增供电线路
在每个机柜内部,智能功率平滑软件与扩展的能量缓冲能够吸收短时峰值,使系统运行更贴近持续负载需求。原本闲置的容量得以转化为有效的计算能力。
对于代理式 AI——即由多个推理步骤和工具调用串联而成的场景——延迟与上下文长度会迅速叠加。此时,NVIDIA Groq 3 LPX 就派上了用场,为 Vera Rubin 平台增添了确定性的超低延迟推理能力,并与 DSX MaxLPS 形成互补。
这一组合平台在长上下文条件下,针对超过 2 万亿参数的模型,每兆瓦的 token 处理吞吐量最高可比 GB200 NVL72 提升 35 倍。
数据足以说明一切。在 10 万上下文长度的 Qwen 3.8 27B 工作负载下,Groq 3 LPX 每位用户每秒可生成 2,529 个输出 token。这种性能余量使得代理能够在相同的响应时间预算内执行更多的推理步骤和工具调用,即便工作负载规模不断扩大亦然。
了解更多关于 NVIDIA Vera Rubin NVL72 和 Groq 3 LPX 如何以更少的功耗产出更多 token 的信息。
太平洋时间 9 月 15 日 星期二 上午 9:55
Vera Rubin NVL72 在 SemiAnalysis AgentX 上实现 30 倍的 AI 工厂吞吐量提升
SemiAnalysis AgentX 通过记录真实的代理式编程会话来衡量推理性能,完整保留了实际的上下文增长、工具调用延迟以及子代理的创建过程,而非仅基于单次请求的基准测试。
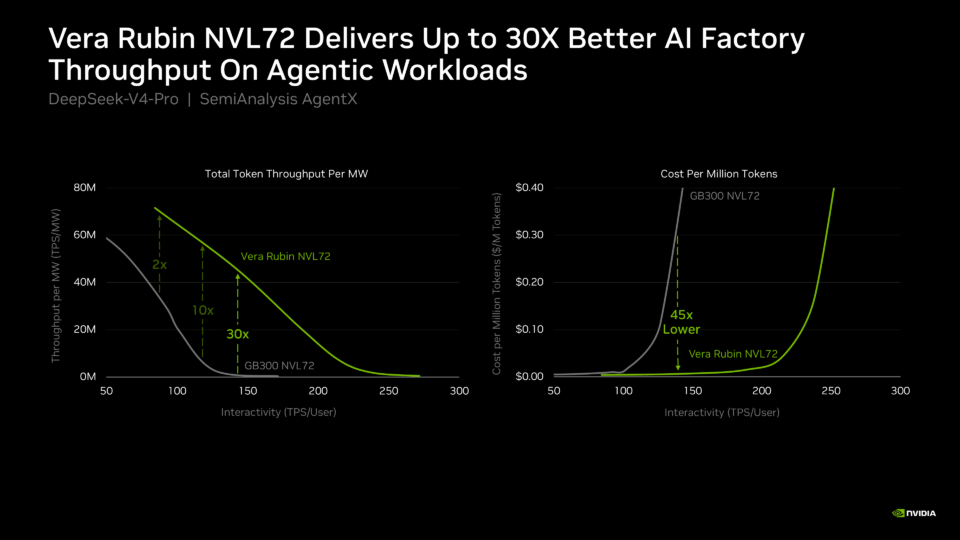
NVIDIA Vera Rubin NVL72 的代理式性能结果现已在 SemiAnalysis AgentX 仪表板 上公布。在 DeepSeek V4 Pro 模型上,Vera Rubin NVL72 的每兆瓦吞吐量最高可达 NVIDIA GB300 NVL72 的 30 倍。
代理式工作负载的特征与传统推理基准所衡量的请求-响应任务截然不同。一次会话中,随着代理的推理、工具调用及子代理的创建,输入 token 数量可能累积至数十万,约为普通聊天请求的 15 倍;且各请求的输入与输出长度差异极大。
要端到端地捕捉这些特性,必须采用围绕完整代理轨迹设计的基准测试。AgentX 正是为此而生,它与 MLPerf Inference 等标准化套件互为补充,后者侧重于在广泛的模型与场景下测量单次请求的性能。
效率的提升直接转化为 AI 工厂的经济效益。每兆瓦吞吐量提高 30 倍,意味着在相同的能耗基础上可完成多达 30 倍的代理式工作;AgentX 结果显示,每百万 token 的成本可降低高达 45 倍。
在电力受限的部署环境中,每兆瓦的吞吐量决定了 AI 工厂的营收上限,而每百万 token 的成本则决定了其利润率。
这一性能得益于深度协同设计,包括 NVL72 规模扩展域、第六代 NVLink 互联技术、第五代 Tensor Core 上的 NVFP4 精度,以及涵盖 NVIDIA TensorRT LLM 和 NVIDIA Dynamo 的推理栈。
Vera Rubin 已全面投产并在整个生态系统中加速规模化部署,随着软件优化的持续推进,性能还将不断提升。
了解更多这些结果背后的平台架构。
太平洋时间 9 月 15 日 星期二 上午 9:55
初创企业庆祝搭载 NVIDIA Vera CPU 的性能成果
初创企业正在测试 NVIDIA Vera CPU 在运行代理式工作负载及其他高要求应用方面的表现,并对取得的成果表示欣喜。
Perplexity 为旗下新的 SPACE 安全沙箱平台进行了 Vera CPU 的基准测试,结果显示沙箱启动速度提升了 1.9 倍。
Daytona 对 Vera CPU 进行了代理式工作负载的测试,指出“在代理式执行方面取得了显著进展”。
ClickHouse 公布了 Vera CPU 在 ClickBench(其面向分析型数据库的开源基准测试)上的测试结果。Vera 是团队迄今测得最快的机器。
ClickHouse 表示,这“强烈预示着面向数据密集型工作负载的 CPU 性能将迎来重大突破”。
DeepInfra 在 Vera CPU 上运行了一系列基准测试,结果显示其在各项指标上均胜出,其中编排步骤的延迟更是快了 2.2 倍。
Prime Intellect 发现,随着更多工作负载并行运行,Vera CPU 能够保持高带宽与低且稳定的内存延迟——这正是代理式 AI 所需的可预测性能。
Redpanda 表示,其对 Vera CPU 的基准测试显示,该 CPU 的延迟比其他 CPU 低 5.5 倍,吞吐量高出 73%。
Starburst 公布了基准测试结果,表明 Vera CPU 的查询吞吐量是其他 CPU 的 3 倍。
Kinetica发现,与传统 CPU 相比,Vera CPU 的分析型查询性能快了 2.7 倍。22
NVIDIA NVLink 6 助力 AI 工厂维持大规模稳定运行
随着AI工厂规模扩大到数十万GPU的规模,可靠性成为性能特征。
训练和推理工作负载依赖于连续运行,使得瞬态错误、信号衰减和硬件故障成为不可避免的挑战。NVIDIA NVLink 6 通过多层弹性架构解决了这些挑战,旨在在故障影响应用之前检测、控制和恢复。
在物理层,定制的前向纠错、物理层重试和通用物理层恢复有助于以最小的延迟影响维持无损结构。在网络层,基于信用的流量控制、动态路由和链路重新平衡在本地控制故障,防止级联停滞,从而降低AI工厂吞吐量。
了解更多关于NVIDIA NVLink 6。