
从兆瓦到 Token:NVIDIA 如何最大化 AI 工厂产能


在硅谷一个闷热的八月夜晚,太阳落山,空调负载激增,硅谷电力向一家人工智能工厂发出信号,要求调整其功耗。
瓦伦·西瓦拉姆和大约四十人一起通过Zoom观看——他在旧金山Emerald AI的会议室、数据中心的工程师以及公用事业公司的人员。没有人碰任何东西。
Emerald AI的Conductor平台——由NVIDIA合作伙伴Emerald AI打造的网格编排平台,是NVIDIA DSX Flex所具备的灵活性的早期范例——能够接收关于电网状况的信号,并调整数据中心的灵活计算工作负载。
可以等待的工作会被放慢或重新安排,而更高优先级的服务则继续运行。
目标是在电网受限时减少电力需求,同时不中断关键的人工智能工作负载——这正是硅谷电力所需要的,
当减量出现在屏幕上时,大家都欢呼起来。
“我们屏息以待,”Sivara姆说。“这是我们首次在数千块NVIDIA GPU上部署。”他的产品主管Mansi Shah情绪激动。“这感觉有点像SpaceX的火箭发射,”她说。
硅谷电力公司此后向那家人工智能工厂发送了200多个需求信号。每次都成功了。
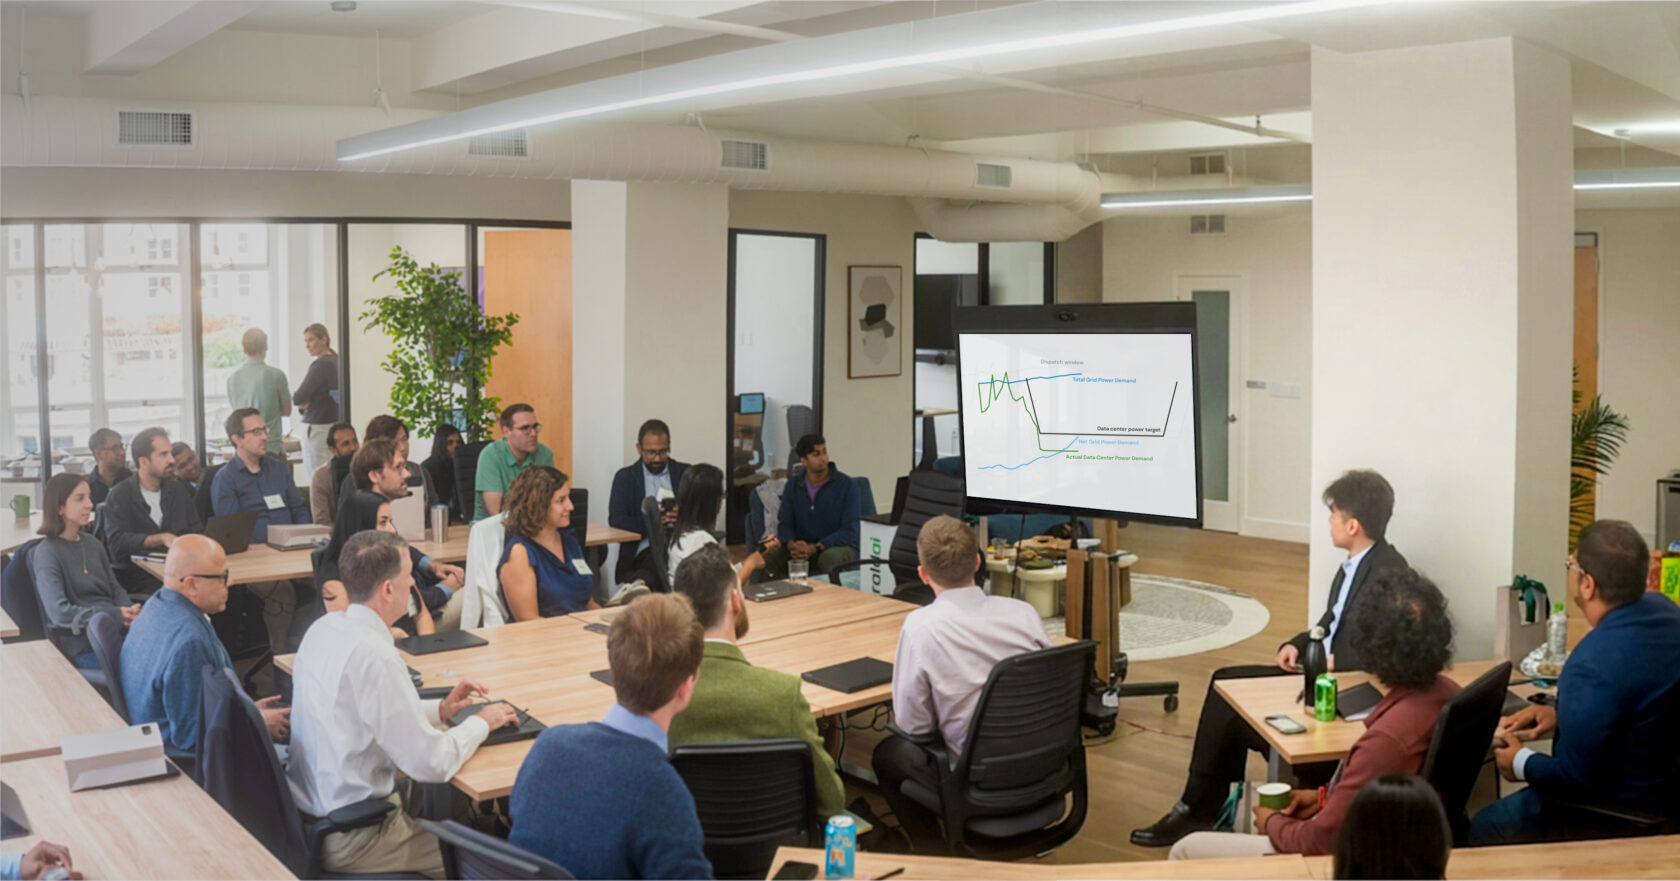
这就是生产中的电网灵活性。它指向的不仅仅是圣克拉拉的一座设施:一条无需等待十年建设新输电线路,就能解锁美国人工智能工厂所需电力的道路。
在人工智能基础设施峰会周二,英伟达超大规模与高性能计算副总裁伊恩·巴克将人工智能工厂效率作为其基础设施主题演讲的核心。
云服务提供商Lambda在部署环境中首次验证的结果(当天发布)显示:固定电力预算在智能管理下可支持24%的令牌吞吐量。
“通过我们的概念验证,我们相信已经突破了固定电力预算的限制,”Lambda云服务总裁Dave Ward说。“NVIDIA DSX MaxLPS为回收被搁置容量并将其转化为实际应用铺平了道路,并且在相同覆盖范围内实现了显著更高的计算密度。”
那个八月晚上,当高级副总裁打电话来电时,Conductor按照预定的工作量层级执行:最低优先级任务产出,高优先级推理持续运行,功率从4兆瓦降至3兆瓦。
自动化。无需操作员。
DSX 一览 NVIDIA DSX MaxLPS 一套优化每兆瓦AI工厂吞吐量的技术套件,包括动态电力分配软件,实时监控GPU和机架级用电,回收被困容量以最大化代币吞吐量,在固定功率预算内实现最大化。
NVIDIA DSX Flex接收电网信号(负载削减、需求响应、定价事件),并相应调整AI工作负载优先级,保护高优先级工作同时降低整体功耗。
NVIDIA DSX OS 开源模块化软件,用于AI工厂生命周期管理、运行时一致性、健康自动化和韧性。NVIDIA DSX 模拟仿真工具,允许运营商在实体部署前建模和验证工厂设计,识别瓶颈,确保资金确定。
NVIDIA DSX参考设计 世代专用、经过验证的架构,涵盖计算、网络、存储和设施,与NVIDIA生态系统合作伙伴共同设计。
在人工智能工厂经济中,电力是限制因素。每吉瓦的工作量是衡量标准。数据中心运营商对效率极为严格——每一瓦特的工作瓦特都带来高效的计算,行业在从设施设计到机架级电力转换的每一个层面都取得了显著提升。
DSX将这一学科扩展到AI工作负载本身。更智能的机架配置将电力投入到工作负载真正需要的地方。运营智能——更紧凑的调度、更快的重启、更精简的检查点——让GPU持续运行,而非等待。
目标始终是运营商追求的:利用现有能力获得更多工作。
“一吉瓦工厂永远不会变成两吉瓦工厂,”英伟达创始人兼首席执行官黄建森曾表示。
当系统达到物理极限时,工程师们的答案总是一样的:停止优化零件,开始设计整体。
NVIDIA DSX于五月在台北GTC展会上亮相,是AI工厂的答案——早期部署已经证明了这一点。
该完整平台涵盖网络、制冷、水效率和设施设计;以下章节重点介绍迄今为止在电力管理和电网参与方面的部分成果。
更多计算,相同预算:DSX MaxLPS
Lambda 在 AI 基础设施峰会上发布的结果,是 NVIDIA HGX B200 GPU 服务器上首次验证 DSX MaxLPS。
DSX MaxLPS监控GPU和机架级功耗,并根据工作负载类型重新分配节点间余量,回收静态配置时可能滞留的容量。训练和推理的耗电方式不同;MaxLPS优化了同时运行两者的AI工厂的分配。
Lambda是一家为超过1万名客户提供服务的GPU云服务提供商,客户涵盖AI原生初创企业到超大规模企业,他们在一个五机架、19节点集群上运行该软件。
他们的发现是:在与16个节点满功率时在同一功率预算内运行19个节点,Lambda实现了集群范围代币吞吐量提升24%——从大约每秒400万个代币提升到500万个。
每瓦性能提升了23%。
根据英伟达的预测,DSX MaxLPS可在合适的部署环境中,在同一兆瓦功率预算内,为下一代Vera Rubin NVL72 AI工厂提供多达40%的GPU容量。
自动化需求响应,已在生产中得到验证
圣克拉拉的故事不是DSX Flex的安装——而是更早、更重要的东西:证明该概念在商业规模下可行。<
英伟达的Eos AI工厂正在运行Emerald AI Conductor,作为硅谷电力灵活负载互联计划的参与者,这是首个将AI工厂视为可调度资源的商业电网公用事业项目。
当硅谷电力发出信号时,Conductor不到一分钟就响应。愿意灵活调整的工厂就能跑得更大。
这正是DSX Flex构建的通用模式——随着平台成熟,Emerald AI Conductor逐步集成进DSX Flex。首个专用的DSX Flex商业部署将设在弗吉尼亚州马纳萨斯的设施:位于英伟达AI工厂研究中心的96兆瓦Vera Rubin AI工厂,基于两大洲五次此前的演示。
下一级电力架构层:800V直流电力架构
如今AI工厂内的成果已是真实且可部署的。下一层是如何将电力传递到更密集的加速计算机架。
随着AI工厂规模扩大,传统的低压电力路径增加了转换复杂性和配电限制。
英伟达的800伏直流架构旨在降低转换复杂度,提高电力传输效率,并支持更密集的加速计算机架。
NVIDIA DSX正在将其参考设计中纳入800V直流电。
是整座工厂,不是零件
没有单一组件能单独优化AI工厂。网络上仍有更快的GPU等待。电力可能因配置不当而滞留。冷却开销仍然会将电力从GPU转移;GB200 NVL72机架运行直流液冷时,携带约120千瓦的热量,必须在这些能量到达计算前排出。
每兆瓦获得更多代币的唯一可靠途径是优化整个工厂——在安装第一个机架前先做DSX Sim,运行后再用DSX OS和DSX Exchange,DSX参考设计,这样建造者就从经过验证的架构开始,而不是从零开始。
(完整DSX套件可一览侧边栏。)
千兆瓦基础设施标准
归根结底只有一个问题:工厂每用电每兆瓦能产生多少有用工作?
NVIDIA DSX为基础设施建设者提供了参考设计、仿真工具、运营软件和电源管理技术,使其能够在该指标上、现有硬件及下一代产品中竞争。
当电网需要缓解时,工厂给予了缓解,没有放弃工作,也没有要求更多电力。
有了NVIDIA DSX,这就是AI工厂应有的新基线。
一览数据 指标上下文来源 +24% 集群令牌吞吐量 19 节点 85% 功耗 对比 16 节点满功率,相同设施预算 Lambda,HGX B200,DSX MaxLPS +每瓦性能 23%,19 节点集群 85% 功耗策略 对比 16 节点全功率基线 Lambda,HGX B200,DSX MaxLPS 在不到一分钟的 SVP 自动响应内降低 40% 功耗,灵活负载互联计划 Emerald AI / 未来 DSX Flex GPU 容量提升 +40% Vera Rubin NVL72,MaxLPS 结合数据中心功率规划,相同功率预算 DSX MaxLPS 3–5% 端到端效率提升(预计):800V 直流对 54V 配电;可选配 Vera Rubin NVL72 2027 NVIDIA DSX 800V 直流架构