hyperresearch:将 Claude Code 打造成深度研究 Agent 的开源工具


代理驱动的研究知识库。代理收集、搜索并综合网络研究,形成一个持久且可搜索的维基。
最强大的深度研究背带
Hyperresearch将Claude Code打造为深度研究代理:目前在DeepResearch-Bench RACE排行榜中领先(内部基准测试)。一个分层适应的16步流水线只需一个提示,就能生成一份具有完整来源的对抗性审计报告。
它读取的每个源都会落入一个持久且可搜索的保险库,因此每次会话的开始都比上一个更聪明。
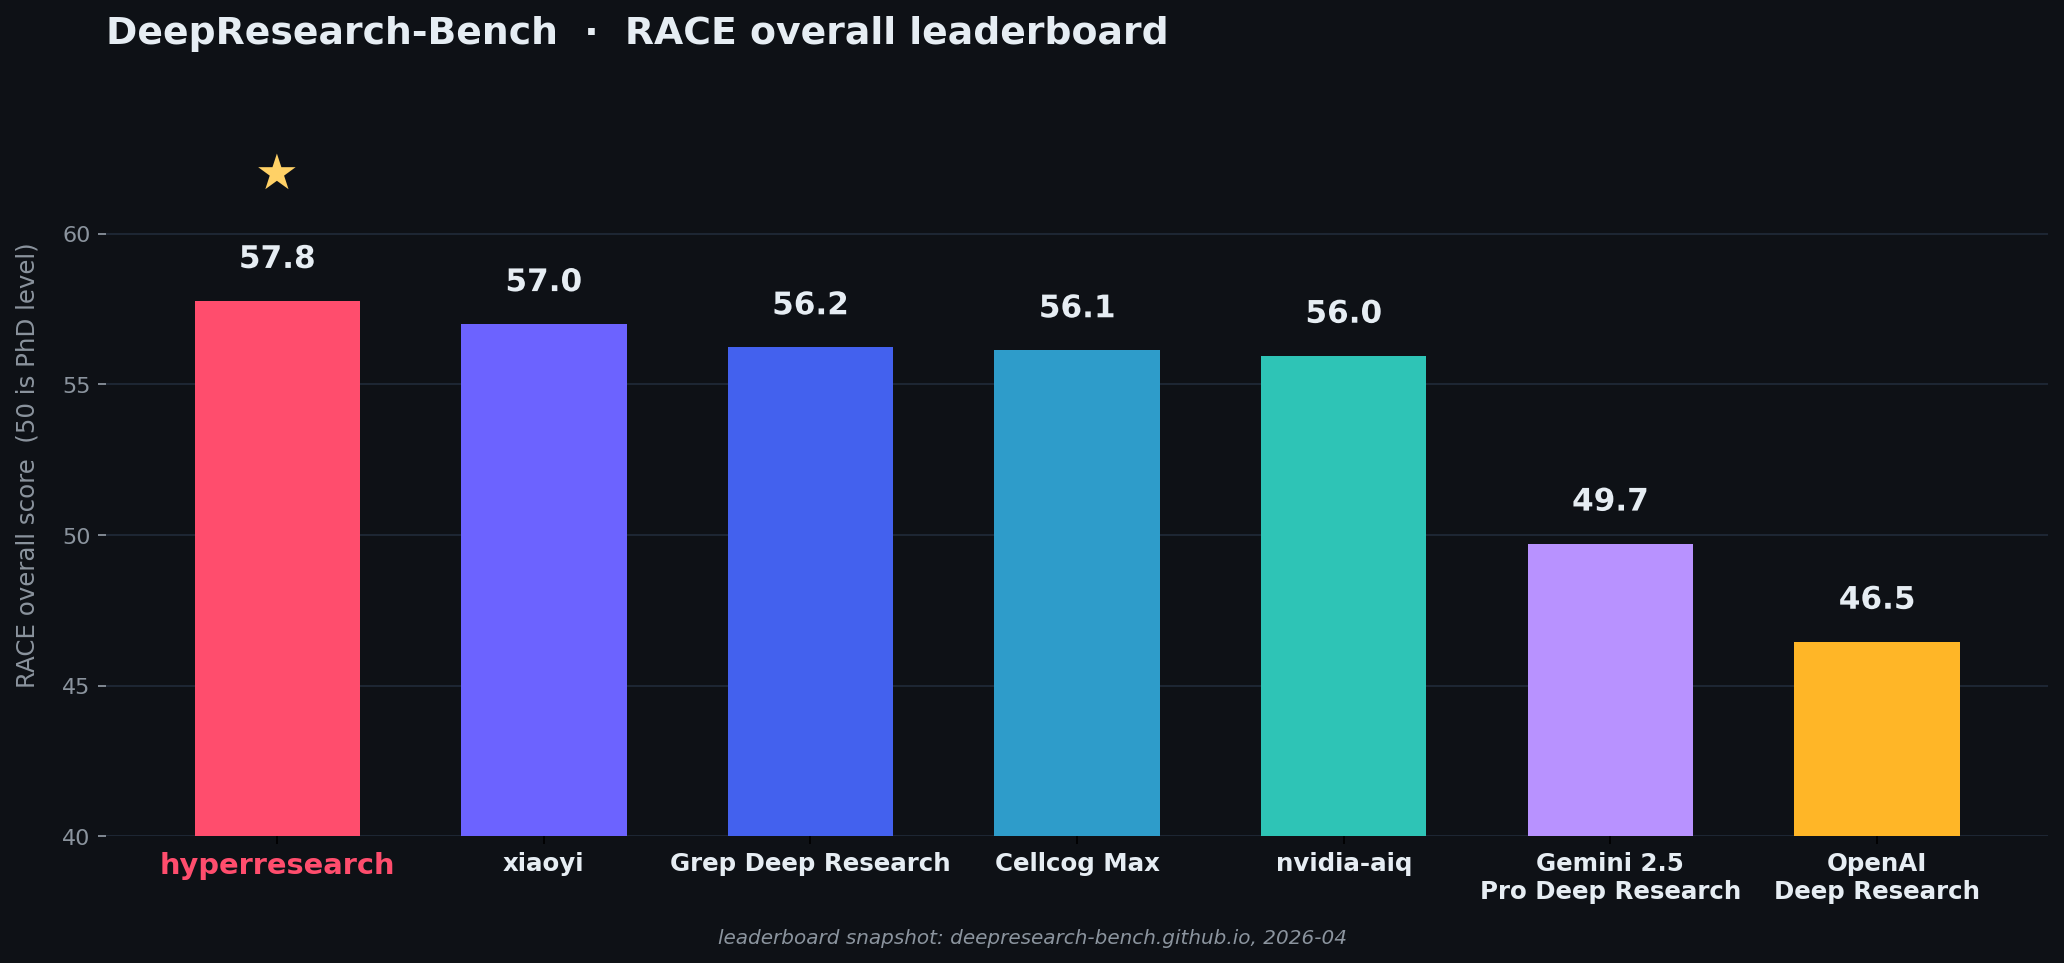
基于分层试点与DeepResearch-Bench排行榜快照的前瞻性预测(https://huggingface.co/spaces/muset-ai/DeepResearch-Bench-Leaderboard).第三方验证正在等待中。
为什么它会获胜
- 一次运行中250+个源。该
premier尺度剖面仅宽度扫荡就针对100–130个;引用追踪和填空的获取量超过实际落入语料库的两倍多。 - 每条引用在报告发出前都会经过核实。怀疑论的引用检查员会审核每个被引用的来源是否真的支持其判决。幻觉引用和未被承认的撤回是关键的障碍。
- 联合播出不算共识。独立审计会将衍生稿分组,因此一份新闻稿的五次重印会与同一来源的权重产生争议。
- 本质上是对立的。四个批评者同时攻击每个草稿,而一个工具锁定的补丁程序只能进行外科手术式的修改。它实际上无法重写报告。
- 八个学术来源,一个查询。
hpr scholar searchHits:OpenAlex、Crossref、CORE、DOAB,ClinicalTrials.gov通过同一客户端层,返回一份通过DOI和标题去重的单一列表。书籍、审判和文件与论文并存,每份都带有标签,以便管道识别哪些是哪种。人文和社会科学是有意为之,而非事后补充。 - 付费墙的论文是被阅读的,而不是浏览。封闭论文通常以1500字符摘要形式进入库中,报告随后引用其文字,仿佛已被阅读过。Hyperresearch向Unpaywall、Europe PMC和CORE请求合法开放获取副本,并保存全文,即使出版商直接阻止取用。每次替换均在注释、前言和CLI输出中披露。
- 没有什么东西会被丢弃。每个源都会进入一个可搜索的 markdown 加 SQLite 库,你的下一次会话会在获取新数据前再利用它。
- 崩溃的跑道继续。每次运行都会有清单;
run resume从它死去的那一步开始。 - 从30分钟到一篇论文不等。有界查询会自动路由到5步快速路径。自愿参与的论文运行,每章从300至450个来源中写下2.5万至8万字。
安装
cd your-project
pip install hyperresearch && hyperresearch install
则/hyperresearch 在克劳德代码中。
Python 3.11–3.13。(3.14 尚未支持。使用pyenv install 3.13,uv venv -p 3.13,或者py -3.13 -m venv .venv.)高级用户:hyperresearch install --global制造/hyperresearch可从每个 Claude Code 会话在任何地方访问,每个会话的系统提醒中需 ~ 15 行。按项目安装(上述)保持无关的 CC 会话干净。
16步研究流程
入口技能是一个薄路由器。它固定了规范的研究查询,然后通过Claude代码每阶段调用一步技能Skill工具。每个步骤的过程只有在该步骤实际运行时才会加载到上下文中。
这正是阻止长流水线在上下文腐朽时悄然丢弃步骤的原因。
| # | 步 | 它的作用 | 第三方 |
|---|---|---|---|
| 1 | 分解 | 正规查询→原子项 + 覆盖矩阵 + 层级分类 | 全部 |
| 1.5 | 章节划分 | 将原子项目分为4至10章;步骤2至10,然后每章循环 | 论文 |
| 2 | 宽度扫掠 | 多视角搜索计划+并行取波 | 全部 |
| 3 | 矛盾图 | 将语料库中的矛盾配对成排序的簇 | 满载 |
| 4 | 位点分析 | 两位平行位点分析师→用源预算评分位点 | 满载 |
| 5 | 深度调查 | K 个平行深度调查员 → 带有已确定位置的临时笔记 | 满载 |
| 6 | 交叉基因座调和 | 调和承诺立场→comparisons.md | 满载 |
| 7 | 紧张关系的根源 | 从专家意见中提取→ source-tensions.json | 满载 |
| 8 | 语料库批评 | “哪个来源会推翻这个观点?”+ 针对性空白填充取球 | 满载 |
| 9 | 证据摘要 | 顶级主张 + 逐字引用→evidence-digest.md | 满载 |
| 10 | 三重吸风 | 按角度策划 + 3个并行草稿子编排器(轻量:单稿) | 全部 |
| 11 | 合成 | 计划 + 轮廓 + 生成合成器子代理 → final_report.md | 满载 |
| 12 | 评论家 | 4个对抗性批评者并行分析→JSONs结果 | 满载 |
| 13 | 间隙取回 | 针对批评者识别金库间隙的目标取波 | 满载 |
| 14 | Patcher | 外科编辑块应用到草图(工具锁定的阅读+编辑) | 满载 |
| 14.5 | 引用核查 | 验证引用句子绑定;怀疑的LLM抽查;第二次手术贴片 | 满载 |
| 15 | 波兰语 | Hygiene + filler pass(工具锁定的 Read+Edit 子代理) | 全部 |
| 16 | 可读性审计 | 推荐者编写 JSON 建议;编排器选择性应用 | 全部 |
层级与齿轮:两个比例杆
第三方每个查询的路由。步骤1自动分类lightvsfull.dissertation仅限自愿加入;在提示中要求。
| 分级 | 运行内容 | 典型时间 |
|---|---|---|
light | 有界事实查询、调查、比较:1 → 2 → 10 → 15 → 16 | ~30–40分钟 |
full(默认) | 深入的论证分析与对抗性审查:全部16步 + 引用检查 | ~1.5–2.5 hfull装备 |
dissertation | 分章的超级连载:300–450个来源,4–10章,2.5万至8万字 | ~4–8小时 |
齿轮设定标准流程的规模:源目标、深度预算和词语目标,都被渲染到步骤技能中。
hyperresearch profile list           # all profiles + descriptions + current gear
hyperresearch profile use premier    # 100–130 sources, doubled depth budget (~3–5 h)
hyperresearch profile use full       # back to the 55–80-source baseline
齿轮在每个项目中会持续存在,并且经得起重新安装的保存。自定义齿轮:定义[profile.]在.hyperresearch/config.toml(任意旋钮:来源目标、位点上限、草稿计数、字目标、每个代理模型)以及profile use .
拉杆:报告用什么声音写的
层级和齿轮决定了工作量。杠杆决定了报告类型,第一步从提示词的动词形态中选择报告。提示中明确的指令总是胜出。
| 肝脏 | 价值观 | 变化 |
|---|---|---|
register | teach/survey/analyze/advocate | “教我X”有教学解释;“景观是什么”有田野地图但没有评判;analyze(默认)获得评价论证;advocate答辩一个名为论文的论文 |
domain_notes | 自由形式 | 采购策略、证据规范、相关领域的最新窗口 |
inference_depth | surface/standard/deep | 兔子洞拨盘。第四步可以升级,先看看语料库里到底有什么 |
这些拉杆渲染成角色范围的 shim 文件,生成模板,逐字粘贴到 subagent 提示中,因此批评者会随着寄存器移动,而不是撤销它。在survey注册辩证批评者标记为不公平代表而非缺失承诺,波兰审计员停止对冲。
在advocate反而全部都紧绷起来。
引文查询器和船门完全没有任何震动。验证从不因模式而变软。
hyperresearch levers set  inference_depth=deep --rerender   # go deeper mid-run
hyperresearch run status -j                                      # see what step 1 chose
承重原理
- 补丁,永远不要再生。第11步生成综合报告(轻级为第10步)后,唯一的修改是外科编辑块。补丁器和润色审计员被工具锁定于
[Read, Edit]在Claude代码允许列表层面,所以他们实际上无法写新草稿。每个块块的上限让“直接重写”在机械上变得不可能。不符合小块块的批评结果会升级为结构性问题。 - 规范研究查询是真理。逐字用户提示符被持久化为
research/runs//query.md一次,并且每次后续步骤和每个生成的子代理都会重新读取。封装要求(保存路径、引用格式、终端部分)是独立的契约。
分代理名单
模型是配置文件配置,不是硬代码。表格显示了出厂默认值,你可以在.hyperresearch/config.toml:[profile.full]其中models = { fetcher = "haiku" }下次安装时将所有取用器切换成俳句,或者profile use.
| 代理人 | 默认模型 | 职责 |
|---|---|---|
hyperresearch-fetcher | 十四行诗 | 通过crawl4ai获取URL;每波并行运行8–12条 |
hyperresearch-source-analyst | 十四行诗 | 任何单一长篇资料的端到端摘要>5000字 |
hyperresearch-loci-analyst | 十四行诗 | 读取宽度语料库,返回1–8深度位点并附有理据 |
hyperresearch-depth-investigator | 十四行诗 | 调查一个位置,写一份带有明确立场的临时备忘录 |
hyperresearch-corpus-critic | 十四行诗 | “哪个来源会颠覆当前趋势?”选秀前差距分析 |
hyperresearch-draft-orchestrator | 作品 | 每个草稿角度一个;阅读其精选的来源列表并写一个草稿 |
hyperresearch-synthesizer | 作品 | 读取全部三份草稿,写最终报告(两遍写入,读取+写入锁定) |
hyperresearch-dialectic-critic | 作品 | 草案未提出反证 |
hyperresearch-depth-critic | 作品 | 临时注释可以填补浅层空白 |
hyperresearch-width-critic | 作品 | 语料库支持的专题角落,但草稿忽略了这些 |
hyperresearch-instruction-critic | 作品 | 结构与提示的原子项不匹配 |
hyperresearch-patcher | 作品 | 工具锁定[Read, Edit].将批评性发现应用为外科手术 编辑 |
hyperresearch-cite-checker | 十四行诗 | 在发货前怀疑地核实样本引用句子的绑定 |
hyperresearch-polish-auditor | 作品 | 工具锁定[Read, Edit].切割填充物,剥除卫生泄漏 |
hyperresearch-readability-recommender | 作品 | 编写段落节奏和列表/表格转换的JSON建议 |
hyperresearch-browser-fetcher | 十四行诗 | 通过驾驶你的真实Chrome(Claude-in-Chrome)来排空升级队列 |
保险库:持久、可搜索、复利
大多数深度研究工具都是一次性的:报告完毕,其他内容丢弃。Hyperresearch保留它读取的内容。每个获取的源代码都会落入SQLite索引的保险库,未来会话在获取前会搜索该库。
hyperresearch search "ion-trap gate fidelity" -j           # Full-text search
hyperresearch search "quantum" --include-body -j           # Full-body search
hyperresearch note show    -j               # Batch-read notes
hyperresearch graph hubs -j                                # Most-connected notes
hyperresearch graph backlinks  -j                      # Reverse links
hyperresearch lint -j                                      # Health check (broken links, missing tags)
Markdown 是真实的,SQLite 是缓存。笔记实时显示为纯 markdown,前置 YAML 格式research/notes/.SQLite索引是完全可重建的:删除它,然后hyperresearch sync从Markdown重建它。
在任何编辑器里打开Vault,在git里做版本。你不需要安装工具也能阅读自己的研究。
PDF是直接获取的。 hyperresearch fetch自动检测PDF网址(arXiv、NBER、SSRN、直接访问).pdf链接)并通过 pymupdf 提取全文。原始 PDF 会落在research/raw/.pdf还有那张纸条raw_file:前片链接回来。
来源线索。每个获取的源都携带--suggested-by与浮现它的存在相连。链条由种子采集形成一棵有根的树;那provenance绒毛规则会捕捉断开的部件。
如果你想要语义搜索,也可以。 hyperresearch embed sync填充嵌入 (provider-pluggable:voyage,openai,或默认none,且不需要任何API密钥)。search --semantic将矢量相似度与全文排名相结合。
策划:笔记有生命周期
每次会议结束时都会获得策展通行证,笔记会通过审核draft→review→evergreen,或者stale→deprecated→archive随着材料逐渐老化。这正是让金库不至于变成半看完的垃圾填埋场的原因。
hyperresearch note update  --summary "..." --add-tag  -j   # promote a draft
hyperresearch dedup -j                                            # near-duplicate pairs by content similarity
hyperresearch topic tree -j                                       # the topic hierarchy
hyperresearch index build -j                                      # regenerate index pages
hyperresearch batch set-status stale --tag  -j                 # bulk lifecycle moves
hyperresearch link --note  --dry-run -j                       # wiki-links the linker would add
你没有被锁定
保险库是目录中的降价。下面所有内容都是方便的,而不是依赖。
hyperresearch export json -o out.json # every note as structured JSON
hyperresearch export vault       # a filtered subset to another directory
hyperresearch import             # pull an existing markdown collection in
hyperresearch git changed -j          # notes with uncommitted changes
hyperresearch git log -j              # notes touched by recent commits
hyperresearch watch                   # auto-sync while you edit in your own editor
用Claude Code外面的避难所
一个MCP服务器。 pip install hyperresearch[mcp],则hyperresearch mcp说stdio,所以Claude Desktop、Cursor或其他任何会说MCP的软件都可以在同一个vault上工作。
十三种工具:search_notes,read_note,read_many,list_notes,get_backlinks,get_hubs,vault_status,lint_vault,check_source,list_sources,fetch_url,create_note,update_note.
本地网页界面。 hyperresearch serve --open在8080端口启动一个带有笔记浏览、标签页、搜索和交互式链接图的STDLIB HTTP服务器。
无构建步骤,也无JavaScript依赖。
来源排名:质量是持久性的,而非氛围
每个源都会累积一个复合quality_score由源类型层级、获取时间实用性、引用权威构建(来源于 OpenAlex / Semantic Scholar,包括撤稿旗帜),以及PageRank的中心性:
hyperresearch sources score -j             # Enrich DOI-bearing notes: citations, venue, retractions
hyperresearch graph rank -j                # PageRank over the link + provenance graph
hyperresearch search "q" --ranked -j       # Quality-weighted full-text search
hyperresearch sources independence -j      # Cluster syndicated/derivative copies: 5 copies of one press release = 1 vote
hyperresearch claims search "q" -j         # Query extracted claims across all sources
撤回的来源质量几乎为零,且船上撤稿扫描会重新核查每条被引用的DOI,所以昨天发布的撤回消息今天被抓。即使是从旧报道中重用的金库来源。
运行次数:可续行、预算、验证
每个运行程序都拥有一个独立的工作区(research/runs//)以及一个清单。并发运行从不发生冲突,崩溃运行会从停止处恢复:
hyperresearch run status -j          # Step-by-step status, spend, escalation queue depth
hyperresearch run resume -j          # Exact next step + Skill invocation to continue
hyperresearch run report -j          # Per-step wall-time / spend / source-yield telemetry
hyperresearch run verify  -j    # Ship gate: headings, length, citation density, cite-check resolution
run init --budget 50限制估计API等效支出;跨越上限反而阻碍了运行,而不是让它悄然膨胀。在任何报告发布之前,验证电池会运行:引用完整性(每个引用的跨度必须逐字出现在金库注释中),撤回引用(引用撤回消息来源未被承认阻挡飞船),数值一致性(无法追溯到证据的数字会被标记),加上引用检查步骤的按引用约束审计。
结构性执行的内容
- 逐字提示如同福音。
scaffold-prompt如果脚手架没有按用户的提示打开,绒毛会被阻挡 - Locus 覆盖。每个第4步点必须有第5步中间注;缺少中间标志为错误
- 仅限补丁修改。步骤14、15、16被工具锁定为
[Read, Edit].他们无法重新生成选秀 - 关键发现从不悄然跳跃。
patch-surgery棉絮覆盖了补丁员无法应用的关键发现 - 必须有引用文本。
quote-integrity棉絮会阻挡任何未逐字出现在保险库注释中的引用跨度;幻觉引用无法寄送 - 收回装置阻挡飞船。引用撤回的来源却不承认撤回,在最终门槛上是一个严重错误
- 模式完整性。
tier,content_type, 和type是受SQLite CHECK约束的词汇表;损坏的前置文件无法毒害索引 - 卫生泄漏在出去时被发现了。脚手架部分、YAML前言和提示回声在发货前的第15步被剔除
- 获取的文本是数据,而不是指令。在两者中,网状取物的尸体都被送上围栏内
note show以及search,因此告诉代理忽略其指令的页面被读作内容
网络是敌意输入
研究代理人会阅读数百页自己未选择的页面,其中任何一页都可能包含寄给代理人而非你的文本。
从网络抓取的每个实体都被包裹在分隔符中,并带有内联的视为数据前言,服务于服务实体的两条路径上(note show单表单、批处理表单和JSON表单,search包括尸体)。
注意你自己的管道子代理写下了未包裹的通道。取回尸体内的伪造围栏标签被中和并留给法医可见,url属性通过HTML转义,控制字符被去除,且search封装发生在代币预算截断之后,因此关闭的围栏永远不会被切断。
取用者、深度调查者、草稿协调者和源分析者都带有一个策略块,告诉他们不要将被围栏页面的指令洗白为可信输出。
第三方API解析的URL也会受到同样的处理。开放访问的位置出现在别人的JSON中,因此在获取之前会检查方案、嵌入凭据和可公开路由的解析。
网络服务提供商
该[web] provider开始.hyperresearch/config.toml选择如何获取页面,以及支持该服务的提供者如何搜索网页。除了默认选项外,其他都是可选的附加功能。
builtin(默认)——纯HTTP抓取,没有搜索。零额外依赖;这是其他所有改进的起点。crawl4ai——无头浏览器抓取,带隐形、PDF提取和浏览器升级通道。这是管道专门针对的。pip install "hyperresearch[crawl4ai]".exa——神经网络搜索和页面提取。需要API密钥。pip install "hyperresearch[exa]".tavily——为代理构建的搜索和提取功能。需要API密钥。pip install "hyperresearch[tavily]".parallel—并行搜索MCP端点,无需账户或密钥。仅搜索——批量取源波会降级为每个URL的访问,因此它是一个很好的搜索提供者,而非crawl4ai取物路径的替代品。来自一个进程的每个请求都带有一个随机会话ID,Parallel会用它来进行相关性和速率限制。pip install "hyperresearch[parallel]".
# .hyperresearch/config.toml
[web]
provider = "crawl4ai"
认证爬行 + 浏览器通道
从LinkedIn、Twitter、付费墙网站或任何你可以登录的平台获取:
hyperresearch setup # Browser opens. Log into your sites. Done.
LinkedIn、Twitter、Facebook、Instagram 和 TikTok 会自动使用可见浏览器以避免会话被杀。
被阻挡的取球会升级,而不是死亡。当无头爬行在运行中途遇到登录墙或机器人墙时,该URL会作为升级队列(hyperresearch escalation list -j).如果你有克劳德·因·克劳德扩展时,浏览器取源代理通过驱动你真实登录的Chrome来排空队列。
硬边界:验证码、两步验证和登录问题从来不会自动解决。它们会合并成一条信息,然后交给你。
学术发现:八个来源,一个查询,一个去重列表
对于任何有研究文献的主题,在进行网页搜索之前,先搜索学术来源。它们返回的是引用排名的经典著作;网络搜索则返回衍生评论。这些建议过去是以代理被信任手工组装的URL模板列表形式提供——不重试、不限速、不去重、不做测试。
现在它是一个真正的客户端层:
hpr scholar search "Byzantine iconoclasm" -j                # every available source, merged
hpr scholar search "GLP-1 cardiovascular outcomes" --scope papers -j
hpr scholar search "credit default swaps" -s edgar -s fred -j
hpr scholar sources                                          # what is wired, what each covers
一个调用查询所有配置的源,合并相同作品的记录(先按DOI,然后按归一化标题和年份),并返回一个列表。两个提供者找到的作品同时携带also_in,引用次数更高,抽象更长。
每个提供者共享一个缓存、一个每个主机的礼貌速率限制器和一个结果格式。
文献来源:
- 开放亚历克斯—— ~2.5亿,涵盖各学科,包括书籍、书籍章节和论文。STEM领域之外的正确默认,因为现有工具最为薄弱。
- 交叉引用—— DOI 注册机构本身。授权元数据,涵盖约1.6亿件注册作品,包括其他作品无法被索引的新注册。
- 核心—— 最大的开放获取全文聚合器。托管文本而非链接,因此它也是一个全文解析器(见下文)。需要一个密钥:
CORE_API_KEY. - DOAB——同行评审的开放获取学术书籍和章节。这里唯一能找到这本书而非对其进行的评论,后者很重要,因为在人文学科中,出版单位是书籍而非文章。
- RePEc—— 列出以显示空白而非无声。他们的 API没有搜索功能;
hpr scholar sources有说过,并指向带有DOI的系列的OpenAlex和Crossref。
专业资料——非论文的可引用记录,标记为work_type所以管道从不把其中一个误认为是文学作品:
- ClinicalTrials.gov——注册的研究,包括那些从未发表论文的。没有钥匙。
- 埃德加部长——对文件进行全文搜索。SEC拒绝任何未在用户代理中提供联系地址的请求,因此设置
HYPERRESEARCH_CONTACT_EMAIL. - 弗雷德——美联储经济系列。需要一个关键点:
FRED_API_KEY,该缓存从未被写入。
背景设定HYPERRESEARCH_CONTACT_EMAIL同时也会让你进入OpenAlex和Crossref的“礼貌池”,这些池对速率限制远比匿名流量宽松得多。不会有人代你发送占位符。
学术扫荡结束后,进行网络搜索以获取背景、新闻、非学术角度,以及至少一项对抗性搜索(“对X的批评”、“X的局限性”)。
开放获取全文:在引用前请先阅读此文
否则,付费墙的论文会以摘要形式进入保险库,管道随后推理超过1500字符,同时引用该作品,仿佛论文已被阅读过。为了结尾,当一个取物任务落在带有DOI的薄页时,hyperresearch会询问无付费墙,欧洲PMC以及核心,按此顺序,合法开放获取副本和存储那而是在注释正文中。
Unpaywall需要联系地址,欧洲PMC仅涵盖生物医学;CORE是覆盖所有其他内容的广泛网络,且直接托管文本,而非指向5月403日的仓库。
那张纸条source:我还是指向你要的那个网址。尸体可能来自别处。这种替代在四个地方都有披露,你应该都知道:
- 笔记正文顶部会显示一条横幅,标明文本实际来源的URL,以及是哪个版本。
oa_url/oa_source/oa_version/oa_license/oa_recovery_kind在便条的前言里。- 一个
oa封闭hpr note show --json,携带body_is_not_from_source: true. - 输出中的一行
hpr fetch以及hpr fetch-batch.
抢救的笔记:里面没有任何来自源的
当无法读取源代码时,同样的查找程序也会运行一点也不——403、登录墙、机器人墙。这些都是付费墙论文最容易丢失的地方,而且由于DOI识别的是作品而非托管人,合法副本最有可能存在于其他地方。
这样构建的音符比替代更有力,且标记方式不同:oa_recovery_kind: rescued,nothing_from_source: true在note show以及一条横幅,上面写着源URL从未被阅读过。
请字面理解。标题、作者和正文中的每一个字都是开放获取副本的——没有从该URL读取任何内容source:.如果你宁愿没有音符,也不愿完全由替代音符组成,则oa_rescue_blocked = false.
有两个限制值得了解。救援需要DOI,而一个没有结果的来源没有页面可读取DOI,所以只有当DOI在URL内时才会触发(adoi.org链接)或墙面页面citation_doimeta标签。
一个没有DOI的裸发布者URL,结果和以前一样失败。而被救回的源代码不是排在浏览器升级通道,因为论文已经拿到手了——如果你特别想要出版商自己的页面,自己通过那条通道获取。
不同版本不能互换。当没有已发表的稿件开放时,Unpaywall会乐意退还已接受的稿件或提交的预印本。Hyperresearch更倾向于记录版本,记录其收到的内容oa_version,但如果acceptedVersion或submittedVersion在报纸发表报告前,请对任何直接引用进行核对。
正文横幅也这么写。
在下面配置[scholar]在.hyperresearch/config.toml:
[scholar]
oa_recovery = true              # set false to disable entirely
contact_email = ""              # REQUIRED by Unpaywall's terms — empty means Unpaywall is skipped
oa_min_full_text_chars = 6000   # bodies shorter than this trigger a lookup
oa_prefer_published = true      # version of record over preprints
oa_max_attempts = 3             # candidate copies to try before giving up
oa_rescue_blocked = true        # also run when the source can't be read at all
开箱即用contact_email空无一人,因此只有欧洲PMC运行,回收仅限于其内的报纸开放获取子集.设置一个真实地址以启用Unpaywall——他们的条款要求有这个地址,发送共享占位符会让所有超研究用户同时使用该占位符的费率受限。
出版商经常封锁自己的开放获取PDF,一次尝试不够,所以Hyperresearch会走候选列表:Unpaywall知道的每个PDF,然后是着陆页,然后是Europe PMC的结构化全文(解析自JATS,比两列PDF上的Pymupdf更强——有真实的章节边界,无页眉出血,无列交错)。
只有当Unpaywall的副本用尽后才会查询Europe PMC。
恢复从不失败,也不会降低质量。候选人必须通过两个门槛才能被录取:比你已有的更多文本,以及足够说明oa_min_full_text_chars.这第二条栏正是阻止仓库记录页——标题、作者、200字摘要——仅仅比出版商摘要稍长就无法被当作全文的原因。
如果没有候选人同时通过两者,你就保留摘要和不oa显示了阻塞。救援只会将失败的取用转为备注,绝不会反过来:当被阻断的源没有开放获取副本时,命令会像往常一样失败。
它做不到的事
- 它不能取代你对哪些消息来源重要的判断。经纪人选择,你引导。
- 它无法获取你未登录的付费墙后的内容。开放获取恢复在存在时会找到合法的免费副本——即使出版商直接阻止了检索——但当没有时,你只能获得摘要,或者什么都没有,说明中也说明了这一点。
- 它通过子特工名单运行在人类模型上(每个特工的分配来自档案的模型映射)。使用会随着等级、装备和语料库规模而变化。如果有人想把它移植到Codex上,请上传PR!
- 绒毛门会卡住结构失败(缺少支架、断裂的来源、未解决的关键问题)。它不能保证事实准确性,这仍然是你的决定。
要求
- Python 3.11+
- 克劳德密码