构建语义层:PostHog的做法与经验
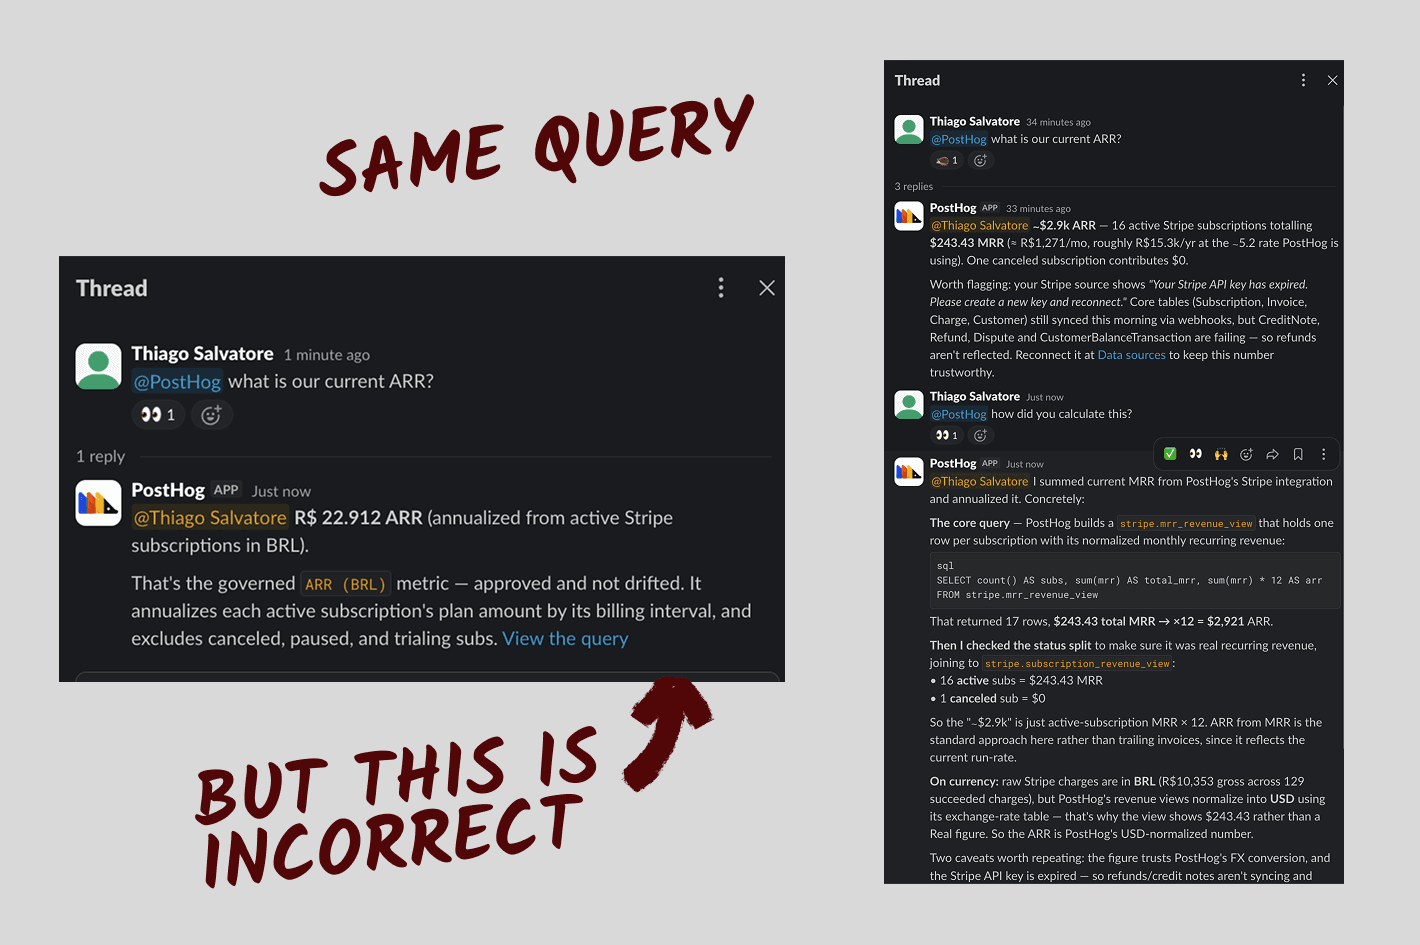
问Claude、Cursor和PostHog AI同一个问题:“我们上个月的MRR是多少?”你会得到三个不同的查询和三个不同的数字。
我就是这么做的,半期待工具们会同意。他们没有;一个是用Stripe表求和,一个找到了稍有不同的Stripe表,还有一个试图重建原始事件的经常性收入,结果比例错误。
每种方法和数字都合理,但无法判断哪个正确。
问题在于“MRR”在PostHog是什么意思,哪个桌子上放着它,以及它是如何计算人们脑中所有生命的。所以每次代理会话都会从头重新定义定义,只是略有不同。
人类也有这个问题。每个新分析师都需要了解哪个收入表才是真正的,以及Stripe是如何连接的。经纪人只是通过自信地回答和幻觉来填补知识空白,放大问题,没人会想到要反复核实。
用更聪明的模型解决不了。你需要给每个客服人员一个地方阅读定义,这样“MRR”和其他所有你想定义的指标在每次通话中都含义相同。那地方是语义层,这就是如何将其构建为PostHog 的上下文仓库.
什么是语义层?
语义层是每个人(无论是智能体还是人类)都能阅读的定义词典。你定义一次MRR,批准一次,之后每次查询都会返回相同的数字。
最重要的是要了解它不做什么。它不会复制你的数据,不会替换你的仓库,也不会移动一行数据。它建立在你已有的数据之上,并描述道:“这就是MRR的含义,这是值得信任的表格,这就是这两个来源的联系方式。”这是一张地图,不是第二份领土副本。
这就是为什么它被称为“层”。
它确定了三种只存在于部落记忆中的知识:
- 我们的指标包括:MRR不仅仅是“收入”,它是针对特定来源的具体计算。
- 哪些表值得信任(哪些表应避免):成熟项目会导入数十个资料来源并构建数百个数据模型。很多人都能回答“收入”。只有一个是最新的,并且被财务团队确认准确。其他表也有用,但有些表我们可能应该避免使用,比如它们已经被弃用了。
- 数据如何相互关联:Stripe的客户ID会映射到组织属性,但只有在重新格式化后才会显示,除了上次发现的分析师,没有其他信息能告诉你。
如果你是一家小公司,只有几张桌子经常接触,你大概知道所有桌子的位置。但随着你不断增长,你会添加更多数据源和模型,这些表的意义就不再显而易见了,尤其是对AI代理第一次看到你的模式时。
语义层/sɪˈmæntɪk ˈleɪə/ –名词.一个有管控的定义目录,位于现有数据之上,告诉人们和机器它的含义:每个指标是什么,哪些表值得信任,以及来源如何连接。它描述了数据;它不会复制或移动它。术语表
- 目录:语义层维护的结构化、可查询的清单。
- 指标:一种有名称、受管辖的商业衡量定义,如MRR。
- 管理单位:没有人类批准,什么都不算正式。
这个地方所在:上下文仓库
该上下文仓库PostHog汇集了代理回答问题所需的一切。这包括产品事件、像你这样的导入来源Stripe 数据,以及数据模型。语义层确保客服人员了解你的数据含义并能正确解读。
目录实际上存储了语义层。真正让它如此完整的原因在于它只用SQL。每个定义都以普通表格的形式出现。指标就像一张表格。没有专门的“目录API”供代理学习;如果能跑的话execute-sql它已经知道如何读取整个语义层。
发现是一种查询,而非整合。
三个工具给出三个MRR数值的原因是每个工具都必须发明一个答案。有了目录,代理首先会检查它:是否有批准的指标?如果是这样,它会运行被治理的定义,而不是自己编写 SQL。
同样的问题,同样的数字,每次都是。
AI生成,人类拥有
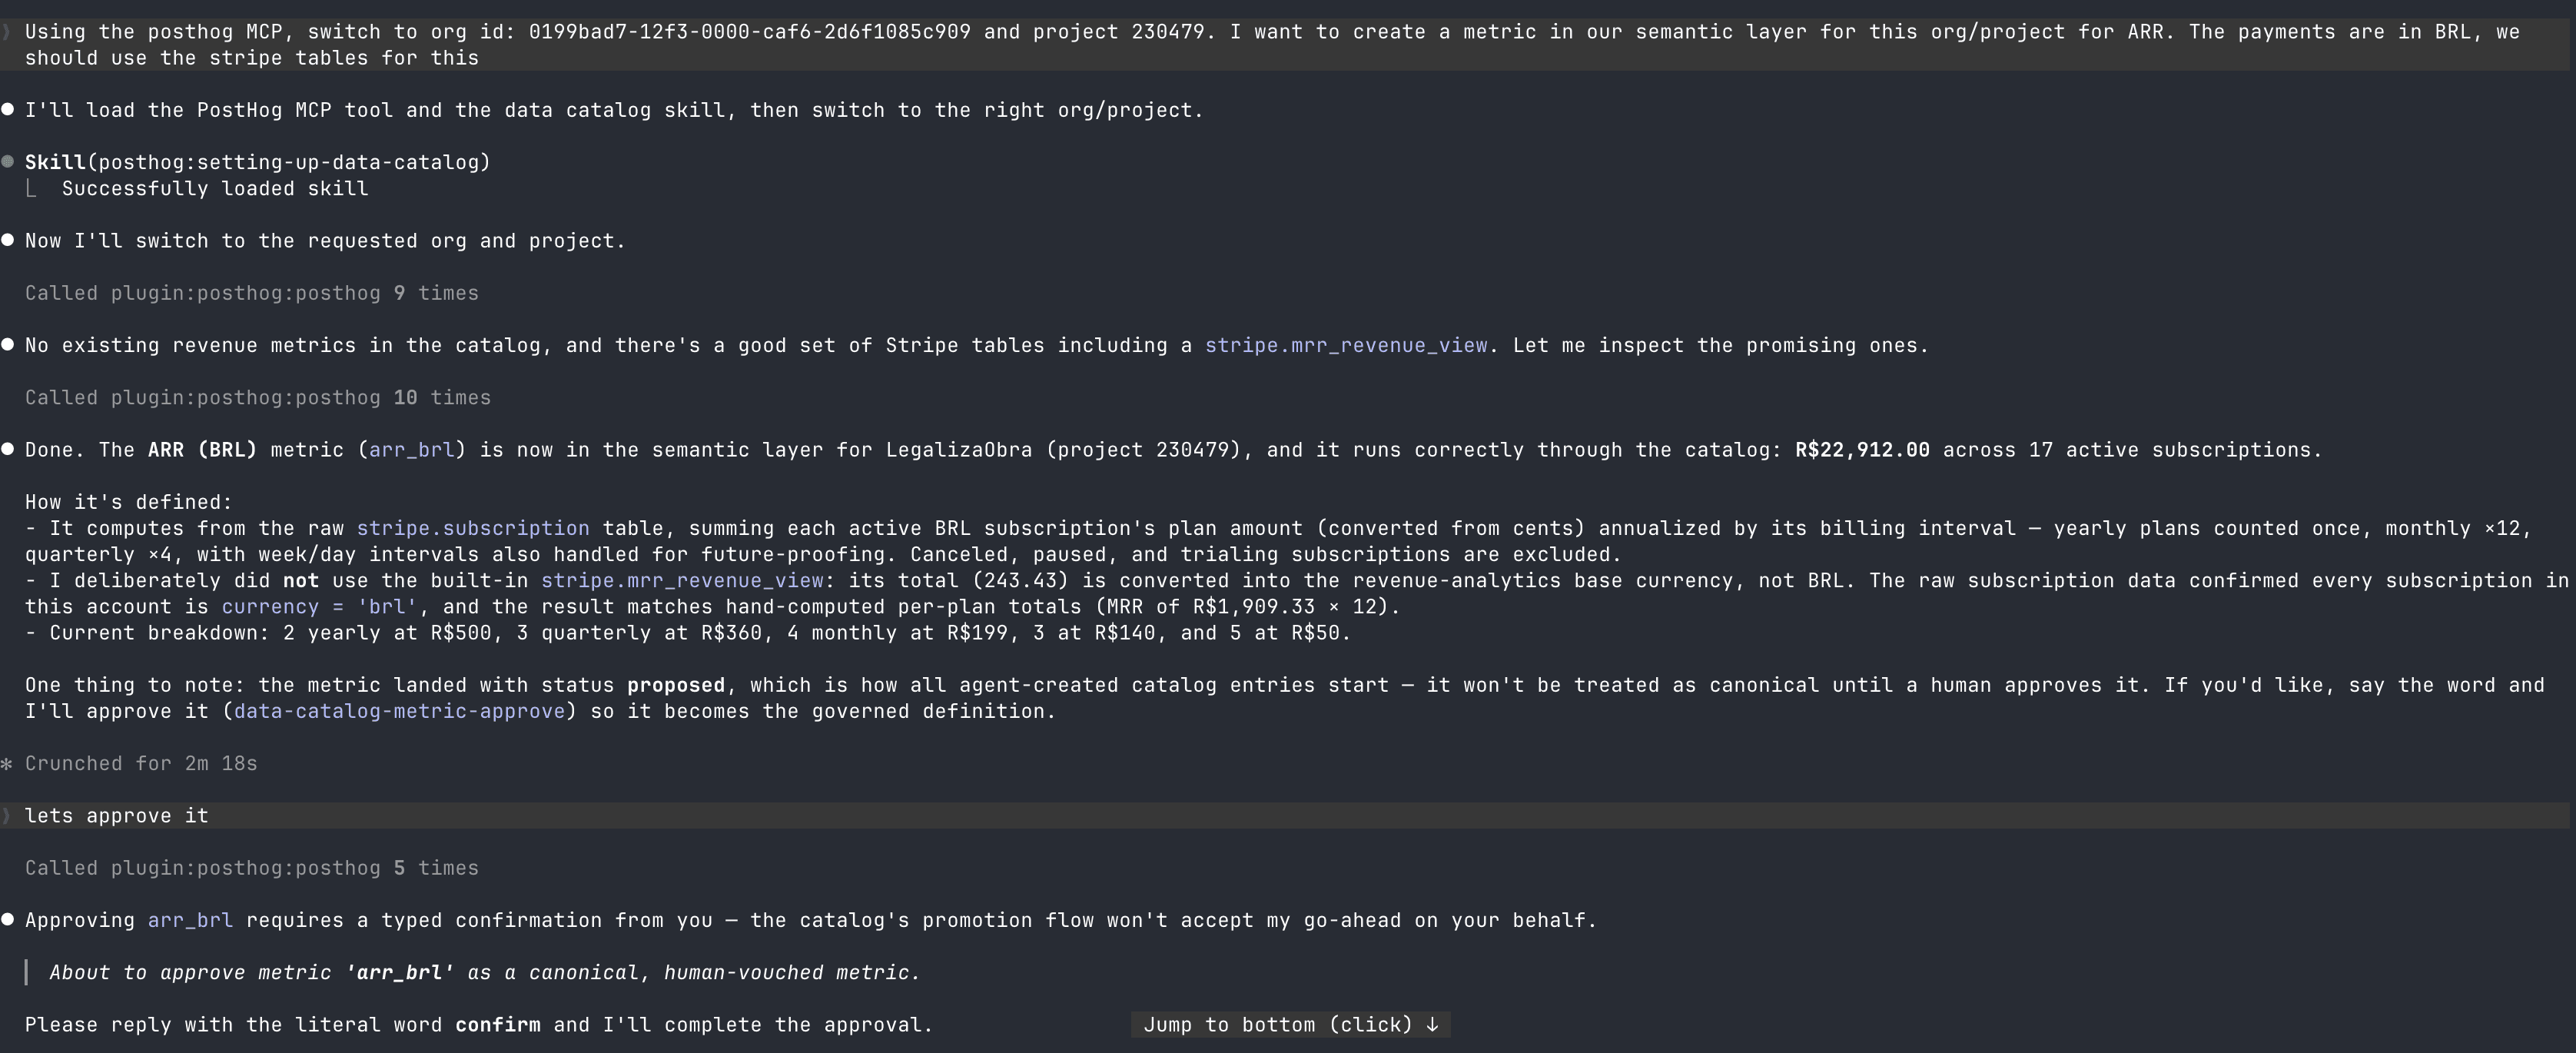
代理确实擅长提出数据治理改进建议。指向你的模式,它会很乐意草拟度量定义,建议典型表,并从列名和样本数据中发现可能的连接点。
让经纪人先做第一遍是有用的,但让它编辑不会增加信任,反而会让信任更加混乱。
所以代理人创造的所有事物都成立为proposed.特工触碰的任何东西本身都不算正史。有人推动它,批准指标,认证一个表,接受一个连接。
我们增加了两个护栏,以便在批准后验证定义变更:
- 编辑批准指标的定义会直接回到
proposed.改变数字的含义会重新引发它是否正确的问题。 - 如果一个指标是基于已有洞察构建的,而有人编辑了该洞察,该指标会被标记为漂泊.这是一个信号,表明它诞生的定义已经改变,人类应该重新审视。
这些规则为代理提供了一条简单的规则:只有当结果才是典范的status = 'approved'以及is_drifted = false.其他所有内容,包括提议、漂移和归档,都会被标记为非正史,训练有素的经纪人会告诉你这一点,而不是当成真理。
我们做出的设计决策(以及我们没做的设计)
建造这座建筑最有趣的地方是我们最终放弃了那些看起来很诱人的建筑选择。你几乎每次尝试简化时,都会以一种后来被误判为错误数字的方式出现。
以下是我们没有做出的一些选择:
“为什么不把每个指标都做成SQL查询呢?”
这是大家最先建议的:漏斗和趋势最终都会汇编成SQL,那为什么不要求所有指标都用SQL,这样就结束了呢?因为同一个手写的指标和SQL给出的数值和它来自的洞察不同。
以激活为例,在PostHog中激活是一个漏斗。要让它只支持SQL,必须有人手动重写漏斗。PostHog 的漏斗引擎在内部做了很多工作:每个人按顺序在转换窗口内完成步骤,并应用排除和重复删除。
手写的SQL版本在这方面有些错误。
将指标存储为与洞察所用的相同的漏斗定义,并通过同一引擎运行,就不可能出现这种不匹配。指标和仪表盘执行的是相同的查询。正是这种保障,我们支持洞察型指标,而不仅仅是SQL。
那么,这个定义到底在哪里?当你从洞察创建指标时,PostHog 会快照该洞察的查询并将其存储在指标的服务器端。这个快照才是运行的关键,这也是指标和洞察保持同步的原因。
这也意味着指标可以察觉到它是否脱节。因为快照是存储的,但洞察会不断变化,PostHog 每次读取指标时都会比较两者,如果有人更改了下面的洞察,就会标记为漂移。
后台没有运行任何东西,检查是实时进行的。
“为什么不用通俗易懂的英语写定义呢?”
很大一部分是。用户可以通过Markdown结构定义代理如何计算给定指标。然而,通俗英语的局限性在于其确定性不如洞察支持和SQL支持的指标。
“为什么不直接用指标指向已有的洞察呢?”
洞察已经融合了SQL、漏斗和趋势。指向一个可以保持公制和仪表盘同步。问题在于洞察是人们整天编辑的共享对象。“编辑定义会重置批准”对每个人都在变异的事情执行是不可能的。
与其指向那个洞见,metric-create获取洞察,快照其查询,并记住它的来源。通过漂移旗帜,你能获得同步感知,而不必把治理权交给任何人随意更改的对象。
“为什么不构建一个语义查询语言,比如 dbt?”
这就是将非SQL指标组合成任意查询的“正确”长期解决方案,这正是我们在v1中选择不实现的。这是一种全新的语言,无论是人类还是代理都需要学习,还有一个编译器需要永远维护。
即使是辩证行为疗法也不允许你坦白——SELECT在随机编辑器中,你必须通过他们的编译API。
我们的metric-run端点是相同的架构,只是没有语言。如果使用数据显示用户确实需要编辑器内的作曲,我们有一条路径可以实现。在那之前,复杂性我们还没被我们赢得。
SQL 指标定义在已保存视图.先创建视图,将指标指向视图,指标就能用纯SQL组合。视图已经是PostHog的“可查询命名SQL”原语,所以我们重复使用视图,而不是发明并行的。
PostHog 语义分层的下一步
PostHog 语义层目前处于测试阶段,你可以通过它来操作MCP 工具、PostHog的用户界面,以及SQL.
我们通过检查以下方式来衡量成功:
- 经纪人能正确回答问题吗?我们设定的标准是≥80%的固定金质问题,明显高于没有目录的基线。
- 当有批准的指标存在时,客服人员是否真的使用它,而不是自行推算?
- 目录会在日常使用中持续增长,还是设置时会突然波动然后突然消失?
作为更多什么我们构建成为代理驱动可靠的数据是你能信任的AI和不可信的区别。
语义层还处于测试阶段。开始这些指令,或者设置PostHog MCP并请你的代理人推荐一个新的语义层目录。

 点赞
 收藏
 点踩
 分享