QuestDB

RSS: https://questdb.com/rss.xml
QuestDB 官方博客,开源高性能时序数据库,关于数据处理与数据库技术。

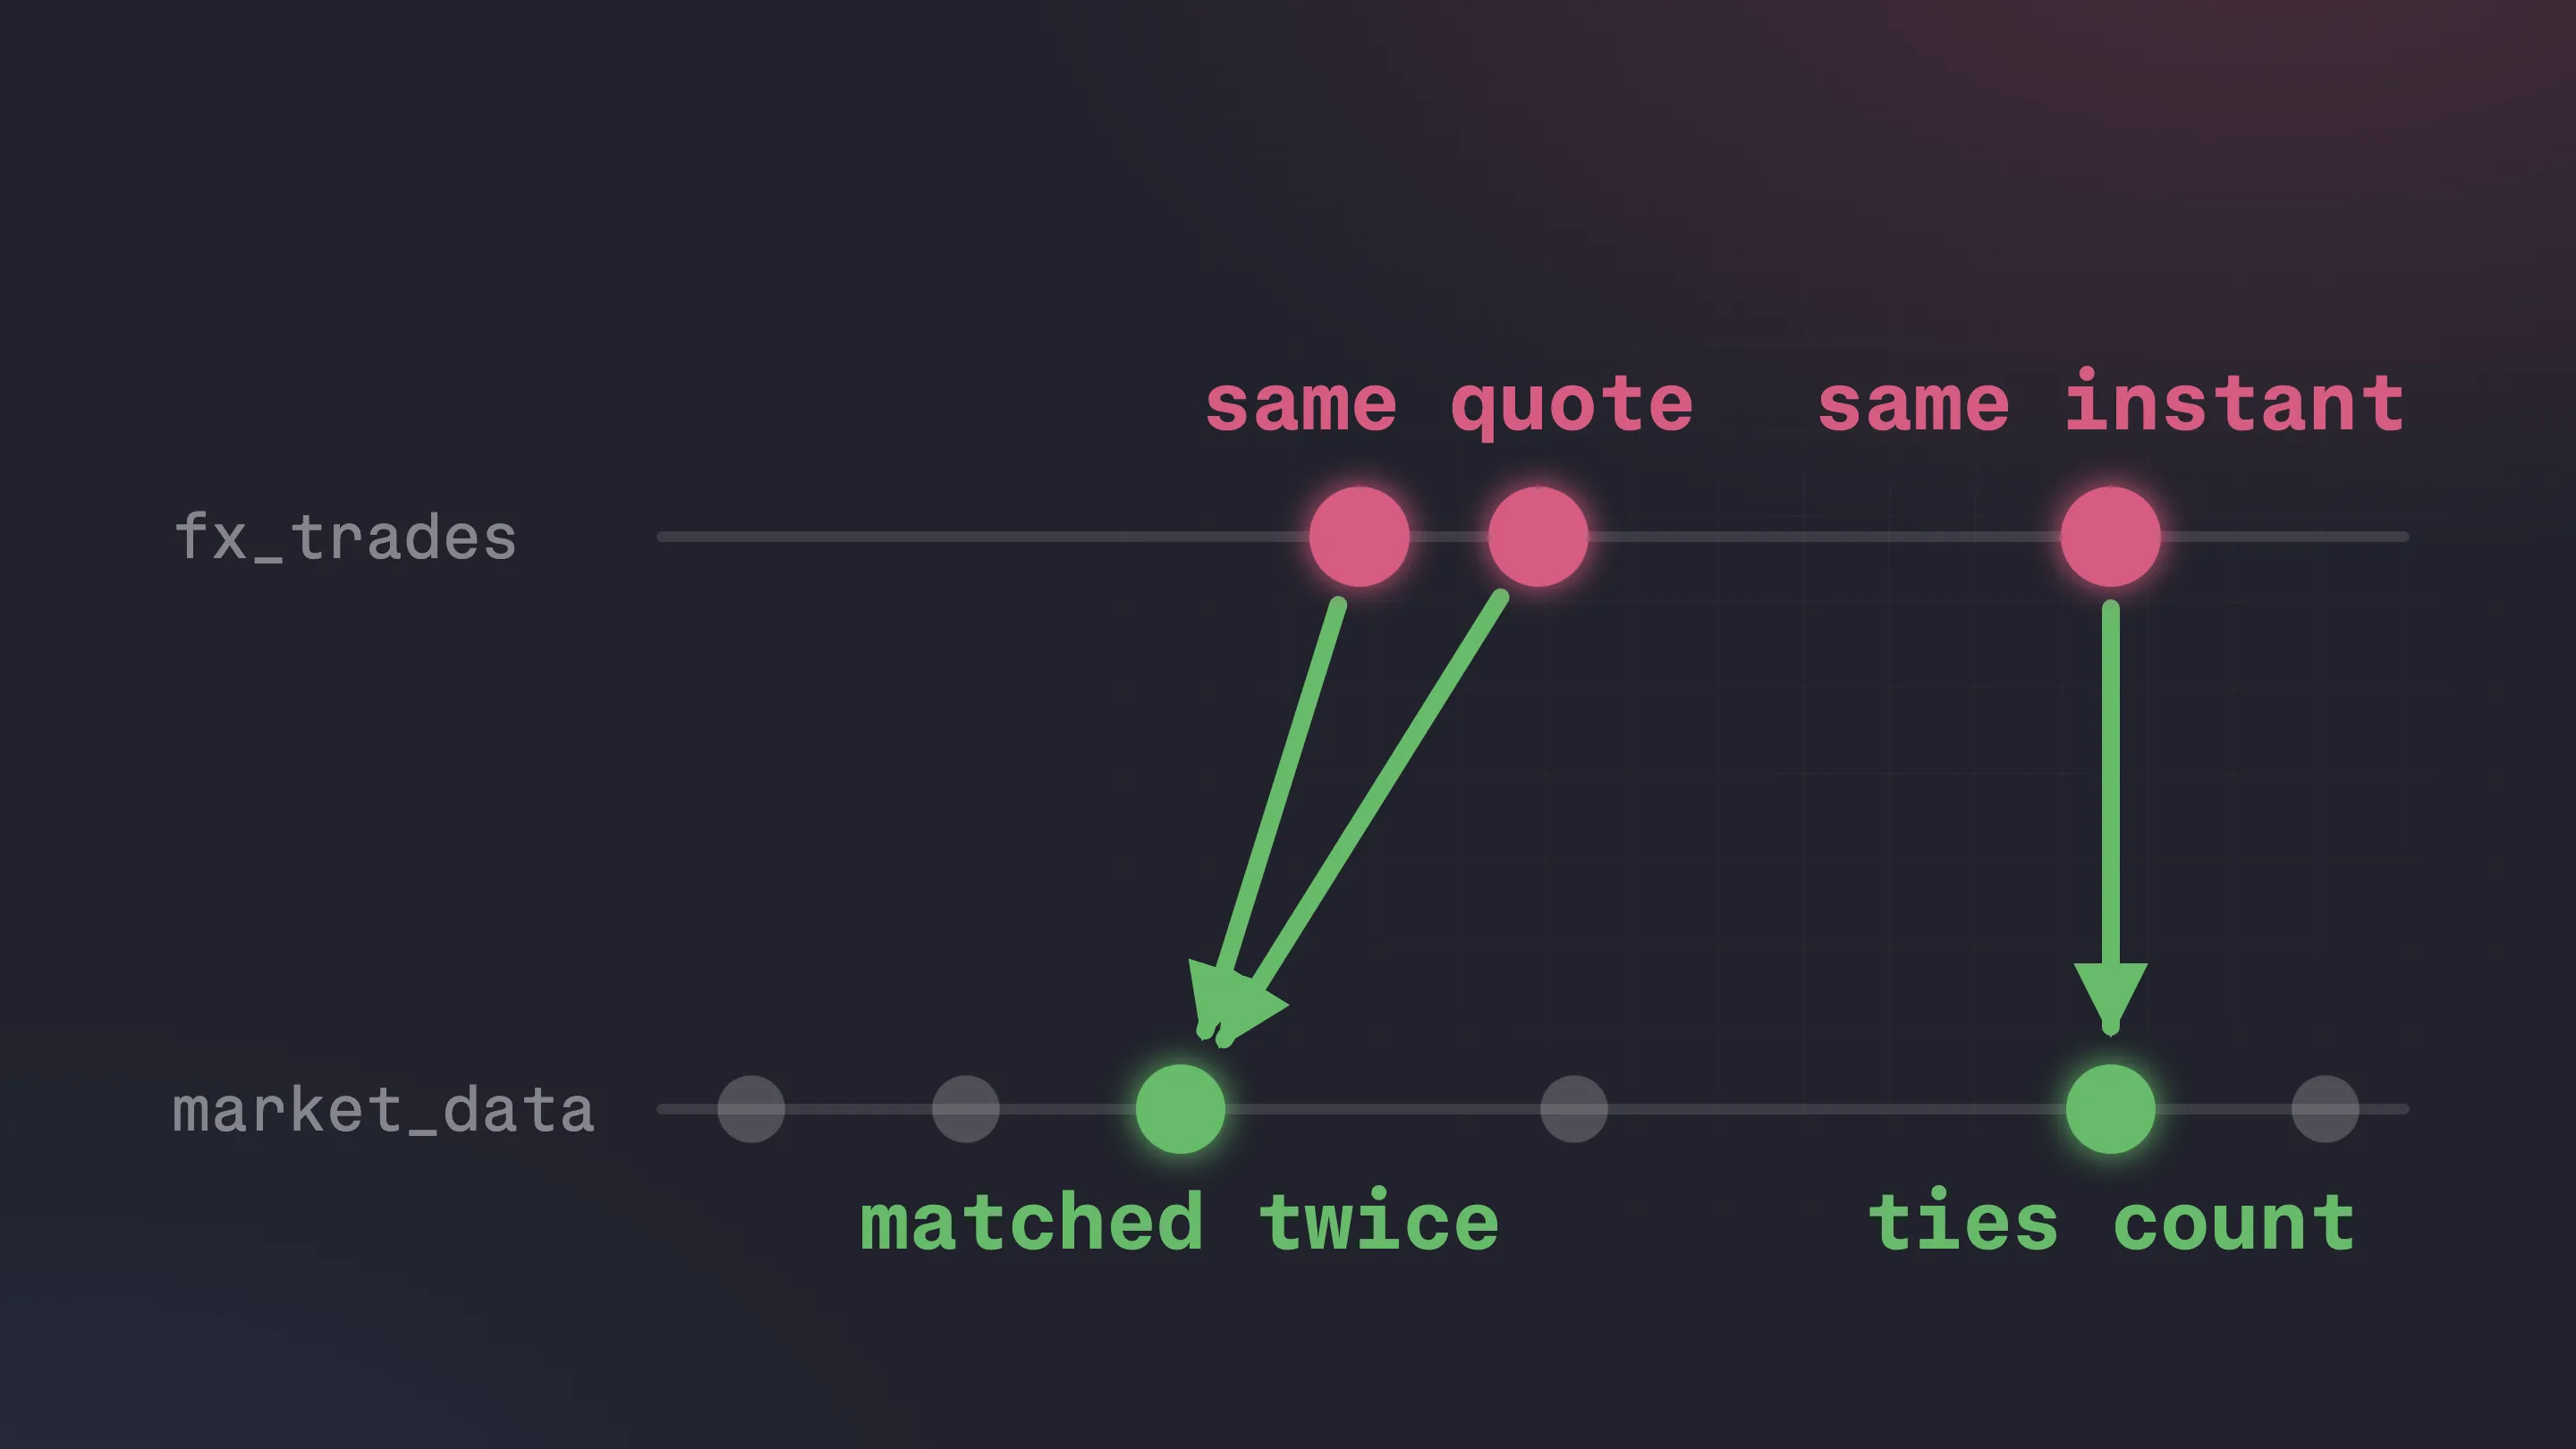
哪种时间序列 join?ASOF、WINDOW、HORIZON、LT 还是 SPLICE

QuestDB 用通俗语言介绍了其五种时间序列 join:ASOF、WINDOW、HORIZON、LT、SPLICE,每种配一条可在在线 demo 直接运行的查询。 内容偏厂商教程,实用价值集中在 QuestDB 用户;对熟悉时序库的人可快速定位 join 语义差异,对非 QuestDB 用户讨论入口较弱。
评论点赞收藏5 天前

DuckLake 与 QuestDB:同一个 Parquet,不同的表格式方案

DuckLake 将表元数据存在 SQL 数据库里而不是 manifest 文件,这篇文章说明这个设计选择带来了什么变化,并给出把 QuestDB 冷存储的 Parquet 注册进 DuckLake 的具体步骤。 适合关注数据湖架构和存储格式互通的技术读者。
评论点赞收藏19 天前

最昂贵的指令可能是 cmov

HotSpot C2 编译器将分支转换为 cmov 指令时,实际测量的是分支偏差而非可预测性。在紧密循环中,这种不匹配可能导致高达 2.9 倍的性能差异。
评论点赞收藏77 天前

Rollup Table(预聚合表)详解

解释时间序列数据库中 Rollup Table 的概念,即预聚合数据以优化查询性能。列举了优缺点及在 QuestDB 中的 SQL 实现示例。属于标准的厂商文档词条,缺乏独立见解或深度工程复盘。
评论点赞收藏81 天前

The mask that compiles to nothing:how HotSpot's JIT learned to reason about bits

文章深入解析了 HotSpot JVM C2 编译器中新增的“已知位(Known Bits)”优化技术。通过追踪整数的每一位状态,编译器能证明某些位运算(如移位后与掩码相与)是冗余的, 从而在生成机器码时直接删除这些指令。 作者结合 JDK 26/27 的代码变更,详细展示了范围分析与位信息如何相互修正以消除无效操作。文中包含具体的代码逻辑、测试用例及汇编对比,揭示了现代编译器底层优化的精妙之处。
评论点赞收藏85 天前

2026 年最佳时序数据库指南及选型建议

这是一篇关于时序数据库选择的指南,对比了 QuestDB、InfluxDB、TimescaleDB、ClickHouse 和 kdb+ 等主流方案。文章核心观点是“最好的数据库取决于你的具体工作负载”,而非单纯罗列排名。
评论点赞收藏85 天前

编译成虚无的面具:HotSpot JIT 如何学会推理比特位

文章深入解析了 HotSpot JVM C2 编译器中新增的“已知位(Known Bits)”优化技术。通过追踪整数的每一位状态,编译器能证明某些位运算(如移位后与掩码相与)是冗余的, 从而在生成机器码时直接删除这些指令。 作者结合 JDK 26/27 的代码变更,详细展示了范围分析与位信息如何相互修正以消除无效操作。文中包含具体的代码逻辑、测试用例及汇编对比,揭示了现代编译器底层优化的精妙之处。
评论点赞收藏86 天前

如何实现并行且向量化窗口连接

QuestDB 团队分享了将窗口连接(Window Join)实现并行化和向量化的工程实践,并与 Timescale、DuckDB、ClickHouse 进行了基准测试对比。 文章提供了具体的性能数据和优化思路。
评论点赞收藏96 天前

Aeron 与 QuestDB:构建资本市场数据的开放基础设施

文章介绍了资本市场的公司如何结合使用 Aeron 高性能传输库和 QuestDB 时序数据库,以实现精确一次语义、确定性回放以及基于开放格式的监管级历史数据存储。 这种组合方案解决了高频交易场景下对低延迟和数据完整性的双重严苛要求,为金融基础设施架构提供了参考案例。
评论点赞收藏117 天前

QuestDB 9.4.0 发布:引入高效 Posting Index 与跨列填充语法

QuestDB 9.4.0 版本发布,引入了针对 SYMBOL 列的新 Posting Index,索引体积缩小 13 倍且查询更快。新增跨列填充语法 FILL(PREV),简化了时间序列数据中的空缺值处理逻辑。 此外还增加了三个标准窗口函数、终端文本可视化功能以及多项性能优化,包括并行分组和哈希连接加速。
评论点赞收藏132 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。