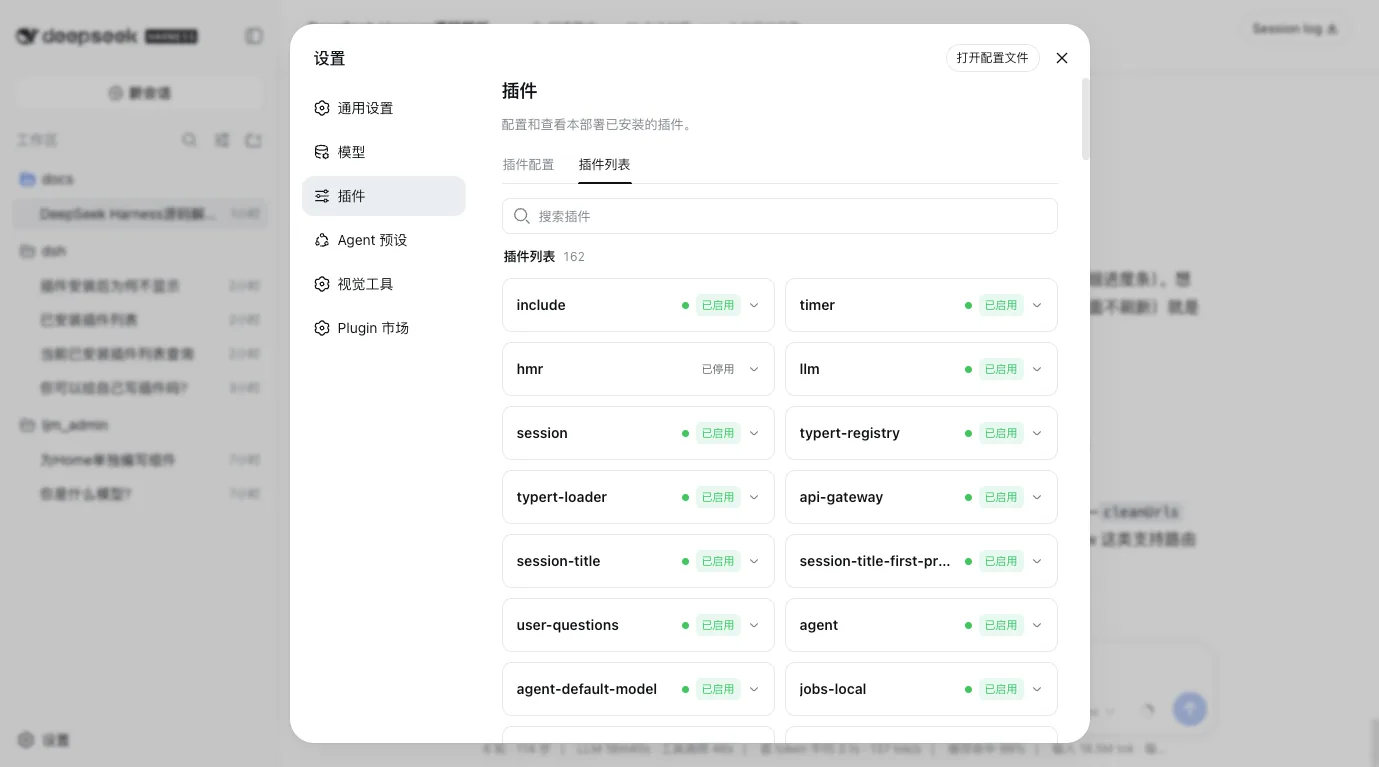
我目前使用的 AI 工具是 Zcode,然后搭配 Opencode Go 套餐里面的 deepseek-v4-flash 模型。性价比很高,速度和模型能力都非常棒,所以被我当成主力模型。 但是它存在一个巨大的问题就是不支持多模态,官网目前好像是支持视觉识别了,但是我是调用了 api 在第三方客户端。而我恰好非常需要这个场景,所以我就想了一个办法,如果能在不更改当前会话模型的情况下,进行图片识别,那...
最近开发内部人员软件项目有个新需求,拿到本机通话记录以及通话录音文件,然后上传到服务器。开始接到这个需求的时候觉得很简单,不就是获取数据,匹配数据,上传数据那一套流程嘛,但是我实际深入进来的时候发现好多坑。由于之前没怎么深入开发过安卓 APP,所以踩了很多坑,也是花了好几天时间加上 AI 分析我才搞定。 就把这几天踩过的坑都记录一下分享出来,下次遇到了可以有效解决,这里只记录思路,具体代码就不赘述...




 评论
 点赞
 收藏