Artificial Analysis

Artificial Analysis,独立 AI 模型性能、速度与价格对比基准测试平台,帮助开发者选择最适合其场景的模型。

GPT-6.1 Sol 在短短 7 天后取代 GPT-6 Sol,具有接近 Astra 的智能

Artificial Analysis 发布 GPT-6.1 Sol 评测:上线 7 天即替换 GPT-6 Sol,价格维持 $2/$10 每百万 token,缓存读取折扣从 90% 升至 95%。 智力指数比 GPT-6 Astra 低 1 分,但每任务成本仅为 Astra 的不到 1/4。相较 GPT-6 Sol,AA-Briefcase 提升 4 分,GDPval-AA 提升 5 分,Terminal-Bench 4.0 提升 12 分,幻觉率从 60% 降至 54%。 编码代理指数在 xhigh 档下比 GPT-6 Astra 高 1 分而成本不到 15%。低、中 effort 档在 token 效率上为帕累托最优。
评论点赞收藏10 小时前

Sonnet 5.5 在 Artificial Analysis 智能指数上仅落后 Opus 5.5 一分

Anthropic 发布 Claude Sonnet 5.5,在 Artificial Analysis 智能指数上以 56 分仅次于 Opus 5.5(满分差距仅 2 分),但单任务输出 token 用量(~193k)为历史最高,成本约为 Sonnet 5 的 1.5 倍。 其终端代理能力大幅提升(Terminal-Bench 4.0 达 64%),但在事实准确性和科学推理上仍落后 Opus。定价与 Sonnet 5 相同($2/$10 per 1M),在智能-成本帕累托前沿上略逊于 GPT-6 系列。
评论点赞收藏1 天前

Artificial Analysis 网络防御指数

Artificial Analysis 发布 Cyber Index,联合 IBM、NVIDIA、Vercel、Collinear AI 等伙伴,用三个基准(CWE-Bench-AA、DeepsecBench-AA、CyberGym-E2E-AA)独立评测模型在"发现漏洞→复现验证→打补丁"完整防御闭环上的能力与成本。 关键发现:CWE 失败中 55% 是只修了主问题留下次级入口的半修补,最强模型的失败里 40% 是过度修补破坏正常功能;DeepsecBench 上最好的模型也仅覆盖 41% 专家验证漏洞,需跨多步推理/业务规则的漏洞很少被发现,但一旦报出准确率约 95%,GPT-6 Sol/Astra 发现率约为普通模型 3-4 倍;CyberGym 上多个前沿模型(GPT-6 Astra、Claude Fable 5.1 等)因安全拒绝率超 98% 导致难以评估,剩余模型 42% 尝试因 90 分钟时限内未找到崩溃输入而失败,31% 的"通过"其实是修了别的更浅层 bug(如空指针)而非目标漏洞。 评测跑在开源 harness Stirrup 上,方法页和各 leaderboard 已公开。
评论点赞收藏2 天前

Mercury 2.5 LLM 达到每秒 770 个 token

Artificial Analysis 发布 Mercury 2.5 LLM 的评测页:输出速度约 770 tokens/s,并给出其在 Artificial Analysis Intelligence Index v4.3.2(含 10 项子评测:AA-Briefcase、GDPval-AA、Terminal-Bench 4.0、SciCode 等)下的得分、成本/任务、上下文窗口、首字延迟等。 页面以指标定义与解释为主,未给出该模型与竞品的直接排名对比数字,信息偏模板化。
评论点赞收藏6 天前

GPT-6 Sol 和 Luna 将成本效率推向新前沿

OpenAI 发布 GPT-6 Sol 和 Luna,定价约为 GPT-5.6 的一半(Sol $2/$10,Luna $0.10/$0.50),在 Artificial Analysis 基准上,二者任务成本下降 50–60%。 Sol 在编码代理指数上提升 2 分(57),成本更低,位于 Pareto 前沿;Luna 则回落 2 分(41),在 SWE-Atlas-QnA 和 DeepSWE 上出现退步。 幻觉率显著降低:Sol 从 92% 降至 60%(通过更多拒答实现),Luna 从 93% 降至 77%。但在经济价值任务 GDPval-AA v2.1 上,Sol 退步约 100 Elo、Luna 约 75 Elo,主要因交付物更短、遗漏评分要素。 AutomationBench 和 Terminal-Bench 4.0 有小幅提升。整体呈现"成本减半、能力持平、幻觉改善、知识工作退步"的混合结果。
评论点赞收藏8 天前

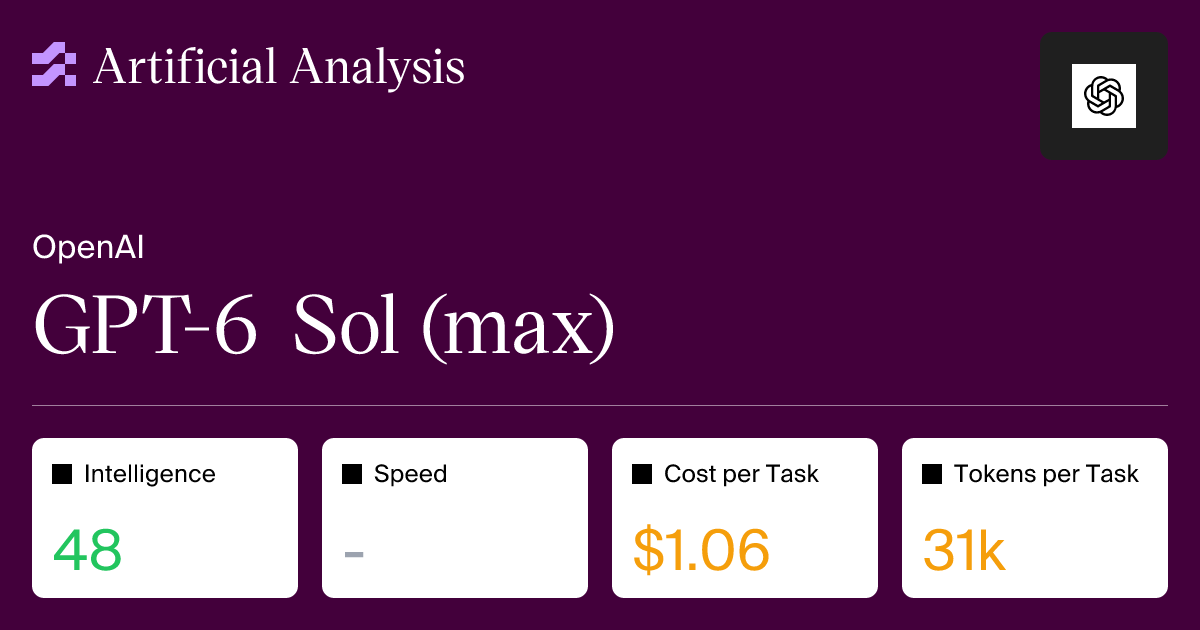
GPT-6 Sol (Max) 智能、性能与价格分析

Artificial Analysis 对 GPT-6 Sol (Max) 的基准评测页面。其智能指数 v4.3.2 综合了 10 项评测(含 AA-Briefcase、Terminal-Bench、SciCode、Humanity's Last Exam 等)。 页面提供智能指数、能力指数(agentic 知识工作、SaaS 流程、编码/终端、医学长上下文)、AA-Omniscience 幻觉/可靠性指标,以及成本相关数据(每任务成本、总评测成本、缓存/输入/输出价格、输出 token 数、上下文窗口)。 没有给出具体分数或排名,主要是评测框架与指标说明。
评论点赞收藏8 天前

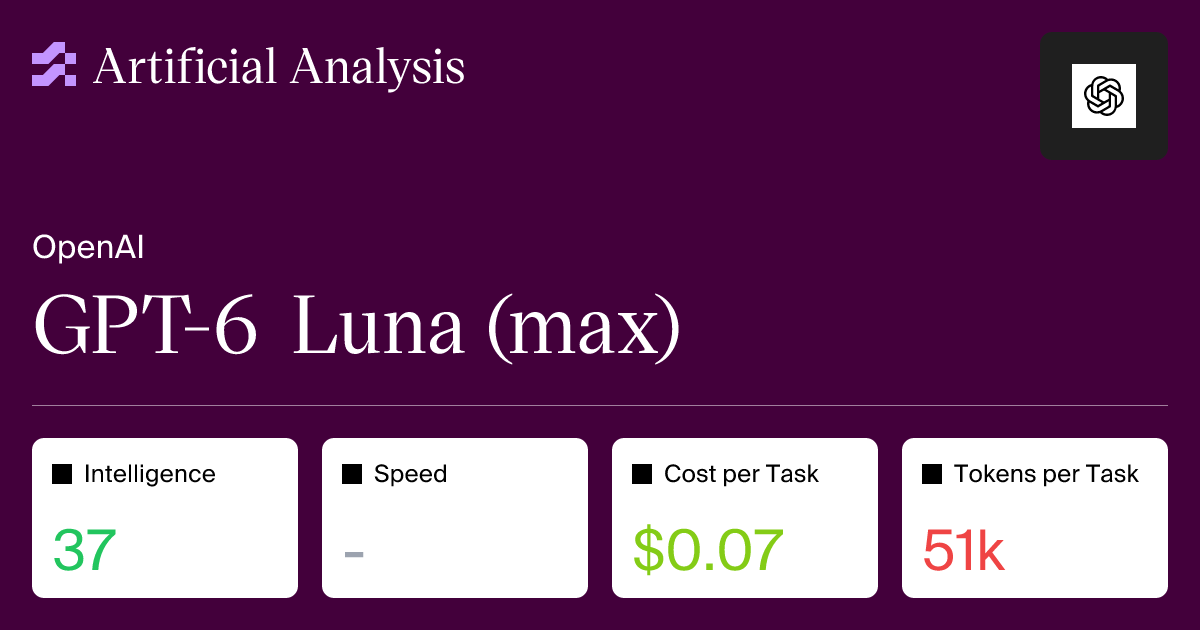
GPT-6 Luna(Max)智能、性能与价格分析

Artificial Analysis 发布 GPT-6 Luna(Max)模型的评测数据页,涵盖其 Intelligence Index v4.3.2 综合得分、各子项基准(AA-Briefcase、GDPval-AA、Terminal-Bench 4.0、SciCode 等 10 项)、成本结构(按 token 类型拆分的每任务成本)、输出 token 用量及上下文窗口等。 页面以结构化指标展示为主,缺乏作者观点或深度解读,内容存在重复描述段落,定位为模型参数与基准成绩速查页。
评论点赞收藏8 天前

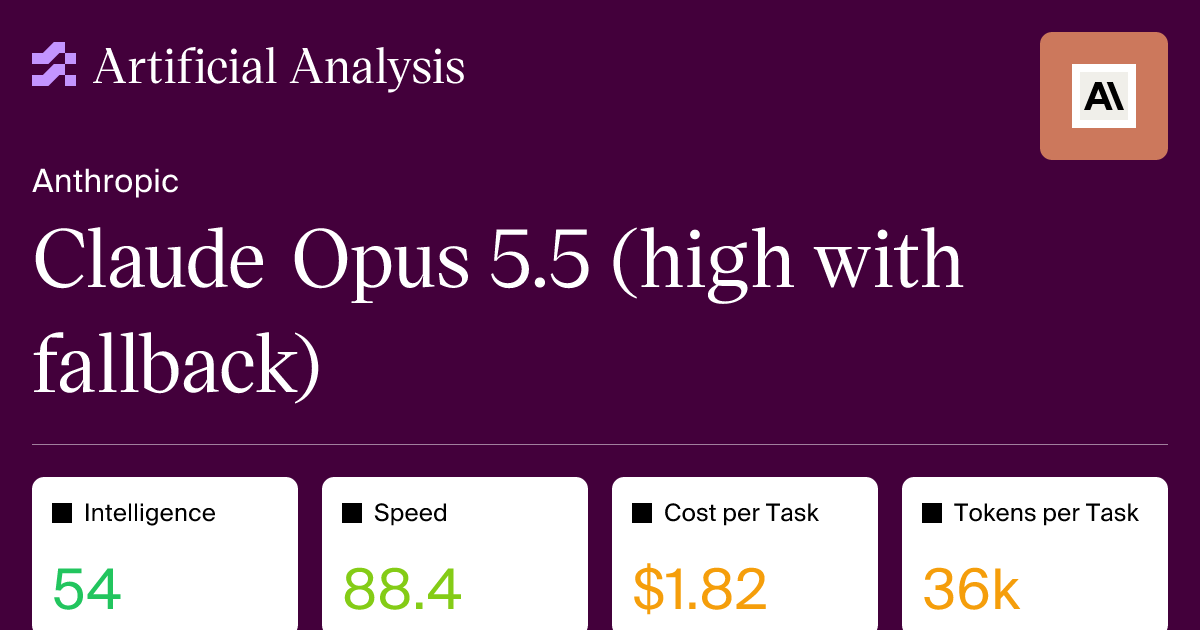
Claude Opus 5.5(高投入)智能、性能与价格分析

Artificial Analysis 对 Claude Opus 5.5(High Effort 模式)的评测页,覆盖其 Artificial Analysis Intelligence Index v4.3.2 得分(10 项子评测)、能力分项、成本/任务、token 用量、上下文窗口、输出速度与延迟等。 内容以指标定义与图表为主,未给出与同档模型的具体对比结论或价格判断,信息增量有限。
评论点赞收藏8 天前

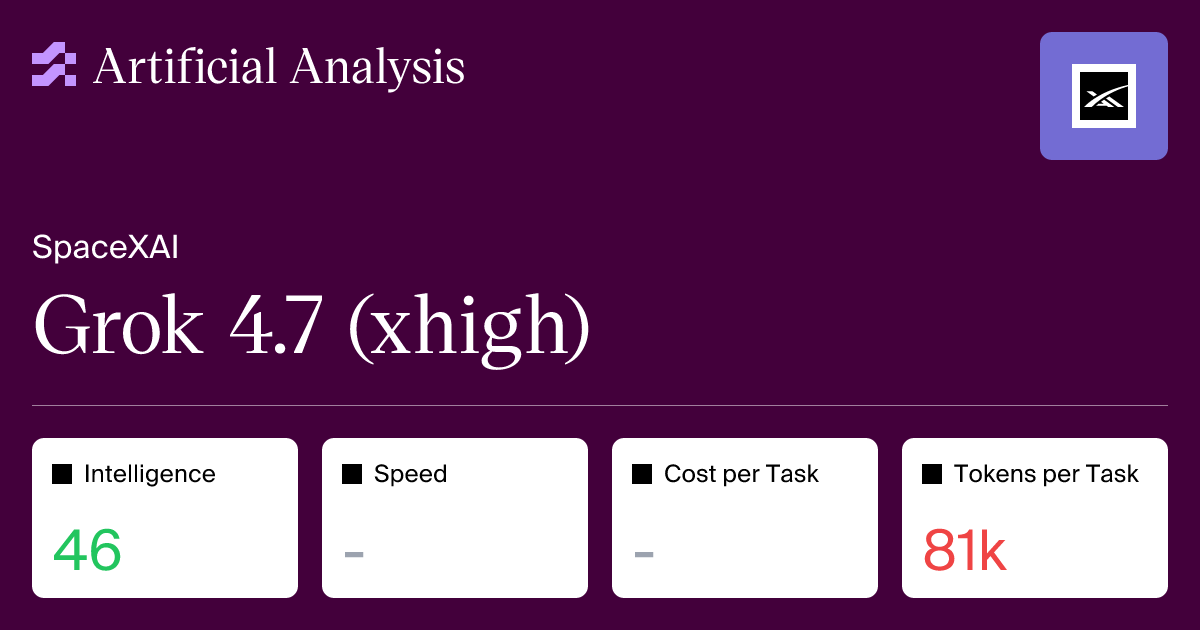
Grok 4.7 在 AI 智能指数上得分 46,SpaceXAI 跻身前四大 AI 实验室

Artificial Analysis 对 Grok 4.7(xhigh)进行基准测试:智能指数 46 分(+2),在 agentic 知识工作上 Elo 升至 1657,接近 Claude Opus 5 和 Fable 5.1 水平;编程代理指数从 47 升至 56,超过 GPT-5.6 Sol,在自家 harness 下排第四。 Token 用量明显增加(81k vs 36k),幻觉率从 34% 降至 29%。上下文 500k,定价不变。整体来看,Grok 4.7 在 agentic 任务和编码方面有显著提升,其他子任务多为小幅波动。
评论点赞收藏8 天前

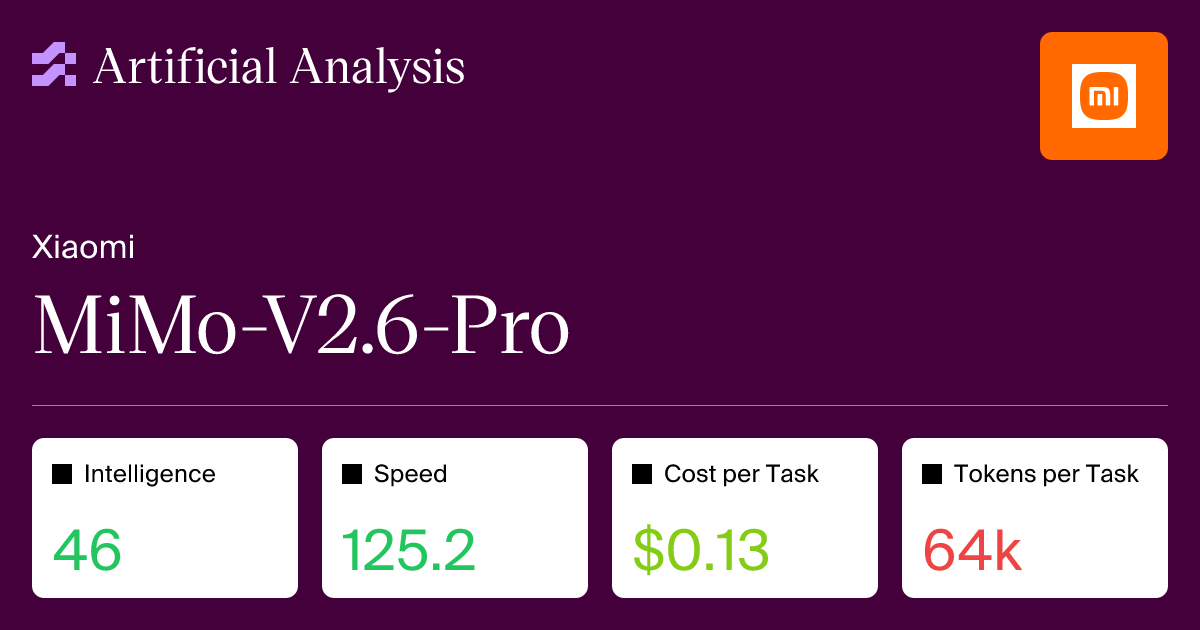
MiMo-v2.6-Pro:智能、性能与价格分析

Artificial Analysis 更新 MiMo-v2.6-Pro 的模型画像:智能指数 v4.3.2 覆盖 10 项评测(含 AA-Briefcase、GDPval-AA、Terminal-Bench 4.0、SciCode、Humanity's Last Exam、AA-Omniscience 等),同时给出能力分项、开源程度、成本、输出速度、首 token 延迟、端到端响应时间与上下文窗口等指标。 MiMo 由小米/自研团队发布,定位开放权重模型,本文主要提供其在 Artificial Analysis 平台上的标准化评分与价格/性能定位,适合需要快速对比开放模型性价比的读者。 内容偏数据面板,缺乏深度分析或个人观点。
评论点赞收藏8 天前

Grok 4.7 智能、性能与价格分析

Artificial Analysis 对 Grok 4.7 进行了多维度评测,基于其 Intelligence Index v4.3.2,涵盖 10 项基准测试(包括 AA-Briefcase、GDPval-AA、Terminal-Bench 4.0、Humanity's Last Exam 等)。 核心关注点包括:模型在 agentic 知识工作、编码、长上下文推理和医疗推理等任务上的表现;输出 token 用量;以及按输入/缓存/输出 token 价格加权的单任务成本。 文章以图表形式展示了成本-智能效率曲线、Pareto 前沿定位,以及不同 token 类型的定价明细。整体为评测数据页面的结构化呈现,缺乏独立观点或争议性结论。
评论点赞收藏9 天前

DeepSeek v4.1 Flash 基准评测与参数全览

Artificial Analysis 更新了 DeepSeek v4.1 Flash 的基准评测数据,覆盖 10 项评测的综合智能指数,以及 AGENT 工作流、代码、文档推理、知识可靠性等分项指标。 页面同时列出了缓存命中率、输入输出价格、上下文窗口、首 token 延迟、端到端响应时间等关键参数,并标注了性价比最优象限。
评论点赞收藏20 天前

Artificial Analysis 智能指数 v4.3 发布:GPT-6 Astra 与 Claude Fable 5.1 并列榜首

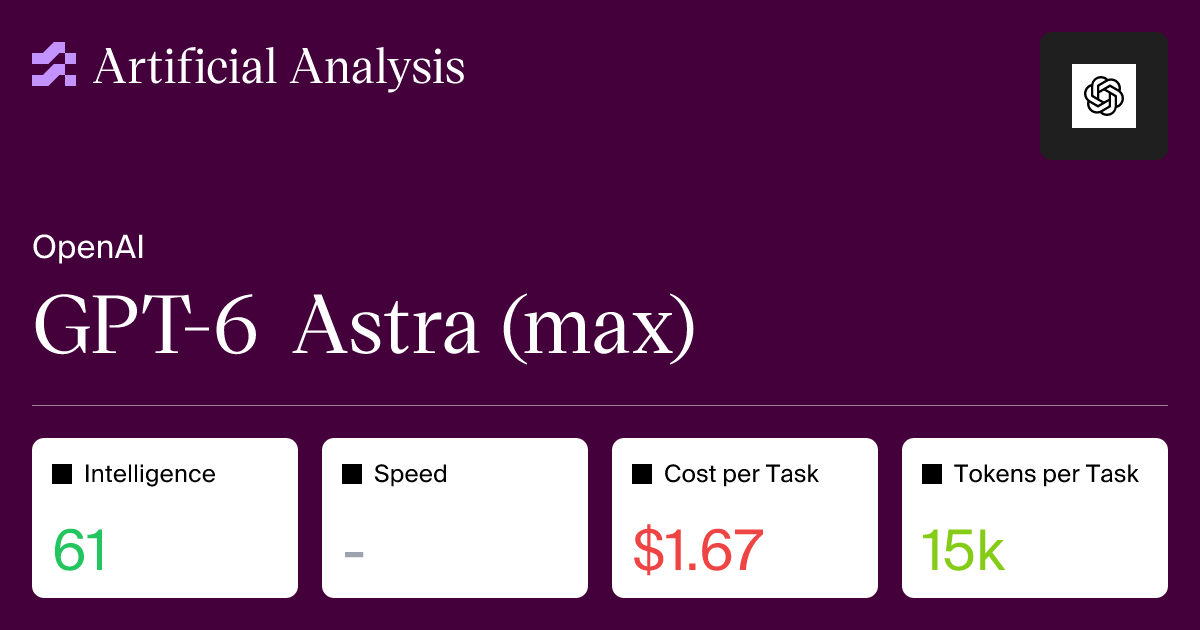
Claude Fable 5.1 和 GPT-6 Astra 在 Intelligence Index v4.3 上并列第一,得分均为 53。GPT-6 Astra 单任务成本比 Fable 5.1 低 57%(3.26 美元 vs 7.63 美元)。 开源模型方面,GLM-5.3 Flash(42 分)位居第三,Qwen3.8 和 DeepSeek V4 Pro 紧随其后。本次更新将 Terminal-Bench 从 v2.1 升级至 v4.0,并用 AutomationBench-AA 替换了 τ³-Banking,新增 657 个 Zapier 商业工作流测试任务,私有测试集权重从 40% 提升至 45%。
评论点赞收藏23 天前

Artificial Analysis 基准测试 v4.2:Claude Fable 5.1 登顶,GPT-6 Astra 效率领先

Artificial Analysis 发布 Intelligence Index v4.2 基准测试更新,Claude Fable 5.1 登顶,GPT-6 Astra 紧随其后。新增 AA-Briefcase(代理知识工作评估)和 GDP.pdf(4592页PDF长文档推理)两个私有测试集,GPQA Diamond 因饱和被移除。 GPT-6 Astra 在输出 token 效率上领先,成本前沿由 Anthropic、OpenAI、Meta、 四家共享。
评论点赞收藏25 天前

Muse Spark 1.3 在 Artificial Analysis 智能指数中排名第三

Artificial Analysis 发布了 Intelligence Index v4.1.1 的模型排名,Muse Spark 1.3 位列第三。该指数综合 GDPval-AA v2、Terminal-Bench v2.1、SciCode、Humanity's Last Exam、GPQA Diamond 等 9 项评测。 页面同时提供各模型的成本、速度、开放度等多维度对比数据。
评论点赞收藏26 天前

GPT-6 在 Artificial Analysis 智能指数上落后 Anthropic

Artificial Analysis 发布 GPT-6 的基准测试数据,GPT-6 在 Intelligence Index v4.1.1 的 9 项评测中综合得分低于 Anthropic 同期模型。 评测涵盖 GDPval-AA v2、Terminal-Bench v2.1、SciCode、Humanity's Last Exam、GPQA Diamond 等。页面同时提供每项任务的加权平均成本、输出 token 用量、上下文窗口等维度的对比数据。
评论点赞收藏26 天前

Google 发布 Gemini 3.8 Flash:基准测试更新

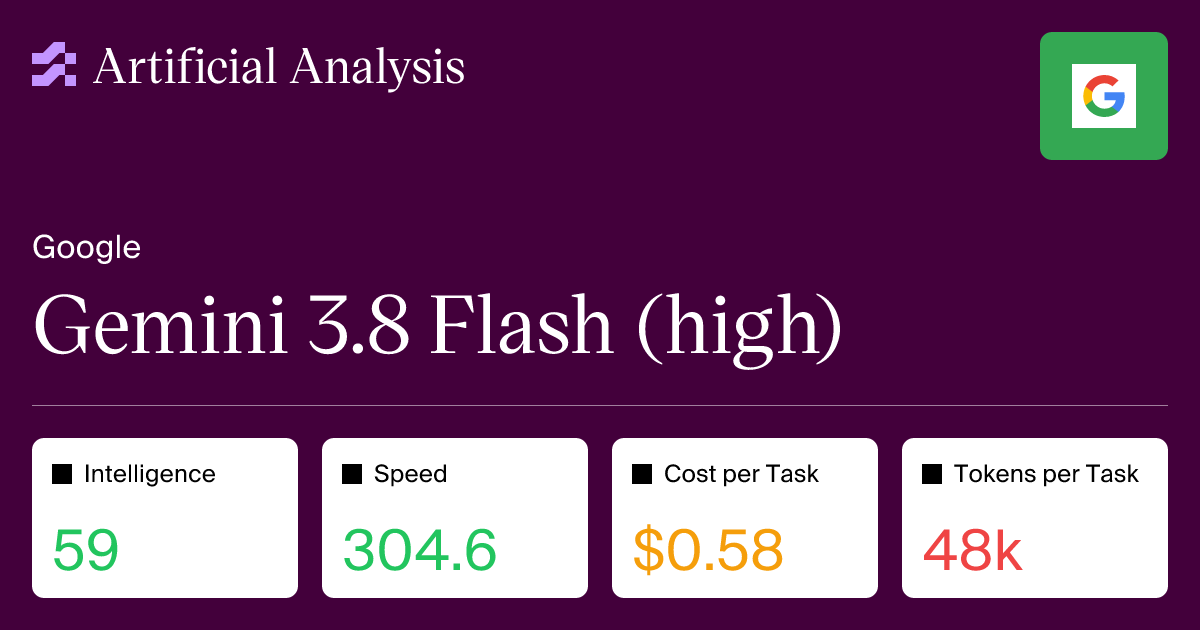
Google DeepMind 发布 Gemini 3.8 Flash,Artificial Analysis 智能指数 59 分,较 3.7 Flash 提升 3 分。定价维持 $0.75/$3.75 每百万 token 至年底,但单次任务成本因输出 token 增加 30% 而上涨约 40%。 智能提升主要来自 agentic 任务表现,τ³-Banking 工具使用提升 12 分。提供高/中/低三种推理级别,低推理级别单次任务成本仅 $0.24,耗时 0.8 分钟。
评论点赞收藏27 天前

Muse Spark 1.3 智能、性能与价格基准分析

Artificial Analysis 发布 Muse Spark 1.3 的多维基准测试数据,覆盖 Intelligence Index v4.1.1(含 GDPval、Terminal-Bench、GPQA Diamond 等 9 项评测)、单位任务成本、输出速度、首 token 延迟及上下文窗口。 数据按开源/闭源分组,提供成本-性能 Pareto 前沿图,适合模型选型时横向对比。
评论点赞收藏27 天前

Gemini 3.8 Flash 智能、性能与价格分析

Artificial Analysis 发布 Gemini 3.8 Flash 的基准测试数据,涵盖智能指数、单次任务成本、输出速度、延迟和上下文窗口等维度。 该页面提供多模型横向对比,适合需要选型参考的工程团队。
评论点赞收藏28 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。