坏代码像葛藤:一旦种下就难以清除代码一旦加进项目就很难删掉,因为人会不断在上面叠加新功能。作者建议每次加功能时就要想好怎么删,并在博客实测:加了 hashtag 气泡功能几个月后发现几乎没人用,果断删掉。 AI 时代更容易堆代码,更要把删除复杂度当成日常任务。 评论点赞收藏29 天前
写给活人看AI生成的PR标题和描述越来越难读,技术黑话加上机器生成的长解释让代码库导航变成徒劳。"Bumped dependencies"比"Performed a scheduled dependency refresh as part of ongoing maintenance practices..."好得多。 写给人看,不是给机器看。 评论点赞收藏49 天前
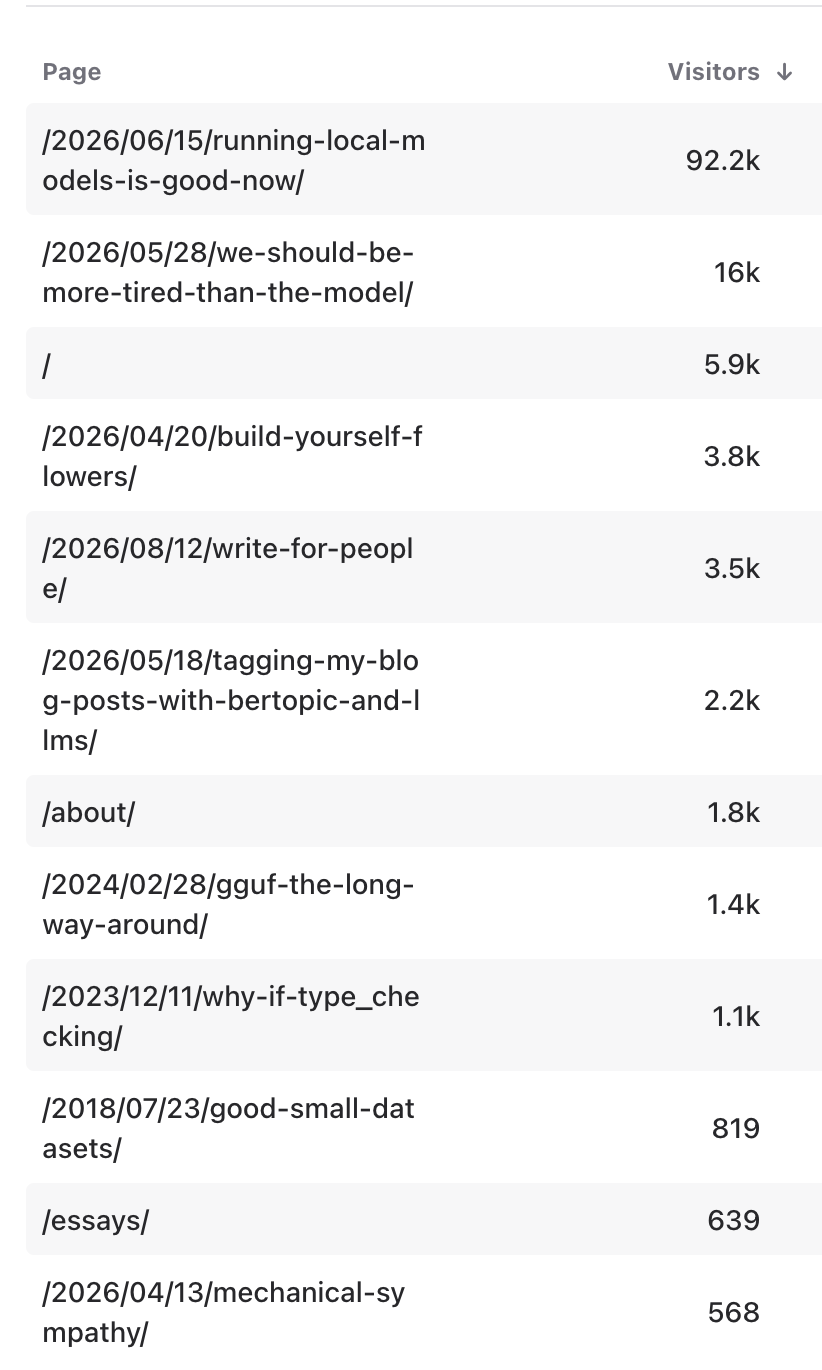
本地模型现在真的很好用了<p>自从本地模型问世以来,我一直在使用它们1。如今,这些模型的表现竟然出人意料地出色。</p><p>我有一台2022款的Mac M2,配备64GB内存和1TB存储空间。我曾多次使用</p><p>• </p><p>• </p><p>• </p><p>• ,以及许多其他Qwen变体,比如</p><p>在各种不同的系统配置中进行测试,例如</p><p>• 原始的Llama CPP,搭配</p><p>• Llama-CPP-Python</p><p>• Ollama</p><p>• LLAMAFILES</p><p>• LM Studio</p><p>本地模型如今何去何从?</p><p>早期,本地模型运行缓慢、使用不便,而且在大多数编程任务上也谈不上多么精准。 直到我接触到GPT-OSS,人们普遍认为本地模型落后严重的想法才逐渐被打破。 不过,我并没有确凿的科学证据来佐证这一点——我个人对“一个模型是否足够好”的判断标准是: “我是否需要再用API模型来验证一遍? ”而GPT-OSS正是我开始少用这种验证方式的第一个模型。</p><p>因此,目前我更多地将本地模型用于快速、个性化的开发需求,尤其是那些不需要实时更新的项目。对于这类任务,我更倾向于使用本地模型,而不是依赖云端的大型预训练模型。</p><p>然而,随着谷歌最新发布的系列模型,我终于得以在本地实现代理式编程,并且让循环的运行精度和速度达到了前沿模型的约75%水平——这简直令人惊叹!</p><p>截至目前,我主要…</p> 评论点赞收藏107 天前
我们应该比模型更累。<p>最近,我总觉得在与代理式代码生成协作时,自己对所编写的代码逐渐失去了掌控力。</p><p>当我完成一次代理式编程会话后,虽然表面上看起来像是写出了代码,却完全忽略了那些在我们手工编写代码时才会发生的内在过程——比如那些由手写代码所带来的种种细节与流程。</p><p>简单来说,人类大脑拥有多种记忆类型:短期记忆、工作记忆和长期记忆。 短期记忆能够暂时储存信息并快速处理这些信息,就像RAM一样。 而长期记忆则包括你之前学过、早已深藏于心底的知识,比如数据库中的数据存储。 工作记忆则从短期记忆和长期记忆中提取信息,并将它们加以整合、加工,从而综合出解决方案或对信息进行深入分析与处理。</p><p>当我们着手编写代码时(这里的“着手”指的是大多数情况下阅读他人的代码),这些过程都会在我们的大脑中同时展开,以帮助我们更好地理解并适应编程环境。</p><p>这其实并不令人意外:默认模式下的代码生成,往往与技能的持续积累背道而驰——尤其是因为它的用户体验设计, 与老虎机如出一辙:你拉一下杠杆,就能获得一份奖励(即解决你的编程问题的方案)。 某种程度上,我们已经用一串串标记取代了社交媒体的动态流; 而我期待着十年后的某一天,能再次研读那些论文。</p><p>要真正从单纯地生成答案,转变为有意识地运用工具,需要付出额外的努力。 有一次我在X平台上发帖,有人建议我:“如果你觉得在一次代理式编程会话后头脑一片昏沉, 那很可能是因为你自己动手改写了部分代码。 ”</p><p>受到这一建议…</p> 评论点赞收藏125 天前
用BERTopic和LLM给我的博客文章打标签作者详细记录了使用BERTopic结合多种LLM工具(Claude Code, Pi, Deepseek等)为博客自动打标签的工程实践。文章不仅包含具体的技术实现细节(从LDA到Embedding再到BERTopic的演进),还深入探讨了LLM在压缩而非生成方面的潜力、标签系统的历史演变以及个人项目中的UX思考。 这是一篇典型的Hacker News风格深度技术复盘,兼具工程细节与行业洞察。 评论点赞收藏135 天前
为自己种花:在AI时代重寻机器学习工程师的工匠精神作者以荷兰黄金时代花卉画家Rachel Ruysch为隐喻,探讨在LLM生成代码普及的今天,传统机器学习工程师为何仍需追求技术卓越与工匠精神。 文章结合其构建语义搜索引擎Rijksearch的个人实战经验,详细拆解了数据清洗、Embedding模型选择、Redis Vector Sets索引及Go语言服务搭建中的具体决策与踩坑过程,强调数据直觉(Data Sense)、刻意练习和长期积累的重要性,反对过度依赖AI导致的工程能力退化。 评论点赞收藏163 天前
机械同情:为何优秀的工程师也是出色的产品设计者作者结合Don Norman的产品设计理论与软件工程中的机械同情概念,指出优秀工程师具备理解代码与产品边界的能力。文章批评当前AI编程代理缺乏这种同情心,列举了其在测试修复、类型使用、依赖管理等具体场景中的失败案例,强调人类积累的上下文直觉是AI难以替代的。 评论点赞收藏170 天前
论编程之乐与Octocat作者借GitHub频繁宕机之机,回顾了过去互联网初创时期的纯真与趣味,以Octocat生成器为例,感叹如今在裁员、AI焦虑和增长导向下,那种无实用目的的 whimsy 已难生存,虽对Claude Code的小趣味感到欣慰,但仍怀念那个充满编程快乐的时代。 评论点赞收藏177 天前
NASA报告揭示工程卓越的核心要素与失败根源作者分享NASA 2012年发布的《工程卓越要素》报告,指出NASA失败的五大根源,包括从亲手工程转向监督、偏差正常化、缺乏批判性思维、权力下放及复杂性。 作者特别强调第一点:工程师失去对设计和硬件的亲手经验,导致技术敏锐度下降,并引用书籍说明保持一线工程文化的重要性,认为需重建基于亲手工作的技术卓越文化。 评论点赞收藏178 天前
给开发者的解药:在效率至上的时代重拾构建的乐趣作者针对当下开发者因追求效率而产生的职业倦怠,提出“慢下来”的建议。文章鼓励工程师回归构建的乐趣,通过阅读纸质书、手写代码、深入理解底层原理(如Transformer架构)以及参与社区互动来重获掌控感,强调过程本身的价值。 评论点赞收藏210 天前
查询30亿向量:从工程实践到需求定义的反思作者受Jeff Dean关于查询30亿向量的讨论启发,尝试实现最优Map-Reduce方案。文章记录了从朴素实现到向量化优化的过程,揭示了内存溢出和性能瓶颈。 最终指出,面对大规模向量搜索,明确需求(如ANN、压缩、硬件限制)比单纯的技术实现更难。 评论点赞收藏221 天前
2025年度最爱书单:为什么程序员该多读小说?知名技术博主 Vicki Boykis 分享其2025年最爱的五本书,包括小说和非虚构作品。作者提出一个反直觉观点:做代码的人应该多读小说而非非虚构,以打破灵感枯竭。 书单涵盖存在主义科幻、经典中篇、俄罗斯政治报道、爱尔兰文学及悬疑小说,每本都带有强烈的社会批判或哲学思考。文章体现了浓厚的人文关怀和个人阅读体验,适合喜欢深度阅读和技术人文交叉领域的读者。 评论点赞收藏278 天前
部署的仪式:工程师面对不确定性的心理博弈作者将软件生产环境部署比作古代航海和太空探索中的仪式与迷信,探讨了工程师在面对不确定性时的心理状态。文章指出,尽管拥有现代技术,但在上线那一刻,开发者仍会遵循各种潜规则和心理安慰行为,因为生产环境充满了不可控的人为和技术风险。 这是一篇关于软件工程文化、心理和不确定性的深度反思。 评论点赞收藏282 天前
2025回顾:在生产的黑暗中点亮火炬作者以《地穴》隐喻生产环境开发的黑暗与恐惧,通过从零构建一个Tokenizer服务的具体案例,详细拆解了从单一方法到完整微服务架构中遇到的无数边缘情况、工程决策及调试过程。 文章强调软件是随时间演进的,并在黑暗中通过日志和测试点亮路径,最终在年底完成系统硬化。 评论点赞收藏282 天前
我想看到狮子的利爪:在AI时代重拾软件工程的匠心作者Vicki Boykis通过个人职业经历,探讨了软件工程中“匠心”与“平庸”的区别。她批评了当前由AI生成的代码带来的普遍平庸化趋势,强调了对代码质量、正确性及开发者关怀的追求。 文章引用Redis、cURL等优秀案例,呼吁开发者重视技艺精进,反对被AI生成的CRUD垃圾淹没,主张在技术世界中寻找并珍视人类智慧留下的卓越印记。 评论点赞收藏345 天前
“漫步应用”:一种对抗软件熵增的日常工程心态作者提出构建AI应用时需每日进行“漫步应用”式的测试,不仅检查功能,更要关注UI细节、性能及代码维护性中的“破窗效应”。这是一种强调日常习惯和整体体验的工程心态,而非传统的QA流程。 评论点赞收藏386 天前
什么是Embeddings?一份给工程师和产品经理的基础指南作者Vicki Boykis针对Embeddings概念缺乏通俗且深入的技术入门资料的问题,撰写了一份PDF指南。文章以毕加索早期绘画需掌握传统技法为类比,阐述理解机器学习基础概念的重要性。 内容旨在为非纯学术背景的工程师、产品经理和学生提供关于向量在推荐系统和NLP中应用的清晰工程与业务视角,强调建立正确的概念模型以打破大模型的黑盒性质。 评论点赞收藏393 天前
现在的嵌入向量有多大?背后的原因是什么作者回顾并分析了嵌入向量维度从早期的300维发展到如今4096维甚至更高的原因。文章梳理了从Word2Vec、BERT到GPT-3及现代大模型的演进历程,探讨了GPU优化、开源社区标准化、API商业化以及向量数据库普及对嵌入尺寸选择的影响。 同时提及了Matryoshka表示学习等新技术,旨在解释工业界在召回率、精度与硬件成本之间的权衡。 评论点赞收藏394 天前
使用 Lunr.js 为 Hugo 静态站点启用搜索功能作者介绍了如何在基于 Hugo 的静态博客中集成 Lunr.js 实现站内搜索。文章分享了利用 Claude 生成 Python 脚本构建索引、在 GitHub Actions 中自动化流程以及前端渲染的技术细节,并探讨了 LLM 在小功能开发中的实际应用场景。 评论点赞收藏418 天前
AI我最喜欢的用途:写日志作者深入分析了PyCharm中Full Line Code Completion插件的技术实现,探讨了JetBrains如何通过训练小型本地模型(基于Llama2架构,量化至INT8)来优化代码补全体验。 文章详细拆解了从数据清洗、Tokenizer设计到Beam Search推理的工程细节,指出在特定垂直场景下,小而精的本地模型比通用大模型更具实用价值,为开发者提供了关于AI工程化落地的深刻洞察。 评论点赞收藏441 天前
你的样本量应该有多大?文章通过一个虚构的“治疗嗜睡症山羊”的创业公司案例,探讨了在大数据背景下如何确定合适的样本量。作者引用Hadley Wickham的观点,指出许多大数据问题本质上是小数据问题。 文中详细解释了置信水平、误差范围等统计概念,并提供了使用Python和在线工具计算样本量的具体方法,旨在帮助数据科学家在计算资源有限或处理速度受限的情况下,高效地进行数据采样和分析。 评论点赞收藏490 天前


 评论
 点赞
 收藏
