Planetscale

PlanetScale,全球最快、最具扩展能力的云数据库平台,基于 Vitess 与 PostgreSQL 构建,适用于现代高增长应用。

TIN:Postgres 的全文文本索引扩展

PlanetScale 发布 Postgres 全文检索扩展 TIN(Text INdex),GA 可用。它支持布尔、短语、span、模糊、通配、正则、大小写/变音折叠,以及 COUNT(*) 和 BM25 top-k,同时兼容 join、复杂 WHERE、连续更新、复制、备份与 MVCC 事务可见性。 基准测试基于 AWS i7i.8xlarge、Postgres 18.6、85GB Stack Exchange 问答语料,对比 ParadeDB、pg_textsearch、GIN:TIN 在多种场景 QPS 至少 8 倍领先,p99 延迟大幅下降,且索引更小(50.7GB vs GIN 28GB 但建索引时间 8 分钟 vs GIN 2 小时+)、并发更新下吞吐更高。 技术亮点:直接用 Postgres ctid 作为文档标识,避免 segment 内 doc id 到 ctid 的映射;两级 bitmap(页号 + 页内偏移)让 postings 高度压缩;每页 256-bit 页号 bitmap 可一次放入 AVX2 寄存器,交并查只需 AND/OR/POPCNT;查询结果天然按 heap 物理顺序返回,减少随机 I/O;MVCC 可见性通过 heap 检查完成。 作者强调这是解决 Postgres 全文检索长期短板的一手工程实践,性能数据与架构解释都较为详细,适合有数据库/检索引擎背景的读者。
评论点赞收藏13 天前

512分片每秒1.185亿查询:Neki分布式数据库线性扩展实测

PlanetScale的Neki用512分片、1.22 PiB数据跑出每秒1.185亿查询。 从5分片到50分片再到512分片,每分片QPS从20万稳定到23万,近线性扩展。 硬件用了512台r8g.16xlarge跑Postgres主节点+480台8xlarge跑路由器,p99延迟6ms(路由器侧)/14ms(客户端),错误率约1/180万,网络吞吐超过2Tb/s。 纯读场景、无副本、未做故障切换,官方预告后续发工程细节文章。
评论点赞收藏18 天前

PlanetScale 推出 Neki:基于真实 Postgres 的分库分表方案

PlanetScale 发布 Neki 平台预览版,为 Postgres 提供原生分库分表能力。每个分片运行真实 Postgres,不修改存储引擎,保留扩展和 SQL 支持。 架构包含路由器(解析查询并路由到各分片)、分片组、边车连接池和控制中心,通过 JSON 拓扑配置表与物理分片的映射。 支持在线 DDL、零停机升级、自动故障切换,未分片也可单独使用以获得更好的连接管理和运维能力。 目前为预览阶段,不建议上生产。
评论点赞收藏19 天前

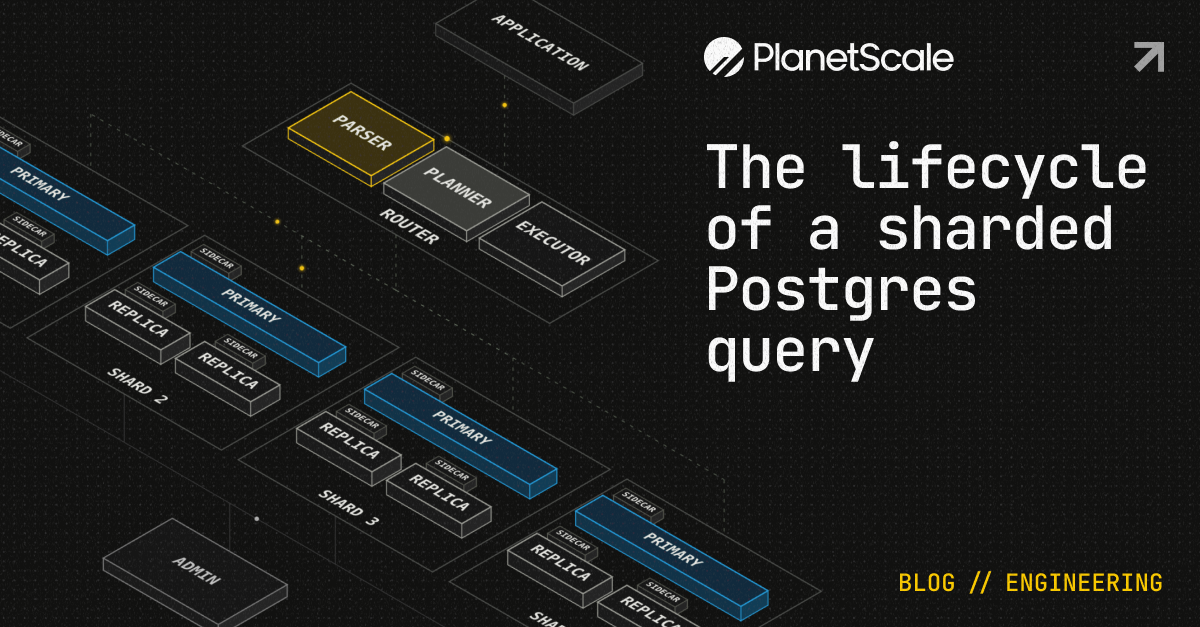
一个分片 Postgres 查询的生命周期

PlanetScale 的 Neki 分片 Postgres 系统展示了查询如何从认证、协议解析到分布式规划的全流程。系统自建了完整的 SCRAM-SHA-256 认证、Simple 和 Extended 两种 wire protocol、约 18,000 行 Go 实现的 parser(性能对标 C 版本)。 查询规划层通过数据拓扑(xxhash 分片)和语义分析生成 query plan tree,面对 customer/orders 分片不同导致的数据分散问题,planner 会在 nested loop、hash join、merge join 之间做成本估算选择最优策略。
评论点赞收藏19 天前

一个连接如何搞挂整个数据库

一个未处理的异常导致Postgres事务不提交,连接不关闭,阻塞了后续所有查询和迁移,引发数据库雪崩式卡顿。PlanetScale推出连接管理工具,可在Dashboard和CLI中实时查看并终止阻塞连接。
评论点赞收藏22 天前

Neki 路由器是什么:PlanetScale 的分片数据库路由方案

PlanetScale 发布 Neki Router,用独立的路由层解决 Postgres 进程-连接架构的连接数瓶颈。应用通过一个连接字符串接入,路由层负责将查询分发到多个分片并聚合结果。 每个查询经过两阶段规划:Neki 决定路由到哪些分片,Postgres 决定每个分片如何执行。支持 scatter-gather 查询,可独立扩展路由层和分片层。
评论点赞收藏25 天前

Postgres大表的那些坑:从事故到分片解法

Postgres大表会引发级联删除超时、vacuum延迟、连接堆积、备份变慢等一系列可预见问题。PlanetScale用真实客户事故开场,逐一分析分区、垂直扩容、分片三种方案的优劣,最终推荐分片(Neki)作为根本解法。 文章包含具体参数(autovacuum触发阈值、32位XID上限、TOAST OID 40亿限制)和可操作的配置建议。
评论点赞收藏33 天前

Postgres分片技术演进史与PlanetScale的新方案

PlanetScale发布Neki,为Postgres提供自动化分片方案。文章回顾了Postgres分片技术的发展历程,从Skype的PL/Proxy、Instagram的逻辑分片,到Citus扩展,再到Spanner、CockroachDB等兼容方案,最终引出Neki的设计思路。
评论点赞收藏36 天前

一个 Postgres 集群承载多个应用

PlanetScale Postgres 支持在一个集群内创建多个逻辑数据库,每个应用用独立 schema 和角色隔离。通过 Pulumi 等 IaC 工具可自动化管理数据库创建、角色权限和 CONNECT 隔离,避免手动操作 Postgres 复杂的权限模型。
评论点赞收藏39 天前

被污染的 Postgres 连接池

PgBouncer 在事务模式下复用底层连接时,若前一个客户端遗留了 session 级状态(如 SET SESSION CHARACTERISTICS AS TRANSACTION READ ONLY),后续客户端会继承该状态,导致大量写入报错。 修复方式是批量执行 DISCARD ALL 重置所有连接,并修改应用代码避免设置 session 级 read-only。预防方案是将读流量路由到副本,或在事务内而非连接级设置 read-only。
评论点赞收藏40 天前

PostgreSQL 子事务缓存溢出:一个事务拖垮整个集群

PostgreSQL 一个事务积累超过 64 个子事务会导致整个集群性能暴跌,新只读副本也无法接受查询。实测 TPS 从 7200 骤降至 160,根因是子事务缓存溢出后所有查询都需要额外 SLRU 查找并产生锁竞争。 新副本遇到溢出 RUNNING_XACTS 记录时会进入 STANDBY_SNAPSHOT_PENDING 状态,无法提供读流量。建议保持事务简短,监控最老运行事务。
评论点赞收藏49 天前

并发与吞吐:为什么更多并行会让数据库变慢

PlanetScale 的 MySQL 数据库因一个长事务卡住导致 16 分钟雪崩,错误峰值 1400 次/分钟,吞吐量跌至 1/10。根因不是锁竞争,而是 InnoDB 同时处理上万条快照读时版本链膨胀,使每请求成本随并发数平方增长。 修复方案是将 Vitess 事务池从 10000 降回约 1000,并把满池时的报错改为排队等待。调整后峰值 26000 请求/秒涌入,错误为零,QPS 稳定在 6 万。
评论点赞收藏53 天前

大规模并行 Postgres 备份

PlanetScale 用大规模并行方式将分片 Postgres 数据库备份到 S3,8 个分片并行可在约 2.8 小时内完成原本需 22 小时的 32TB 数据库备份,峰值速率超过 50 GB/s。
评论点赞收藏60 天前

Postgres 备份机制深度解析:从 pg_dump 到连续归档的原理与工程实践

PlanetScale 详解 PostgreSQL 三种备份方式(逻辑备份、文件系统备份、连续归档),重点剖析 WAL 原理、事务回绕风险及大规模集群下的恢复策略。 文章包含真实生产场景中的技术决策依据,如 pg_dump 在 30TB+ 数据库上可能触发只读模式、全页写入(FPW)如何修复“涂抹”数据、以及基于 LSN 的时间点恢复实现细节。
评论点赞收藏67 天前

PostgreSQL 19 新特性:在线表重组入核、JIT 默认关闭与查询优化增强

Postgres 19 Beta 2 发布,GA 预计 9-10 月。核心亮点:1. REPACK 命令入核,支持在线(CONCURRENTLY)重写表以收缩膨胀空间,替代 pg_repack,但需注意锁升级死锁风险和 MVCC 一致性限制;2. JIT 默认关闭,避免短查询因估算偏差承担编译开销;3. 查询优化器引入 eager aggregation 和 NOT IN 反连接优化,新增 pg_plan_advice 用于锁定执行计划。 此外 lz4 成为 TOAST 默认压缩算法,并行 autovacuum 等新特性也值得关注。
评论点赞收藏68 天前

如何让 768 台服务器看起来像 1 台

PlanetScale 分享将 768 台服务器组成的 Petabyte 级 Postgres 集群伪装成单节点的工程实践。文章深入剖析了从垂直扩展、只读副本到分片(Sharding)的演进瓶颈,重点讲解 Proxy 层如何通过路由、连接池和查询重写屏蔽底层复杂性。 虽然带有 Neki/Vitess 推广色彩,但其关于写入瓶颈、备份延迟及分布式路由的具体技术细节,对处理大规模数据库架构的工程师具有极高的参考价值。
评论点赞收藏76 天前

数据库分片详解:原理、策略与工程实践

详解数据库分片(Sharding)原理与实战策略,涵盖范围分片、哈希分片的优劣对比,以及跨分片查询、数据一致性、延迟和数据持久性等关键工程考量。 适合需要处理海量数据扩展的工程师参考架构设计。
评论点赞收藏77 天前

死锁与停机:PostgreSQL的高频陷阱与防御策略

PostgreSQL死锁不仅导致事务报错,高频死锁还会引发重试风暴拖垮数据库。核心解法包括:保持事务内加锁顺序一致、缩短事务窗口、查询增加退避与抖动重试。 PlanetScale还推出了Traffic Control功能,通过限制并发资源来主动拦截高风险查询,从数据库层面预防死锁雪崩。
评论点赞收藏83 天前

Kubernetes 背后的反馈循环机制解析

PlanetScale 工程师从控制理论视角深度解析 Kubernetes Operator 机制。文章通过手动搭建 Postgres 集群的实战案例,逐步引出“期望状态”与“实际状态”的差异,解释了为何 Kubernetes 采用边缘触发通知配合电平触发逻辑的设计哲学。 内容兼具工程实操细节与底层原理洞察,适合对分布式系统和云原生架构感兴趣的开发者。
评论点赞收藏105 天前

Postgres中唯一可扩展的删除方式是DROP TABLE

文章指出Postgres中大规模DELETE操作因MVCC机制会产生大量死元组和复制开销,建议通过表分区或DROP/TRUNCATE来替代批量删除。文中提供了具体的工程实践方案,如利用事务性DDL进行数据清洗,适合DBA和后端工程师参考。
评论点赞收藏110 天前

极致容错的底层逻辑:PlanetScale 架构实践

PlanetScale 工程师详解其数据库架构的高容错设计原则,包括隔离性、冗余和静态稳定性。文章深入剖析了控制面与数据面的架构差异,以及故障转移、同步复制和渐进式发布等具体工程实践,展示了如何在云环境中构建极致的可靠性。
评论点赞收藏128 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。