语言模型用于文本分类:从词袋到 Jev
Sebastian Raschka 写的一篇长文,梳理了文本分类方法从 bag-of-words + naive Bayes/logistic regression,到词嵌入 + CNN/RNN/LSTM,再到 BERT/GPT 等 transformer 的历史脉络,并将其映射到 2026 年 Typesafe 新发布的通用分类器模型 Jev 上。 核心判断:Jev 不是"只是分类器",它把"窄问题专用模型"与"大模型零样本能力"之间的中间地带填上了——比专用分类器更通用、比 GPT 更快更便宜;但对非常窄的单一任务,专用模型仍可能更强。 作者还提到自己在 15 年前做过 bag-of-words 分类,以及 2014 年的 arXiv 早期教程,把 Jev 放进自己亲历的技术演进里。文章配了大量插图与代码链接(GitHub 上的 LR、LSTM、CNN 教程),并强调自己与 Jev 无利益关联,纯技术解读。 整体信息密度较高,带个人视角与历史纵深,对工程实践者读起来像一条清晰的"分类器简史 + Jev 定位"线索。 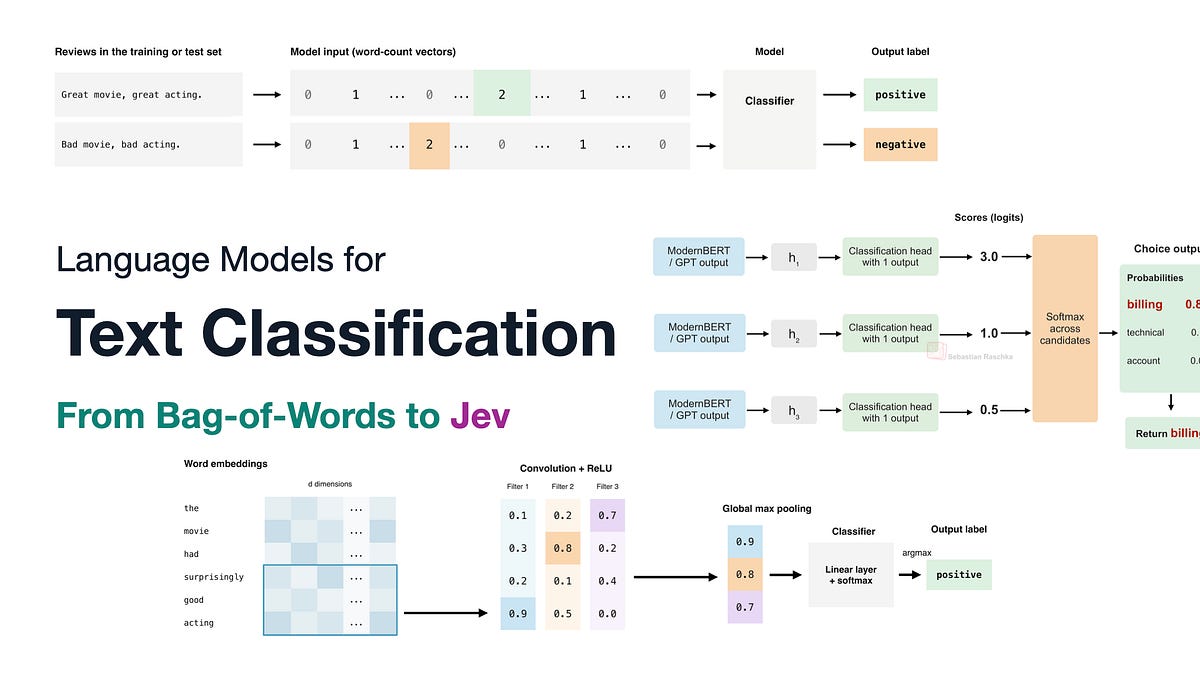
 评论
 点赞
 收藏