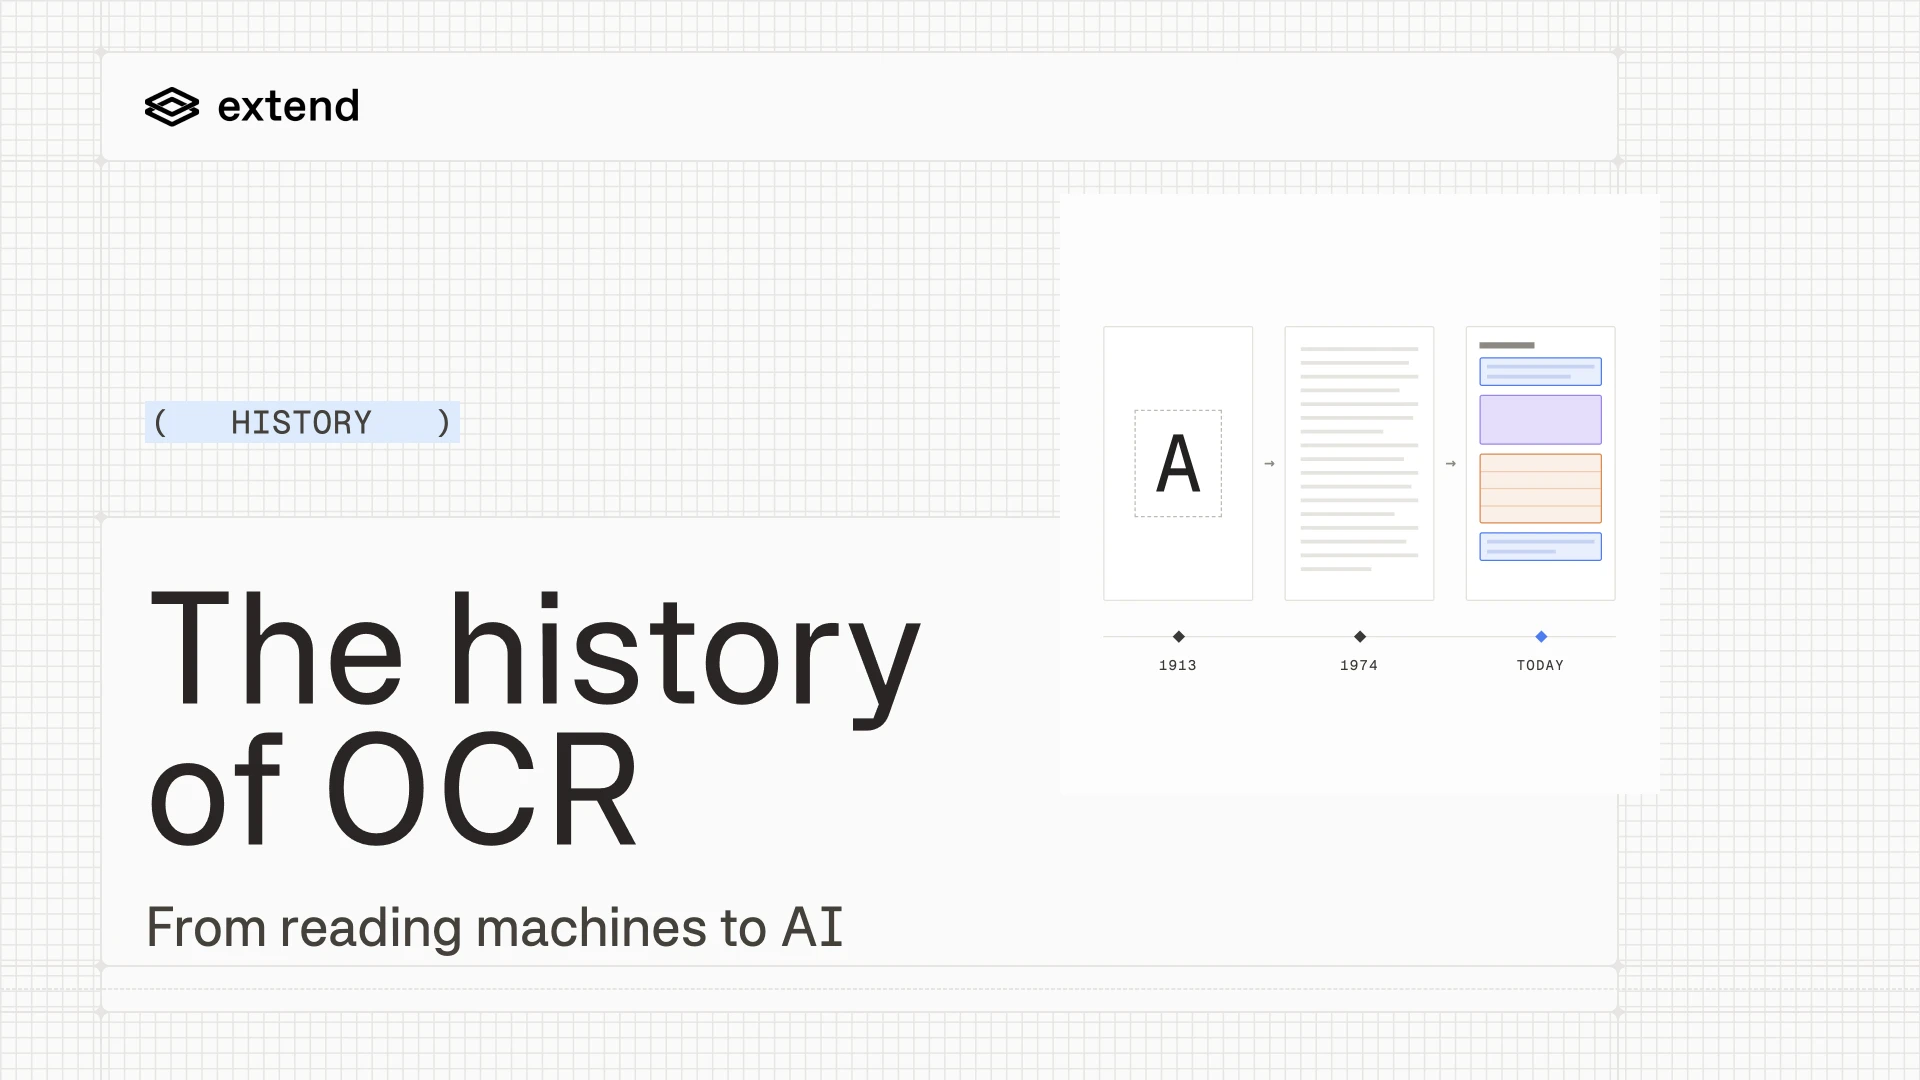
2OCR:从读取字符到理解文档光栅字符识别(OCR)把扫描文档、照片和 PDF 中的印刷或手写文字转成可搜索、可编辑的文本。如今 OCR 只是文档处理流程中的一步:系统先识别页面组件,如段落、表格和图像,再把各组件交给专门模型处理。OCR 的早期商用系统只能在固定字体或有限字符集下工作。1 小时前
1PoliTax Split:基于总统税单的PDF拆分基准测试Extend发布基于白宫税单数据的PDF拆分基准测试PoliTax Split。文章指出前沿大模型直接处理长文档拆分时召回率极低,通过自建Harness系统可显著提升F1分数。文章详细分析了模型在边界判断上的常见错误,并提供了基准数据集和代码示例,具有明确的工程参考价值。219 天前
5我们如何构建一个提示词优化AgentExtend团队分享构建文档处理提示词优化Agent“Composer”的工程实践。文章详细记录了从启发式工作流转向Agent的决策过程,并总结了四个关键经验:上下文工程的重要性、小工具设计(批处理与合并)、长耗时操作的状态管理,以及意外发现Agent在解释“为何无法提升准确率”方面的价值。内容包含大量具体的工程细节和踩坑记录,对构建Agent系统的开发者有较高参考价值。236 天前
16Extend (YC W23):将杂乱文档转化为结构化数据YC W23项目Extend介绍其文档解析工具包,针对PDF、图片等复杂文档的解析痛点,提供结合计算机视觉、LLM上下文工程和提示词优化的解决方案,旨在实现高准确率的生产级文档处理管道。391 天前
1Extend 融资 1700 万美元,打造文档处理云基础设施文档处理初创公司 Extend 宣布完成 1700 万美元种子及 A 轮融资。文章介绍了其结合 LLM 与工程原语的文档处理云平台,强调在高精度要求场景下的优势,并发布了自动化配置生成和沙盒模式等功能。505 天前
 2


 21516
 1
