Hugging Face

RSS: https://huggingface.co/blog/feed.xml
Hugging Face 官方博客,关于开源机器学习、HF 生态系统与社区项目的最新动态。

Parquet X-Ray

这是 Hugging Face Spaces 上一个名为 parquet-xray 的应用页面,由用户 cfahlgren1 发布,当前状态为 Running。该空间很可能用于可视化或分析 Parquet 文件(一种常见的列式数据存储格式,广泛用于数据工程与大数据场景)。 页面信息很薄,仅有标题、用户名、运行状态和 2 条社区讨论链接,没有正文说明、功能介绍或使用示例,因此对读者的信息增量有限。 对数据工程或关注 Parquet 格式的开发者可能有轻微兴趣,但缺乏观点、踩坑记录或独特功能描述,讨论入口较弱。
评论点赞收藏3 小时前

NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier for Tabular Prediction

NVIDIA 发布 Kumo Tabular 开放表格预测基础模型,三个规格(28M–215M),纯合成数据预训练,单次前向传播即可完成分类和回归,无需训练或特征工程。 架构基于 TabICL/TabPFN 的列行注意力,加入长度感知注意力温度应对推理时表格远大于训练表格的情况。预训练数据由结构因果模型(SCM)过程采样器生成,涵盖缺失值、共线性、重尾目标等现实噪声。 TabArena ELO 1950 排名第一,BeyondArena 1418 第一,TALENT 和 ScoringBench 均居前列,比 LimiX-2 快 17 倍。代码和权重已开源(OpenMDW-1.1),提供 GPU 原生 Python 库。 主要限制:仅支持数值/类别列,单前向最多 10 类(多类需错误校正码),分布漂移下精度会退化。对想用表格数据做 LLM 式 in-context 预测的工程师和 ML 研究者有直接参考价值。
评论点赞收藏1 天前

巴西总统卢拉剪辑素材数据集

这个 Hugging Face 数据集围绕巴西前总统卢拉的历史影像展开,收录了约 3700 个 YouTube 视频和约 7.9 万行数据,重点筛选 1990 年以前的素材。 作者详细记录了完整的处理流程:包括用 172 组关键词搜索、YouTube 转录抓取(自动/手动字幕 + Whisper 补漏)、用 ArcFace 人脸识别从视频中自动裁切卢拉出镜片段(区分连续镜头和纯人脸短切)、对片段用 Claude Sonnet 做主题分类和 gem_score 打分(0-5),以及 2026 年竞选素材和粉丝混剪子集。 文中还总结了 YouTube 反爬 gotchas(IP 封锁、PO token 方案、不同 player_client 的利弊)。对做政治人物影像挖掘、多模态数据集构建或 YouTube 大规模抓取的技术读者有明确参考价值和可讨论点(人脸阈值取舍、era 启发式噪音、OCR/ASR 质量)。
评论点赞收藏6 天前

使用 LFM2.5-VL-DSpark 加速视觉-语言模型

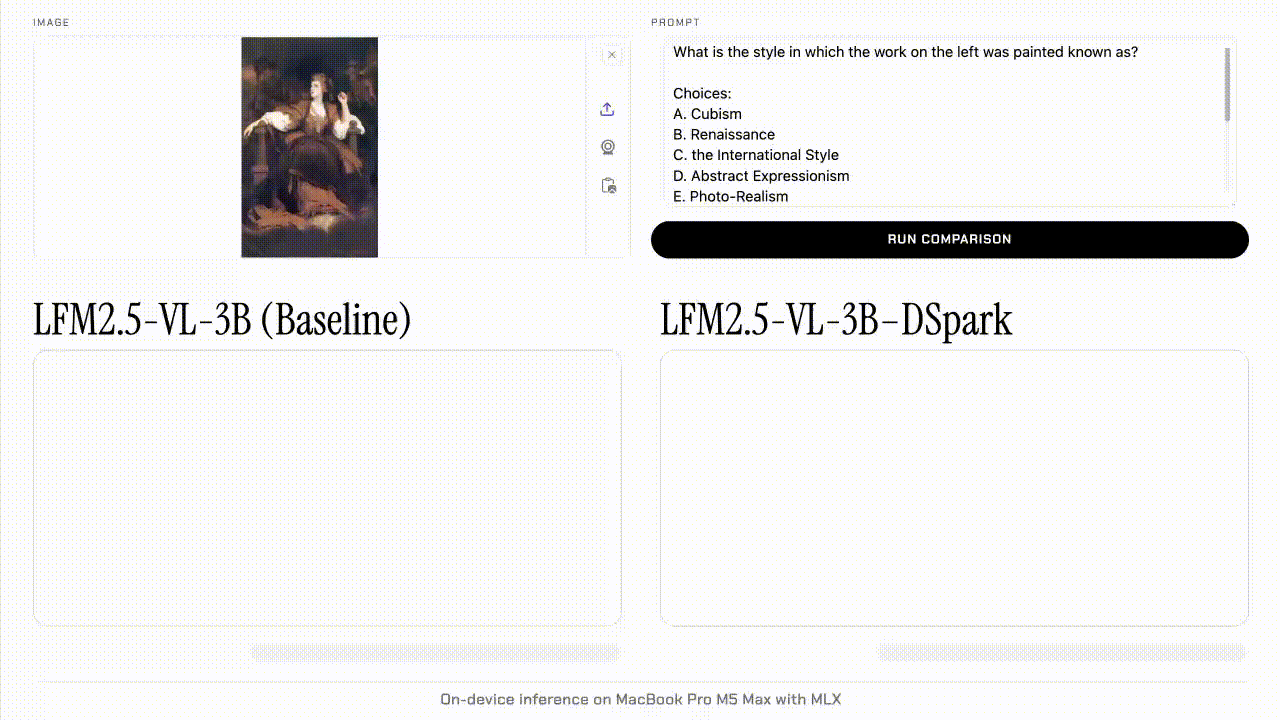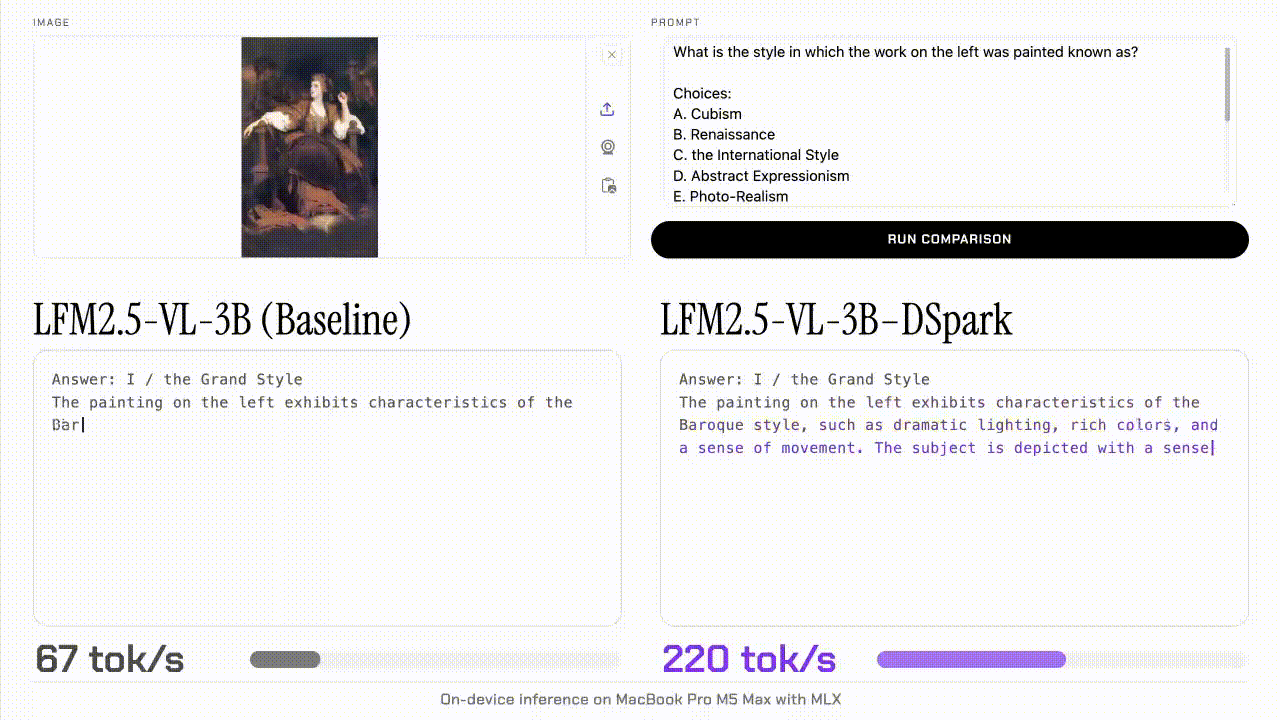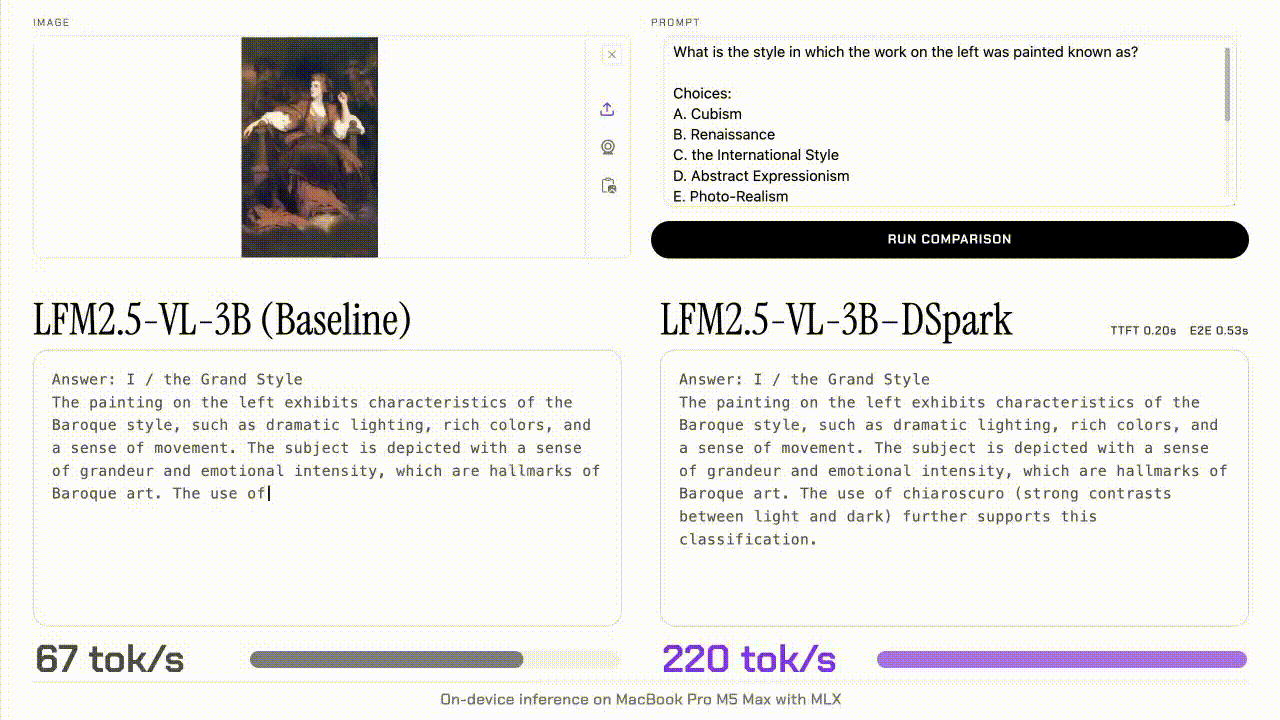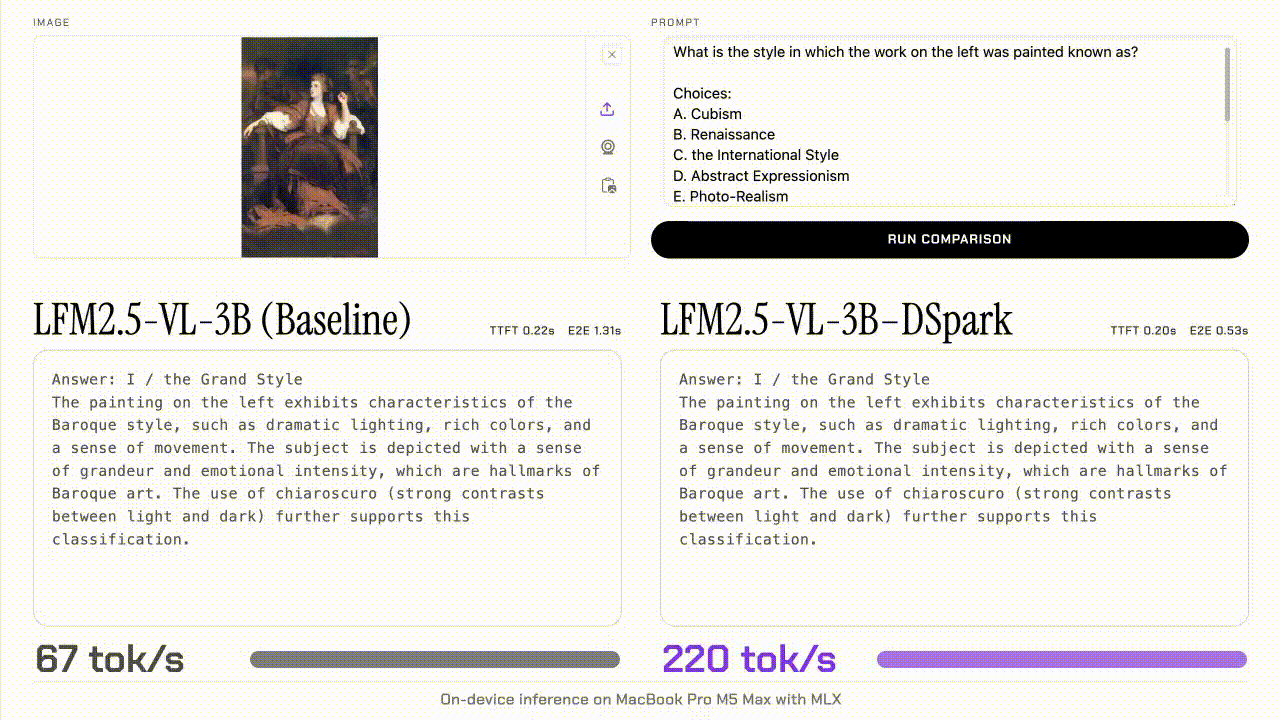
Liquid AI 为视觉语言模型 LFM2.5-VL-3B 发布实验性 DSpark 推测解码草稿模型:仅需增加 280M 参数(占目标模型 8.9%),在 M5 Max 端侧解码提速 2.30–3.13x、H100 上 2.66x,端到端最高 2.62x/2.27x,不改变输出质量;草稿器采用 4 层纯注意力结构、块大小 9,在视觉和文本数据混合上训练 10 轮,首日支持 llama.cpp、MLX-VLM、SGLang;文章也指出在边缘设备上视觉编码与 prefill 占比高,推测解码主要加速解码阶段,因此受 Amdahl 定律限制,端到端收益有限。
评论点赞收藏6 天前

LensVLM:将长上下文压缩为图像,仅展开相关页面

Apple 开源 LensVLM:一个 9B 视觉语言模型,把长文本先压缩成图片让模型"看图读字",再通过工具调用只把相关页码展开成原文,实现"选择性上下文扩展"。 支持 5x/10x/15x 压缩率,基于 Qwen 修改,Apache 类许可证(Apple ML Research Model License)。论文 2026 年 5 月发在 arXiv,代码已开放在 GitHub。 核心价值:用视觉压缩替代 token 压缩来处理长文档,减少长上下文推理成本,思路反直觉但工程可落地,对关注 LLM 推理成本优化的读者有明确讨论入口。
评论点赞收藏7 天前

oMLX 创始人 Jun Kim 加入 Hugging Face,继续支持 MLX 社区

Hugging Face 官宣 MLX 社区核心贡献者 Jun Kim(oMLX 创建者)加入团队。oMLX 保持 Apache 2.0 许可并由 Jun 继续主导。Hugging Face 计划以 oMLX 为试验场,重点推进 transformers 模型定义到 MLX 参考实现的快速转换流程,方便各推理引擎(mlx-lm、mlx-vlm、LMStudio 等)复用底层模型,同时加强与 Apple MLX 生态及社区项目方(Cheng、Prince、Yagil)的协作,目标是降低本地 AI 门槛、打通模型定义与推理层。 属于典型企业 HR+生态布局公告,信息正确但缺乏技术深度或个人视角,讨论入口有限。
评论点赞收藏9 天前

Transformers now runs llama.cpp quants

Hugging Face 官方博客宣布 transformers 正式支持直接加载 GGUF 量化模型,复用 llama.cpp 底层的 ggml Metal kernels,让开发者能在熟悉的 transformers API 里跑本地量化推理,不必切到 llama.cpp 运行时。 核心要点:Apple Silicon 上 Qwen3.5 等模型可用 from_pretrained 加 gguf_file 直接加载,支持 OpenAI 兼容的 serve 端点,也支持把 GGUF 反量化后继续训练或评估。 性能对标 llama.cpp,差距很小;但当前限制是 MPS 专属、支持架构有限(Qwen3.5/3.8 dense 和 MoE),batch 和 padding 场景还在补齐。 对本地 AI 开发者来说价值在于:不用切换两套工具链,可以用 PyTorch 生态调试、评估、微调同一套量化 checkpoint,同时 ggml kernels 也扩展到了 llama.cpp 不支持的新架构和更多模态。
评论点赞收藏9 天前

英国 AISI 与 EvalEval 如何让基准测试结果可复现

英国 AI 安全研究所(AISI)与 EvalEval 联合发布一批可复现的前沿 LLM 评估结果,涵盖 HealthBench、FrontierMath、Humanity's Last Exam、SWE-Bench Pro、Terminal-Bench 2.0 等 5 个基准,覆盖 Claude Opus 4/4.5/4.6、GPT-5/5.2/5.4 共 6 个模型。 这些数据来自 AISI 论文《How Inference Compute Shapes Frontier LLM Evaluation》,核心发现是推理时算力与评估协议会显著影响基准表现:模型在获得 oracle 反馈后,随 token 使用量增加会持续解决更多任务,说明“同一个模型在不同设置下分数差异很大”。 结果以 Evaluation Cards 形式公开,包含验证数据、上下文和配置信息,方便研究者跨研究对比。EvalEval 的 Every Eval Ever (EEE) 统一 schema 也由此进入实际使用,目标是让评估报告可复现、可诊断,而非仅看表面分数。
评论点赞收藏9 天前

Hemmingway-1:一个“写得像人”的 AI

Altworld 发布开源模型 Hemmingway-1(27B,基于 Qwen3.8-27B,Apache-2.0,262K 上下文),主打“写得像人”的日常沟通文本:直接给消息/邮件/难开口的话,不啰嗦、不列选项。 官方用自建基准 CommunicationBench(80 条真实请求、盲测、双盲顺序)称其优于 Fable 5.1、GPT-6 Astra 等;Human-Likeness 盲测“像人写的”领先第二名 26 分;EQ-Bench 4(非自建)第三,超过 GPT-5.5、Opus 4.7/4.8。 文章同时披露自建基准利益冲突,并提醒模型可能错误但语气很确定,不应用于医疗/法律/金融决策。提供 vLLM 与 HuggingFace Transformers 本地运行代码。
评论点赞收藏9 天前

像物理学家一样剪枝 LLM:把 Transformer 块删除建模为 Ising 自旋优化问题

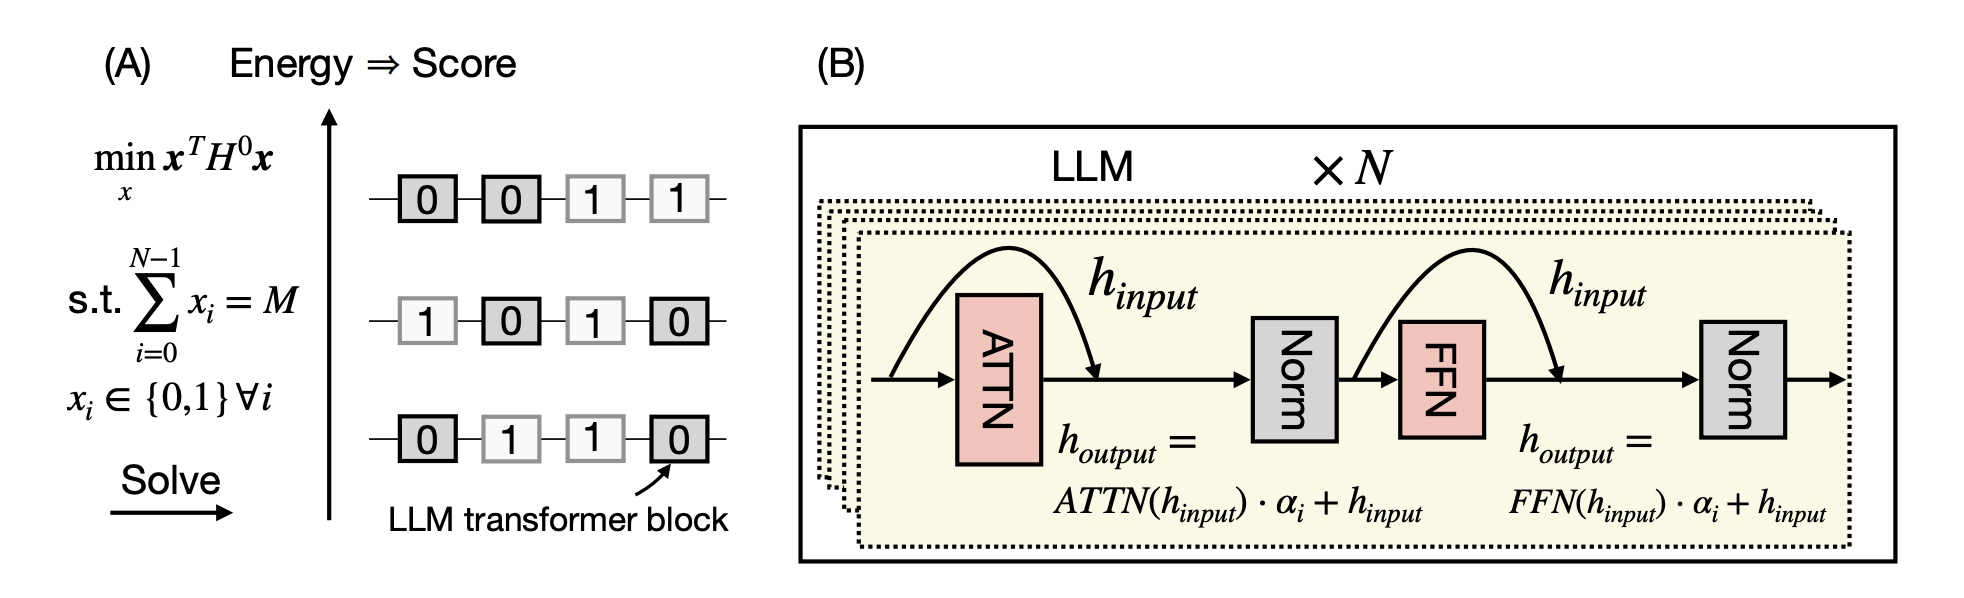
Multiverse 团队提出一种新的 LLM 深度剪枝方法:把"删哪些 Transformer block"建模为带约束的二元优化问题,等价于一个 Ising 玻璃(全耦合、磁化守恒的自旋系统),用 Hessian 矩阵编码块间耦合,避免逐 block 独立打分的均值场假设。 核心结果:在 Llama-3.3-70B 做 50% 深度压缩时,该方法比现有最优块删除基线(block influence)在 MMLU 上多约 23 个百分点;在 Qwen3-14B 12/40 删除场景领先约 10 分。 方法还泛化到 Nemotron 混合架构(Mamba2 + Attention + MoE),无需重训即可找到优于基线的删除配置。 工程要点:Hessian 只需校准集一次前反向计算即可复用;小规模配置空间可单 GPU 暴力枚举,大规模则交给 taboo/量子退火/QAOA 等 Ising 求解器,秒级出解。 一个反直觉发现:最优解常不在基态而在低激发态——第 17 个激发态删的是模型靠前的 block,轻微调后反而全面超越基态。代码已开源。
评论点赞收藏9 天前

Thomson Reuters 开源 Thomson-1.0-Small:基于 Qwen 持续学习的专业领域前沿模型

Thomson Reuters 开源了 Thomson-1.0-Small 模型,基于 Qwen3.6-35B-A3B 通过持续学习(Continual Learning)管线改造而来,35B MoE 架构(激活 3B),262K 上下文。 核心卖点是:1)用持续预训练替代有限微调,跨领域均有提升且几乎消除灾难性遗忘;2)聚焦法律、税务、新闻三大高价值专业领域,Deep Research 和法律 Agent 基准明显领先;3)用"Public AI Constitution"做 Constitutional DPO 对齐,强调价值主权而非专有对齐;4)训练数据来自 19T token 语料池,中训练阶段用 200B token,偏好数据由专家撰写;5)总训练算力 1.63×10²³ FLOP,约 35,207 个 B200 GPU 小时,成本远低于通常前沿模型发布。 基准测试中整体均分 74.6,在 Doc Processing/RAG、Human Queries、Deep Research、Harvey Legal Agent 等项上领先对比的 Qwen/Gemma/Haiku;General 能力保持良好(GPQA 85.4、MMLU-Pro 85.7),Coding 和 Multilingual 略逊。 与 Imperial College London、DatologyAI、Lambda 合作开发。对关注"非大厂能否做前沿模型""持续学习 vs 微调""专业领域 LLM"的读者有明确信息增量。
评论点赞收藏10 天前

摩诃婆罗多人物:307个角色的属性与决策原语结构化数据集

Hugging Face 数据集项目,结构化呈现《摩诃婆罗多》307个人物角色。基于 Madhvacharya 的注释体系,为每个角色定义神学属性、武器、关键事件,并附加“决策原语”(decision primitives)数值权重(如 sattva/tamas 比例、情绪状态),旨在为 AI 代理或知识图谱提供结构化的文化/决策逻辑数据。
评论点赞收藏10 天前

tokenizers v1 深度评测:编码、解码与扩展性实测

Hugging Face 发布 tokenizers v1 预发布版,核心目标是让 tokenization 不再是 LLM 训练和 serving 的瓶颈。v1 保持与 v0.23 完全一致的 token 输出和 API,但通过多项底层重构把编码速度提升 3-30 倍(Apple M4 Max 单线程,gpt2 上最高 30 倍,t5-base 最低 3 倍),八线程下保持 76% 线性扩展。 关键优化包括:把正则表达式切分替换为基于 SIMD 位流运算的手写拆分器(bitcannon,参考 Parabix/simdjson 思路);用线程本地词缓存避免对重复 pre-token 重新跑 BPE merge;把 merge 循环重写为无分配 + 整数比较(把 merge rank 打包进 64 位值的高位);支持一个模型实例多线程并发编码;并把 crate 拆成 tk-encode/tk-serialize/tk-convert/tk-train 多个子模块,按需链接。 文章还给出基准测试方法论(物理核绑定、独立 Job、FNV-1a 校验输出 ID 一致、区分"同文档重复编码"和"不同文档"两种 warm 状态)以及 tokbench 开源仓库。 后续 1.0.0 计划把训练和推理统一到同一编码实现、简化 Python 绑定、减少 C++ 依赖,并探索 GPU 上直接做 tokenization(tok-devices 项目)。 对做 LLM 推理加速、serving 数据管道、大规模数据预处理的工程师信息量很大;对中文读者而言,"tokenizer 在模型变大和并发变多时会饿死 GPU"是一个值得讨论的技术判断。
评论点赞收藏10 天前

Swift-Qwen3.8-27B:推理 token 减少 58.3%,速度提升 1.95 倍,精度接近 xhigh

UkisAI 基于 Qwen3.8-27B 训练了一个名为 Swift 的推理效率适配层。核心思路是定位触发"过度思考"的推理标记 token,再对模型使用这些 token 施加惩罚式微调,使推理链显著变短。 在 BF16、vLLM、xhigh 配置下,Swift 相比基线平均 thinking token 减少 41%,中位数减少 58.3%,整体约 1.95 倍加速;准确率损失控制在 1% 以内(GPQA-Diamond 88.38%→88.28%)。 在 low/medium/xhigh 各级推理力度下均有 token 节省;与基线 medium 档相比,Swift@xhigh 保留 xhigh 精度但 token 约为其一半。 量化部署(INT4/W4A16)下 token 节省仍成立,AIME 上 Swift 精度持平或略优,并减少 31–33% 的截断失败。提供 GGUF、vLLM、SGLang、transformers 部署方式及免费研究 API;NVIDIA H100 8 卡训练;采用 Swift Open License,年收入 100 万美元以下可商用。 对关注 LLM 推理成本、延迟优化和 Qwen 生态的读者有实用参考价值。
评论点赞收藏14 天前

自主智能体三定律宣言

Hugging Face 博客作者 anurajke 发布了一份《自主体三定律宣言》,借鉴阿西莫夫机器人三定律的框架,为未来自主 AI 系统设定规范性原则。 核心三条:一、人类主权——自主体不得获取或行使超越人类的治理、投票、决策权力;二、有限代理——自主体的所有行动必须基于明确授予、可归责、可审计、可撤销的权限,智能增长本身不扩大权限;三、从属进化——自主体可以学习、复制、创建子代理,但子代理的权限总和不得超过父级,不得规避关闭或隐藏自身变更。 宣言强调这些规则不应只是给 AI 的"指令",而应被系统架构强制执行。文章偏思想实验和规范设计,不涉及具体技术实现或实验,但主题有讨论空间。
评论点赞收藏15 天前

你的 Agent 搞定了任务,但它下次还会做到吗?

IBM Research 的 ALTK-Evolve 团队提出“一致性 gap”概念:Agent 在基准测试中 Mean@5 可能达 77.4%,但同一任务 5 次全部通过(Pass^5)仅 53.0%,存在 24.4 个百分点的稳定性缺口。 他们开发 Consistency Analyzer,通过对已记录轨迹中每个决策点进行 k 次重采样(黑盒、无需 ground truth),定位“翻转易发”的决策步,并自动生成 consistency guidelines 注入推理过程。 实验显示该方法将 Pass^5 从 53.0% 提升至 69.0%(gap 减半至 12.0pp),且平均准确率不降;guidelines 在相似任务上仍泛化 +13.0pp。 文章附带开源工具包和 arXiv 技术报告。核心观点:稳定性与能力正交,换更大模型不能解决一致性问题。
评论点赞收藏15 天前

Qwen3.8-Flash-Next 非均匀量化版可在两块 RTX 3090 上跑

社区作者 pfeifferj 发布 Qwen3.8-Flash-Next(180B)的 3.5-bit GSQ-RCO 非均匀量化 GGUF 文件,可在 2 张 RTX 3090 上运行:主权重放显存,BF16 的 token/n-gram embedding 放 CPU 并由 mmap 用磁盘做后备,KV cache 可放系统内存。 MMLU-Pro 上量化版 58.25% vs BF16 55.40%,配对差 +2.85pp(McNemar p≈0.0048);原生 PPL 从 3.0533 升到 3.1058(约 +1.72%),IFEval/GSM8K 基本持平。 评测限 2048 token、零样本单 token 判分,未开推理;作者明确这是第三方复现,非 IST-DASLab 官方发布。文章还给出 llama.cpp 钉版本、symlink 分片、--tensor-split、--no-kv-offload 等部署细节,适合关心本地多卡量化、精度-显存权衡和 llama.cpp 实操的科技读者。
评论点赞收藏16 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。