我们做出了首个向量化快速排序
Google 开源了基于 Highway 库的向量化 Quicksort,宣称在多种现代 CPU 架构上比 C++ std::sort 快约 10 倍,并超过此前针对特定架构优化的排序实现。 核心思路是利用 SIMD 的“compress-store”(或可用 permute 模拟)加速 Quicksort 中最耗时的 partition 步骤:先用小于 pivot 的 yes/no 掩码把元素压入一段连续内存,再取反掩码写入另一段,直到子数组小到可用特殊方式排序。 实现通过 Highway 的统一 SIMD 接口同时支持 Arm SVE、RISC-V V、x86 AVX-512/AVX2 等六种指令集、三大架构,避免为每个平台重写约 3000 行 C++,并支持 16 到 128 位整数/浮点输入。 性能方面,Apple M1(NEON)上 100 万个 32/64/128 位数的排序吞吐约 499/471/466 MB/s;Skylake AVX-512 约 1120 MB/s;AVX2 约 798 MB/s,高于此前 AVX2 专用最优的 699 MB/s,而标准库在同一 CPU 上只有 58-128 MB/s,整体达到 9-19 倍加速。 代码以 Apache-2.0 发布在 Google Highway 仓库,附带 arXiv 论文详细介绍实现与评测。 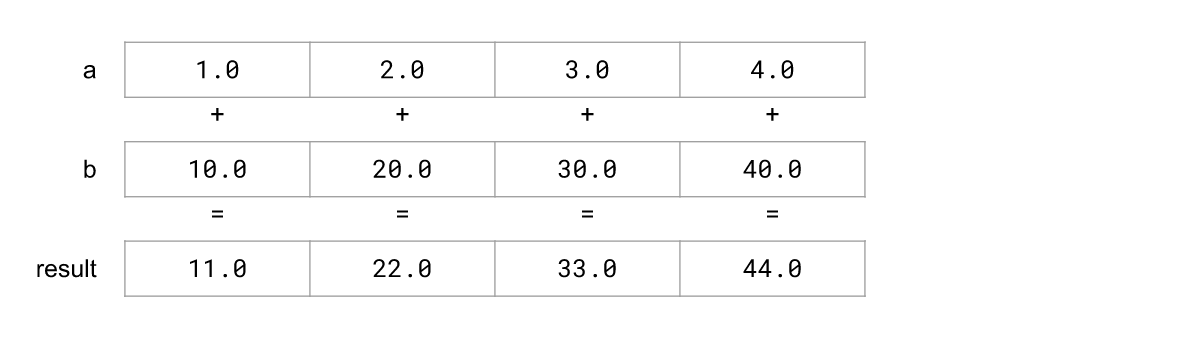
 评论
 点赞
 收藏