优步(Uber)

了解如何借助 Uber 平台和应用增加收入、点餐、通勤、叫车、简化商务出行等。

混合核心分配:从超分配到可靠共享

Uber 的有状态容器编排系统 Odin 引入"混合核心分配":工作负载同时获得专用(reserved)核心和共享核心, 共享核心按主机池化超分配,并用 Linux cpu.shares 做公平竞争。 关键工程细节: • cpu.shares 公式:round((dedicated + shared_for_contention) × 100),例 2 专 + 0.5 共 = 250;实验表明严重竞争下实际份额会明显偏离设定,与 SoCC'21 的 rkube 结论一致。 • NUMA 观察:内核默认会把进程调度到内存所在 socket 的 CPU,cgroup 约束下也成立,但共享库会打乱;内存分配优先就近,自动 NUMA 平衡可迁移页。 策略是专用核放在同一 NUMA node,共享池跨 node 铺开。 • 同机 in-place 垂直扩缩:有状态工作负载跑在本地盘上,换机代价高,所以直接在原主机上调 CPU 配额,部分场景仍需重启但不需迁移。 • 垂直 scaler 用专用核平均用量定基线、共享核用量偏离定弹性;共享总池通常大于物理可用,靠 cpu.shares 按比例分。 • 对齐 K8s:把 cgroups 管理拆成独立库并封装为 CRI 插件,弥补 K8s 没有混合核心调度的缺口。 作者坦承局限:分配决策仍在 host 级,未来可上移到全局调度器;长期运行会产生核心碎片化,需要周期 defrag。
评论点赞收藏11 天前

零增长栈,真实收益:Go 中栈分配如何节省 10% CPU

Uber 工程团队发现 Go 的自适应栈扩展机制在大规模部署下导致约 10% 的 CPU 消耗在栈拷贝上。他们通过私有链接(linkname)patch Go runtime,禁用 adaptive stack start/shrinking,配合配置系统注入静态栈大小(如 32KB),并用 pprof 分析器 + 汇编符号表自动定位 copystack 热点、计算每个函数的栈用量。 最终该服务 CPU 从 180 降到 150(约 16% 降幅),栈内存多占不到 2% 的容器内存。文章详细展示了四种调优方案对比、构建标签保护机制、以及 yarpc 中间件栈占用从 2.6KB 优化到 600B 的 PR。 核心看点:非官方手段改 runtime 的可行性与风险、profile 驱动自动化调参的工作流、以及"用内存换 CPU"在超大规模下的经济学。
评论点赞收藏17 天前

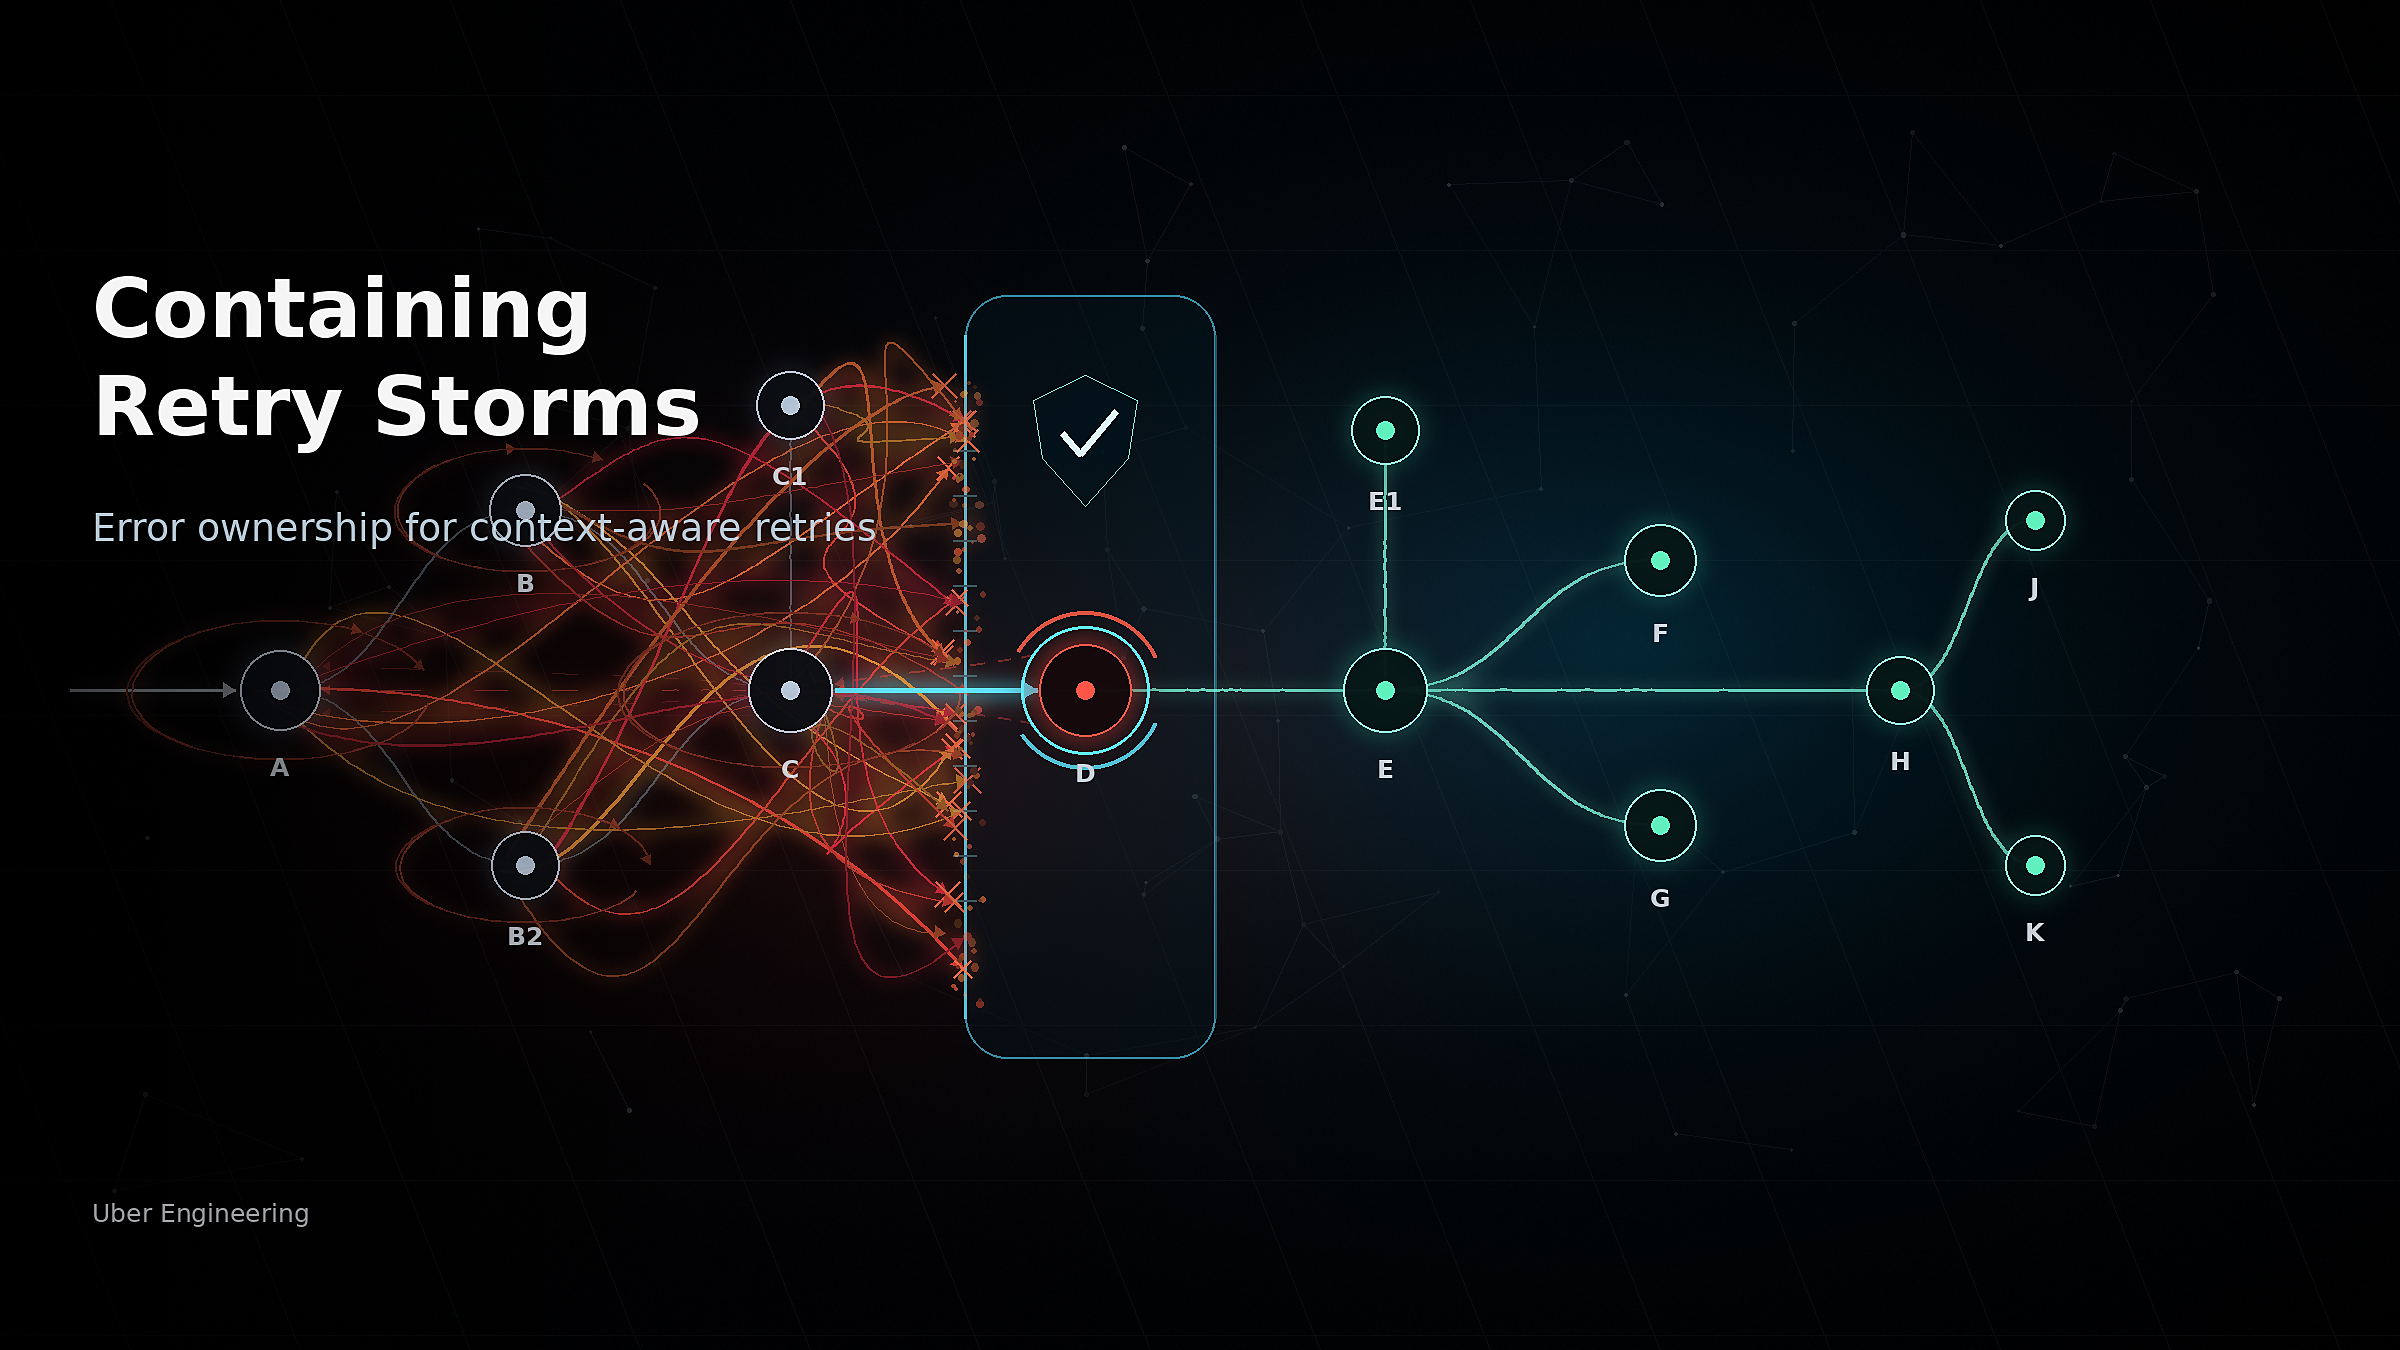
Uber 如何防御重试风暴

Uber 工程团队介绍其防止重试风暴(retry storm)的生产机制。核心问题是微服务深依赖链中重试会按 2^depth 放大,retry budget 只能线性缓解。 Uber 引入"错误归属"(error ownership):每个服务区分自己是错误"原因"还是"症状",通过共享基础设施中的重试中间件 + 服务依赖分析方案,在请求头中标记 claim/unclaim,让只有真正拥有错误的服务才允许被重试,上游看到被认领/未被认领的错误头则停止重试,从而把重试风暴半径从最大 25 层压到 3 层(平均从 20 降到 2)。 文中含决策矩阵、edge case(at-least-once 保证、上下文丢失处理)、coincidental error 处理逻辑,并引用 2025-11-18 真实故障:Core Entity 服务深层降级时,系统自动拦截了 950 万次多余请求(含直接调用方 20 万),否则按 10% retry budget 会造成 46%-135% 流量放大、延长故障。 适合微服务/SRE 从业者深挖 retry 策略与故障隔离设计。
评论点赞收藏29 天前

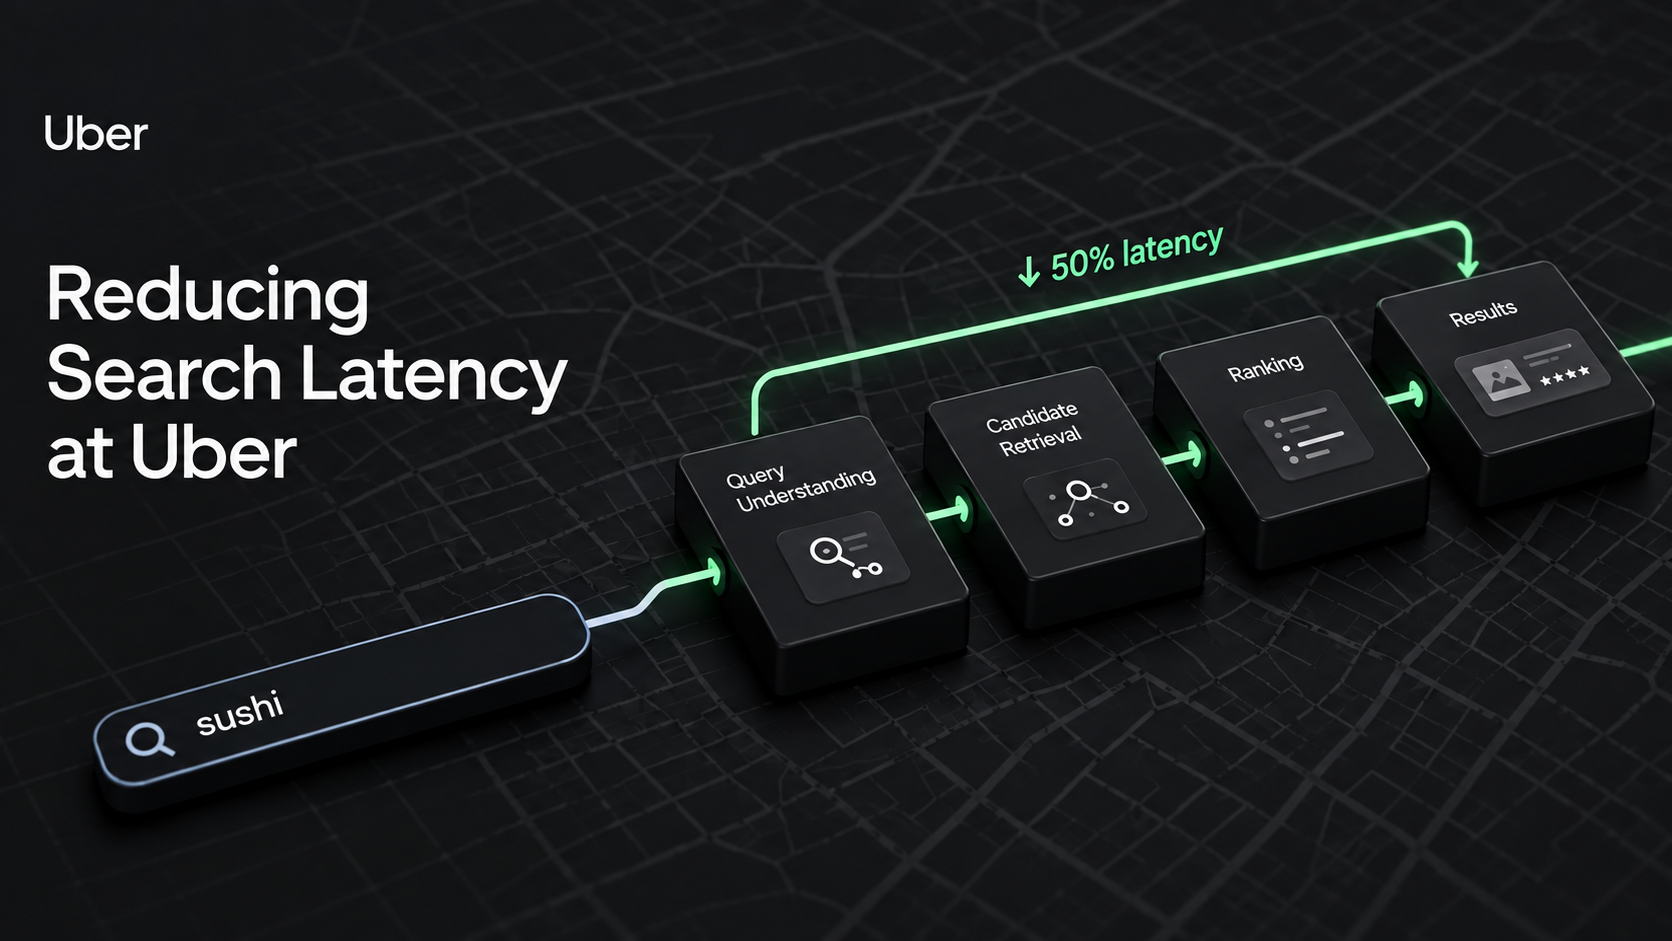
Uber Eats 重建其搜索流水线

Uber Eats 搜索团队通过多条并行工作流把端到端搜索延迟砍半,核心思路是"少做事、更早开做、持续度量"。关键改动包括:把主指标从后端 API 延迟改为 ATF(首屏渲染完成时间),引入服务端分页缓存 + 异步并行渲染,单点改进超 200ms;检索层删掉低收益的词法召回路径省约 120ms,用产品级 embedding 分组把数据查找量降 100 倍、延迟再省 50ms;把原本串行的一体化 hydration 拆成 ranking 与 presentation 两路并行,省 100ms+,并对执行图做假依赖清理和请求 hedging 降低尾延迟;广告子系统把行式数据改为列式 + 应用内存化,省约 130ms;基础设施细节层面(并行编码、embedding 精度压缩、连接池扩容、Go 值类型替代指针)合计再省约 200ms。 最有讨论价值的亮点是一个"Agentic Loop":给 AI coding agent 配上生产 latency 画像、自动开 PR、跑 benchmark 验证的闭环,迭代式修掉那些"单个不起眼但量大就累积"的热点路径浪费,且每个改动都有测量背书。 下一步计划包括 end-to-end microbatching(估算再省 100ms+)、product-based search(目录缩小约 100 倍,p99 已降 50%+)、ZPR(在索引层做早期打分过滤,目标省 30–50ms)以及 HTTP multi-part 流式渲染。 文章是典型的一线大厂工程复盘,细节密度高、数字具体,适合系统/搜索方向工程师读完评论。
评论点赞收藏32 天前

从单一水平伸缩控制器到多控制器:Uber 计算平台的演进

Uber 将 Kubernetes 扩容控制从单控制器拆分为多控制器架构,引入 ServiceScale CRD 和 Service Scale Controller,让故障转移调度器与原有部署控制器并存而不互相干扰。 关键踩坑:Kubernetes informer 缓存延迟导致终端状态字段误读;多写入者并发修改资源时出现 metadata-spec 漂移,甚至触发了上游 Kubernetes 的一个真实 bug(#135483),曾导致 proportional scaling 失效和服务卡死;团队通过可观测性检测、自动 healer 补丁和上游修复三层应对。
评论点赞收藏37 天前

GitFarm:面向大规模 Monorepo 的 Git 即服务

Uber 推出 GitFarm,把 Git 操作抽象成 gRPC 服务,用预热的仓库和容器池让客户端在 500ms 内拿到完整 checkout。读重服务 CPU 从 70+ 核降到 16 核、内存从 400-600GB 降到 32GB,启动时间从 15-20 分钟降到 1 分钟以内。 合规审计场景 p50 延迟从 110-160 秒降到 20-30 秒。核心思路:不存仓库、不替代 Git,而是作为云端集中式 Git 客户端,在隔离沙箱里替其他服务执行命令。
评论点赞收藏43 天前

Uber 裁员10%并收紧远程办公政策

Uber 宣布裁员约10%并同步推进组织重组。业务表现良好(5年多营收近翻三倍),但增长带来层级过多、协调成本高、决策慢等问题。具体措施包括:7层以上管理层减少20%、微团队减少近50%、合并外卖/零售/直连三个配送运营团队、合并核心服务工程与科学团队。 远程办公政策大幅收紧,仅约1%员工可远程,其余需回办公室,每周三天到岗。
评论点赞收藏45 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。