Daniel Lemire

Daniel Lemire,计算机科学教授,撰写关于高性能编程、数据结构与软件性能优化的技术博客。

Simdjson 5.0 发布了

simdjson 5.0 正式发布,核心变化:C++26 静态反射从实验性变为官方支持,反序列化时默认使用 key selectors(编译期构建完美哈希,单遍扫描即可按任意键序提取字段);新增注解宏(rename、alias、deny_unknown_fields 等)自动化序列化/反序列化。 流式方面支持 RFC 7464 JSON 文本序列、NDJSON 逐行跳过、slice_at 文档边界切分以多线程解析。性能上,数值密集文件解析提速 8%–25%,转义 Unicode 文件提速近 2 倍;浮点序列化用 Dragonbox 替换 Grisu2,数值文件序列化提速 1.3–1.7 倍。 其他:支持 NaN/Inf 可选解析、窄类型 getter、无填充缓冲解析、C++20 ranges 管道、DOM 反向迭代、Windows 内存映射、Fil-C 内存安全编译器。 作者 Lemire 附带了在 Xeon Gold 6548N 单核上的实测基准表。
评论点赞收藏2 天前

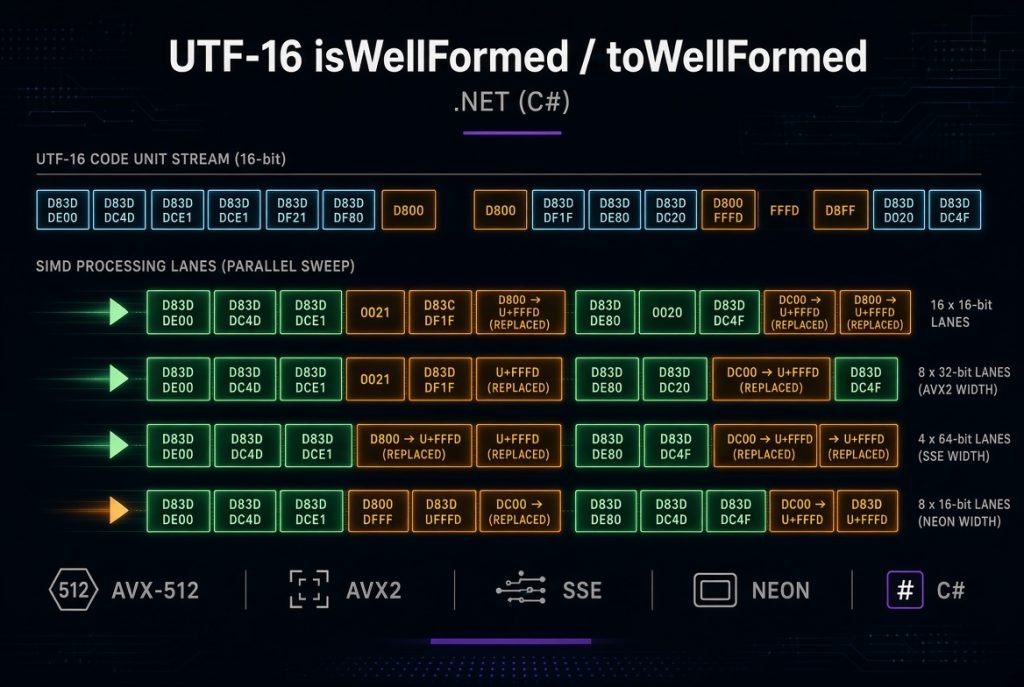
你在 C# 中能多快修复一个 UTF-16 字符串?

C# 字符串以 UTF-16 存储,表情等 BMP 外字符占两个 16 位码元(高代理+低代理),单代理或顺序错误即为畸形字符串,不应直接落盘或上网络。 作者将 JavaScript 引擎 V8 中的 toWellFormed / isWellFormed 思路引入 C# 库 SimdUnicode(PR 54),用 SIMD 指令实现并行校验与修复:畸形位置替换为 U+FFFD,输入合法时零拷贝直接返回原实例。 实测 Intel Xeon(AVX-512)上拉丁文本校验可达 69 GB/s,传统 IndexOfAnyInRange 仅 33 GB/s;纯代理对表情输入下传统搜索跌至 0.4 GB/s,而 SIMD 方案维持 53 GB/s。 Apple M4 Max 结果方向一致但相对差距较小。整体修复速度接近纯内存拷贝。论文发表于 Software: Practice & Experience(arXiv 2601.06349),含.NET 10.0 SDK 环境与源码链接。
评论点赞收藏4 天前

一篇论文不足以支撑一个博士学位

丹尼尔·莱米尔指出,过去博士学位基本等同于完成一篇论文。但现在 AI 能生成看似博士论文的文本,这让"以论文定学位"的模式失效。 哈佛方面已表态:论文不再能可靠评估学生能力,建议以多次、多面、在座的严格评估作为核心考核方式,并留档供就业参考。作者认为这是一个重大且紧迫的问题,AI 对学术评估体系的冲击已从理论变成现实。
评论点赞收藏4 天前

每周期不止一个已执行分支?

Daniel Lemire 用 Go 写了一个带 if 的循环基准,测试现代 CPU 是否真的"每周期只能执行一个已执行分支(taken branch)"。结果:Apple M4 Max 和 Intel Granite Rapids 在该测试中平均每不到 2 个周期完成两个已执行分支,说明在特定条件下确实可以每周期超过一个 taken branch;AMD Zen 4 表现最差,Zen 5 明显改善。 代码已开源,可直接复现。
评论点赞收藏4 天前

你每秒能创建多少个字符串?

Daniel Lemire 在 Apple M4 Max 上实测 7 种语言/运行时将 0 到 1 亿整数转字符串的速度,结果以百万字符串/秒计:C++ std::to_string 最快(183.8),Nim、Go、Node.js、Rust itoa、Bun、Rust std::to_string、Python str(i) 依次递减,Python 最慢(22.9)。 关键洞察:C++ 大幅领先得益于小字符串优化(SSO),短字符串直接存在对象内部,不触发堆分配;而 Rust、Go、Nim 每次都将字符串放堆上,速度反而与 JS 相近(12–16 ns/个),Python 因解释器开销最慢(44 ns/个)。 GC 运行时对大量短命小对象分配效率很高。附完整源码和版本信息,适合性能调优、语言选型或底层实现讨论。
评论点赞收藏5 天前

如果你没有工厂,你就会失去专业知识

Daniel Lemire 反驳"制造业岗位流失主要因自动化/机器人"的主流叙事,认为2000年后美国制造业岗位下降的主因是生产外包,而非技术进步。 他用数据论证:1985-2000年间产出指数从51涨到93,但就业基本稳定在1700万上下;2000年后产出停滞在100附近,就业却从1390万跌到1150万(2010),到2026年8月才回1260万。 劳动力生产率在2010年达到约100后十五年基本持平。核心论点:没有工厂就没有设计师——硅谷已很少能做硅芯片工程的人,魁北克能读机器人PhD但设计机器人必须去制造地。 技术红利需要本地制造能力来承接,光靠视频会议和远程设计无法规模化维持专业纵深。
评论点赞收藏6 天前

Faster JSON parsing with SVE2 on ARM processors

Daniel Lemire 跟进四月那篇"ARM 上最快字符匹配"实验,验证 SVE2 的 match 指令能否真正在 simdjson 解析器中带来收益。ARM 工程师 Madhurendra Purbay 向 simdjson 提交了 PR,用 SVE2 match 替代 NEON 四指令查找表,将 16 字节分类压缩到接近单条指令;结合 NEON-SVE 桥接指令,无需汇编即可在 GCC/clang 下编译。 在 AWS Graviton 4/5 实测:索引阶段吞吐提升 3%~9%(整体解析提升 1%~4%),结构化 JSON 收益更大、纯数字文件收益有限。局限:仅 SVE2 可用,Apple 芯片和 Graviton 3 仍走 NEON 回退;当前默认构建不启用 SVE2,Lemire 正在做运行时分发。 基准、脚本和 PR 均公开。对 ARM 性能工程与 SIMD 实践是一手、可读性高的技术观察。
评论点赞收藏6 天前

一个属于 AI 优化的夏天

Daniel Lemire(维护 ada、fast_float、simdjson、simdutf、Roaring 等多个被 GCC/Chromium/Node.js 等广泛使用的基础库的作者)公布了一个一手观察:过去十几年这些库性能基本持平,但 2026 年夏天六周左右,六个库同时出现明显提速。 他重建了每个库的全部提交并在 Intel Xeon Gold 6548N 上做基准,追踪 2024 年 8 月以来的加速倍数。结果:roaring(Go) 多路并集快 3.1 倍、迭代器快 4.5–5.9 倍;ada URL 解析从 0.54 GB/s 提到 1.28 GB/s(约 1500 万 URL/秒/单核);fast_float 两个数据集分别提速 43% 和 70%;simdjson 因 C++26 静态反射新增直接序列化/反序列化结构体,序列化指令数/字节从 6.1 降到 3.1,速度快 1.6–2.1 倍;simdutf ASCII 校验 83→160 GB/s;CRoaring(C) 64 位基数计算快 4.9 倍。 优化多由老合作者(Yagiz Nizipli 等)完成,部分人使用 Cursor/Claude/Grok/DeepSeek;其中一个贡献者甚至是 AI 工具 perfloop(Lemire 是顾问,已披露)。 他的核心判断:这些技术都是已知方法,真正变化是“试新想法变便宜了”,AI 把原本需要几天精力的微优化门槛降低,带来真实、可量化的公共利益(数百万开发者使用的库直接变快)。 文章立场清晰、数据具体,对 AI 编程是否真有用的争论提供了一手正面证据。
评论点赞收藏8 天前

Apple Silicon 如何在三年内快了近 50%?

作者用 Geekbench 6 对比 M2(2022)到 M5(2025)基础款 Apple Silicon:单核性能三年提升约 52%,多核提升 83%。归因上,P 核频率从 3.5GHz 升到 4.6GHz(+30%)解释了单核提升的大部分;晶体管数从 20B 增到 28B(M2→M4,+40%);M4/M5 多了 2 个 E 核;IPC 提升主要来自解码宽度从 8/cycle 增至 10/cycle;M5 内存带宽升到 154GB/s(LPDDR5X-9600),主要帮多核。 与 AMD 的对比中,Apple SIMD 始终是 4 个 128 位单元,远落后于 Zen 5 的 4×512 位,但 M4/M5 引入了新的 512 位 SME 矩阵单元。 文章最后简提了刚发布的 M6(10→12 核,含两个 super core,带宽再升),并给出整体判断:CPU 演进并不无聊,仍在快速进步。信息密度中高,数据点丰富,适合对处理器架构/性能有好奇的科技读者。
评论点赞收藏10 天前

AMD Ryzen 如何在两年内快了 50%?

Daniel Lemire 用 2022-2024 三代可比 8 核 3D V-Cache Ryzen 7(5800X3D/7800X3D/9800X3D)说明 CPU 并未停滞:Geekbench 6 单核从 2016 涨到 2969(约 47%),多核从 11832 涨到 18751(约 58%),而主频只提升约 15%。 性能增量主要来自晶体管数从 110 亿增到 160 亿并用于加宽核心:分派宽度 6→8、整数 ALU 4→6、ROB 256→448、L1D 32K→48K,SIMD 从 4×256-bit 升到 4×512-bit。 文末提到 Zen 6 与 256 核 Epyc Venice(1GB L3)即将到来,桌面核心规格未知。数据图表清晰,适合想理解近年 x86 单核进步从何而来的读者。
评论点赞收藏12 天前

C++23 的 std::flat_map 有多快?

Daniel Lemire 用真实基准(GCC 16.1、-O3、单核 Intel Xeon Gold 6548N)对比 C++23 新增的 std::flat_map 与 std::map。核心结论:flat_map 本质是"有序 keys 数组 + 平行 values 数组",可直接 memcpy 序列化、可用 std::sorted_unique 标签零拷贝重建;随机逐个插入在超过约 1000 个元素后呈二次方劣化,100K 时单次插入已达 7149ns(std::map 仅 253ns),不可用于大规模随机插入;但顺序插入、批量 insert_range/范围构造和随机查找都显著优于 std::map(10M 规模查找 flat_map 239ns vs std::map 980ns)。 作者强调用简单数据结构替换红黑树的实用性,并附开源基准代码。
评论点赞收藏12 天前

Intel 处理器上处理次正规浮点数代价高昂

Daniel Lemire 用 C++ 基准测试对比了 IEEE 浮点中"次正规数(subnormal)"在 Intel、AMD、Arm 和 Apple 芯片上的性能表现。结论很清晰:Intel 上涉及次正规数的乘法比正常数慢 45-50 倍,除法慢 18 倍,依赖链延迟从 4 周期飙到 128 周期;即使 1% 的次正规数占比,编译器的自动向量化也会让整块计算被拖慢。 AMD Zen 5 基本不受影响(乘法全速,除法慢约 2 倍),Graviton 5 和 Apple M4 Max 则完全无感知。文章附有 5 种内核在 5 款处理器上的详细数据表,并开源了测试代码。 对做数值计算、游戏引擎、ML 推理等需要极致性能优化的工程师来说,这是一份很实用的芯片级避坑指南,也解释了为什么"次正规数很慢"这句老话在 Intel 上依然成立、但在 AMD/Arm 上已不再适用。
评论点赞收藏15 天前

四色定理只是开始:数学家联名抵制AI,一位编程者反驳

几位数学家联名致信OpenAI,警告AI解题太快会动摇数学教育的根基——年轻人还会不会愿意花十几年苦功学证明。Daniel Lemire对此逐一反驳:AI生成证明照样可以研究, attribution问题没有证据表明AI比人更差,数学界对功劳的执念本身值得质疑。 他主张数学、法律、医学等领域的人最终都会学会与AI协作,拒绝的人就当艺术家。
评论点赞收藏18 天前

恐惧不是论点

Daniel Lemire批评AI末日论:历史上每一次新技术出现都会有类似的灾难预言,从Y2K到核末日,这些恐慌最终都被证明是过度的。他引用Thomas Sowell的观点指出,知识精英往往推动有害想法却无需承担后果。 真正的风险不在于AI毁灭人类,而在于科技巨头利用恐惧推动有利于自己的监管、排除竞争对手。与其沉浸在末日想象,应专注于实际防御、疾病治疗和太阳系探索。
评论点赞收藏20 天前

C 语言原子操作快速入门

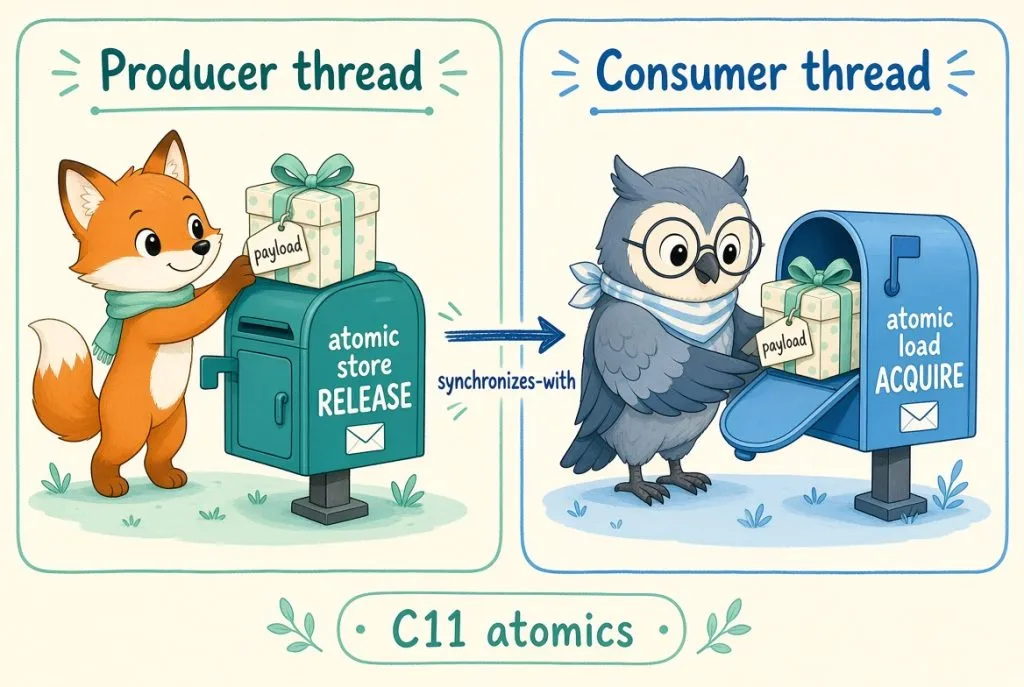
C11 atomics 实现线程安全的 copy-on-write 共享数组,演示 release/acquire 内存序的实际用法。 C11 threads 是可选特性,macOS 从未支持,glibc 2.28 才加入。文章用共享数组引用计数为例,说明 relaxed 内存序在释放资源时会导致 use-after-free,需要 release 保证写操作不被重排序、acquire 保证最后释放者看到其他线程已完成访问。 x64 上 acquire/release 几乎免费,ARM 需要额外指令。
评论点赞收藏20 天前

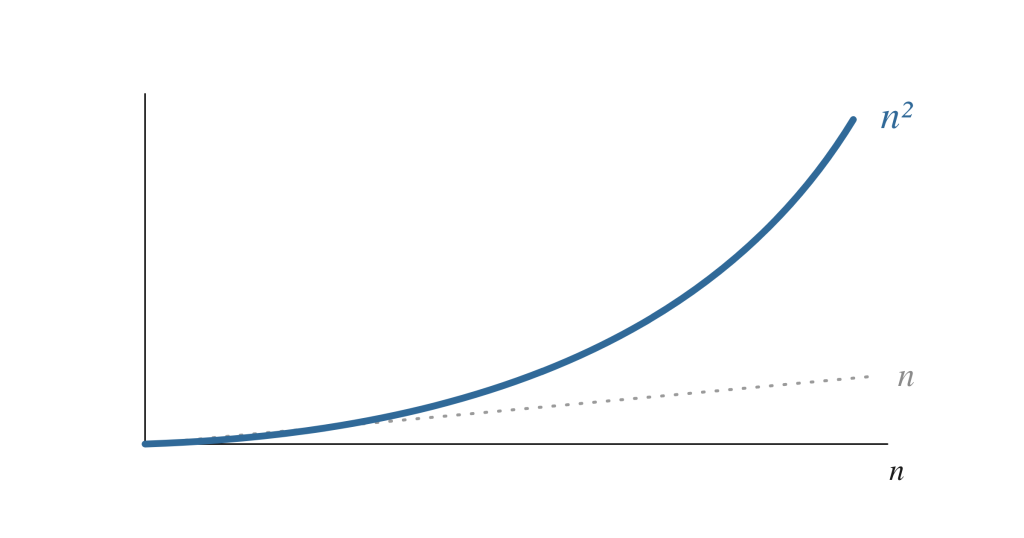
Python 的 dict 和 set 可能呈现二次时间性能

Python 的 dict 和 set 在最坏情况下会退化为 O(n²),且数据量增大时缓存未命中会让单次查找变慢近 10 倍。Daniel Lemire 用精心构造的哈希碰撞输入实测:16000 个元素时插入和查询各耗时约 1 秒,10 万元素时建集合需 45 秒。 另一组对比显示,100 万字符串键的 dict 单次查找从 22ns 升至 202ns,而 fastconstmap 库因每键仅占 9 字节常驻缓存,始终维持在 11.8ns。 结论:O(1) 是教学模型而非现实,大规模查找场景应考虑不可变紧凑映射。
评论点赞收藏22 天前

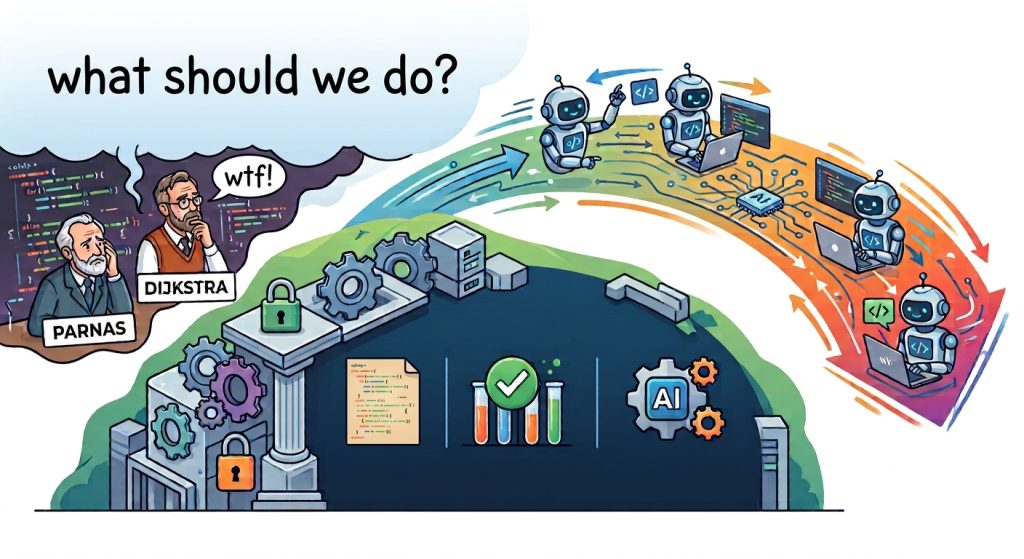
AI 编程的分层模型

Daniel Lemire 提出 AI 编程的分层模型:核心层保持小而稳定,人工阅读和测试,禁止"氛围编程";外层可以快速迭代,AI 自动修 bug。 他将当下 AI 辅助编程的代码膨胀与 1960-70 年代的软件危机类比,Parnas 和 Dijkstra 当年面对的问题正在重演。依赖关系必须单向:外层依赖核心,核心不依赖外层。
评论点赞收藏24 天前

Python 的 set 和 dict 可能呈现二次方时间复杂度

Python 的 dict 和 set 常被当作 O(1) 操作,但 Daniel Lemire 实测发现,精心构造的输入会让 set 插入和查询变成 O(n²)——16000 个元素时耗时 1072ms,10 万元素时建集合要 45 秒。 dict 查找同样随规模增长变慢,百万级时单次查找从 22ns 涨到 202ns,原因是缓存失效而非算法变化。fastconstmap 库通过紧凑内存布局把百万级查找压到 11.8ns。 O(1) 是教学模型,不是现实。
评论点赞收藏27 天前

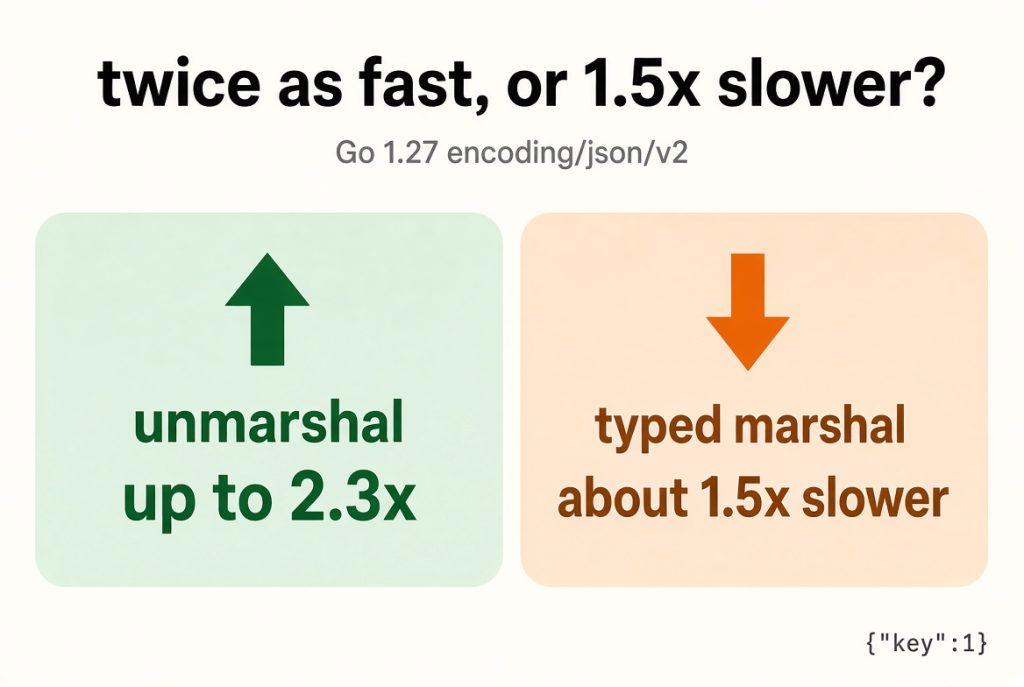
Go 1.27 新 JSON API:反序列化快一倍,序列化却慢了 1.5 倍?

Go 1.27 的 encoding/json/v2 反序列化全面提速,但序列化对带标签的结构体反而慢了约 1.5 倍,与官方发布说明声称的"性能持平"不符。 实测在 M4 Max 和 Xeon Gold 6548N 上,json/v2 反序列化比原版快 1.5x-2.3x,序列化快 1.2x-3x(针对 interface{} 路径);但对固定 schema 的结构体切片序列化,旧版反而更快。 legacy API 在 Go 1.27 上升级到 v2 后端后,序列化性能提升约 2 倍(twitter.json 从 198 MB/s 到 374 MB/s),无需改代码。
评论点赞收藏32 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。