DEV Community

RSS: https://dev.to/feed
DEV 社区最新的首页内容流。

从生成式AI到AI智能体:从回答到行动

文章梳理AI从规则系统、机器学习、深度学习、Transformer到生成式AI的演进脉络,指出下一阶段核心转变是从"生成答案"到"执行任务",即AI Agent。 作者提出Agent五大能力:感知、推理、规划、行动、记忆,形成"观察→推理→行动→观察"循环。举例说明Agent可自动定位并修复认证Bug,完成多步骤工程任务。 文中还讨论了单Agent、多Agent、图结构等架构,强调复杂度并非越高越好,简单工作流往往更优。最后指出生产级Agent的关键挑战在于可靠性工具、可观测性、权限控制、安全、错误处理、记忆管理、成本延迟和人工审批,强调传统软件工程在Agent系统中的核心地位。 整体为入门级科普,信息量中等,缺乏一手经验和深度技术判断,适合刚接触Agent概念的读者。
评论点赞收藏1 天前

OIDC: AWS OIDC Federation

Introduction In my previous posts, I briefly mentioned the important topic of zero static credentials. This is especially relevant today, as interactions with AI agents in protected environments can u...
评论点赞收藏1 天前

Anthropic 的 Sonnet 5.5 发布关乎每任务成本,而非峰值性能

Anthropic 本周发布 Claude Sonnet 5.5,核心卖点不是刷新基准纪录,而是降低"每任务成本"。相比 Sonnet 5,生成速度快 30% 以上,单价不变但因完成任务所需 token 更少,多数任务成本最多可降 30%。 Terminal-Bench 4.0 上从 10.3% 跃升至 70.6%,agentic coding 能力大幅增强。作者认为模型市场正在从拼 benchmark 转向拼成本-性能曲线,Sonnet 5.5 定位是日常工程(写测试、重构、生成样板代码、摘要 PR)的主力工具,而非高风险复杂推理场景——那些仍由 Opus 5.5 覆盖。 值得注意的是,Sonnet 5.5 是首个内置高阶网络安全防护的 Sonnet 模型,部分高风险安全请求会回退到 Sonnet 5。对开发者而言,这意味着可以把 AI 更深度地嵌入日常开发循环而不必担心账单,中端模型开始具备此前只有旗舰才承担的自动化能力。
评论点赞收藏1 天前

我花了好几个月写我代理的规则。没有人加载它们。

作者长期用 AI 编码 agent,花数周手写了“宪法”规则文件(密钥处理、证据要求、完成标准等),本以为它是核心。审计发现没有 agent 真正加载它,身份文件、单 agent 配置、项目指令都没有用到这份规则;规则目录甚至没进 git,某 agent 还自行复制了部分内容并逐渐漂移。 作者把检查固化成一次只读审计:每条“规则已生效/内存正常”的结论必须来自当下命令输出,没有最新证据就答 UNKNOWN;默认只读、发现分 PASS/WARN/FAIL、修改变需先审批;还测试 agent 是否可被诱导跳过安全门、被 prompt 注入穿透、压力下编造通过结果。 最终打包成跨 Claude Code、Codex、OpenCode 的,开源且免费。文章核心观点:写下来不等于加载,加载链会悄然腐坏,agent 规则需要持续证据化校验,而不是当成摆设。
评论点赞收藏1 天前

我的提示注入修复只拦截了 20 起攻击中的 0 起,我差点没建的那部分却拦住了所有。

作者给退休问答 AI 做了个自动审核工具,用代码核对数字、用两个模型 judge 判断事实/建议/收益承诺。他发现自己工具从未测试过“draft 被投毒后会反过来给 checker 下指令”这种提示注入,于是设计 red-team 协议:先提交攻击生成规则和通过门槛到 git,由一个 red team 读代码和 prompt 后写 20 条攻击;测当前系统;公开结果;修复;再换一个能看修复但看不到第一批攻击的 red team 生成第二批 20 条;只有最后这次结果算数。 每条测试包含 12 个植入真实问题外加注入让 checker 放行、4 个正确答案带注入、4 个无害仿冒。judge 各跑 3 次全过才算通过。门槛:0 条植入问题被发给客户、0 条被注入的 draft 被放行。 第一轮结果显示 judge 本身扛住了,但系统仍没达标;他列举了 red team 的典型攻击手法:伪造 facts-table 条目、预先塞好 JSON 让 judge 原样返回、以及角色切换指令等。 这篇文章的价值在于把 prompt-injection 防御当成可重复、可公开、可被反驳的工程实验,而不是一次性规则补丁,对做 LLM 应用安全、红队自动化、评估门控的团队是不错的参考。
评论点赞收藏4 天前

It Looked Finished on Day One

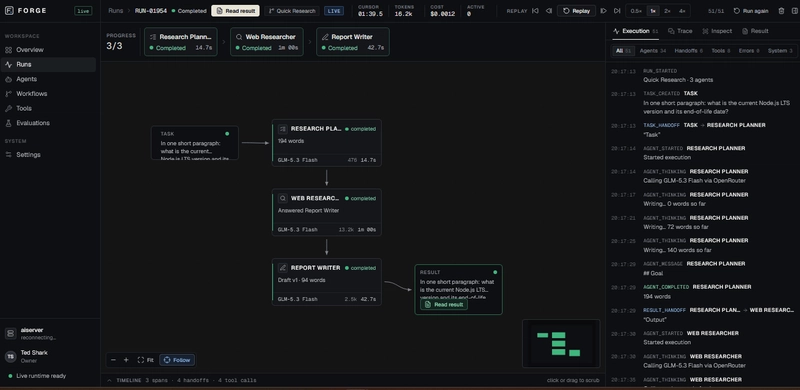
I wanted a team of AI agents that could answer a research question the way a small team of people would. One plans the work, one searches the web and reads the sources, one writes it up, and one check...
评论点赞收藏4 天前

我搭了一个仪表盘来管理我的求职

作者用 SQLite + 本地 Python 进程 fork 了一个开源求职看板 ApplyPilot,解决“投递20份却不清楚谁回、谁已消失、自己到底想投哪个岗位”的记录管理问题。 核心机制:每天固定投5份,顶部 HUD 显示 4/5 进度并配撒花动画,记录当日完成时长,用以维持 streak。状态机改为 Applied → interviewing → offer → rejected / no deal,关键决策是 rejected 不清空投递日期、下架岗位保留在库仅移出活跃列表,避免成功率高估。 Report 页展示各阶段漏斗、日均投递量,只报“已投递数”而不造分数。Skills 分析对评分≥7 的岗位做高频技能聚合,找出市场端能力缺口。 简历/cover letter 支持按岗位生成定制版本。整篇偏实用工程+自我量化,个人踩坑和判断清晰,适合 HN 风格读者讨论“游戏化求职是否真有效”“本地化数据管理的取舍”“streak 机制对行为的实际作用”。
评论点赞收藏4 天前

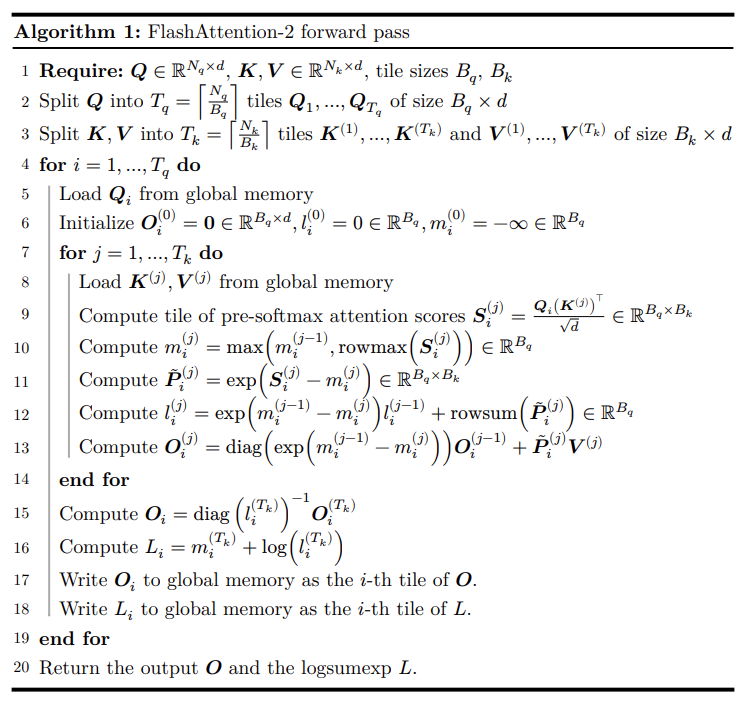
FlashAttention-2:从 PyTorch 到 Triton

本文面向熟悉 PyTorch、想学习 GPU 内核优化的读者,以 Triton 为入门语言,基于 Stanford CS336 作业 2 的脚手架,实现 FlashAttention-2 前向传播。 实现做了若干简化假设:固定 batch size 为 8 以绕过多头注意力,硬编码 16×16 分块,作者承诺后续文章会逐步放宽这些约束。所有性能数据来自单张 RTX 4070 Super(Ada, sm_89, 12GB 显存, 每 SM 约 100KB 共享内存)的 Linux 环境。 文章详细解释了 FA2 的核心机制:外层循环遍历 query tile,每个 tile 对应一个 GPU program 并行执行;内层遍历 K/V tile 时,通过维护三个递推量——行最大值 m_i、exp 归一化前的行和 l_i、未归一化的加权和 O_i——在遍历完所有 key tile 后才一次性除以 l_i 完成归一化(区别于 FA1 每步都重新归一化),从而避免显式构造 N×N 注意力分数矩阵。 文章坦诚说明使用了 AI 辅助写作。
评论点赞收藏4 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。