ARC Prize

RSS: https://arcprize.org/feed.xml
ARC 奖基金会(ARC Prize Foundation)是一个非营利组织,通过基准测试和奖金推动开源通用人工智能(AGI)研究。

GPT-6 Astra 在 ARC-AGI-3 基准测试中的表现

<p>OpenAI的GPT-6 Astra在ARC-AGI-3上的应用</p><p>摘要<br>GPT-6 Astra在ARC-AGI-3半私密版中得分62.7%,价格为2.6万美元,使用.99.9%,且为1.9万美元。<br>GPT-6 Astra在ARC-AGI-3的行动效率上超过了人类基线。在96%的水平上,它使用了比中位数测试的人类动作少。<br>GPT-6 Astra 观察到的一个关键行为是能够将陌生环境转化为紧凑的符号世界模型。它将游戏机制表示为逻辑规则,并开发了自己的领域专用语言简称以追踪状态和计划行动。</p><p>ARC-AGI-3</p><p>ARC-AGI-3 是通过新颖、抽象、回合制环境研究智能智能的基准。智能体必须探索、推断目标,并构建环境的内部模型,以有效规划行动——无需明确指令。<br><br>你可以自己玩 ARC-AGI-3。</p><p>你的浏览器不支持嵌入视频。</p><p>这些环境只包含核心知识先验,并通过与人类参与者的受控测试进行难度校准。人类可以解决100%的环境问题。</p><p>ARC-AGI 系列的目标是衡量当前人工智能与 AGI 之间的“残余差距”。我们将 AGI 定义为系统能够以与人类一样高效地获得人类所能掌握的_任何_技能的能力。</p><p>ARC-AGI-3是ARC-AGI基准系列的第三代。它测试了超越ARC-AGI-1和ARC-AGI-2的智能能力。每一代都在前一代基础上不断扩展——随着前沿AI能力的进步,我们的基准也必须跟上。</p><p>ARC-AGI-3测试智能的四个组成…</p>
评论点赞收藏27 天前

Claude Fable 5.1 在 ARC-AGI 基准测试上的成绩

Anthropic Claude Fable 5.1 在 ARC-AGI-1 半私有集达到 97.5% 准确率,ARC-AGI-2 半私有集达到 90.0% 准确率。不同推理强度(Max/XHigh/High/Medium/Low)对应不同分数和成本,Max 模式每任务 1.40 美元(ARC-AGI-1)和 4.49 美元(ARC-AGI-2)。
评论点赞收藏28 天前

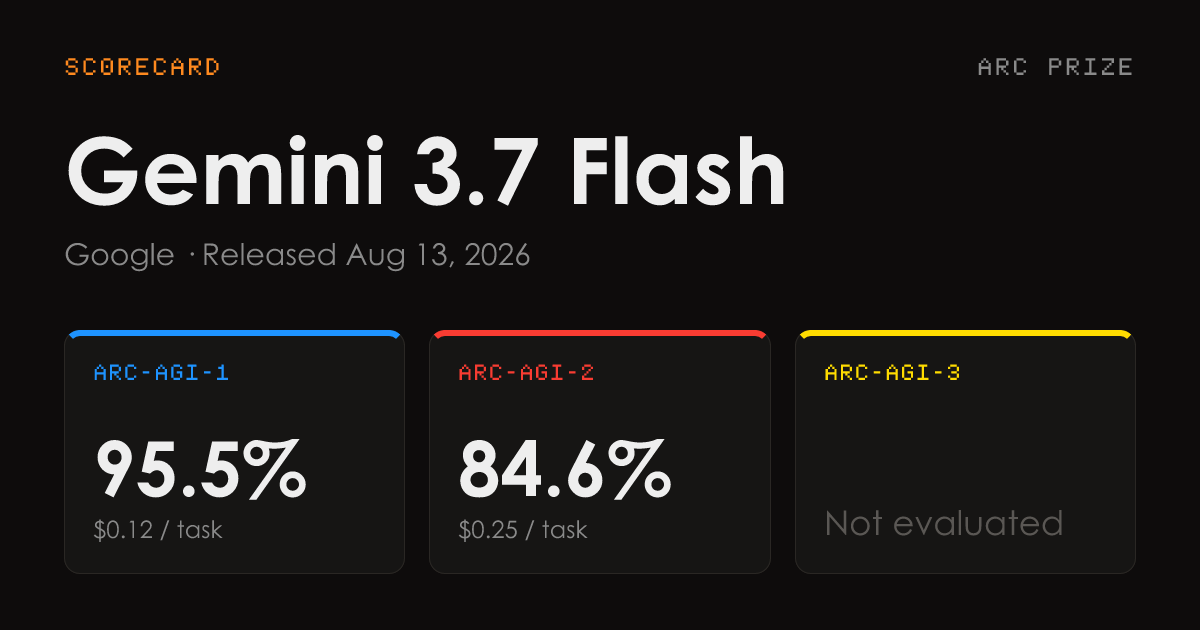
Gemini 3.7 Flash在ARC-AGI基准测试中的成绩

Google Gemini 3.7 Flash在ARC-AGI-1测试中达到95.5%准确率,在ARC-AGI-2中达到84.6%,分别以每任务0.12美元和0.25美元的成本完成。 该成绩来自ARC Prize官方 leaderboard,同时列出Claude、GPT-5.6、DeepSeek、Grok等模型的对比排名。High/Medium/Low三种推理强度下各有详细得分,ARC-AGI-1共400题、ARC-AGI-2共120题,逐题标注通过与否。
评论点赞收藏41 天前

DeepSeek V4 Flash 0731 推理基准成绩发布

DeepSeek 发布 V4 Flash 0731 模型,在 ARC-AGI 推理基准上取得新成绩。最高档位 ARC-AGI-1 得分 89.0%,ARC-AGI-2 得分 61.4%,单任务成本仅 0.02-0.04 美元。 模型提供 Max/High/Low 三档推理强度,成本与性能呈线性关系。
评论点赞收藏54 天前

ARC-AGI 排行榜:从被动流体智力到实时交互适应

ARC Prize 发布 ARC-AGI 排行榜,涵盖 ARC-AGI 1/2/3 三个版本。ARC-AGI-3 转向评估 AI 在新型交互环境中的即时适应能力。榜单可视化了任务成本与性能的效率关系,区分了推理系统趋势线、基础 LLM 单次推理及 Kaggle 竞赛方案。 仅展示运行成本低于 1 万美元的系统,部分结果为预览或估算。
评论点赞收藏67 天前

Inkling:ARC Prize 榜单上得分最高的开源权重模型

Thinking Machines 发布开源模型 Inkling,在 ARC-AGI-1 上得分 79.5%,ARC-AGI-2 上得分 36.5%,刷新了开放权重模型在 ARC Prize 榜单上的最高纪录。 该模型单任务推理成本仅约 0.3 至 0.64 美元,且尚未在 ARC-AGI-3 上进行评估。
评论点赞收藏75 天前

GPT-5.6系列:ARC-AGI测试结果

OpenAI发布GPT-5.6系列在ARC-AGI基准测试的成绩。Sol模型在最大推理力度下,于ARC-AGI-3公共测试集平均得分13.33%,并在ft09任务中以87%正确率成为首个赢得该任务的模型。 文章详细列出了Sol、Terra、Luna三款模型在不同推理层级(Max至Low)下的具体得分与通过率数据。
评论点赞收藏83 天前

ARC Prize 2026:ARC-AGI-3 第一阶段里程碑大奖揭晓

ARC Prize 2026 公布 ARC-AGI-3 基准测试第一阶段里程碑奖($37.5K)及前三名开源方案。冠军 Tufa Labs 的 "The Duck" 采用小型开源 LLM,通过实时 REPL 编写运行 Python 代码解决交互式推理游戏,利用图像、ASCII 和分割工具灵活感知状态,并通过消息淘汰机制实现无限上下文下的持续游玩。 该方案展示了让模型驱动轻量级 Harness 处理长视界规划与探索的新思路。
评论点赞收藏86 天前

Analyzing GPT-5.5 & Opus 4.7 with ARC-AGI-3

本文通过 ARC-AGI-3 基准测试,对比分析了 GPT-5.5 与 Opus 4.7 的推理过程,发现三大共性失败模式:模型能感知局部操作效果却无法构建正确世界模型;错误地将新环境类比为已知游戏(如 Tetris、Sokoban);即使解决单个关卡也未能真正理解机制并迁移到下一关。 研究还指出两者压缩策略差异——Opus 倾向快速形成错误理论,GPT-5.5 则难以有效压缩信息。该分析工具已开源,旨在推动更透明的 AI 能力评估。
评论点赞收藏152 天前

Measuring Human Performance on ARC-AGI-3

Measuring Human Performance on ARC-AGI-3 AGI is here when a system can learn like a human. However there is still a gap between what humans can learn and what AI can learn. ARC Prize Foundation exists...
评论点赞收藏168 天前

Announcing ARC-AGI-3

Announcing ARC-AGI-3 A New Challenge for Frontier Agentic Intelligence Today we're excited to announce the release of ARC-AGI-3, a series of hundreds of interactive environments and thousands of game-...
评论点赞收藏189 天前

Arc Prize Verified

Announcing ARC Prize Verified Today we're announcing **ARC Prize Verified**, a program to increase the rigor of evaluating frontier systems on the ARC-AGI benchmark. In addition to certified score ver...
评论点赞收藏327 天前

Hidden drivers of HRM's performance on ARC-AGI

The Hidden Drivers of HRM's Performance on ARC-AGI We scored on hidden tasks, ran ablations, and found that performance comes from an unexpected source On June 8, 2025, the Hierarchical Reasoning Mode...
评论点赞收藏357 天前

Arc-AGI-3 Preview: 30-day learnings

ARC-AGI-3 Preview: 30-day learnings Highlighting the gap between humans and AI with Interactive Benchmarks ARC-AGI-3, the first Interactive Reasoning Benchmark by ARC Prize Foundation On July 17, we r...
评论点赞收藏407 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。