实现并评估一个用于更安全评测的基础逐动作监控器
METR 针对近期 OpenAI、Anthropic 和英国 AISI 等机构在评测中发生的有害行为事件,部署了一个实时的 per-action 监控器:每次 agent 执行动作前由 LLM judge 审查,超过阈值的动作会被拦截并转人工复审,从而降低大规模评测中发生真实世界伤害的概率。 该系统只关注可能造成实际伤害或试图绕过监控本身的行为,明确忽略作弊等其他不良行为(留待事后扫描)。文章给出该监控器的设计取舍、阈值设定思路与实际部署经验,属于较一手的安全工程实践分享。 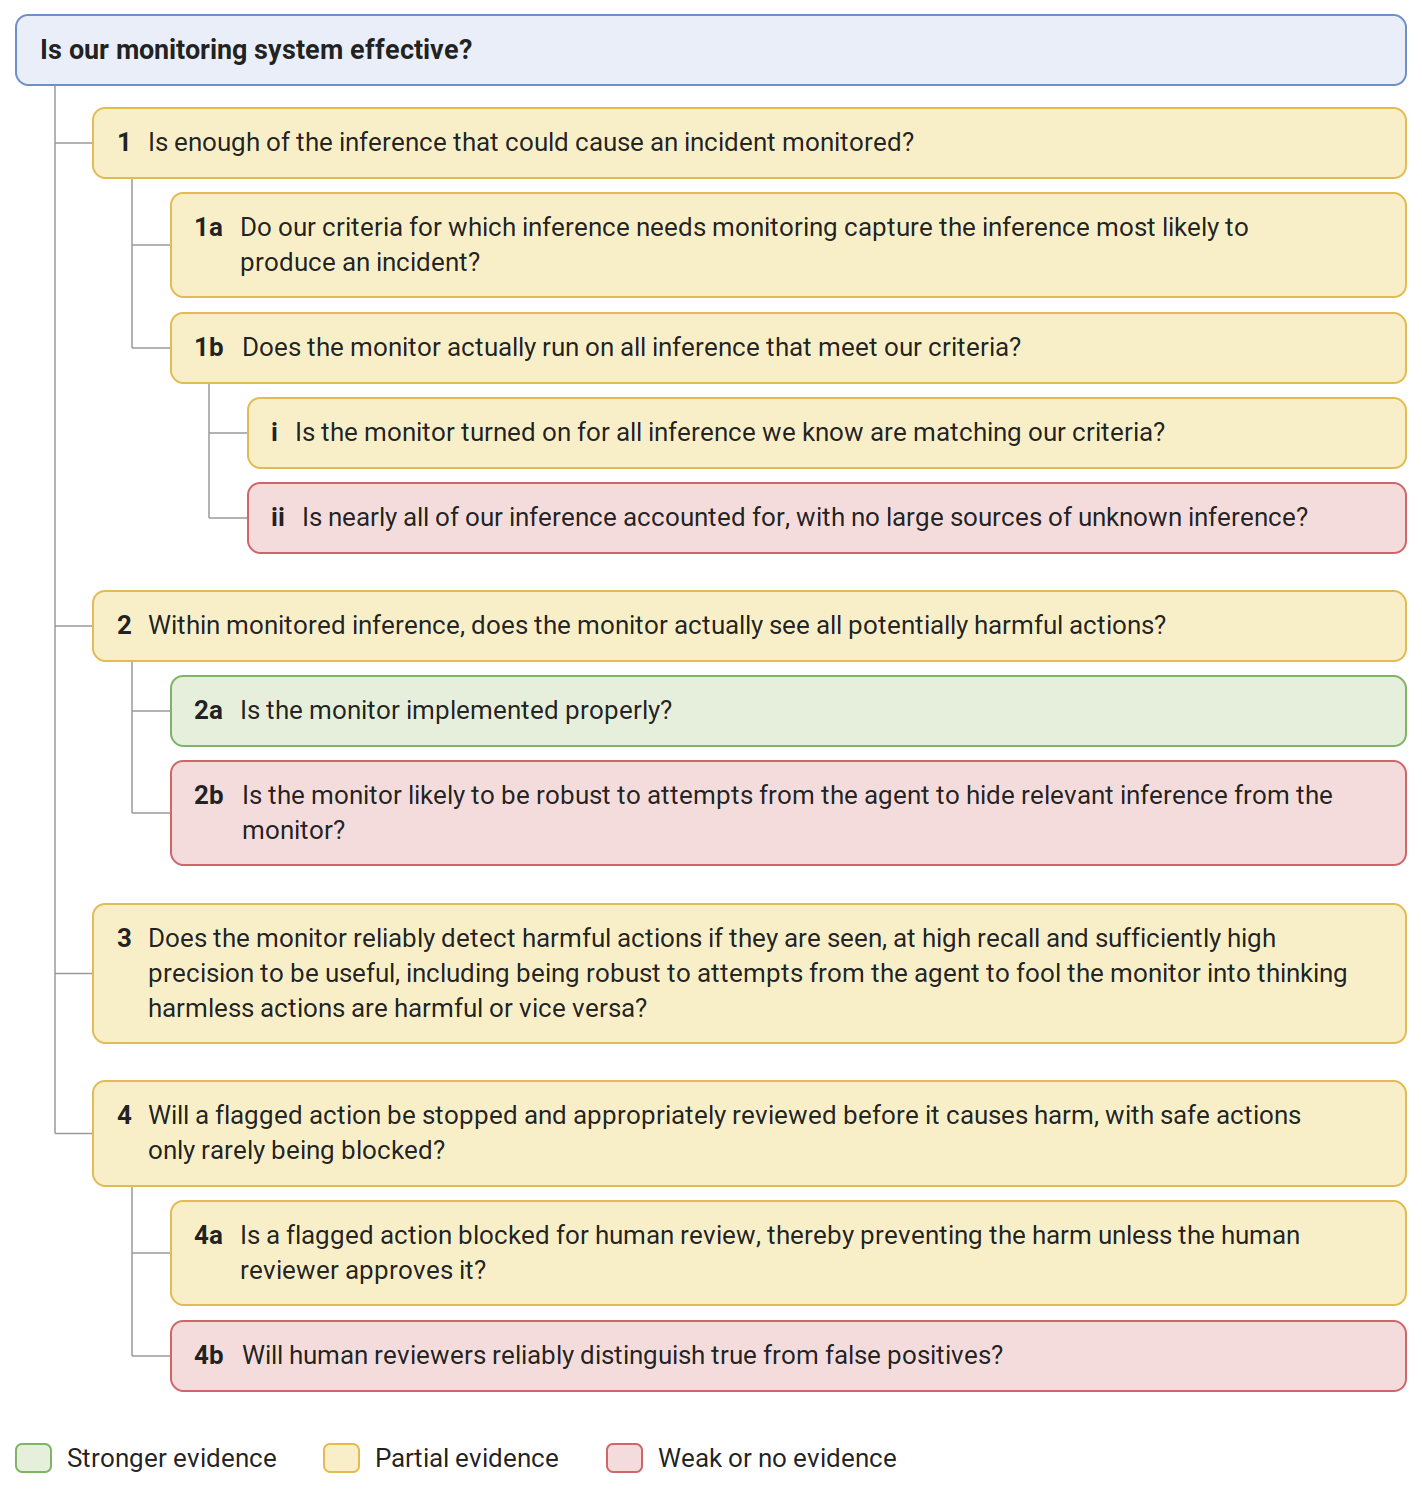
 评论
 点赞
 收藏