Doug Turnbull

RSS: https://softwaredoug.com/feed.xml
Doug Turnbull 的技术博客,专注搜索(Elasticsearch)、相关性工程与数据。

用 LLM 搜索相关性评估时,检查两次,再做一次判断

作者基于 WANDS 家具电商搜索数据集,探讨如何用 LLM 做 pairwise 搜索相关性评估,并与人类标注员偏好对齐。核心发现:(1) 允许 LLM 回答"不确定/两者都不是"可提升 precision 但大幅降低 recall;(2) 关键技巧是"双向检查"——交换 LHS/RHS 产品顺序各问一次,取两次一致的结果,可显著消除 LLM 的位置偏差;(3) 组合"双向检查 + 允许弃权"可达到最高 precision(90.76%),但 recall 降至 11.9%。 作者还对比了仅用 product name、class、分类层级、description 等不同字段的评估效果,给出完整的 confusion matrix。对做 LLM-as-judge 搜索评估的团队有直接工程参考价值,"双向检查去位置偏差"是一个实用且易被忽略的技巧。 文末有课程推广。
评论点赞收藏1 天前

用 Jev 在搜索上作弊

Doug Turnbull 用 Jev 这个 AI 搜索引擎做了一次查询理解任务的快速测试,探索其基本能力。标题"Cheating at Search"带有自嘲和调侃色彩,暗示用 AI 搜索来"作弊"完成传统搜索无法直接解决的问题。 对关注 AI 搜索新工具和实践的读者有一定新鲜度,但内容偏短、测试深度有限,更像一次轻量体验分享。
评论点赞收藏7 天前

用经典机器学习应对“笨”的 LLM 裁判(2025)

作者在自己笔记本电脑上用本地 LLM 做电商搜索相关性评估,不依赖 OpenAI。文章的核心思路是:先让 LLM 对“商品名、分类、类目路径、描述”等单一属性分别做很“笨”的二选一判断,再把这些判断作为特征,用经典机器学习(先试 scikit-learn 决策树)去预测人工标注的偏好,从而得到一个可解释、可缓存、成本低的“搜索质量裁判”。 文中给出了不同提示策略(强制决定 vs 允许说“不知道”、单次 vs 双向 double-check)的 precision/recall 表格:例如在商品名上,双向检查并允许“Neither”时覆盖率只有约 11.9%,但精确率升到 90.76%;而强制每次给答案虽然覆盖 100%,精确率只有 75.08%。 用全部字段的“uber prompt”也能得到类似 tradeoff(如 force+double check 约 91.72% 精度 / 65.2% 覆盖)。之后把多个 attribute-level 预测拼成特征表,用决策树训练,最佳子集在约 40% 覆盖率下达到 96%+ 精度;作者强调这只是 lab notebook 式数据点,还提到可尝试梯度提升等。 整体是一篇工程师实操向帖子,提供可复用脚本、数据集(Wayfair WANDS)和代码,讨论入口在于“LLM 作为特征生成器+经典 ML 组合”是否值得推广。
评论点赞收藏13 天前

Grug 式评测:别迷信完美指标

作者用"Grug Brain"自嘲式表达,直接挑战搜索团队对 NDCG 等"完美指标"的执念:评测的真正作用不是衡量系统"好不好",而是确认"改动是否做到了我们想做的事"。 他批评过度建模的代价——为消除误差反而引入更复杂的误差,团队被绕晕。他推荐 5 步简单循环:圈定一批要解决的查询 → 找内部用户 10-20 条标注 → 迭代让这批的 NDCG 变好 → 对旧查询做回归 → 回到第 1 步。 真正的"质量"判断留给 A/B 实验和可用性测试,与意图评测严格解耦。文章同时澄清:当确实要训练一个模型时,仍然需要"Big Brain"级严谨的标注和点击模型方法论,但多数团队还在为 Elasticsearch 调相关性,应先"笨点"做完当前循环再谈模型。 结尾明确反常识结论:把意图评测和质量建模强耦合才是复杂度灾难。对做搜索、RAG、agent 工具调用评测的工程师,这是能触发团队内激烈讨论的立场文,且作者(AI Powered Search 作者)背景增加分量。
评论点赞收藏13 天前

新AI团队的三个常见错误

新AI团队常犯三个错误:一是忽视评估,把50%精力放在理解问题上而非直接构建;二是把检索当checkbox,没意识到检索质量决定AI输出质量;三是把context等同于chunk,忽略了结构化元数据对LLM判断的重要性。 作者基于多年搜索团队顾问经验,认为AI团队本质是搜索团队,需要工程与数据科学的交叉能力。
评论点赞收藏32 天前

向量数据库更新:HNSW 算法的工程权衡

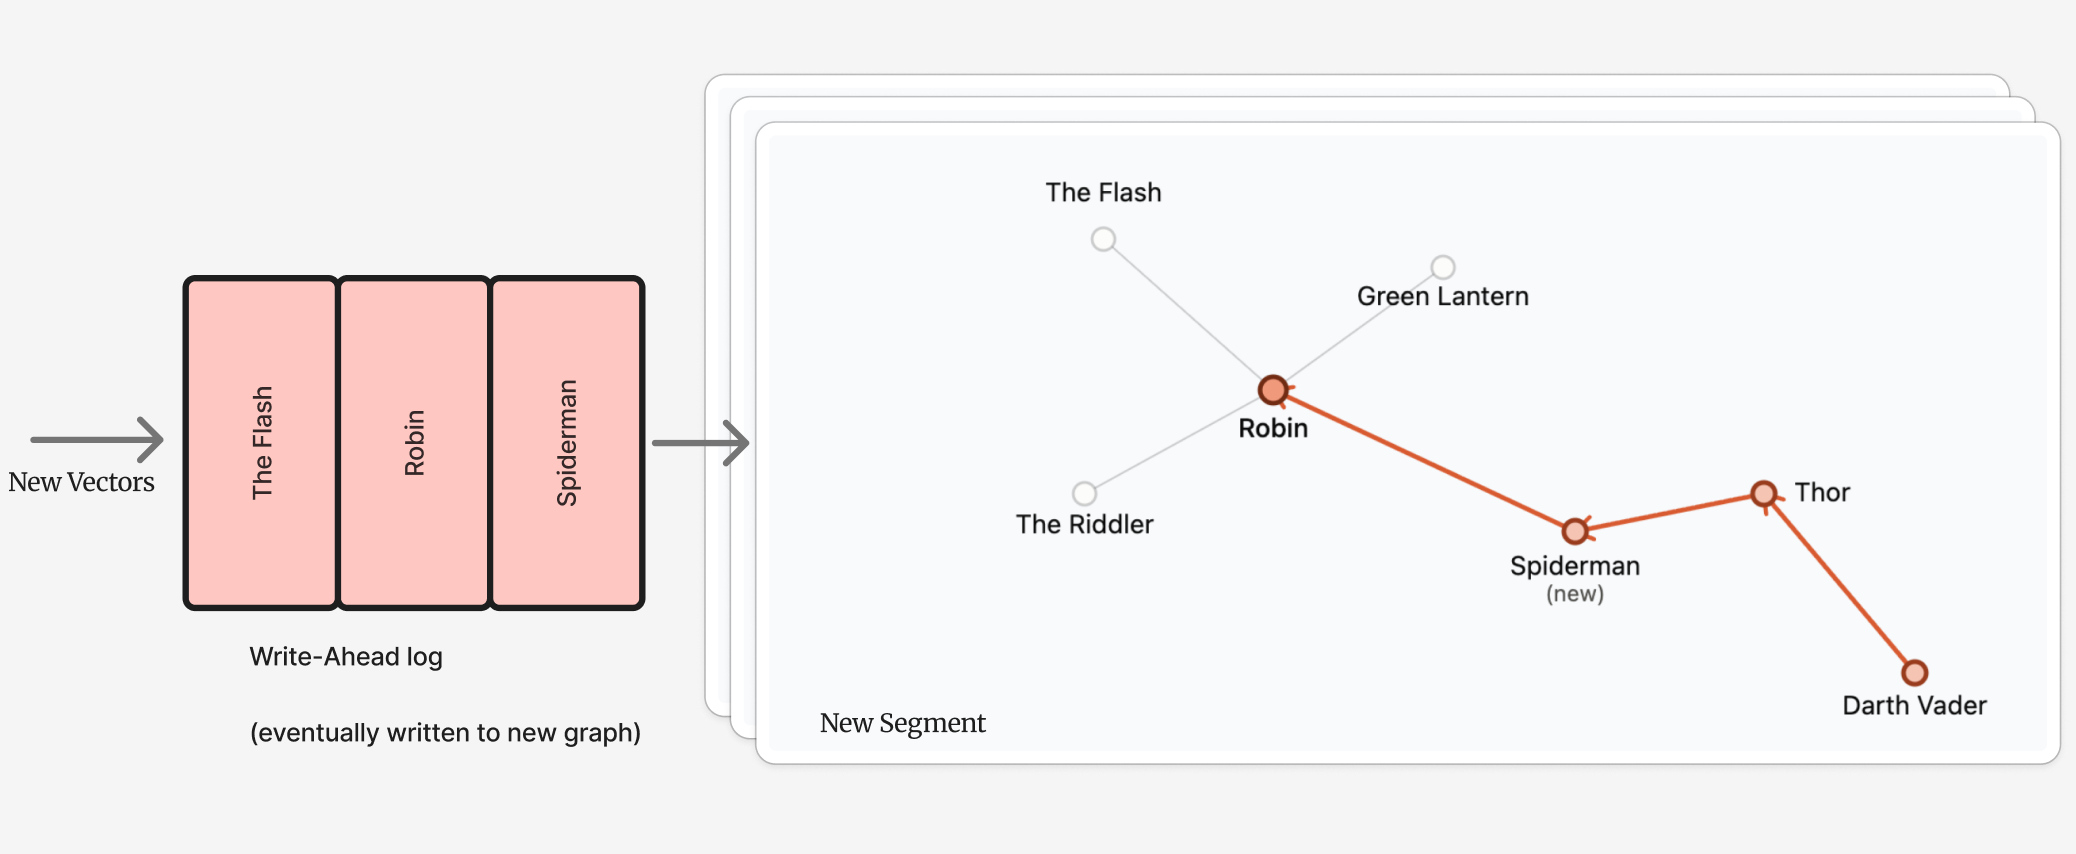
HNSW 向量搜索在生产环境处理更新时存在显著工程权衡,大多数系统采用删除标记加分段合并而非原地修复图结构。Lucene 用写前日志排队插入,新数据不会立即可搜索——实测数据:每1000向量提交查询延迟0.064秒,每50000向量提交仅需0.002秒。 Vespa 和 Weaviate 维护单图策略,与 QDrant、Milvus 的分段方案不同。建议用真实生产流量做影子测试,而非仅依赖小规模基准测试。
评论点赞收藏34 天前

Elasticsearch 混合搜索策略实测:从 BM25 到分层 Boost 的 NDCG 对比

在 WANDS 家具电商数据集上实测 Elasticsearch 混合搜索策略,纯 BM25 均值 NDCG 0.70,纯 KNN 0.70,RRF 融合仅 0.71,而三级分层 boost 策略(全词匹配 100x + 任意词 10x + 纯向量 0.1x)加上商品名 boost 后均值 NDCG 升至 0.75、中位数 0.84。 RRF 单独使用增量收益有限,关键在 lexical filter + vector ranking + 分层 boost 的组合。代码和评测脚本已开源。
评论点赞收藏49 天前

别做分类,让模型幻觉

用幻觉分类替代结构化输出,用廉价模型生成假分类再用向量匹配到真实类目。传统做法是把几百个合法分类值作为 Pydantic Literal 发给 LLM,既占 token 又有上下文上限。 新做法是让便宜模型自由编造分类,再用 MiniLM 向量检索找到最接近的真实类目。Wayfair 电商数据集实测可行,能大幅降低成本。
评论点赞收藏50 天前

别做分类,让模型去幻觉

用廉价小模型"幻觉"出虚构分类,再用向量相似度映射到真实类目表,替代传统结构化输出做查询分类。Wayfair电商数据集实测,省去每次发送完整schema的开销,适合大规模场景降本。
评论点赞收藏51 天前

别分类,去幻觉

<p>在大规模应用中,用于LLM分类的一个有用模式是:让其生成看似合理、假想的实体,然后将其识别为真实实体。</p>
评论点赞收藏51 天前

直接用暴力方式处理嵌入向量

小语料库直接用暴力搜索向量,能省运维麻烦。Doug Turnbull 指出朴素方法在数据量小时足够有效,无需过度追求复杂检索架构。
评论点赞收藏63 天前

深度解析LambdaMART:从零实现与原理拆解

用Python从零实现LambdaMART算法,详细拆解了如何通过Pandas自连接高效计算DCG交换影响,以及利用rho加权误差进行梯度提升的集成训练过程。 适合需要深入理解Learning to Rank底层原理及工程落地的搜索推荐工程师。
评论点赞收藏79 天前

别问你想要什么,问问你想成为谁

提出职业迷茫时,问“想要什么”不如问“想成为谁”。通过斯多葛哲学视角,将抽象价值观转化为具体情境下的行为选择,以内心自豪感和道德罗盘替代对外部结果的执念。 文末附带搜索代理课程推广。
评论点赞收藏79 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。