模型到底多有效地在用它的记忆?(2025)
Liquid 团队提出 Effective State-Size(ESS),用来衡量深度学习序列模型(attention、SSM、gated conv 等)在相同状态/缓存大小下真正"用了多少记忆"。 核心思想:这些模型可写成 y = T(u)u,其中 T(u) 是输入相关矩阵;扩展经典信号处理结论后,证明任何等价递推实现的状态大小至少要达到 T(u) 子矩阵的秩,这个秩就是 ESS。 由此得到几条实用结论:ESS 高的模型更难蒸馏到更小状态的学生模型;ESS 能指导初始化与特征化以提升召回性能;把 ESS 逐时间步跟踪可看到模型如何随上下文调整记忆使用(例如 EOS token 附近变化更明显的 LLM 在召回密集任务上表现更好)。 论文已被 ICML 2025 接收,全文在 arXiv 2504.19561。 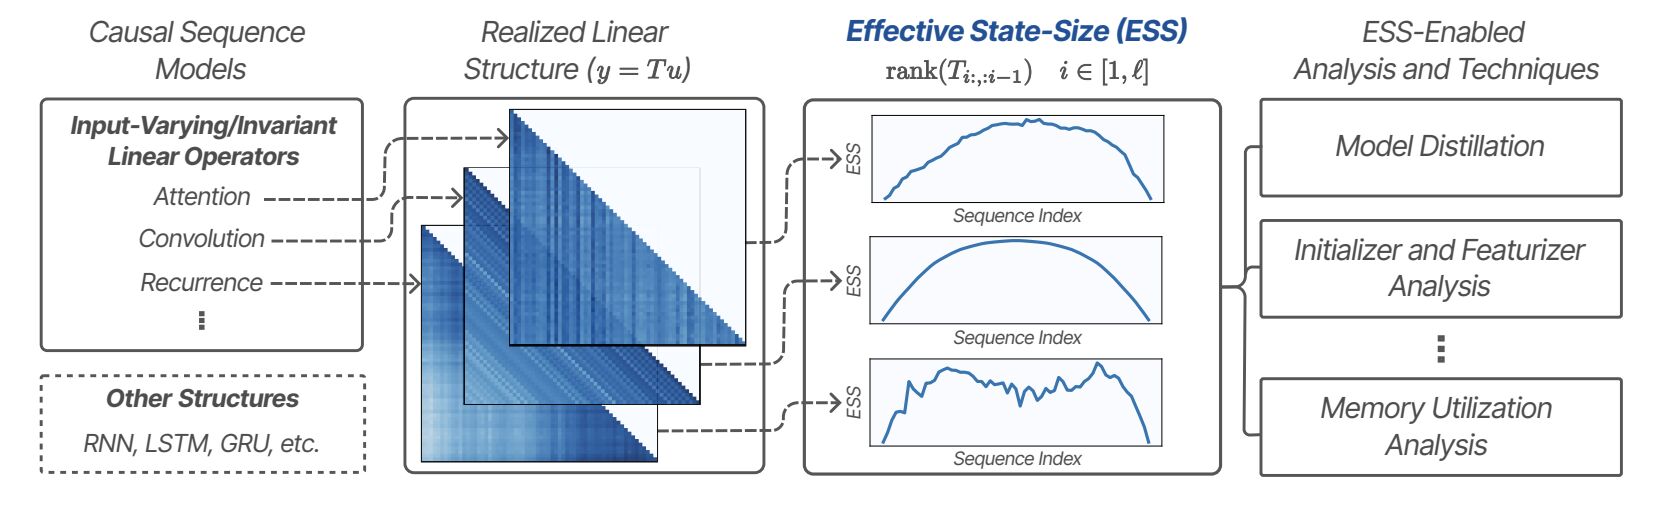
 评论
 点赞
 收藏