Vllm

高性能、内存高效的 LLM 推理与服务引擎。

在Tenstorrent硬件上服务LLM:vLLM TT插件技术内幕

Tenstorrent推出vLLM TT插件,让Tenstorrent加速器通过vLLM标准插件机制服务LLM。插件不做fork,完全外置于vLLM核心,支持Llama 3.1-3.3、Qwen、Mistral、Gemma等模型,涵盖多模态。 核心设计挑战来自Mesh架构:没有TP/PP ranks,调度器改为纯预填充或纯解码的相位隔离模式;单执行模型采用单进程多路径数据并行而非多进程;设备端采样自动降级。 目前不支持投机解码、LoRA、提示logprobs和多机扩展。
评论点赞收藏19 天前

vLLM在AMD GPU上的投机解码:5种方法实测对比

vLLM在AMD MI300X和MI355X GPU上测试了5种投机解码方法,包括Native MTP、Gemma 4 MTP、EAGLE-3、DFlash和DSpark。投机解码通过草稿-验证机制,让目标模型一次性验证多个候选token,减少自回归解码的串行等待。 不同方法的草稿生成策略各异:MTP类顺序生成,DFlash并行生成整块token,DSpark在并行基础上加入轻量级顺序修正。实验显示吞吐提升因模型家族、草稿检查点、工作负载和接受行为而异,没有统一的最优方案。
评论点赞收藏23 天前

vLLM 长上下文推理的解码上下文并行(DCP)技术详解

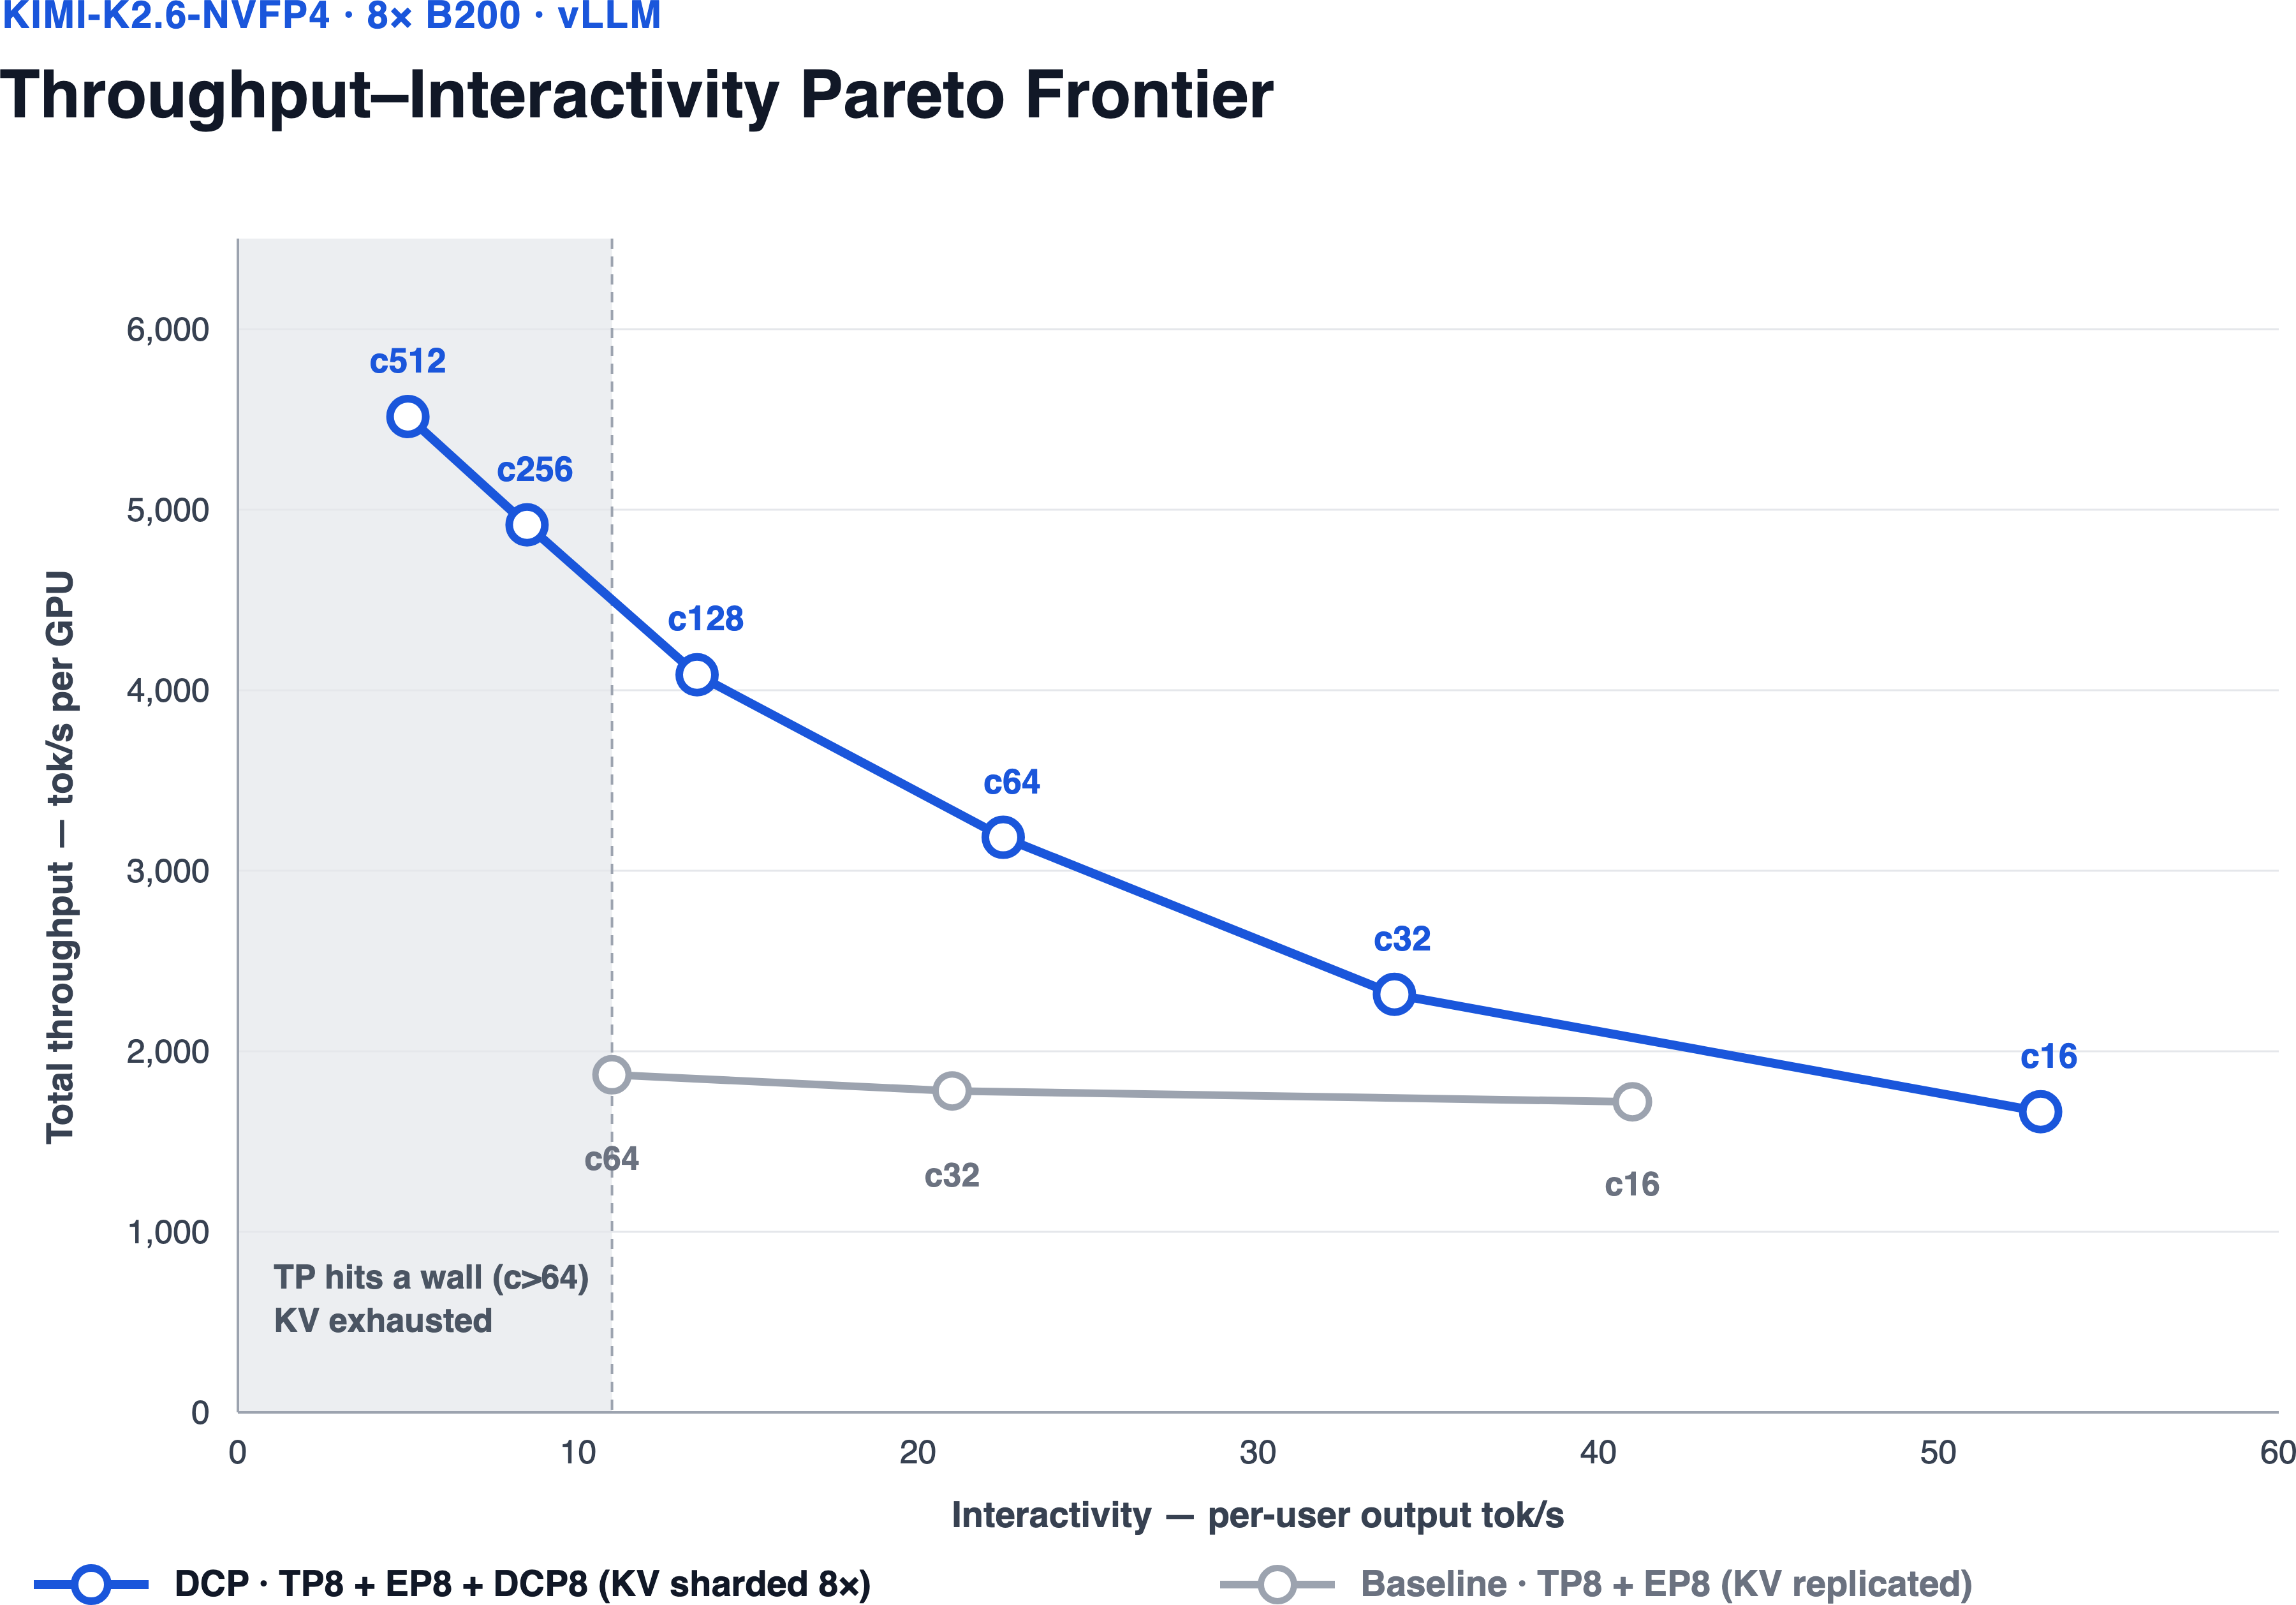
vLLM 官方详解 Decode Context Parallelism(DCP):将 KV cache 按序列维度而非 attention head 分片到多 GPU,解决长上下文推理中 KV cache 重复占用显存的问题。 在 8×B200 节点上跑 Kimi K2.6 NVFP4,并发 512 时 DCP 达到 6,091 tok/s/GPU,而基线 TP 在并发 64 时就撞墙停在 1,863。DCP 对 MLA 模型(DeepSeek-V2/V3/R1、Kimi K2.6)效果最显著,因为 MLA 只有一个 latent KV head,TP 完全无法分片;GQA 模型(如 Qwen3-235B)受 KV head 数限制,DCP 并行度上限为 tp//num_key_value_heads。 启用只需加一个 decode_context_parallel_size 参数。
评论点赞收藏32 天前

vLLM 预填充结合 TileRT 解码:专为低延迟场景优化的推理架构

vLLM 推出与 TileRT 解码引擎集成的方案,将计算密集的 Prefill 阶段与内存带宽受限的 Decode 阶段分离。该集成利用 vLLM V1 连接器接口,允许用户在保持 vLLM 调度和缓存优势的同时,针对交互式 Agent、实时语音等延迟敏感场景,切换至 TileRT 以获得更高的单用户 Token 生成速度。
评论点赞收藏77 天前

vLLM 与 Deeplearning.ai 联合推出:快速高效的 LLM 推理新课程

vLLM 团队与 Red Hat 及 合作推出了一门关于 LLM 推理优化的新课程。课程涵盖模型压缩、使用 vLLM 部署以及性能基准测试三个主要阶段,并包含动手实验环节。 该课程由 Red Hat 的高级开发者倡导者 Cedric Clyburn 授课,旨在帮助开发者理解 LLM 推理背后的原理,如 KV Cache 和 GPU 内存层次结构,并提供从量化到部署的全流程实践指导。
评论点赞收藏118 天前

EAGLE 3.1 发布:解决推测解码鲁棒性问题,vLLM 集成带来两倍吞吐提升

EAGLE 团队联合 vLLM 和 TorchSpec 发布推测解码算法 EAGLE 3.1。针对长上下文和不同对话模板下的性能衰减问题,新版本引入 FC 归一化和后归一化隐藏状态反馈机制,显著提升了训练到推理的外推能力及系统提示词的鲁棒性。 实测在 Kimi K2.6 模型上,吞吐量提升约 2 倍。该功能已合并至 vLLM 主分支,并开源了对应草稿模型。
评论点赞收藏127 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。