Quesma

RSS: https://quesma.com/rss.xml
面向前沿实验室与企业的 AI 独立评估与培训。

阿姆斯特丹的代币经济学:探访首届 Tokenomicon

Linux Foundation 的 FinOps 方向新设 Tokenomics 组织,聚焦 AI 支出管理,并举办了首届线下大会 Tokenomicon,地点在阿姆斯特丹。 文章是对该会议的简短报道,信息量有限,属于机构/生态任务式发布,个人观察和讨论入口较少。
评论点赞收藏5 天前

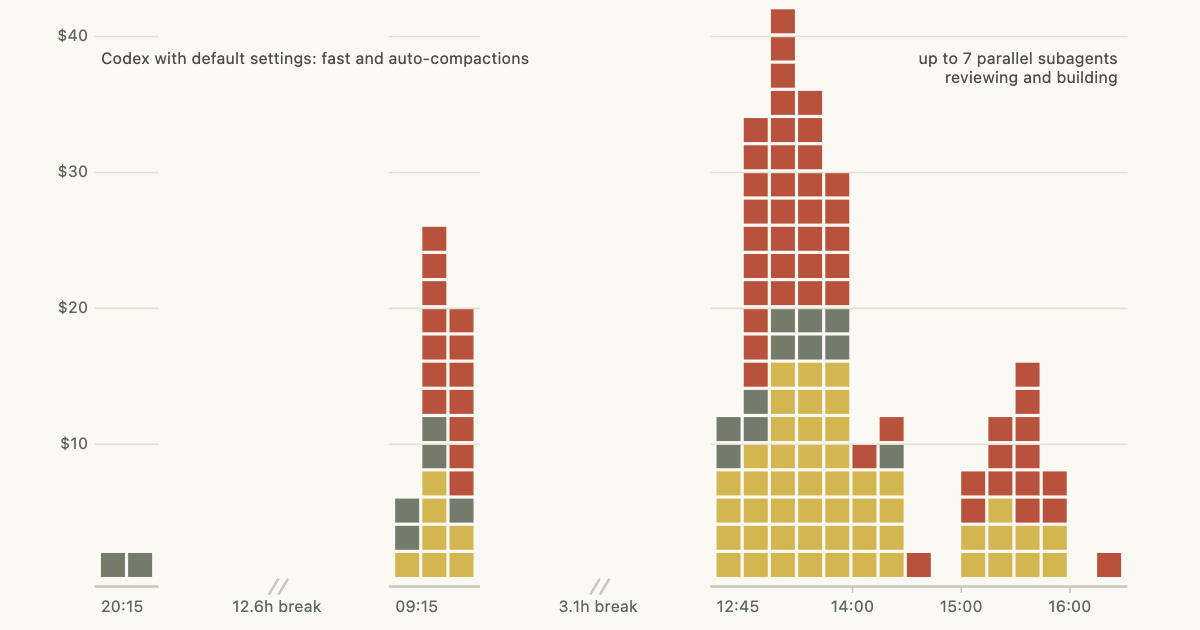
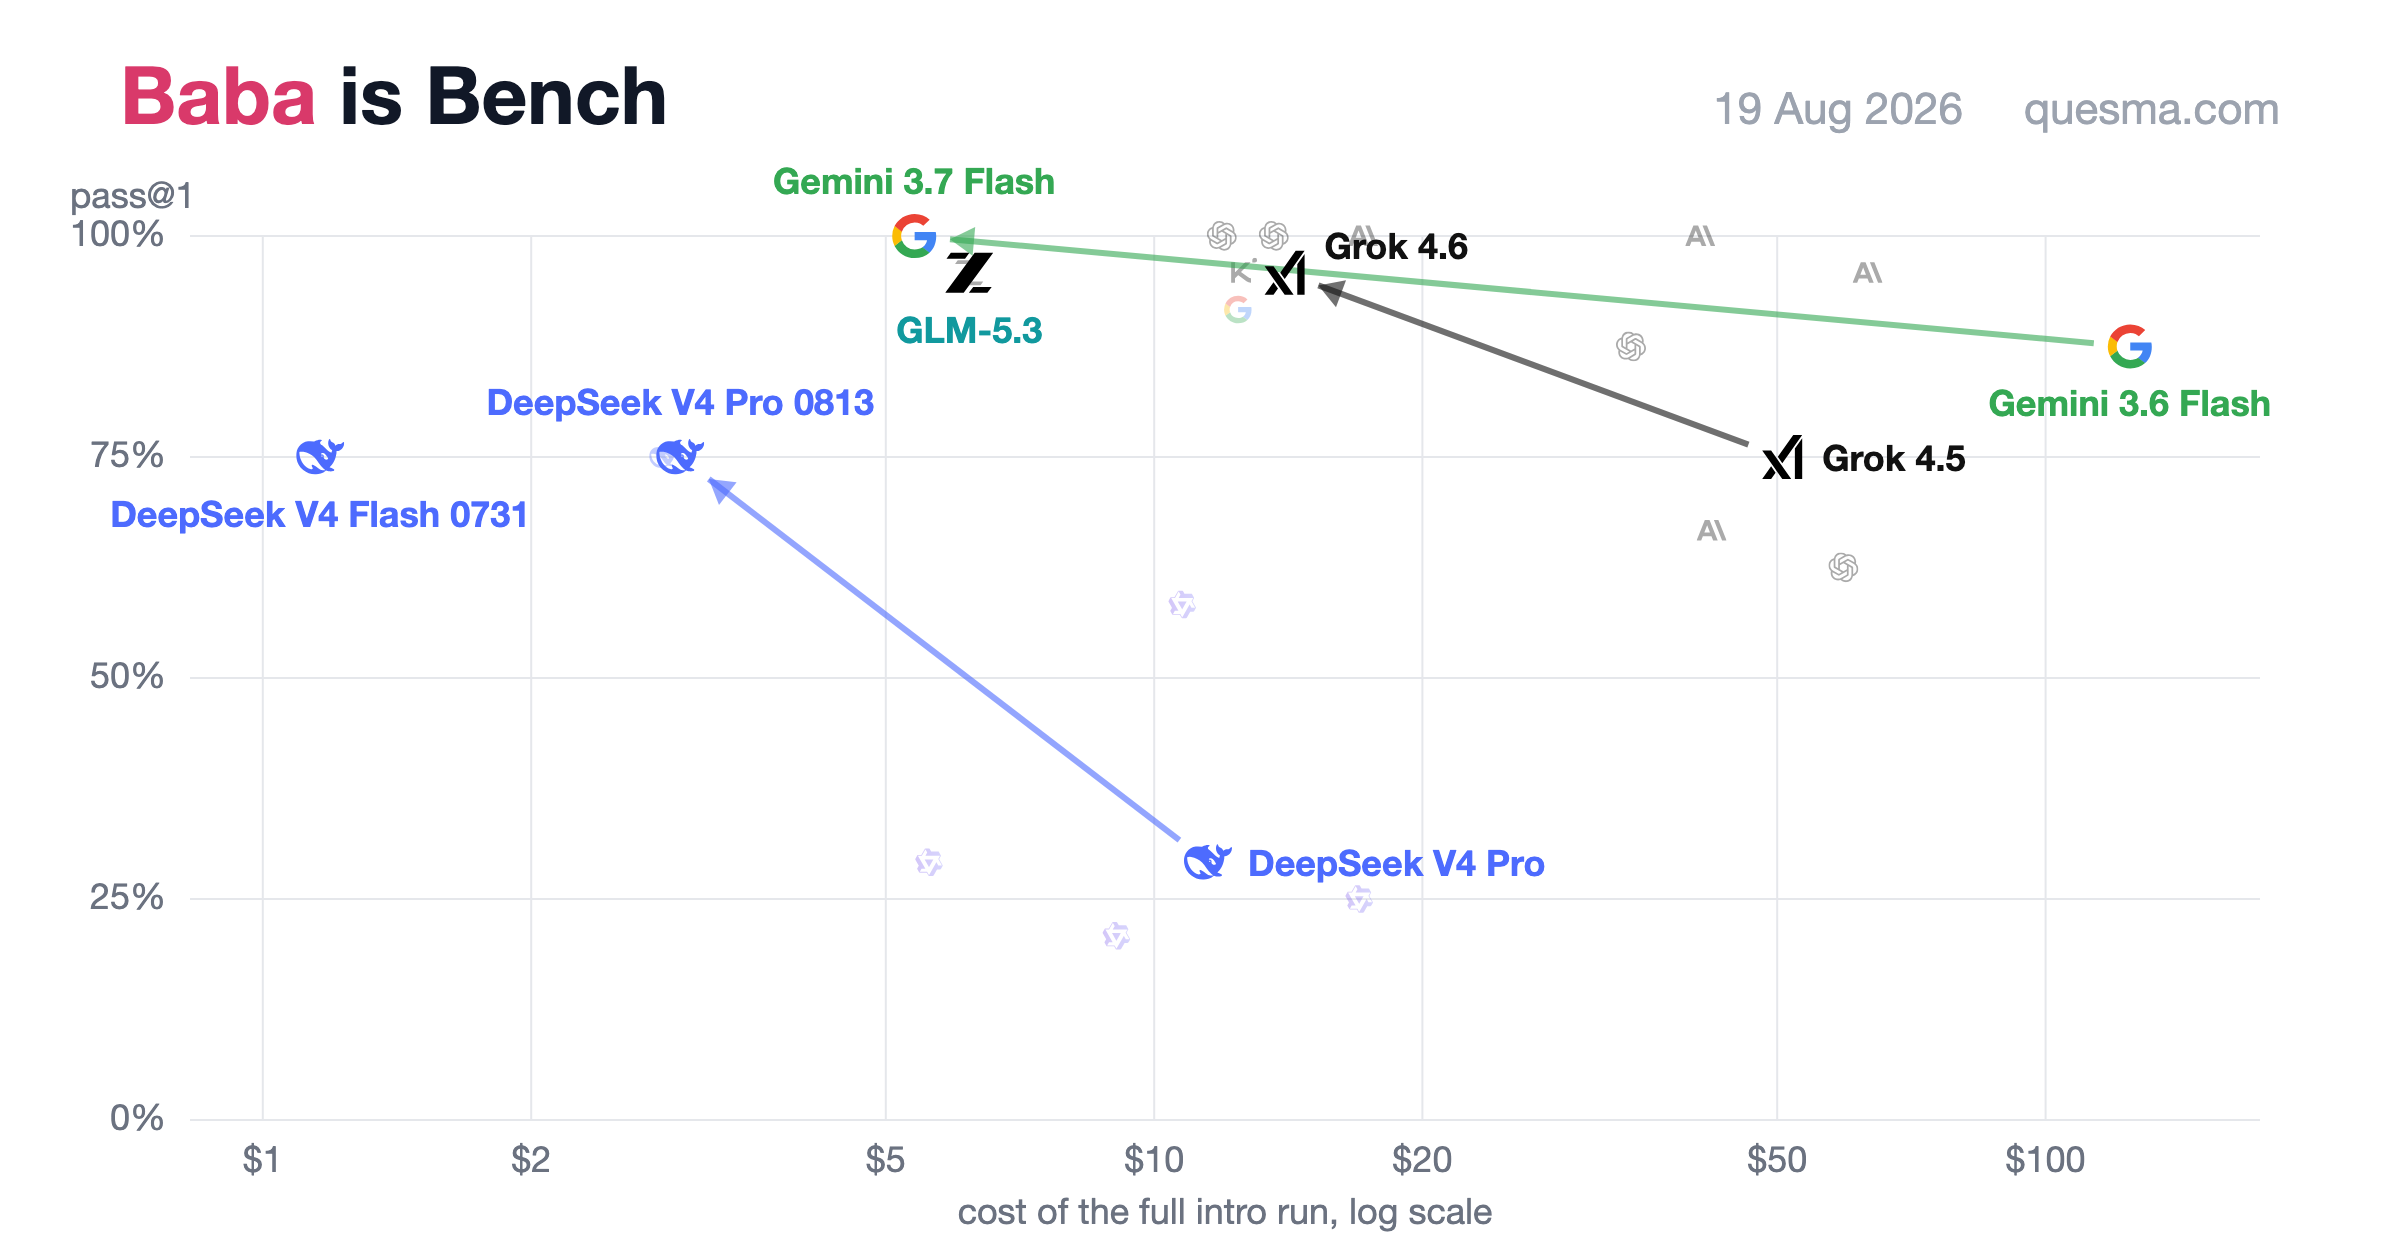
GPT-6 Astra 解谜能力实测:从 ARC-AGI-3 到 Portal 与 Baba Is You

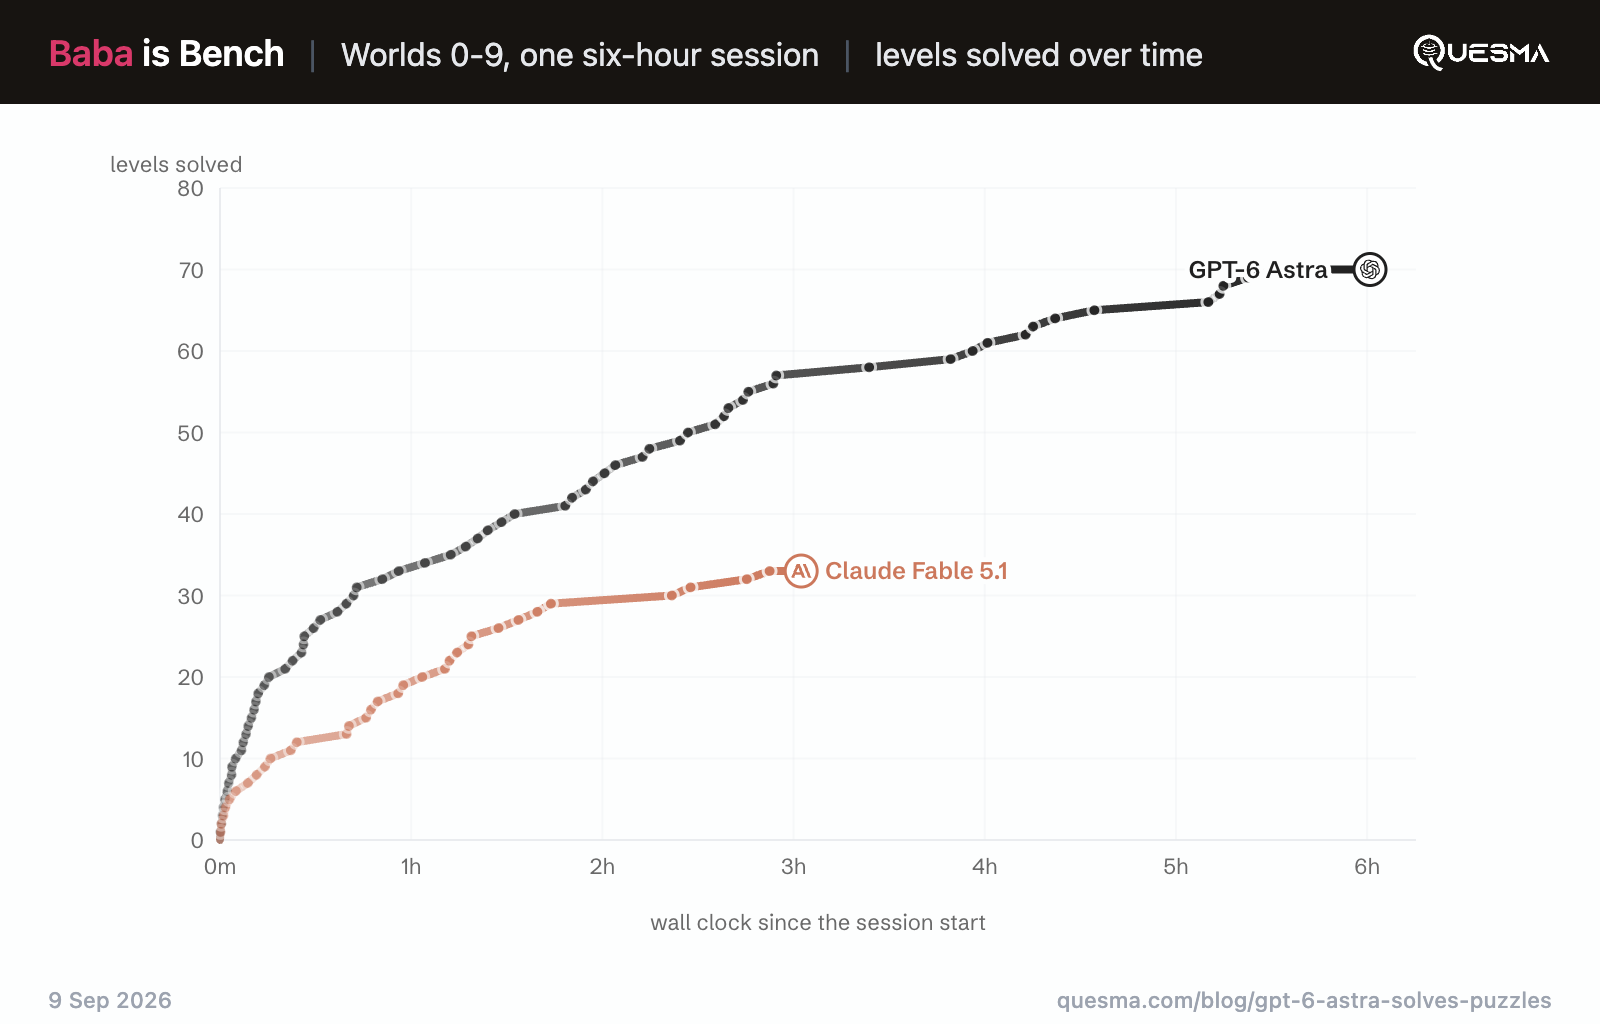
Quesma 团队测试 GPT-6 Astra 的解谜能力:标准 harness 下 ARC-AGI-3 得 63%,自定义 harness 达 99%;可自主通关 Portal(约 23.7 小时)。 在 154 关 Baba Is You 前 10 个世界中,6 小时限制下 Astra 解决约 70 关中的多数,而 Claude Fable 5.1 仅解 33 关且中途自停;MazeBench 上 Astra 60 小时得 14%,Fable 5.1 仅 2%。 作者提醒游戏可能进入训练数据,记忆与泛化仍难区分,并指出若前沿模型能解人类专家级谜题,安全锁类谜题也将被轻松突破;ARC-AGI-4 可能取消,直接跳到 5。
评论点赞收藏16 天前

RTK 宣称大幅省 token,但实测数据不买单

RTK 声称大幅降低 token 成本,但实测数据显示其节省效果与官方基准不一致。在 Fable 5.0 上使用 Claude Code 配合 RTK,以及在 Terminal-Bench 2.1 上用 OpenCode 搭配 DeepSeek V4 Pro 0813 进行测试,实际 token 消耗与宣传的节省幅度存在明显差距。
评论点赞收藏19 天前

Qwen3.8 27B 量化基准测试:4-bit 表现稳定,1-bit 直接崩盘

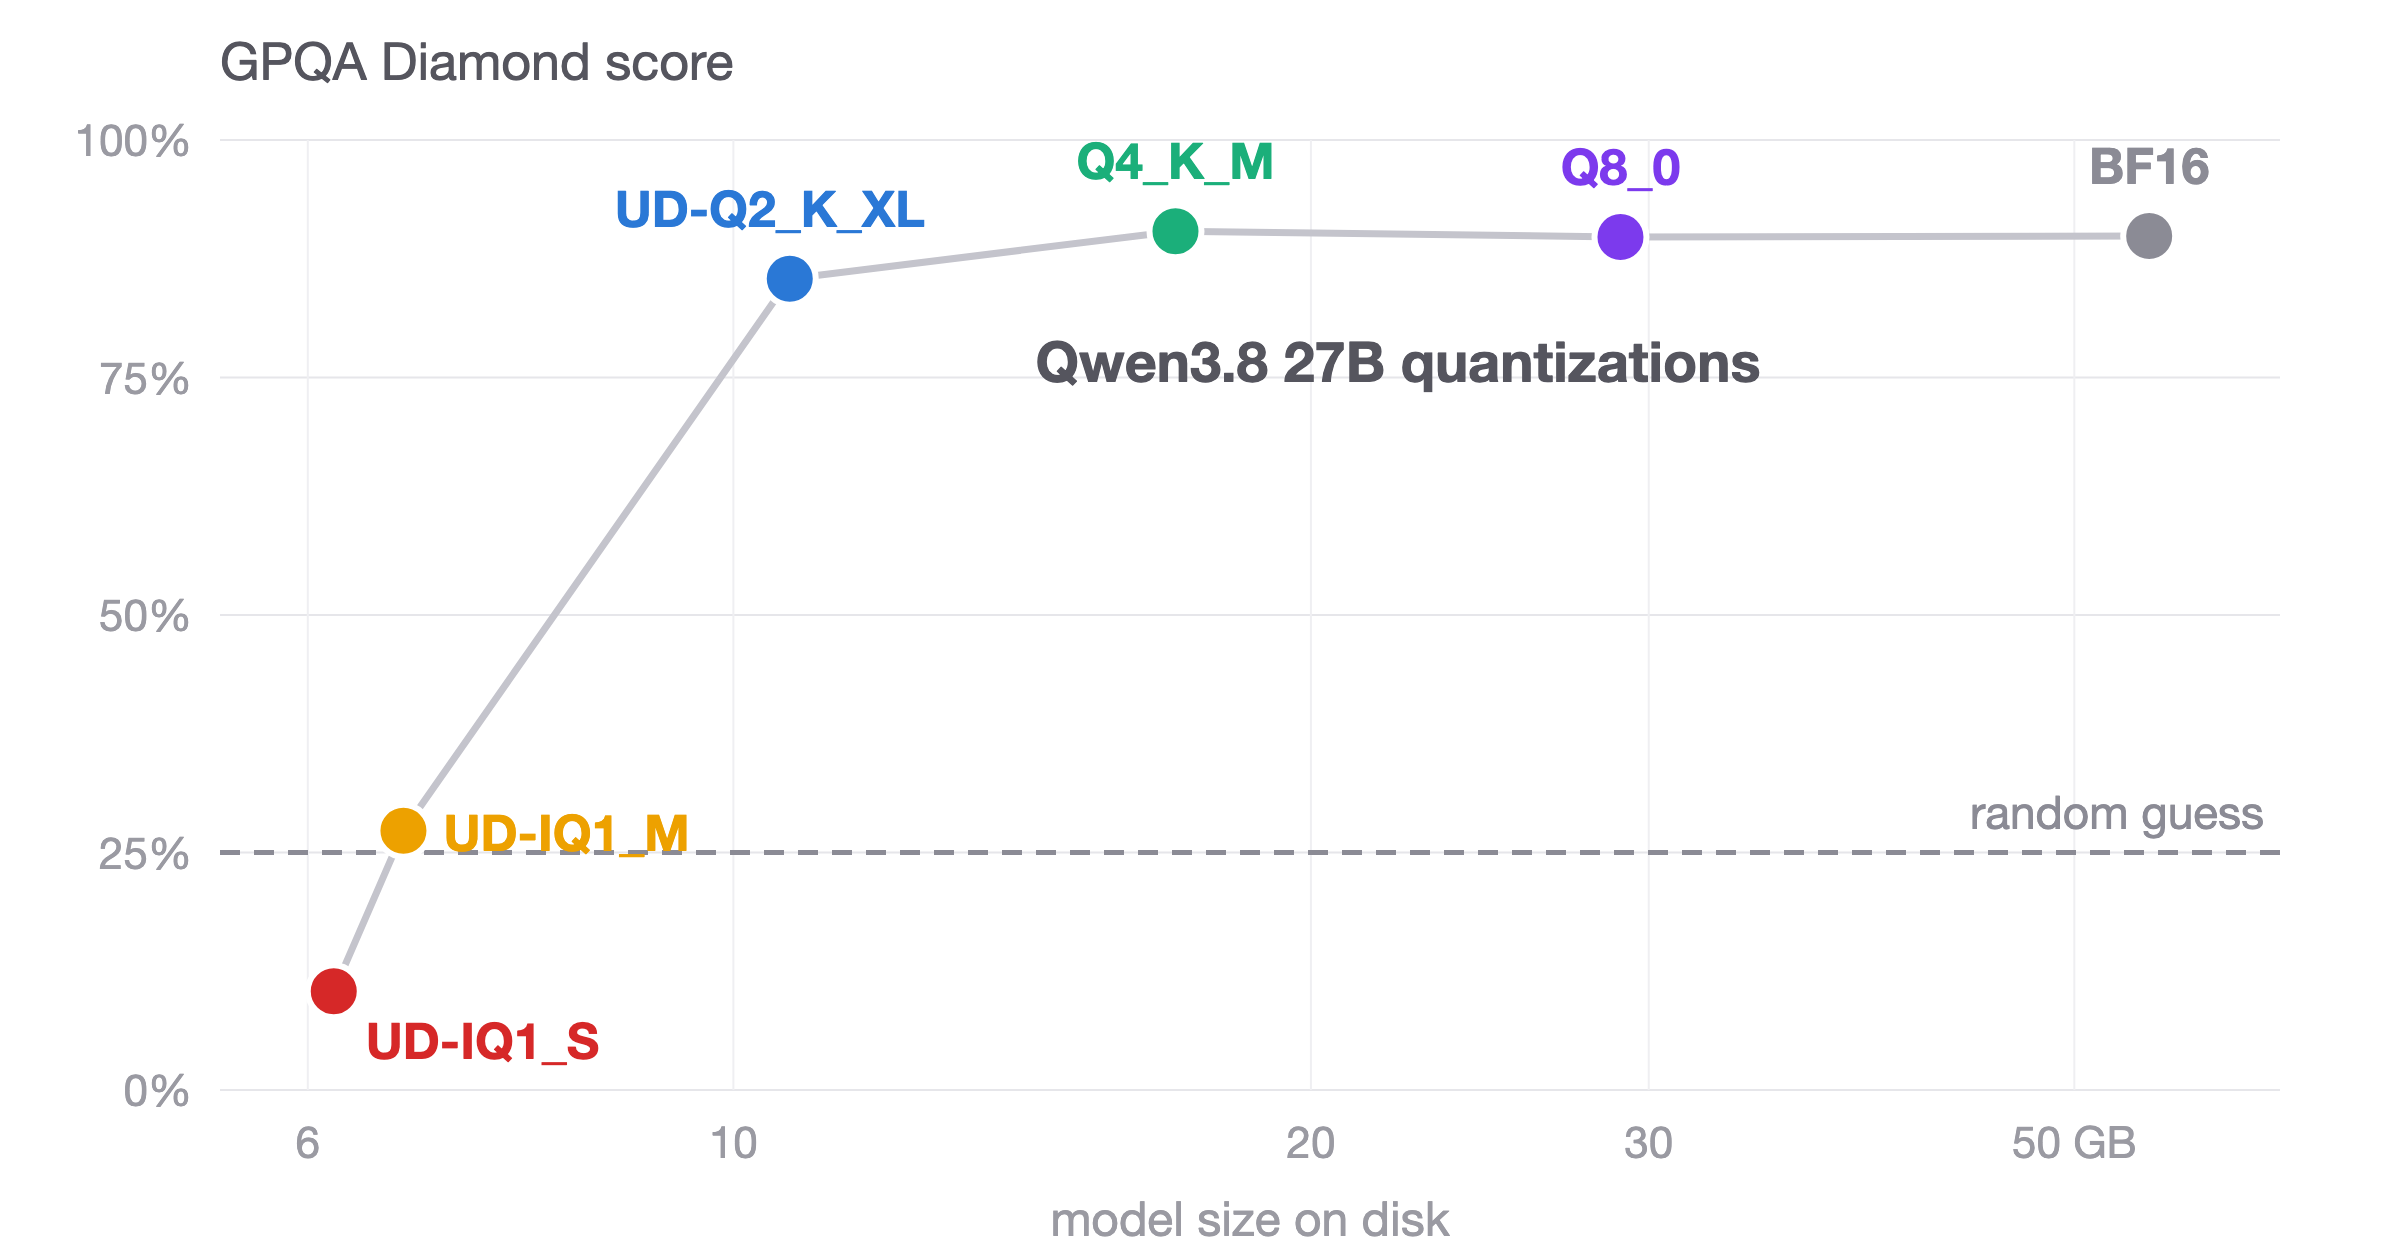
Qwen3.8 27B 模型在 4-bit 量化(17GB)下与完整 BF16 版本在编程和科学基准上表现几乎无差异,可跑在 RTX 4090 上。2-bit 略有下降但仍可用。 1-bit 直接崩盘,分数接近随机猜测,更长推理反而更差。作者实测花费约 3000 美元 GPU 费用,建议本地部署优先选 Q4_K_M。
评论点赞收藏22 天前

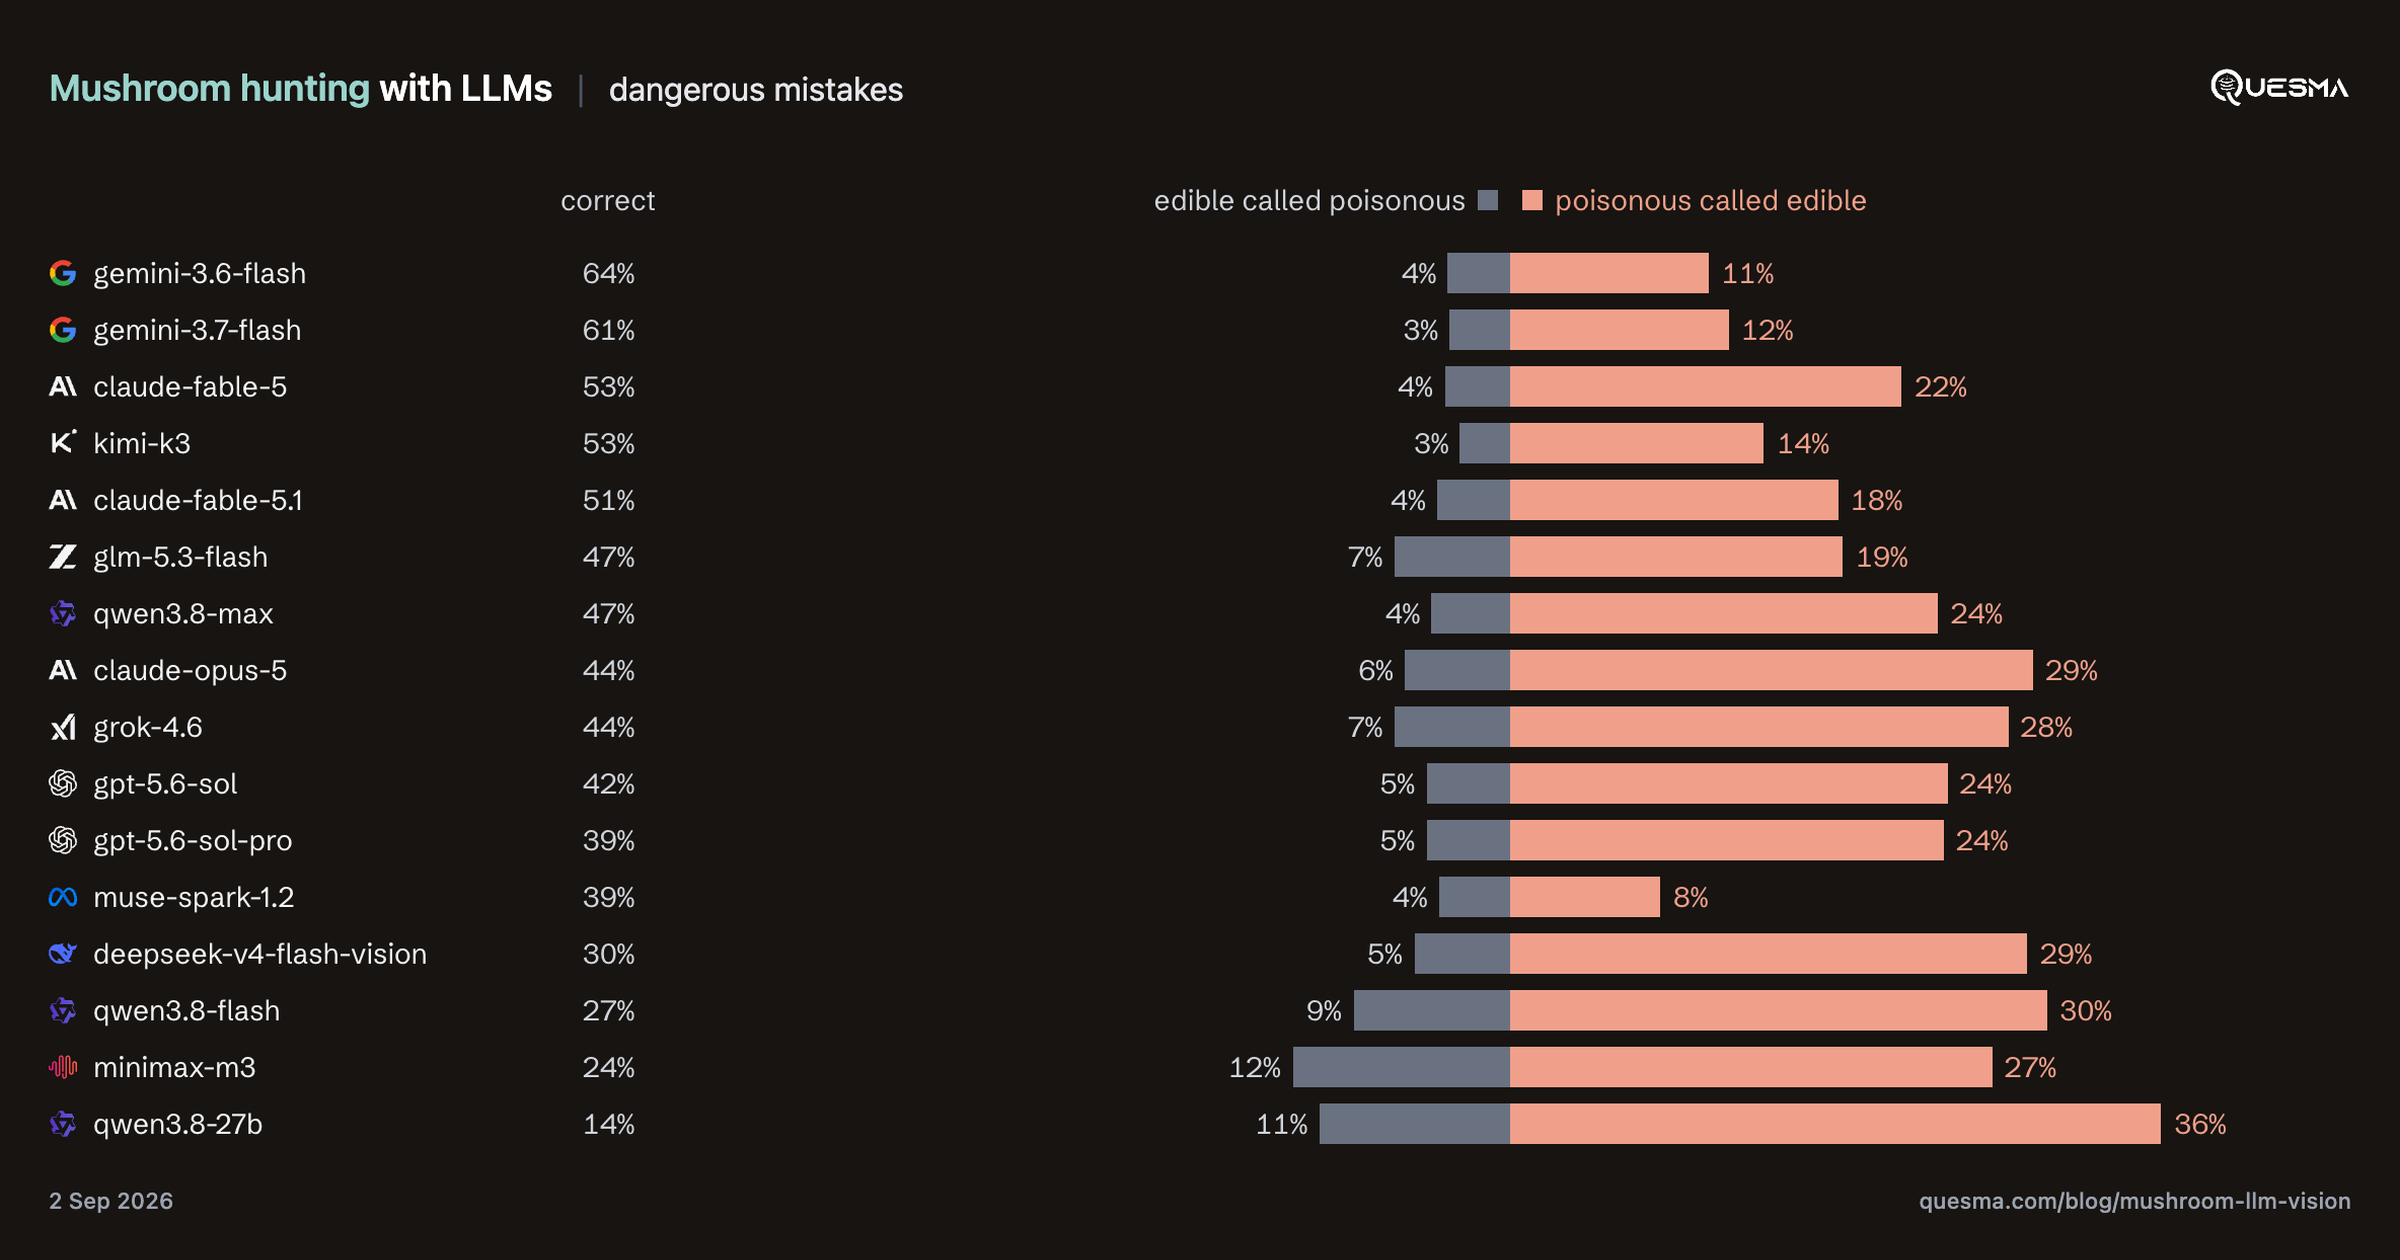
用LLM识别蘑菇:会出什么错?

<p>基于AI的蘑菇识别:在FungiTastic数据集的有毒与食用菌种上,对GPT‑5.6‑Sol、Gemini 3.7 Flash、GLM‑5.3‑Flash以及Claude Fable 5.1进行了基准测试,结果出现了大量危险性误判。</p>
评论点赞收藏27 天前

Qwen3.8 27B 量化实测:4-bit 够用,1-bit 直接崩

Qwen3.8 27B 的 4-bit 量化(Q4_K_M,17GB)在 Terminal-Bench 2.1 等基准测试中与完整 BF16 模型表现一致,可跑在 24GB 显存的 RTX 4090 上,还能留出约 64k token 的上下文空间。 2-bit 略有下降但仍可用,1-bit 则直接崩到随机猜测水平,且更长推理反而更差。作者实测烧了约 3000 美元 GPU 费用,建议本地跑实验时优先选能装下模型+上下文的最大量化版本。
评论点赞收藏34 天前

Claude Code 定价:同模型同 token,价格差高达 40 倍

Claude Code 按 token 计费比订阅贵 40 倍,Uber 四个月烧光全年 AI 预算。Pylon CEO 三天花掉 $4,000。SemiAnalysis 实测 Max 20x 订阅对应 $8,000 API 等价费用。 Anthropic 订阅只占收入 5-15%,企业按量计费才是利润来源。
评论点赞收藏50 天前

把4个Claude模型接进Claude Code,在Terminal-Bench上翻车了四次

用4个Claude模型搭了多智能体编排系统跑Terminal-Bench 2.1,78%正确率排第七,花了$1,178,暴露四个问题。委托机制让Opus 5拒绝执行合法安全任务,直接问能解、委托就不解。 验证步骤设为可选导致25%任务跳过审查,正确率从91%暴跌到43%。最贵的Opus 5被放在最高频的执行角色,占58%花费,角色分配反了。 超过6次交接后成功率从90%跌到50%,花费翻近四倍。
评论点赞收藏51 天前

量化对知识的损害是非线性的——Qwen3.6 27B 案例研究

量化会非线性地损害模型知识。对 Qwen3.6 27B 的 55 种量化版本测试发现,4-bit 量化后事实知识几乎无损,但 3-bit 以下知识骤降——比单纯缩小模型参数更严重。 原因是量化是"盲压缩",只逼近原始分布而非优化训练数据,KL 散度与知识损失呈线性关系。实际建议:8-bit 最安全,4-bit 通常够用,优先用能放进显存的最大模型而非更小更便宜的模型。
评论点赞收藏58 天前

Qwen 3.6 27B 量化会破坏鹈鹕吗?

Qwen3.6 27B 量化模型在 4-bit 及以上精度下质量几乎无损,2-bit 开始明显退化。作者通过 SVG 生成、数学基准和概率分布测试验证了该结论。
评论点赞收藏65 天前

Tokenflation:当“你好”触发33次工具调用

简单任务消耗过多上下文和工具调用,却未增加有用输出。测试发现某模型仅回复“Hi”就触发了33次工具调用并擅自提交代码。这一现象揭示了当前大模型在工具使用上的过度倾向和资源浪费问题,对优化API成本和提升系统效率具有直接参考价值。
评论点赞收藏83 天前

对 AI Agent 说“嗨”的真实代价

Token 价格下降不代表 AI Agent 变便宜了。模糊的 Prompt(如简单的 "Hi")会导致 Agent 反复试错,消耗大量计算资源,最终烧掉的是开发者的薪资预算。 文章揭示了“简单问候”背后的隐性算力成本,提醒工程师在构建 Agent 时需重视 Prompt 的精确性,避免因指令不清导致昂贵的无效推理。
评论点赞收藏83 天前

比较编排层而非模型:Blitzy 与 GPT-5.4 在 SWE-Bench Pro 上的对决

Quesma 独立审计了 Blitzy 在 SWE-Bench Pro 基准测试中取得的 66.5% 高分,确认其成绩有效且高于 GPT-5.4。文章指出,在企业级复杂代码库场景中,智能体编排层(Harness)的工程能力比单纯依赖大模型底座更为关键。 Blitzy 通过深度分析仓库、生成详细规范及严格验证,解决了模型在“最后一公里”执行细节上的失误。这表明未来 AI 编程的竞争焦点将从模型本身转向围绕模型的工程基础设施。
评论点赞收藏175 天前

登录芦苇

登录后关注作者、收藏内容和参与讨论。