
36氪首发丨创新工场投了家成都具身模型公司,已实现拣选环节新零件免训练


作者 | 乔钰杰
编辑 | 袁斯来
本文约3000字,建议阅读8分钟
硬氪获悉,成都睿芯行科技有限公司(以下简称“睿芯行”)近日完成数千万元新一轮融资,投资方包括创新工场、中力股份及今天国际。
睿芯行成立于2019年,由长江学者特聘教授、电子科技大学教授周军与西南交通大学教授徐菱联合创立,聚焦工业场景下的具身智能技术与产品研发。
公司早期从移动机器人控制器切入,围绕AGV、AMR等产品积累了SLAM、导航、运动控制、视觉感知与决策等技术能力,相关产品已在工业场景中广泛应用。现阶段,睿芯行正将这些积累延伸至具身智能机器人整机,试图解决机器人进入工厂时面临的部署成本高、环境适应能力不足等问题。
工业拣选场景中,机器人需要面对大量形态、尺寸各异的零部件。传统方案通常需要针对不同零件采集数据、标注数据并重新训练模型,单个零件的训练周期至少需要一周。如果需要处理数百种零件,部署周期就可能被拉长至数十周。与此同时,训练过程还涉及云端算力成本。
针对工业零配件品类多、形态差异大、订单变化快等实际需求,睿芯行推出全球首创的基于类人脑机制的具身智能免训练抓取模型。通过自适应学习做到新零件免训练,免去了每个零件一周的训练时间和上千元的训练成本,并支持使用千元级普通3D相机替代数万元级高精度3D相机,降低系统拣选抓取和感知硬件成本,系统可根据工件特征选择夹爪、气吸、磁吸等抓取方式,适用于工业拣选及相关物料操作场景。
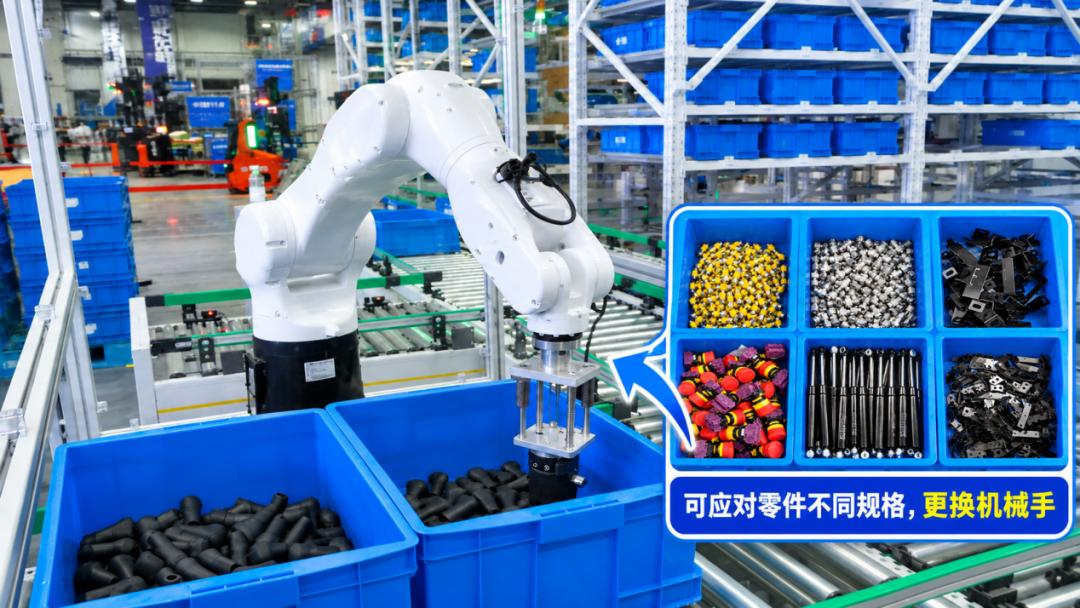
(图源/企业)
周军向硬氪介绍,睿芯行的思路不是针对每一种新零件训练VLA模型,而是在基座模型之上增加知识提取与检索机制,并通过在线学习,让机器人在执行任务的过程中积累经验,再利用这些信息调整后续的抓取动作,形成实时反馈与自适应的闭环,可以做到“边做边学”。
这一机制更接近人类的抓取方式。例如,人拿起水杯或钢笔时,通常不需要预先计算物体与手之间的精确距离,而是根据看到的形态、接触后的反馈不断调整动作。睿芯行希望让机器人也具备类似的动态适应能力,在遇到未经训练的新零件时,仍能根据实时感知完成抓取。
除了拣选,装卸搬运仍是睿芯行重点布局的场景。传统移动机器人通常依赖激光雷达感知周围环境并完成定位。当工厂内的货物、料框或其他设施发生移动时,机器人可能面临定位失准,需要重新识别环境并调整行驶路径。与此同时,当多台机器人同时执行任务时,交通拥塞、路径冲突与任务分配不合理等问题,也会影响整体作业效率。
睿芯行的具身“小脑”技术具备环境自适应与多智能体协同能力。与部分从机械臂操作切入的具身智能企业不同,公司自2019年成立以来,便持续研发AGV、AMR等移动机器人技术,在工厂环境中的移动、避障、定位与导航方面积累了较长时间的工程经验。
在此基础上,公司近两年自研了千台级智能体协同调度系统,将任务分配、实时动态调度与数据分析结合起来,解决多台机器人在有限空间内的协同作业问题。公司还在原有移动机器人系统中加入大模型感知能力,以提升机器人对动态环境的适应能力,并进一步支持多智能体集群调度。
软硬件协同设计则是睿芯行强调的另一项技术能力。周军表示,具身智能模型的运行不仅涉及算法本身,也与底层硬件的算力、功耗和成本密切相关。如果直接依赖高算力硬件运行复杂模型,整机成本很难降下来。团队依托在算法与芯片方面的研究积累,可以在模型向硬件部署的过程中进行协同优化,在保证模型精度的前提下,降低算法复杂度与硬件资源需求。
目前,睿芯行已推出多款面向不同场景的产品。2025年6月29日,公司与中力股份联合发布第一代工业拣选机器人。用户可通过远程下发零部件种类与数量,由机器人自动完成拣选流程。针对商超等商业场景,公司也开发了无人拣选方案。考虑到商品包装以瓶装、罐装和纸盒等形态为主,机器人采用气吸式末端执行器完成抓取。
2025年11月,睿芯行进一步发布“飞箱”产品与第二代具身拣选机器人。上一代方案需要机器人自主移动至不同料框位置完成拣选,而飞箱系统能够将对应物料的料框快速送至待拣选平台,以缩短物料切换与取料所需的时间。第二代机器人则采用双臂设计,两条手臂可适配不同类型的末端执行器,以覆盖更多零件品类。
此外,公司还推出了单臂拣选站,可根据零件类型切换二指夹爪、气吸、磁吸及灵巧手等末端执行器,并与AMR、CTU及输送带等设备组合,搭建不同的拣选系统。
在多机器人协同方面,睿芯行曾于2025年11月在中力股份现场演示50台移动机器人协同作业。演示场地约为30米×30米,系统需要在有限空间内完成多任务调度,并处理机器人之间的交通拥塞与路径协调问题。
以下为创始人问答(略经编辑):
硬氪:怎么理解睿芯行的“类脑具身模型”?为什么这种架构有望解决现有大模型的训练问题?
周军:我们可以把类脑具身模型理解为一个分层架构。底层是基座模型,包括VLA、世界模型等,负责提供基础的感知与动作能力;在此之上,我们增加了知识检索与迁移机制,并通过在线学习,将执行任务与积累经验结合起来。
人之所以能够拿起一个从未见过的零件,并不意味着每遇到一种新物体,都要重新学习一遍。比如,我们已经学会拿水杯,再拿一个纸杯时,就可以根据两者的相似之处,迁移已有的抓取经验,而不需要重新训练上万次。
现有一些大模型的训练与执行是相对分离的:模型先通过大量数据完成训练,部署后再执行任务。如果遇到新零件,往往还需要补充数据、重新训练,才能适应新的情况。
我们希望把学习和执行融合起来,让机器人在抓取过程中实时获取反馈、积累经验。同时,当它遇到新的零件时,可以检索过去处理过的相似物体,将已有知识迁移到当前任务中。这其中有两个关键点:一是“边做边学”,不必等积累了大量新数据后再进行训练;二是“知识迁移”,能够从过去的经验中提取可复用的信息,帮助机器人处理新的物体。
硬氪:这种架构对数据的依赖程度如何?目前已经实现了哪些能力?
周军:从最终目标来看,我们希望尽可能降低模型对训练数据的依赖,但目前还处于逐步实现的阶段,不同任务的进展也不一样。
以工业拣选为例,我们目前已经能够在不针对新零件进行专门数据训练的情况下完成抓取。对于搬运场景,也可以在较少数据甚至不依赖新增训练数据的情况下完成部分任务。但装配涉及更复杂的操作精度和动作要求,现阶段仍需要更多数据支持。
所以,我们并不是说具身机器人已经不需要数据,而是希望通过在线学习和知识迁移,减少针对每个新任务重复采集数据、训练模型的需求。未来能把数据需求降到什么程度,还需要随着技术迭代和更多场景验证进一步确认。
硬氪:目前模型落地进入什么阶段了?
周军:目前,我们已经在浙江中力、海尔、京东方、中际旭创等企业的工厂开展落地测试。这些头部工厂对新技术的导入有比较严格的要求。机器人不仅要能够完成任务,还需要具备足够的泛化能力,能够适应不同零件和环境;同时,作业节拍要尽可能接近人工,成本也必须合理。只有同时满足这些条件,客户才有可能真正将机器人部署到生产流程中。
我们此前长期为工业客户提供AMR等移动机器人产品,相关产品已经在一些工厂得到应用。这让我们积累了客户基础,也更容易理解工厂的实际需求。相比只验证单台机器人能否完成某个动作,我们更关注它能否进入真实生产环境,稳定完成任务,并满足客户对效率和成本的要求。
接下来,我们还需要通过更多工厂测试,持续验证模型的泛化能力、作业效率与系统稳定性,并逐步推动产品从场景测试走向规模化交付。