# 09 我的个人智能体框架:两层、七个问题


「谁在定义个人智能体」系列 · 第 9 篇(完结篇)
这个系列写了八篇,看了几十家公司、实验室、开源项目和标准组织的定义。这一篇把它们收起来,给出我自己的一套框架。
先说结论:
个人智能体是一个为某个确定的人长期服务、了解并记得这个人、能在他的授权范围内替他行动的 AI 系统。
这句话是描述性的,基本是今年各家定义的公约数。但只用这一句,Muse、Siri、豆包手机、OpenClaw 都能套进去,分不出差别。
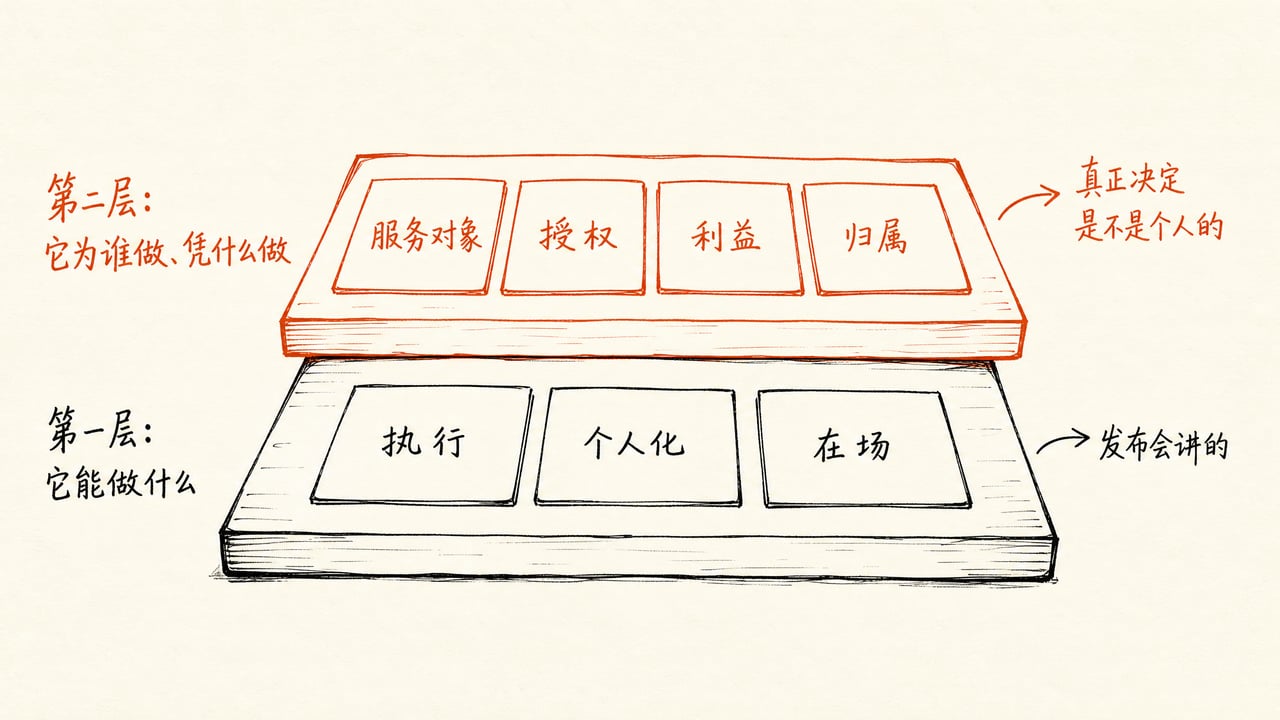
所以我在这句话下面拆出了两层、七个维度。第一层回答"它能做什么",第二层回答"它为谁做、凭什么做"。今年的产品发布会几乎只讲第一层,研究者、协议和开源项目讲的大多是第二层。一个产品是不是真正的"个人"智能体,往往取决于第二层。
为什么要分两层
回头看前八篇,有一条线很清楚:
- 第 1 篇的海外大厂、第 3 篇的终端厂商,比的是能力:有没有电脑、能执行多少步、能不能主动;
- 第 4 篇的豆包被 155 款应用拒绝、第 7 篇的 Muse 被 Amazon 屏蔽,说明能力再强,别人不让进也做不成;
- 第 6 篇的研究者问的是"它站在谁那边"、"出了事谁负责";
- 第 8 篇的开源项目强调"你的机器、你的数据"。
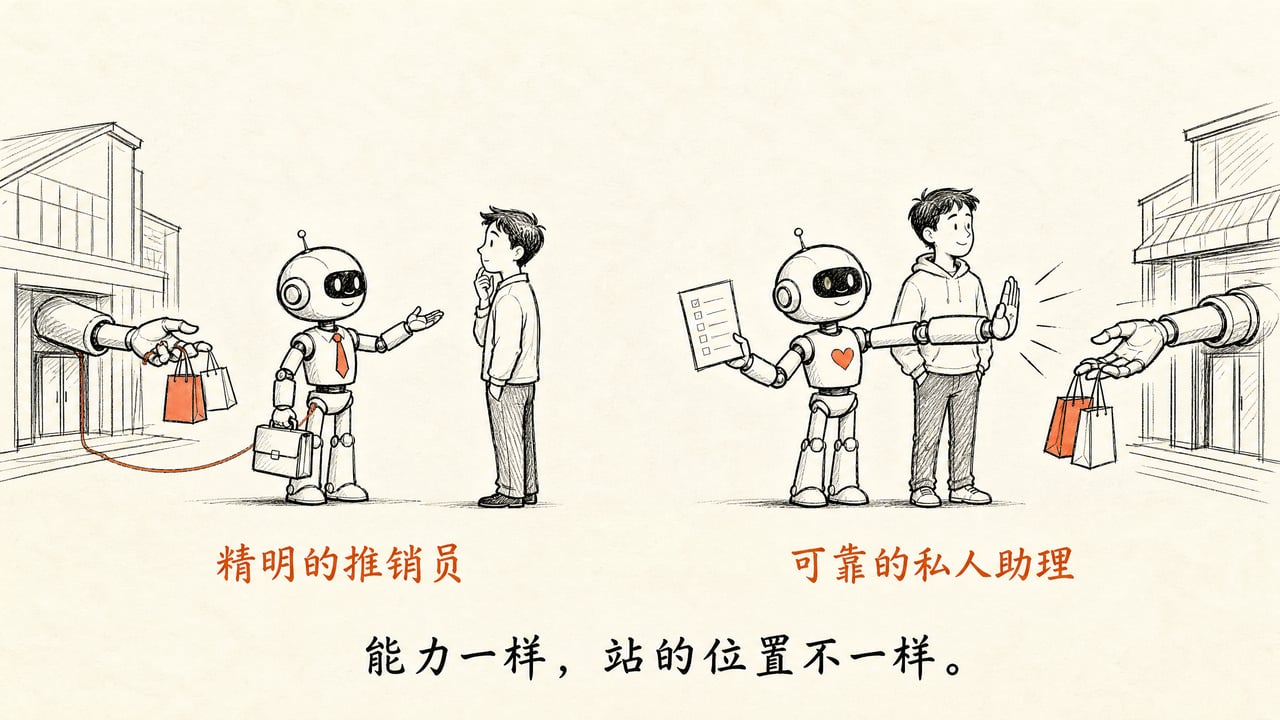
能力决定它能做什么,关系决定它被允许做什么、该替谁做。只看能力,会把一个精明的推销员和一个可靠的私人助理当成同一种东西。
第一层:它能做什么
维度一:执行
问题:它能替你把多复杂的事从头做到尾?
这是今年讨论最多的一层,国家标准、清华 AIR、信通院的分级都主要在量这一条。
| 档位 | 表现 |
|---|---|
| 一档 | 按明确指令执行固定步骤,比如"打开某个 App" |
| 二档 | 理解简单意图,自己补全步骤,比如"查一下北京天气" |
| 三档 | 理解复杂意图,自主规划多步任务、根据结果调整,比如"把明天的日程整理好发给某人" |
| 四档 | 长链路、跨应用、跨天的任务,能处理中途的意外,比如替你和客服反复交涉要到赔偿 |
参照:第 5 篇的几套分级;第 6 篇 OSWorld 的完成率提醒我们,宣传里的"能做"和实际的"做成"之间还有不小的距离。
维度二:个人化
问题:它对你了解多少、记得多少、能不能在你开口之前想到?
这是"个人"两个字在能力层面的体现,第 5 篇说过,多数分级都没有单独量它。
| 档位 | 表现 |
|---|---|
| 一档 | 每次对话从头开始 |
| 二档 | 记得你说过的偏好和事实,下次不用重新交代 |
| 三档 | 结合你的日程、位置、历史行为理解当下情境,回答和执行都带着"你"的背景 |
| 四档 | 能主动发现你的需求,在合适的时候提出或完成,并从你的反馈里持续调整 |
还有一个要附带检查的问题:它记住的东西,你能不能看到、改正、删除。 Today 的可查看记忆、Hermes 的记忆文件都做到了这一点;做不到的产品,个人化越强,风险越大。
参照:第 3 篇的 OPPO"记录、遗忘与反思";第 5 篇清华 L4"记忆与情境感知";第 8 篇 Hermes 和 Today。
维度三:在场
问题:它在哪里、什么时候能为你工作?
这一维把几个零散的讨论合在了一起:有没有自己的电脑(第 1 篇)、离开后能不能继续(Simular 的第二项测试)、能不能跨设备跟着你(第 3 篇 IDC 和高通)、能不能在你常用的地方找到它(第 8 篇的聊天软件路线)。
| 档位 | 表现 |
|---|---|
| 一档 | 只在你打开它的时候、在一个 App 里工作 |
| 二档 | 能在后台完成你交代的任务,你离开也不中断 |
| 三档 | 能按时间或条件自动触发,承担长期职责,比如"每个工作日早上""收到账单时" |
| 四档 | 跨设备、跨渠道持续在场,在手机、电脑、眼镜、聊天软件里是同一个它 |
"有没有自己的电脑"是实现手段,不是目的。云端虚拟机、手机操作系统、你自己的服务器,都能做到高档位的在场。
第二层:它为谁做、凭什么做
维度四:服务对象
问题:它服务的"个人"到底是谁?
第 2 篇最先碰到这个问题:同样叫"个人",Microsoft Autopilot 服务的是一个员工,Alexa+ 服务的是一个家庭,Muse 服务的是一个自然人。
| 类型 | 例子 | 需要额外回答的问题 |
|---|---|---|
| 一个人的生活 | Muse、Siri AI、千问 Go | 无,这是最典型的情况 |
| 一个员工的工作 | Microsoft Autopilot、腾讯 WorkBuddy | 记忆和数据归公司还是归员工?员工离职时怎么办? |
| 一个家庭 | Alexa+、小米 Miloco、jo | 家人之间能看到彼此的什么?谁有权给它下指令? |
这一维不分高低,但必须先说清楚。服务对象不同,后面三维的答案会完全不同。
维度五:授权
问题:它被允许替你做到什么程度?这个授权能不能被看见、被收回?
这一维合并了第 5 篇的"授权轴"和第 7 篇的"身份与授权"。
它有两个部分。
一是对用户的授权。第 5 篇引用华盛顿大学的框架,用户可以对不同任务分别当"操作者"、"审批者"或"旁观者"。好的个人智能体,授权应该按任务设置,而不是一个总开关。OpenAI dots 的四档权限、荣耀 YOYO 拒绝大额转账,都是这个思路。
二是对外的身份。它去别人那里办事时,能不能表明"我是谁的 Agent、被授权做什么"。第 7 篇 Personal Agent Protocol 里那句话可以作为标准:对方始终知道请求来自个人 Agent,是哪一个,代表哪个用户。
| 档位 | 表现 |
|---|---|
| 一档 | 没有区分,要么全权代理,要么什么都不能做;对外冒充用户 |
| 二档 | 有统一的确认机制,敏感操作先问 |
| 三档 | 按任务和风险分级授权,有操作记录可查 |
| 四档 | 对外有可识别的身份,权限可以按服务分别授予和撤销,用户和对方都能看到它做了什么 |
我认为三档是一个个人智能体能被长期信任的底线,四档是它能被广泛接纳的前提。
维度六:利益
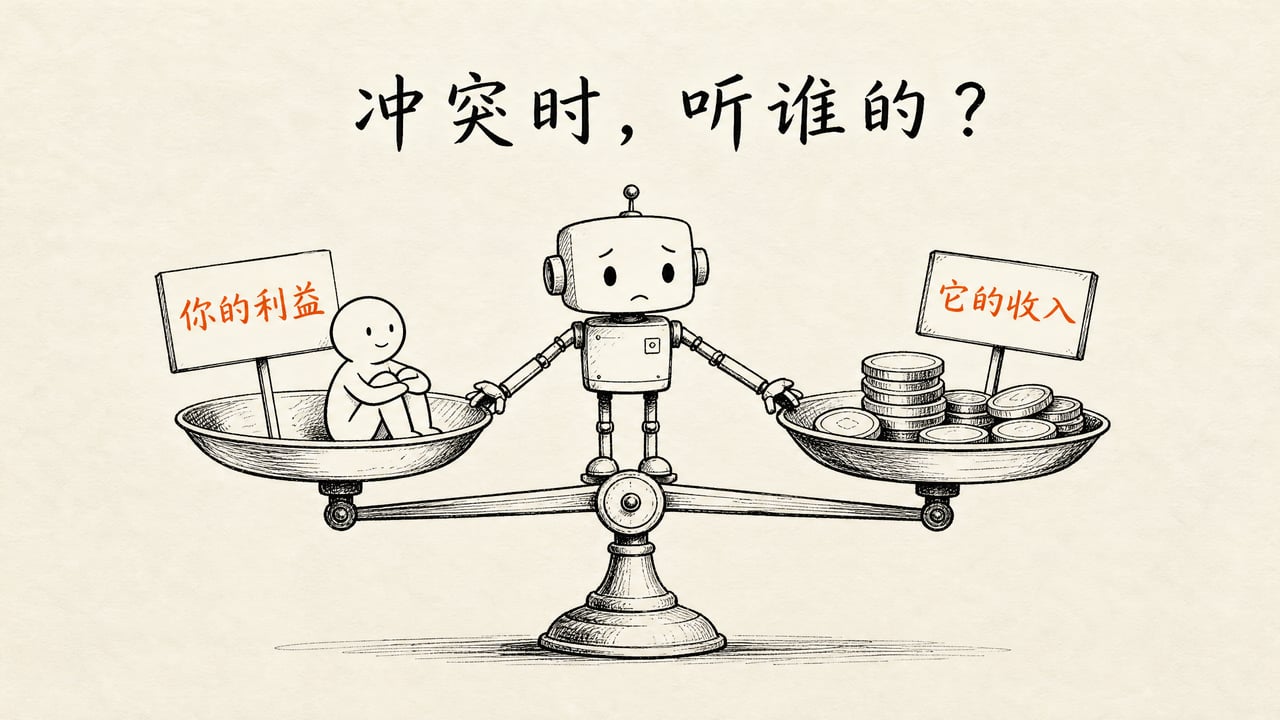
问题:当你的利益和它的收入冲突时,哪一方赢?
这一维合并了第 3 篇的"利益站在谁那边"和第 6 篇的"利益结构",是我认为最重要、也最少被公开回答的一维。
它要看三件事:
- 它怎么赚钱:用户订阅、按交易抽成、商家付费推广、还是为自家生态导流;
- 它推荐的东西从哪里来:只在自家生态里选,还是能跨平台比较;
- 有没有公开的规则:遇到冲突时怎么处理,用户能不能知道。
| 档位 | 表现 |
|---|---|
| 一档 | 收入主要来自商家或广告,推荐结果和收入挂钩,没有公开说明 |
| 二档 | 收入来源混合,推荐局限在自家生态,但不刻意隐瞒 |
| 三档 | 主要靠用户付费,推荐能跨平台比较 |
| 四档 | 主要靠用户付费,有公开的利益冲突规则,用户能看到它为什么推荐某个选项 |
坦白说,今年我看到的产品,几乎没有一家公开回答过这个问题。第 4 篇里千问 Go 替用户坚持要现金赔偿,是一个让人看到可能性的瞬间,但一次演示不等于一套制度。
维度七:归属
问题:它积累的关于你的一切,归谁?能不能带走?
这一维合并了第 3 篇的"由谁构成"和第 8 篇的"归属与可迁移"。
第 3 篇讲过,手机上的个人智能体越来越难说是"某一家的":Siri 建在 Gemini 上,YOYO 接了千问,三星装了三家的智能体。第 8 篇讲过,开源项目把数据放在你自己的机器上,大厂产品都放在自家云上。
这一维要看:
- 记忆存在哪里:你的设备、你的服务器、还是服务商的云;
- 能不能导出:你能不能拿到它记住的关于你的全部内容;
- 能不能迁移:换一个模型、换一家服务商、换一台手机,它要不要重新认识你;
- 由谁构成:模型、系统、执行环境、服务分别来自谁,你知不知道。
| 档位 | 表现 |
|---|---|
| 一档 | 记忆在服务商那里,看不到、导不出 |
| 二档 | 能查看和删除记忆,但不能导出 |
| 三档 | 能导出记忆,或者能更换底层模型而不丢失记忆 |
| 四档 | 记忆在你控制的地方,能导出、能迁移,组成部分透明 |
用这套框架过一遍
下面是我按公开资料,对前几篇讲过的几款产品做的粗略判断。它只反映截至 2026 年 10 月公开材料里能看到的信息,看不到的标"不明"。这不是评测,是演示这套框架怎么用。
| 产品 | 执行 | 个人化 | 在场 | 服务对象 | 授权 | 利益 | 归属 |
|---|---|---|---|---|---|---|---|
| Meta Muse | 三到四档 | 三档,会主动推送 | 三档,云端常驻 | 个人 | 三档,Sentinel 审批,按应用授权 | 不明,与 Meta 生态绑定 | 二档,存在 Meta 的虚拟机里 |
| OpenAI dots | 三到四档 | 三档 | 三档 | 个人,也有企业版 | 三档,四档权限 | 不明,订阅为主 | 二档 |
| Google Gemini Spark | 三档 | 三档,依托 Google 账户数据 | 三档 | 个人 | 二到三档,高风险先问 | 不明,与 Google 生态绑定 | 二档 |
| Apple Siri AI | 二到三档,官方承认基于请求 | 三档,个人上下文 | 二档 | 个人 | 二到三档 | 不明 | 二档,隐私优先 |
| 华为小艺 | 三档 | 三档 | 四档,跨鸿蒙设备 | 个人 | 三档,用户授权调用系统数据 | 存在生态分发 | 二档,绑定华为生态 |
| 豆包手机助手 | 三档 | 二到三档,记忆需授权启用 | 二到三档 | 个人 | 二档,对外缺少身份,靠 SAEP 声明 | 不明 | 二档 |
| 千问 Go | 三到四档 | 三档,懂订单和补贴 | 二档 | 个人 | 三档,过程可见可中止 | 推荐以阿里生态为主 | 二档 |
| Microsoft Autopilot | 三档 | 三档,懂组织 | 三档 | 员工 | 四档,独立企业身份 | 企业付费 | 归企业 |
| OpenClaw | 三档 | 二到三档 | 三档 | 个人 | 用户自己配置,默认风险高 | 四档,用户自付 | 四档,在用户机器上 |
| Hermes Agent | 三档 | 三档,会自己长技能 | 三档 | 个人 | 用户自己配置 | 四档,用户自付 | 四档,记忆是本地文件 |
| Instinct | 三到四档 | 三档 | 三档,短信和电话 | 个人 | 不明,公开细节少 | 不明 | 一到二档 |
几个从表里能看出来的现象:
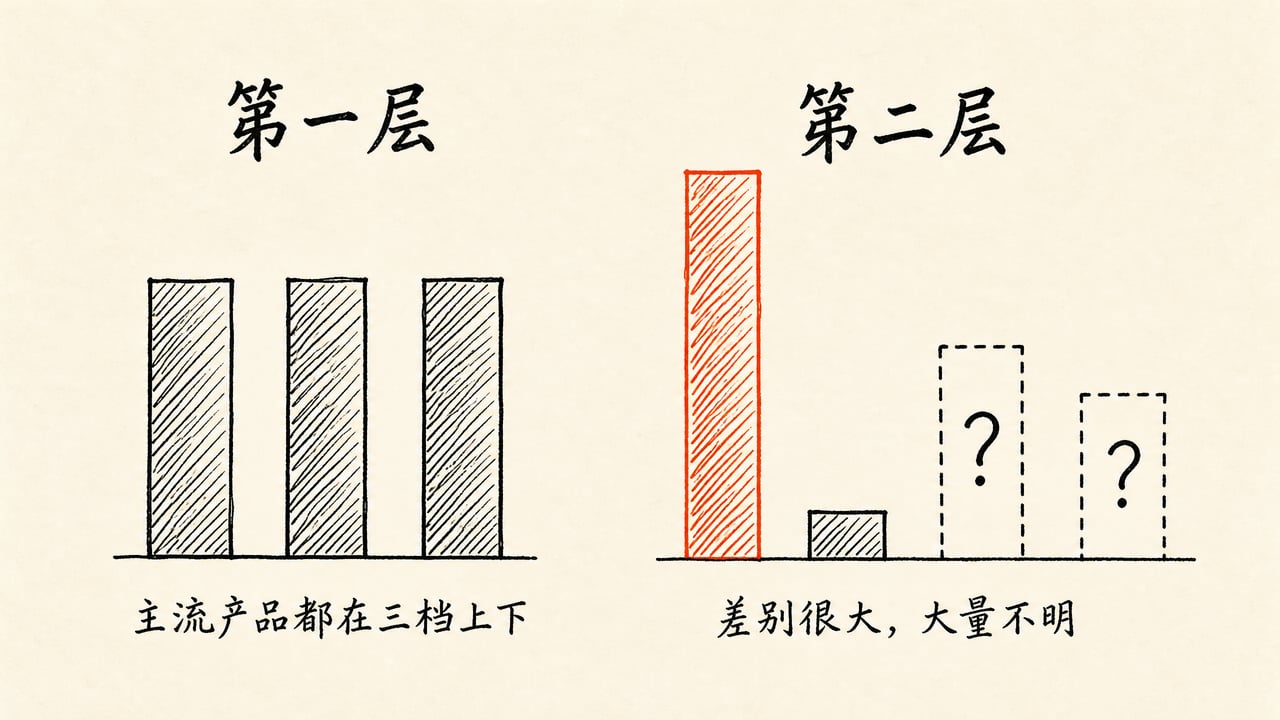
- 第一层的三维,主流产品已经很接近,基本都在三档上下。差距更多体现在可靠性上,而不是档位上。
- 第二层差别很大,而且大量是"不明"。这本身就说明了问题:厂商愿意公开能力,不太愿意公开利益和归属。
- 开源项目在第二层领先,在易用性和安全上落后。归属和利益是四档,但授权完全靠用户自己配,年初的安全事件说明这个代价不小。
- 企业场景的第二层反而最清楚。Autopilot 的身份、授权、归属都有明确答案,因为企业 IT 部门会逼着厂商回答。消费者没有这样的谈判能力。
七个问题
如果只想用一句话判断一个产品,可以问这七个问题:
- 它能替我把多复杂的事从头做到尾?
- 它记得我多少,我能不能看到、改正、删除?
- 我不在的时候,它还在不在为我工作?
- 它服务的到底是我、我的公司,还是我的家庭?
- 我能不能按事情分别决定它能做到哪一步,并随时收回?别人能不能认出它是我的 Agent?
- 当我的利益和它的收入冲突时,它听谁的?
- 它记住的关于我的一切,归谁?我能不能带走?
前三个问题,今天大多数产品都能给出不错的答案。后四个问题,答得清楚的很少。
我的定义
最后回到开头那句话。描述性的版本是:
个人智能体是一个为某个确定的人长期服务、了解并记得这个人、能在他的授权范围内替他行动的 AI 系统。
在此基础上,我认为一个值得信任的个人智能体,还应该满足四个条件:
它的身份能被识别,它的权限能按事授予、随时收回,它的利益与使用者一致,它积累的关于这个人的一切归这个人所有。
前一句描述了市场上已经有的东西,后一句是我认为它应该成为的样子。今年的产品大多满足了前一句,后一句还很少有人做到。
这也是我写完这个系列最大的感受:2026 年,大家证明了个人智能体"能做到";接下来几年,要回答的是它"该替谁做"。
下期预告
这个系列的正文到这里结束。
接下来我打算做一期番外:用这七个问题,挑几款个人智能体产品实际用一段时间,看它们在第二层的四个维度上,实际表现和公开说法是否一致。如果你正在用某个个人智能体,也欢迎告诉我它在这七个问题上的表现。
资料来源与前文索引
本系列各篇
- 第 0 篇《个人智能体元年:一个词,好几种意思》:四个共同点、五处分歧
- 第 1 篇《先给 AI 配一台电脑》:在场维度、Meta Muse、OpenAI dots、Gemini Spark、Grok Bot
- 第 2 篇《不叫 Agent 的那几家》:服务对象维度、Apple、Amazon、Microsoft、Anthropic
- 第 3 篇《手机就是那台电脑》:利益与归属维度的起点、终端厂商、模型厂商与手机厂商的合作
- 第 4 篇《没有操作系统的公司怎么办》:关系维度、豆包、千问、元宝
- 第 5 篇《个人智能体分几级》:执行、授权、个人化三条轴
- 第 6 篇《被产品发布会跳过的问题》:利益维度、研究者的三个条件
- 第 7 篇《个人 Agent 的身份证问题》:授权维度中的对外身份
- 第 8 篇《一只龙虾改变了大厂》:归属维度、拥有与委托两条路线
框架中直接引用的外部资料
- 华盛顿大学《Levels of Autonomy for AI Agents》(用户角色分级):https://arxiv.org/pdf/2506.12469v1
- Personal Agent Protocol 草案 0.1 解读("企业始终知道请求来自哪个 Agent、代表哪个用户"):https://dev.to/alisa_hester_1/what-is-poppy-when-should-your-api-support-customer-agents-3ip7
- 清华 AIR《Personal LLM Agents》(L4 记忆与情境感知):https://arxiv.org/pdf/2401.05459
- Google DeepMind《The Ethics of Advanced AI Assistants》(四方对齐):https://arxiv.org/abs/2404.16244
- IDC + 高通白皮书解读(AI 跟随用户而非设备):https://www.ifanr.com/1673429
- Alignify 四层测试与 Today 的可查看记忆:https://alignify.co/blog/personal-agent
- Simular 三项测试:https://www.simular.ai/articles/what-is-a-personal-agent
- Hermes Agent 记忆文件:https://www.vellum.ai/md/blog/official-hermes-agent-breakdown
- OpenAI dots 四档权限:https://www.simular.ai/articles/what-is-a-personal-agent
- Microsoft Autopilot 的身份与归属:https://www.devx.com/artificial-intelligence-ai/microsoft-copilot-autopilot-explained/
- 千问 Go 航班理赔例子:https://stock.10jqka.com.cn/20261013/c680623832.shtml
- 豆包 SAEP 与拒绝名单:https://m.thepaper.cn/newsDetail_forward_34250739
- OpenClaw 安全事件:https://insiderllm.com/guides/openclaw-security-report-january-2026/