OpenAI 和 Anthropic 在几个月内将 LLM 价格削减至最高 80%。为什么?
 25


让我们来看一下过去几个月里,OpenAI 和 Anthropic 双方主要的大型语言模型发布时间线。所有给出的价格均以 input MTok / output MTok / cache read MTok 为单位。
2026年6月26日
OpenAI 宣布推出 GPT-5.6 Sol 和 Luna。Sol 是 GPT 5.5 的直接后继版本,价格仍为 $5 / $30 / $0.50;而 Luna 则是一款专为更低成本场景设计的小型模型,定价为 $1 / $6 / $0.10。
他们还发布了一款介于两者之间的 Terra 模型,但关注度不高。
2026年6月30日
Anthropic 宣布推出 Claude Sonnet 5,据称其性能更接近 Anthropic 的 Opus 系列,但用户反馈褒贬不一。值得注意的是,该模型最初采用临时定价 $2 / $10 / $0.20,本计划随后上调,但最终维持不变。
2026年7月24日
Anthropic 宣布推出 Claude Opus 5,这是备受期待的主版本更新,鉴于 Opus 4.5 对代理式编程兴起产生的 影响,其定价为 $5 / $25 / $0.50(与 GPT-5.6 Sol 相当)。
尽管部分提供的基准测试结果出人意料地优于体积大得多的 Fable 5,但实际应用中的反馈则较为复杂。
2026年7月30日
OpenAI 宣布将 GPT-5.6 Luna 的价格下调 80%(???),降至 $0.20 / $1.20 / $0.02。
2026年8月10日
Anthropic 宣布,Sonnet 5 的首发临时折扣已转为永久定价。
2026年8月21日
OpenAI 宣布在未来三个月内将 GPT-5.6 Sol 的价格下调约 20%(至 $4 / $20 / $0.40)。
2026年9月1日
Anthropic 宣布推出 Fable 5.1,定价为 $10 / $50 / $0.25。该版本不仅在各项基准测试中全面超越六月发布的 Fable 5(定价 $10 / $50 / $1),还将缓存读取成本降低了 75%。
缓存读取成本
在使用代理进行编码时,缓存读取成本占总 token 消耗的绝大部分(96%–99%),因为每次交互时整个历史对话都存储在缓存中。此外,缓存命中率通常高达 90%–100%(具体数值因 LLM 推理服务提供商的基础设施而异)。
综合来看,缓存读取成本降低 75% 将使模型使用成本整体下降 70%–75%,这一降幅即使在以往常被视为次要因素的缓存成本上也十分显著!
2026年9月3日
OpenAI 宣布推出 GPT-6 Astra,其规模与 Fable 5.1 相当,定价也为 $10 / $50 / $1,但未提供更低的缓存读取成本。Astra 的模型性能确实可与 Fable 相媲美。
2026年9月22日
OpenAI 宣布推出 GPT-6 Sol,定价令人震惊,仅为 $2 / $10 / $0.20,较此前享受临时折扣的 GPT-5.6 Sol 的输入输出价格减半!同时发布的还有 GPT-6 Luna,其输入输出价格同样减半($0.10 / $0.50 / $0.01),降至旧版的一半。
在同一 同一天, Anthropic 宣布推出 Claude Opus 5.5,并明确指出“Opus 5.5 的推理所需算力低于 Opus 5,定价亦相应调整”。其总价 $4 / $20 / $0.20 远低于 Opus 5,得益于 20% 的输入输出成本削减以及更大的缓存读取成本降幅,使得总体成本降低了 40%–60%,且性能甚至优于 Fable 5.1(关于 Opus 5.5 我有很多话想说,但留待另文详述)。
2026年9月29日
事实证明,GPT-6 Sol 在性能上表现平平,因此一周后 OpenAI 宣布推出 GPT-6.1 Sol,其性能竟与 Astra 相当(经本人使用确认),而且 OpenAI 还顺势将缓存价格再减半($2 / $10 / $0.10),与 Anthropic 的 5% 输入成本相当,从而使该系列模型的整体成本累计降低了 75%。
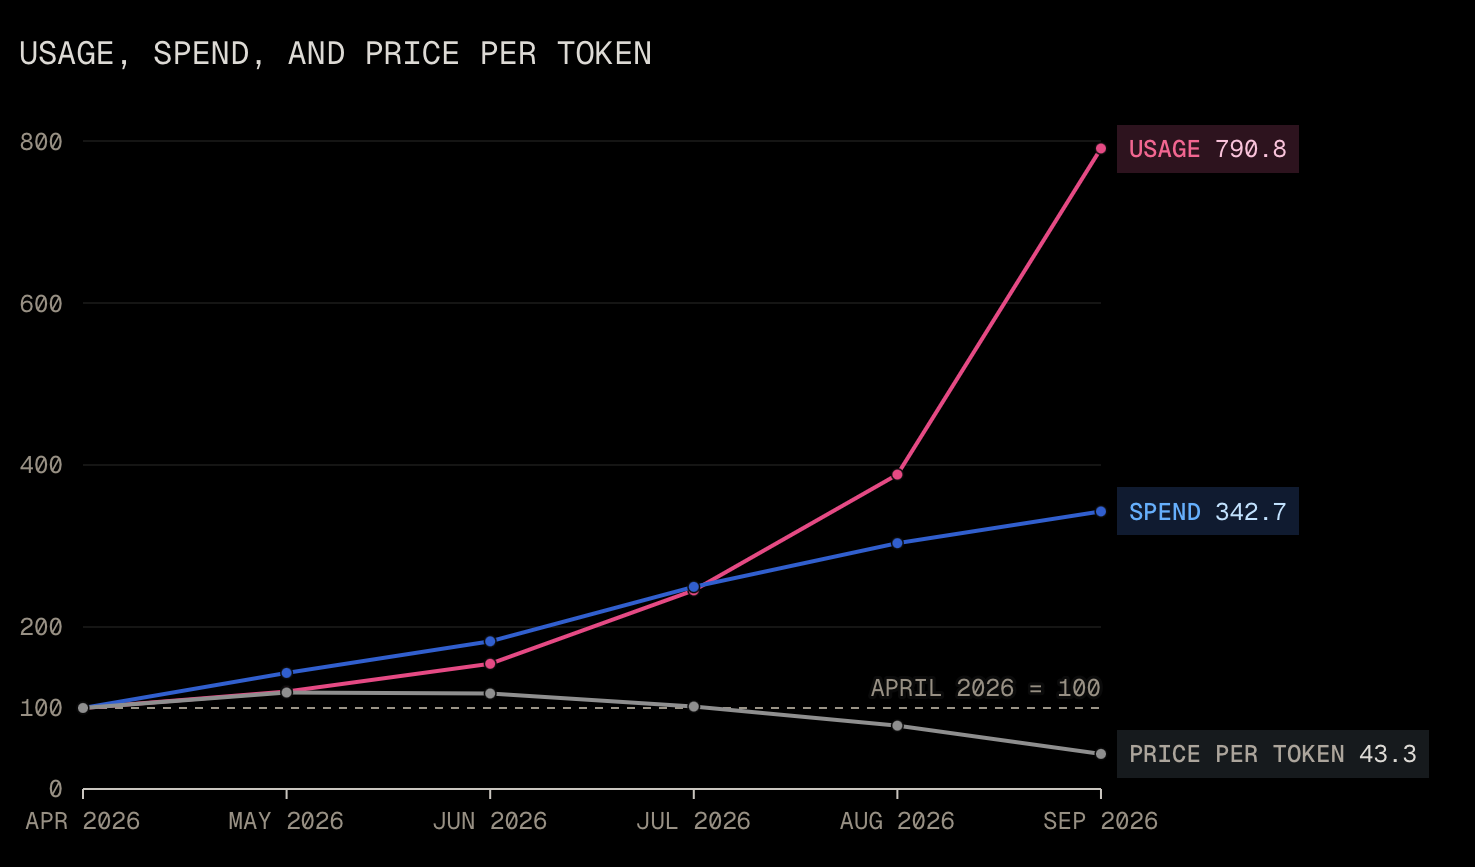
总体而言,自六月 GPT-5.6 系列发布至今,这些热门 LLM 的使用成本已大幅下滑,这是一年前我所始料未及的。这些降价同样适用于通过订阅方式使用的代理框架,例如 Codex 和 Claude Code。
更重要的是,这些模型在实现降价的同时,并未在输出质量上作出任何妥协。
从上述时间线可以看出,Anthropic 与 OpenAI 之间存在明显的针锋相对,可以合理推测,双方的此次降价互为回应。然而,除非存在某种外部因素,否则很少有公司会将价格下调 80%。
那么,究竟是什么原因呢?
LLM 的行为经济学与竞争对手的定价压力
如果你一直在测试新发布的大型语言模型代理,除了主观感受外,很难区分它们。自去年十一月代理大型语言模型的快速增长以来,模型变得越来越普及,只需在代码库中切换开关,比如OpenCode以及劫特工,或者通过不同的API端点字符串OpenRouter因此护城河很少。
此外,还有许多竞争对手——不仅仅是像这样的大型公司谷歌以及元文化——能够提供充分替代因此,允许价格压力。
对于开放重量模型,我们再来看看DeepSeek 闪光 V4.1,最近还发布了更新版1017型.
原版DeepSeek V4 Flash 0420已发布2026年4月,价格为$0.14 / $0.28 / $0.0028因此,OpenAI变得超级流行,尤其是当时OpenAI还没有针对简单任务的小类模型。
那$0.0028事实证明,缓存读取比例为2%,远低于上述OpenAI和Anthropic模型的5%-10%,这也构成了实际成本甚至低于宣传的水平。我怀疑7月份80%的GPT-5.6 Luna降价,是专门为了与这些较小的开放权重模型竞争。
现在,新的DeepSeek Flash V4.1 1017型号表现非常重要在基准测试方面比DeepSeek Flash V4更好 (45在人工分析指数与24而DeepSeek的成本也大致相同。$0.15 / $0.60 / $0.003.请注意关键词“来自DeepSeek”。
在OpenRouter上,任何推理提供商都可以列出他们托管的模型,当用户点击OpenRouter API时,请求会被路由到这些模型之一——默认情况下,请求会被路由到任何可用模型进行负载均衡,但开发者可以指定偏好比如API请求中的“最低价格”。
五月份,我已记录当时有13家不同的供应商在OpenRouter上托管DeepSeek V4 Flash。对于更新后的1017版本,现在有29 不同的服务提供者.
然而,从有效输入成本(考虑缓存读取成本与缓存命中率之间的相互作用)来看,许多不同的提供者在成本上相近。
OpenAI和Anthropic必须用更高质量的模型来区分这些开放权重模型——他们目前在这方面做得很好,尤其是在Opus 5.5方面——但他们必须这样做守这也是为什么数十亿美元被投入研发。
开放权模型正在迅速赶上:就在几天前,登月计划 AI已宣布Kimi K3.1 Pro其性能与作品5.5(Kimi在55与作品5.5的对比58)以输入/输出价格的一半和相同的缓存读取成本($2 / $10 / $0.20).它的大小和架构和Kimi K3目前由20多个不同的推理提供商托管:权重在11月4日下达后,你可以预期大多数平台将以大致相同的价格支持新的Kimi K3.1 Pro型号。
值得注意的是,Moonshot AI本身也加入了降价的行列,将Kimi K3.1 Pro定价低于原版Kimi K3 ($3 / $15 / $0.30).
一个反对 AI 的反对者反复出现的趋势是,代币价格被人为压低以吸引人们进入 LLM 生态系统,但随后价格会上涨到“代币的真实成本”,等免费搭车结束后,AI 助推者就会被坑。
理论上,OpenAI 和 Anthropic 是亏损主导就像2010年代Uber和Lyft对网约车行业的影响但与当时不同的是,OpenAI和Anthropic并非拥有生态系统中唯一定价权的双头垄断,推理行业的进入门槛也较低。
只要这些众多推理提供商能够继续以与OpenAI和Anthropic相近的价格和质量提供模型,且切换成本微乎其微,价格可能会继续下降更多.两家公司都在努力修建护城河以防范这一趋势,比如专注于企业承诺以及个人代理助理,如OpenAI 点以及克洛德二重奏.
代币价格会突然上涨的说法更多是个幻想,既没有行为经济学支持,也没有被大型语言模型价格下跌的实际趋势支持非常重要过去几个月里,更好的模型,不仅仅是OpenAI和Anthropic。
只要规模化者能以低于每代币收入的成本定价,这些推理提供者就会降低代币成本以相互竞争,直到OpenAI/Anthropic也不得不降低价格才能竞争。
OpenRouter上的29个独立供应商几乎没有动力去服务一个无利可图的模型(他们会停止提供该模型,转而利用计算能力来构建盈利模型),而“代币的真正成本”可能最终会是价格等于边际成本。
说到这里,OpenAI和Anthropic确实都接近上市,这也进一步引发了关于降价的疑问。
IPO抽水
此次降价的时机值得注意,因为据传OpenAI和Anthropic即将上市——OpenAI 将于 2027 年推出,Anthropic 几个月内上市.到目前为止,两者的财务泄露OpenAI以及人为毫不意外地显示,他们因研发和规模化而损失数十亿美元,尽管这两份报告都未考虑到过去几个月代理型LLM使用的超大规模扩张。
投资者会审视巨额负利润,要求他们制定计划扭转局面。
那么,为什么他们要将主要收入削减高达80%呢?这就是对面你想做什么才能在S-1招股说明书上看起来好看!推理利润率本身可能讲述了不同的情况,有些报道称每个代币的利润率是健康度可达80%但有前提条件。
经过这些大幅削减后,他们的利润空间有多大?
就我个人而言,降价确实影响了我在LLM代理上的花费,但并不是我预期OpenAI/Anthropic希望他们典型客户表现的方式。我以前有100美元的Codex订阅(5倍Pro套餐),当时GPT-5.6 Sol是顶级模型,尽管我对订阅感到恼火,但我还是设法用完了订阅中包含的所有使用量随机使用重置.一旦GPT-6.1 Sol发布,我发现使用成本实际上降低了75%,你知道我做了什么吗?
我会把最大使用量减到1/5,因为同型号使用效率提升了4倍,所以大致中性,是显而易见的选择。
公平地说,鉴于Claude Code和Codex相对于API使用量的巨大价值,订阅的利润率存在不确定性,如果出现资本紧张,我猜订阅价值会在模型基础价格之前被削减。
例如,在GPT-6.1 Sol发布的同时,OpenAI削减使用额度在Codex中每月200美元层级减少50%,理由是“反映我们日益高效的模式”——即技术上来说没错,但写下来确实挺有趣的。
我会的非常很想看看Anthropic首次公开招股说明书及其推断利润率。
我也怀疑如果OpenAI/Anthropic故意淘汰他们更贵的模型,这对他们是否有利。自从一个月前发布的Opus 5.5之后,就没有了任何讨论Fable 5.1或GPT-6 Astra,因为Opus 5.5实在太棒了。
我完全相信Fable 5.2/GPT-6.1 Astra会在几周内发布,证明我错了,而我一定会非常很好奇价格会如何。
另一个不那么愤世嫉俗的因素可能是大型语言模型基础设施具有在过去几个月里有所改进——当Anthropic说“Opus 5.5所需的计算量比Opus 5少,其定价也反映了这一点”时,我相信。
一个真正具有讽刺意味的结果是,如果这些模型计算效率更高,它就会减少对大规模数据中心建设的需求,避免导致连锁经济失败。然而,这很可能不会发生,因为推断只是计算组合的一部分,而这些数据中心仍然需要用于流程的其他部分。
总体来说,降价很奇怪,但作为用户我绝不抱怨!开放权模型和二级推理提供商将继续作为经济制衡大型语言模型价格及大型实验室可能策划的其他商业花招的工具。
即使Anthropic和OpenAI的首次公开募股灾难性,导致两家公司倒闭,也不会突然导致大型语言模型和代理作为一个行业的衰亡。