Java SE八股整理.md

Java SE八股整理 ## Java 核心特性 - 面向对象:支持封装、继承、多态三大特性,以对象为核心组织程序结构 - 平台无关性:基于 JVM 屏蔽底层差异,将源代码编译为字节码后可在任意安装JVM的平台上运行 - 内存自动管理:内置垃圾回收机制(GC),无需像C语言手动调用 malloc/free 释放内存,降低了内存泄露的风险 - …… ## JVM、JRE、JDK > JAVAGUID-java基础 JVM:Java 虚拟机(Java Virtual Machine, JVM)是运行 Java 字节码的虚拟机。JVM 有针对不同系统的特定实现(Windows,Linux,macOS),目的是使用相同的字节码,
它们都会给出相同的结果。字节码和不同系统的 JVM 实现是 Java 语言“一次编译,随处可以运行”的关键所在。
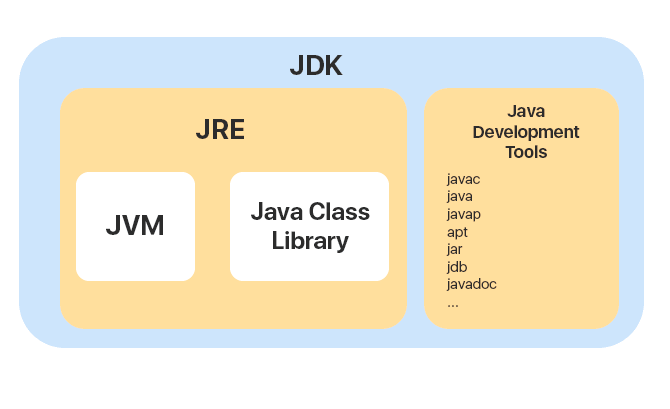
JRE:Java Runtime Environment,JRE 是运行已编译 Java 程序所需的环境,主要包含以下两个部分: 1. JVM : 也就是我们上面提到的 Java 虚拟机。 2. Java 基础类库(Class Library):一组标准的类库,提供常用的功能和 API(如 I/O 操作、网络通信、数据结构等)。 JDK(Java Development Kit)是一个功能齐全的 Java 开发工具包,供开发者使用,用于创建和编译 Java 程序。它包含了 JRE(Java Runtime Environment),以及编译器 javac 和其他工具,如 javadoc(文档生成器)、jdb(调试器)、jconsole(监控工具)、
javap(反编译工具)等。 image-20261021113456276 > 图片源自:oss.javaguide.cn/github/javaguide/java/basis/jdk-include-jre.png ## 基础数据类型 Java 中有 8 种基本数据类型,分别为: - 6 种数字类型: - 4 种整数型:byte、short、int、long,占用字节分别是:1字节、
2字节、4字节、8字节 - 2 种浮点型:float、double,,占用字节分别是4字节,8字节 - 1 种字符类型:char,2字节 - 1 种布尔型:boolean,true/false 这八种基本类型都有对应的包装类分别为:Byte、Short、Integer、
Long、Float、Double、Character、Boolean。
### 基本类型与包装类的区别是? 我觉得主要区别在于代码的复用性,与前端的JavaScript不同,JavaScript通过原型链实现复用,
而Java则主要通过类的继承实现,子类继承父类的方法,因此包装类可以使用父类的方法,
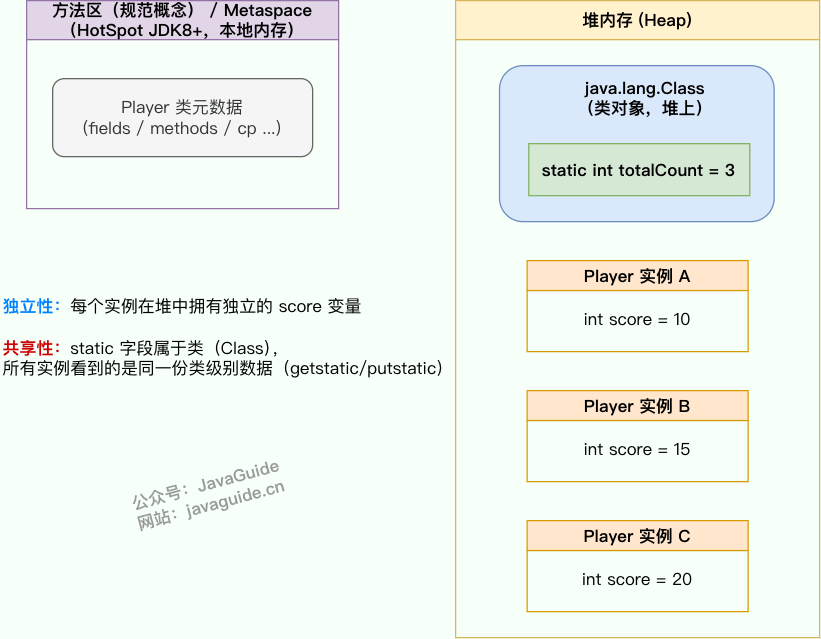
如:map、filter……,但基本类型不行 ## 面向对象 ### 三大特性 面向对象的三大特性: - 封装:通过 private 修饰属性,提供 getter/setter 方法控制访问,隐藏内部实现细节 - 继承:子类继承父类的属性与方法,提高了代码的复用性 - 多态:子类重写父类的方法,后续调用时使用子类重写后的方法,提高了代码的灵活性和可扩展性 ### this 关键字 类可以有多个实例,this 关键字便指向实例本身 ### this与静态方法、静态变量 在 Java 中通过 static 修饰的属性称为静态变量,通过 static 修饰的方法称为静态方法,两者的共同特点是:全局属性/全局方法 image-20261021113625632 > 图片源自:oss.javaguide.cn/github/javaguide/java/...va-basis-variables-static-variable.png 而 this 是指向实例本身,因此静态方法是没有this的,只能访问静态变量,不能直接访问实例成员 ### 重写与重载 重写:实现面向对象多态的基础,子类继承父类方法时,可进行重写,后续方法使用时,
查找方法从子类到父类逐步往上查找,此时子类重写了父类的方法,可直接使用,
不会经过父类的方法 重载:多个同名方法,但不同参数,根据参数选择对应的方法 ### 抽象类与接口的区别 抽象类与接口的主要区别是,一个类只能继承一个抽象类(Java不支持多继承),
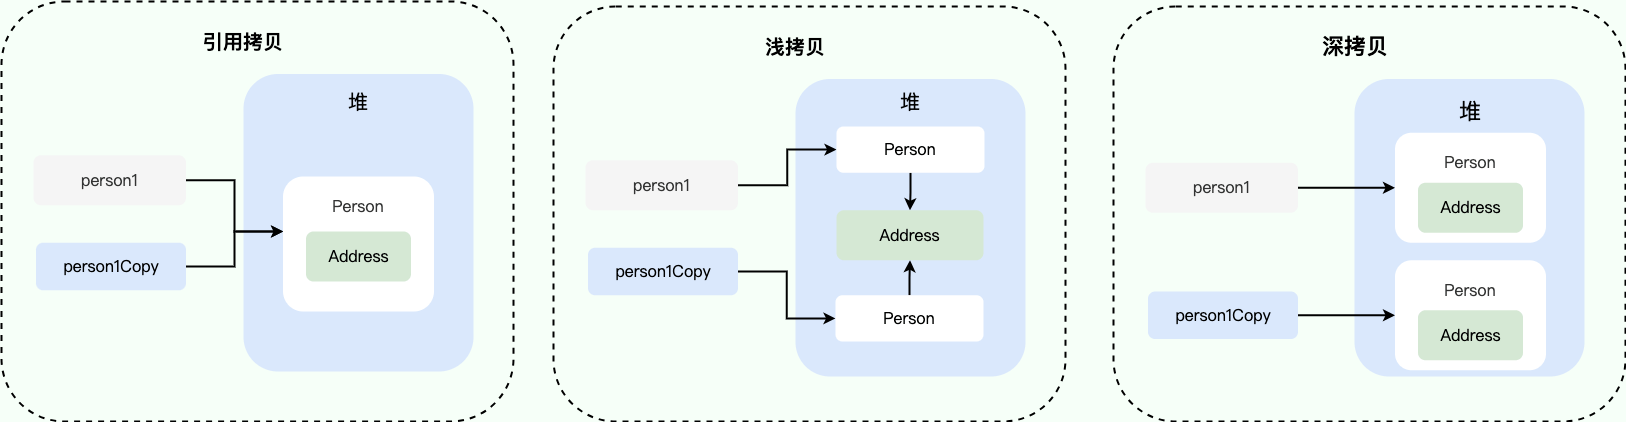
但一个类却可以实现多个接口 ### 浅拷贝与深拷贝的区别 两者的区别主要体现在引用数据类型,浅拷贝会拷贝引用数据类型的地址值,而深拷贝则完全拷贝一个对象,
并将堆中的对象也拷贝一份 image-20261021113646622 > 图片源自:oss.javaguide.cn/github/javaguide/java/basis/shallow&deep-copy.png ### 为什么重写 equals() 时必须重写 hashCode() > 参考:Java equals() 和 hashCode() 详解 #### equals() 方法 equals() 定义在 Java 的 Object 类中,默认通过 == 判断两个引用是否指向同一个对象 ``Java public boolean equals(Object obj) { return this == obj; } ` 但实际开发中,我们可能希望两个不同对象的属性相同,也认为它们相等,因此需要重写 equals() 例如: `Java Person p1 = new Person("Tom", 20); Person p2 = new Person("Tom", 20); System.out.println(p1 == p2); // false System.out.println(p1.equals(p2)); // true(重写 equals 后) ` 重写示例: `Java @Override public boolean equals(Object obj) { if (this == obj) return true; // 同一个对象 if (obj == null || getClass() != obj.getClass()) return false; Person person = (Person) obj; return age == person.age && Objects.equals(name, person.name); // 不同对象比较属性是否相同 } ` #### hashCode() 方法 hashCode() 同样定义在 Object 类中,用于返回对象的哈希码(int 类型),主要用于 HashSet、HashMap 等哈希集合,辅助快速定位元素,以 HashSet 为例,底层基于 HashMap 实现,添加元素时: 1. 计算哈希值:调用 hashCode(),经过处理后确定数组桶的位置 2. 检查桶内元素: - 桶为空:直接插入 - 桶不为空:检查已有节点的哈希码 - 哈希码相同:进一步通过 == 或 equals() 判断是否相等 3. 决定是否插入: - 存在相等元素:拒绝插入 - 不存在相等元素:插入新节点 注意:不同哈希码也可能映射到同一个桶,但不会因此直接调用 equals() 比较 #### 为什么重写 equals() 必须重写 hashCode() 假设 Person 只重写了 equals(),没有重写 hashCode() `Java Person p1 = new Person("Tom", 20); Person p2 = new Person("Tom", 20); System.out.println(p1.equals(p2)); // true HashSet set = new HashSet<>(); set.add(p1); set.add(p2); System.out.println(set.size()); // 可能为 2 ` 问题原因: - p1 和 p2 属性相同,equals() 返回 true - 但默认 hashCode() 通常根据对象身份生成哈希码,两者可能不同 - HashSet 根据不同哈希码定位元素,可能将两个对象都插入集合,导致去重失败 解决方法:同时重写 hashCode(),使用与 equals() 相同的属性计算哈希码 `Java @Override public int hashCode() { return Objects.hash(name, age); } ` 此时: `Java p1.equals(p2); // true p1.hashCode() == p2.hashCode(); // true ` HashSet 就能正确识别两个逻辑上相等的对象,最终 set.size() 为 1 总的来说,重写 hashCode 是为了处理当两个对象相同时,哈希表不重复添加元素 #### 总结 - equals():判断两个对象在逻辑上是否相等 - hashCode():生成哈希码,帮助哈希表快速定位对象 - 重写 equals() 时必须同时重写 hashCode(),保证相等对象具有相同哈希码 - hashCode() 相同不代表对象相等,仍需通过 equals() 进一步判断 核心:equals() 负责判断对象是否相等,hashCode() 负责辅助定位对象,两者必须遵守一致的相等性规则,才能保证哈希集合正常工作 ## String、Stringbuilder、Stringbuffer > 文档:javaguide.cn/java/basis/java-basic-questions-02.html 都是用来处理字符串的,但 String 不可变,每次修改都会生成新的对象,并将引用指向新的实例(即新的String),
而 StringBuffer 和 StringBuilder 都是可变的,它们在修改字符串时不会创建新对象,而是直接在原有字符数组上进行操作。
因此,遇到大量字符串连接可以用 StringBuilder ,不会生成许多新的对象,StringBuilder 与 StringBuffer 的区别是,StringBuffer 对字符串的基本操作,如:append、insert 等都添加了同步锁,synchronized,线程安全,而 StringBuilder 并没有对方法进行加同步锁,所以是非线程安全的。
String 为什么不可变?——final - 在源码中,java对于 String 类的保存通过数组存储每个字符,并通过 final 进行修饰,而且没有提供/暴露修改这个字符串的方法 - String 类也被 final 修饰,导致其不能被继承,进而避免了子类破坏 String 不可变 `java public final class String implements java.io.Serializable,Comparable, CharSequence { // @Stable 注解表示变量最多被修改一次,称为“稳定的”。
@Stable private final byte[] value; } ` ## 字符串常量池的作用了解吗? > 文档:javaguide.cn/java/basis/java-basic-questions-02.html 字符串是引用数据类型,默认情况下每次创建都会开辟新的空间,放置对象,并返回引用地址,
但用于字符串是不可变的,此时 JVM 开辟一块空间放置字符串,也就是字符串常量池,提示了性能并减少内存消耗,避免字符串重复创建 `java // 1.在字符串常量池中查询字符串对象 "ab",如果没有则创建"ab"并放入字符串常量池 // 2.将字符串对象 "ab" 的引用赋值给 aa String aa = "ab"; // 直接返回字符串常量池中字符串对象 "ab",赋值给引用 bb String bb = "ab"; System.out.println(aa==bb); // true ` ## 泛型 泛型,我的理解是参数,将数据的类型参数化,在定义类、接口或者方法时不必指定具体的数据类型,
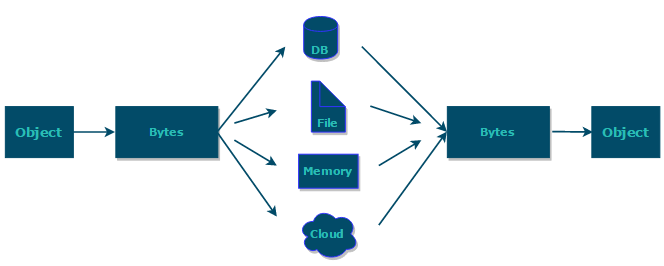
在实际使用时指定具体的类型即可 `java class Box { private T value; public void setValue(T value) { this.value = value; } public T getValue() { return value; } } ` `java Box box1 = new Box<>(); // 指定 String 类型 box1.setValue("Hello"); Box box2 = new Box<>(); // 指定 Integer 类型 box2.setValue(100); ` ## 序列化与反序列化 image-20261021113723532 > 图片源自:oss.javaguide.cn/github/javaguide/a478c74d-2c48-40ae-9374-87aacf05188c.png 序列化(Serialization):将 java 中对象持久化保持,保持格式有二进制字节流(Bytes)、JSON等 反序列化:序列化的逆过程,将序列化持久化的文件转换为对象的过程 ## 反射 在程序运行时,可以动态的获取类的属性与方法,并可以调用方法,例如: `java User user = new User(); user.sayHello(); ` 编译时已经明确知道调用的是 User 类的 sayHello() 方法。而通过反射: `java Class clazz = Class.forName("com.example.User");
// 获取构造方法并创建实例
Object user = clazz.getDeclaredConstructor().newInstance();
// 获取指定方法
Method method = clazz.getMethod("sayHello");
// 调用方法
method.invoke(user);
• *总结:read() 返回 int 并不意味着每次读取 4 个字节,而是为了完整表示单字节的 0~255,同时保留 -1 作为文件结束标志**
BIO、NIO、AIO的区别
BIO、NIO、AIO 是 java 中常见的 3 种 IO 模型,三者的区别:
- BIO:blocking IO,阻塞,read 调用后会一直阻塞,直至读取完成
- NIO:new IO,同步非阻塞 IO,一个线程监听多个 channel ,就绪时进行后续的处理
- AIO:异步IO,当 IO 完成后执行回调函数即可
hashMap
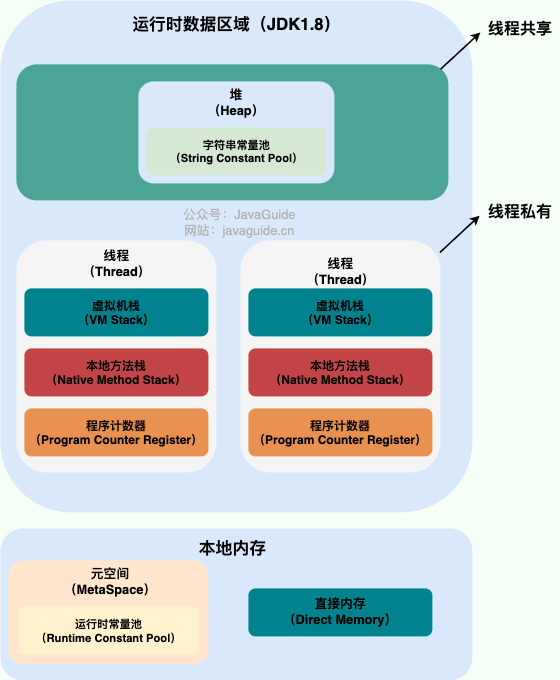
JVM 内存结构
【java】jvm内存模型全面解析_哔哩哔哩_bilibili
image-20261021113752392
图片源自:oss.javaguide.cn/github/javaguide/java/jvm/java-runtime-data-areas-jdk1.8.png
Java 虚拟机(JVM)的运行时数据区域主要分为五部分:
栈帧:栈的基本单位,每调用一个 java 方法,JVM 就会为该方法创建一个栈帧,用于存储该方法所需的数据
需要注意:
- 每个线程都有自己的虚拟机栈、程序计数器等线程私有空间,线程结束后,相应的运行时空间也会被释放
- 堆由线程共享,对象通常分配在堆中,但存在逃逸分析等优化情形
- 方法区是逻辑概念,在 HotSpot JVM 中,JDK 8 起主要使用元空间(Metaspace)实现,元空间使用本地内存,不属于 Java 堆
堆与栈的区别
按照常见情况理解:
- age:栈,基本类型局部变量,其值存放在栈帧的局部变量表中
- person:局部引用变量,存放在栈帧的局部变量表中
- new Person():堆,创建的对象通常存放在堆中
栈主要管理方法执行过程,存放局部变量等,堆主要存储对象实例等引用数据类型
GC 垃圾回收
为什么需要 GC 垃圾回收?
堆中的数据需要处理,在栈中,出栈后数据会进行删除,但栈存放的是局部变量,
而堆中存放的是引用数据类型,如:对象,此时栈中只会清理局部变量,堆中的对象等还没有处理,
因此需要GC对堆中的数据进行清理
GC(Garbage Collection)即垃圾回收,负责自动识别并回收不再使用的对象,减少手动管理内存的负担。
堆内存分代结构
传统分代垃圾回收将 Java 堆划分为两个主要区域:
- 新生代(Young Generation):主要存储新创建的对象,生命周期通常较短
- 老年代(Old Generation):主要存储经过多次 GC 后仍然存活的对象
新生代又分为三个区域:
- Eden(伊甸园,新生区):对象通常最先分配的区域
- Survivor 0(S0):幸存者区
- Survivor 1(S1):幸存者区
image-20261020171035936
新生代垃圾回收(Young GC)
新生代采用的经典垃圾回收算法是复制算法(Copying)。
基本流程:
- 新创建的对象通常分配在 Eden 区
- Eden 空间不足时,可能触发 Young GC
- GC 识别仍然存活的对象,将其复制到空闲的 Survivor 区
- 清理 Eden 及原 Survivor 区中不再需要的对象
- S0 和 S1 轮流充当存活对象复制的目标区域
- 对象经过多次 GC 仍然存活,达到一定条件后晋升到 Old 区
image-20261020171116136
• *为什么使用复制算法?**
因为新生代中的对象通常存活率较低,仅需复制少量存活对象,效率较高,同时能够减少内存碎片。
注意:若 Survivor 空间不足,对象也可能提前晋升到老年代,不一定必须经过固定次数的 GC。
老年代垃圾回收(Old GC)
老年代主要存储长期存活的对象,这些对象存活率通常较高,因此经典分代模型中通常采用以下算法:
- 标记-清除(Mark-Sweep):标记存活对象,清除不可达对象,但容易产生内存碎片
- 标记-整理(Mark-Compact):标记存活对象,将其移动到连续空间,再回收剩余内存,减少内存碎片
image-20261020171243630
• *为什么老年代不适合简单使用新生代的复制方案**?
因为老年代对象存活率通常较高,需要复制的对象较多,复制开销较大。
需要注意,具体算法取决于垃圾收集器。
例如,传统 Parallel Old 使用标记-整理,旧版 CMS 主要使用标记-清除,G1 则通过 Region 进行对象转移和空间回收。
总结
GC的存在是为了解决堆中的数据清理,由于栈区域出栈时会将局部变量等数据进行删除,
但栈中引用的对象等存放在堆区域,而堆区域便是由 GC 进行数据清理,清理的逻辑大致是:
- young区域存放新 new 的对象
- young区域大致分为三块:E区、S0区、S1区
- E区满了会触发young GC,进行清理,清理策略是复制,将E区存活的数据放置在空闲的S区,然后清空E区与另一个S区,通过两个S区进行交替工作
- 当young区多次GC清理,某些对象仍存在时,如:清理6次,仍存活,此时该对象会晋升到OLD区,表示使用频率高,存活率高
- old区满时触发oldGC,清理策略一般是标记-清楚或者标记-整理
注意:
- young区空间有限,若清理复制时:S区空间满了,剩余存活对象会提前进入old区
- 大对象会放置在old区,因为大对象进行复制时开销太大,而old区若采用标记-清楚策略时,不会进行移动,更适合
GC 如何判断哪些对象需要回收?
核心原理:可达性分析(Reachability Analysis),从 GC Roots 出发,沿着对象引用关系向下查找,无法从 GC Roots 到达的对象,通常就可以被回收。
GC 并不是简单地检查某个变量是否存在,而是判断对象是否仍然存在有效的引用路径。
GC Roots 主要有哪些?
入门阶段重点掌握以下几类:
注意:并不是只有栈和 static 才能影响对象是否被回收。 只要某个对象能够通过引用链从 GC Roots 到达,就可能继续存活。
示例:栈引用与 static 引用
结合代码理解:
- a = null:只是取消 a 对对象的引用,但 b 仍然引用该对象,因此对象仍然可达
- b = null:如果不存在其他有效引用路径,该对象就可能成为垃圾
- global = null:取消静态字段对对象的引用;如果没有其他有效引用路径,该对象也可能成为垃圾
这里需要区分两个概念:不可达不等于立即被回收。它只是说明对象具备被回收的条件,具体何时回收由 JVM 决定。
static 对象为什么通常不会被回收?
例如:
只要对应的类仍处于可达状态,且静态字段 global 仍然引用这个对象,那么 GC 就能沿着这条引用路径找到它。
因此,该对象通常不会被当作垃圾回收。
不过,static` 并不意味着对象永远不会被回收。如果对应的类可以被卸载,或者静态字段不再引用该对象,
且没有其他有效引用路径,对象仍然可能被回收。
最后总结
可以把 GC 的判断过程理解为:
- 找到 GC Roots
- 沿着引用关系遍历对象
- 能够到达的对象,继续保留
- 无法到达的对象,通常具备被回收的条件
- JVM 在合适的时机执行实际回收
栈中的有效引用、static 字段等决定了对象是否仍然可达;GC 通过可达性分析判断堆中的对象是否具备回收条件,而不是简单地清理没有被当前方法直接引用的数据
JVM调优参数有哪些?
调优主要针对于JVM内存空间的分布,主要是栈和堆
- 虚拟机栈的设置
- 设置堆空间的大小
- 调整年轻代E区与两个S区的大小比例
- 年轻代晋升老年队的阈值
- 设置GC,常见的垃圾回收收集器有:CMS、G1
OOM 与 full GC 问题排查
out of memory:内存溢出,堆中对象过多、发生内存泄露、堆内存不足等会产生OOM问题
OOM与内存泄露的区别:内存泄露指的是不再使用的对象无法被回收,会占据内存空间,导致内存空间减小,后续可能发生OOM问题
排查流程:
1. 收集日志:查看 GC 日志,判断是否频繁 Full GC、GC 后内存是否下降,以及是否出现 OOM;日志的话可以通过配置参数来开启,现在好像可以直接配置:-Xlog:gc,记录GC日志
2. 获取 Dump 文件:通过 JVM 参数在发生 OOM 时自动生成堆转储文件,保留内存现场;dump:转储的意思,会生成日志文件
3. MAT 分析:使用 MAT 分析生成的日志文件,一般会指出哪个对象出了问题,后续通过代码进行定位,进行修复
4. 修复并验证:根据原因优化代码或调整 JVM 参数,再通过压测观察 GC 频率、内存占用和应用运行情况
类加载过程与双亲委派模型
类加载过程
背景:Java源代码代码经过编译生成class文件,而类加载过程便是从磁盘中读取所生成的 class 文件到 JVM 中,在 JVM 中生成对应的 class 对象,方便后续直接 new 生成实例
五个阶段:加载 → 验证 → 准备 → 解析 → 初始化
| 阶段 | 核心作用 | 关键词 |
| - | - | - |
| 加载阶段 | 从磁盘中获取对应的class文件,在jvm中生成对应的class对象 | 加载class文件(字节码) |
| 验证阶段 | 检查字节码是否合法、安全 | 校验字节码合法性 |
|准备阶段|为静态变量分配内存空间,并设置默认值|分配内存空间、默认值|
|解析阶段|将符号引用转换为直接引用|符号引用 → 直接引用|
|初始化阶段|执行类初始化代码,赋予静态变量代码中设定的值|执行 (),不是 init()|
解析阶段:符号引用转变为直接引用是什么意思?
指的是当某个类的方法被调用时,解析阶段直接定位到该方法的具体位置,如:下方 main 调用了 Helper 类的 doWork 方法
此时,解析阶段 JVM 会根据符号引用找到对应的类和方法,并建立能够定位该目标的直接引用
注意两个高频考点:
- 准备阶段不等于赋予代码中定义的初始值:普通静态变量在准备阶段先获得默认值,初始化阶段再执行相应的赋值代码
- 初始化不等于执行构造方法:初始化阶段执行的是类初始化方法 (),它由静态变量赋值语句和 static 静态代码块合并生成;对象构造方法 () 则在创建对象时执行
例如:
- 准备阶段:a = 0
- 初始化阶段:先执行 a = 10,再执行静态代码块,最终 a = 20
补充:五个阶段通常按上述顺序推进,但解析阶段可以根据虚拟机实现的需要延迟执行,因此不一定发生在初始化之前
双亲委派模型
核心记忆:递归向上加载,先向父加载器委托,父加载器无法加载时,子加载器再尝试
当类加载器收到类加载请求时,通常遵循以下流程:
image-20261021154152217
为什么需要双亲委派?
- 安全性:例如 java.lang.String 应由受信任的核心类加载机制加载,避免应用自行定义同名类替换它
- 避免类的重复加载:父加载器已经成功加载的类,子加载器通常可以直接使用,无需再次加载
补充:双亲委派是常见的类加载机制,不是所有类加载场景都必须严格遵循它。自定义类加载器可以通过重写相关方法改变默认行为
类加载器有哪些?
Java 中常见的类加载器可以分为四种:启动类加载器、扩展类加载器、应用类加载器和自定义类加载器
补充说明:
- 启动类加载器:由 JVM 实现,通常负责加载 java.lang.String 等核心类
- 扩展类加载器:Java 8 及之前主要加载 jre/lib/ext 等扩展目录中的类库
- 应用类加载器:也称系统类加载器,可以通过 ClassLoader.getSystemClassLoader() 获取
- 自定义类加载器:通常通过继承 ClassLoader 并重写 findClass() 等方法实现,可用于插件系统、动态加载等场景
注意:Java 9 起,扩展类加载器被平台类加载器(Platform ClassLoader)取代。因此,面向 Java 8 的面试资料通常使用“扩展类加载器”,面向 Java 9 及之后的版本则应使用“平台类加载器”
类加载器之间的关系
这里的箭头表示父子委派关系的方向相反于请求方向:加载请求从子加载器向父加载器委托,
父加载器无法加载时,再由子加载器尝试,自定义类加载器可以有不同的父加载器,
也可以改变默认的委派行为,因此上述关系是常见情况,并非固定结构
面试速记
Java 常见的类加载器包括启动类加载器、扩展类加载器、应用类加载器和自定义类加载器。启动类加载器负责加载核心类库,扩展类加载器负责加载扩展类库,应用类加载器负责加载应用程序的类,自定义类加载器则用于满足特殊的类加载需求。需要注意,Java 9 起,扩展类加载器被平台类加载器取代

 点赞
 收藏
 点踩
 分享