分治法算法设计美学:最近点对问题的快速解
对于一个二维平面上散落的若干点,要从中求出离得最近的两个点。这个是计算几何中基础且重要的问题,是聚类分析、碰撞检测、图形渲染的理论基础之一。朴素的两两匹配做法时间复杂度上会到 O(n²) ,大数据规模下几乎不可用。本文从利用分治法“分、解、合”的思想,优化二维中的最近点对问题。
本算法我用DeepSeekV4.1-flash制作了一个比较清晰简明的视频,[分治法] 二维最近点对问题的优化 可以作为参考。
现在给出一个问题,平面上给定 n 个点的坐标 (xᵢ,yᵢ) ,求距离最小的那一对点的编号以及两点间的距离。
一、暴力法:小数据可用
最直接的做法是枚举所有点对(xᵢ,yᵢ) (xⱼ,yⱼ),同时保证 i < j ,逐个算欧氏距离,取最小:
double brute(Pt p[], int n) {
    double best = 1e18;  // 目前的最小距离
    for (int i = 0; i < n; i++){
        for (int j = i + 1; j < n; j++){     // 只枚举 i 之后的点,避免重复
            best = min(best, dist(p[i], p[j]));
        }
    }

    return best;
}
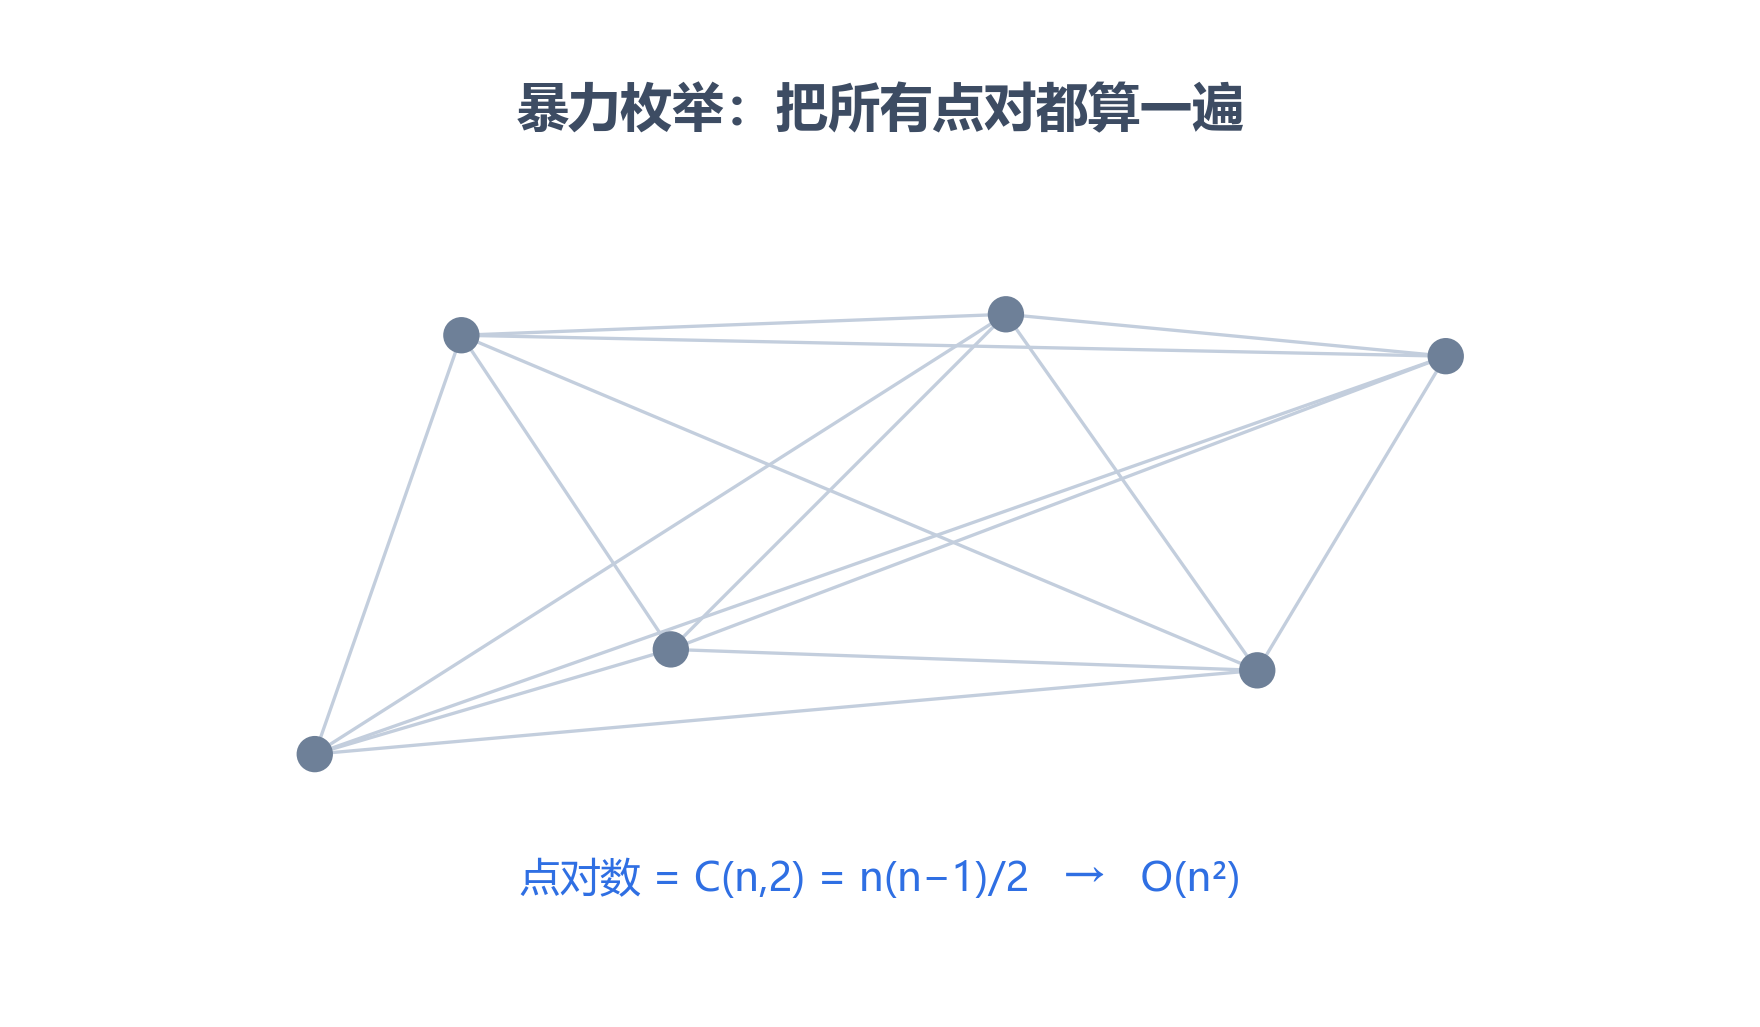
点对总数是组合数 C(n,2) = n(n−1)/2,也就是 O(n²) 级别。在小数据下尚且可用,但是当 n = 10⁵ 时大约要算 50 亿对,几乎不可用。但是我们其实很容易发现,有些点离一个点之间的距离明显大于他离周围的点的距离,很多对比实际上是无用的,所以我们的目标就是要省去那些明显不必要的比较。
二、分治:切割成块,逐块寻找
这道题很符合分治法的直觉。首先把点集画一条平行于y轴的竖线,对左右两侧分别求距离最小值,再加上跨越分割线的点对的距离最小值,就可以将原问题分割成两个与原问题相同(其实是近似相同,因为分割线两侧的最近点问题实际上是原问题没有、而原问题的非最小子问题都有的)、规模更小的子问题,将子问题解决、并将结果收集起来后,就可以得出原问题的解。这完全符合分治法“分割、求解、合并”的算法流程。
所以算法的求解流程就如下:
- 拆分:先把所有点按 x 排列,画一条竖线将点集等分成左半、右半;
- 递归:左半、右半各自递归地求内部的最近点对,设得到的最小距离分别是 d左、d右;
- 合并:令 d = min(d左, d右),再专门处理一左一右的跨线点对。
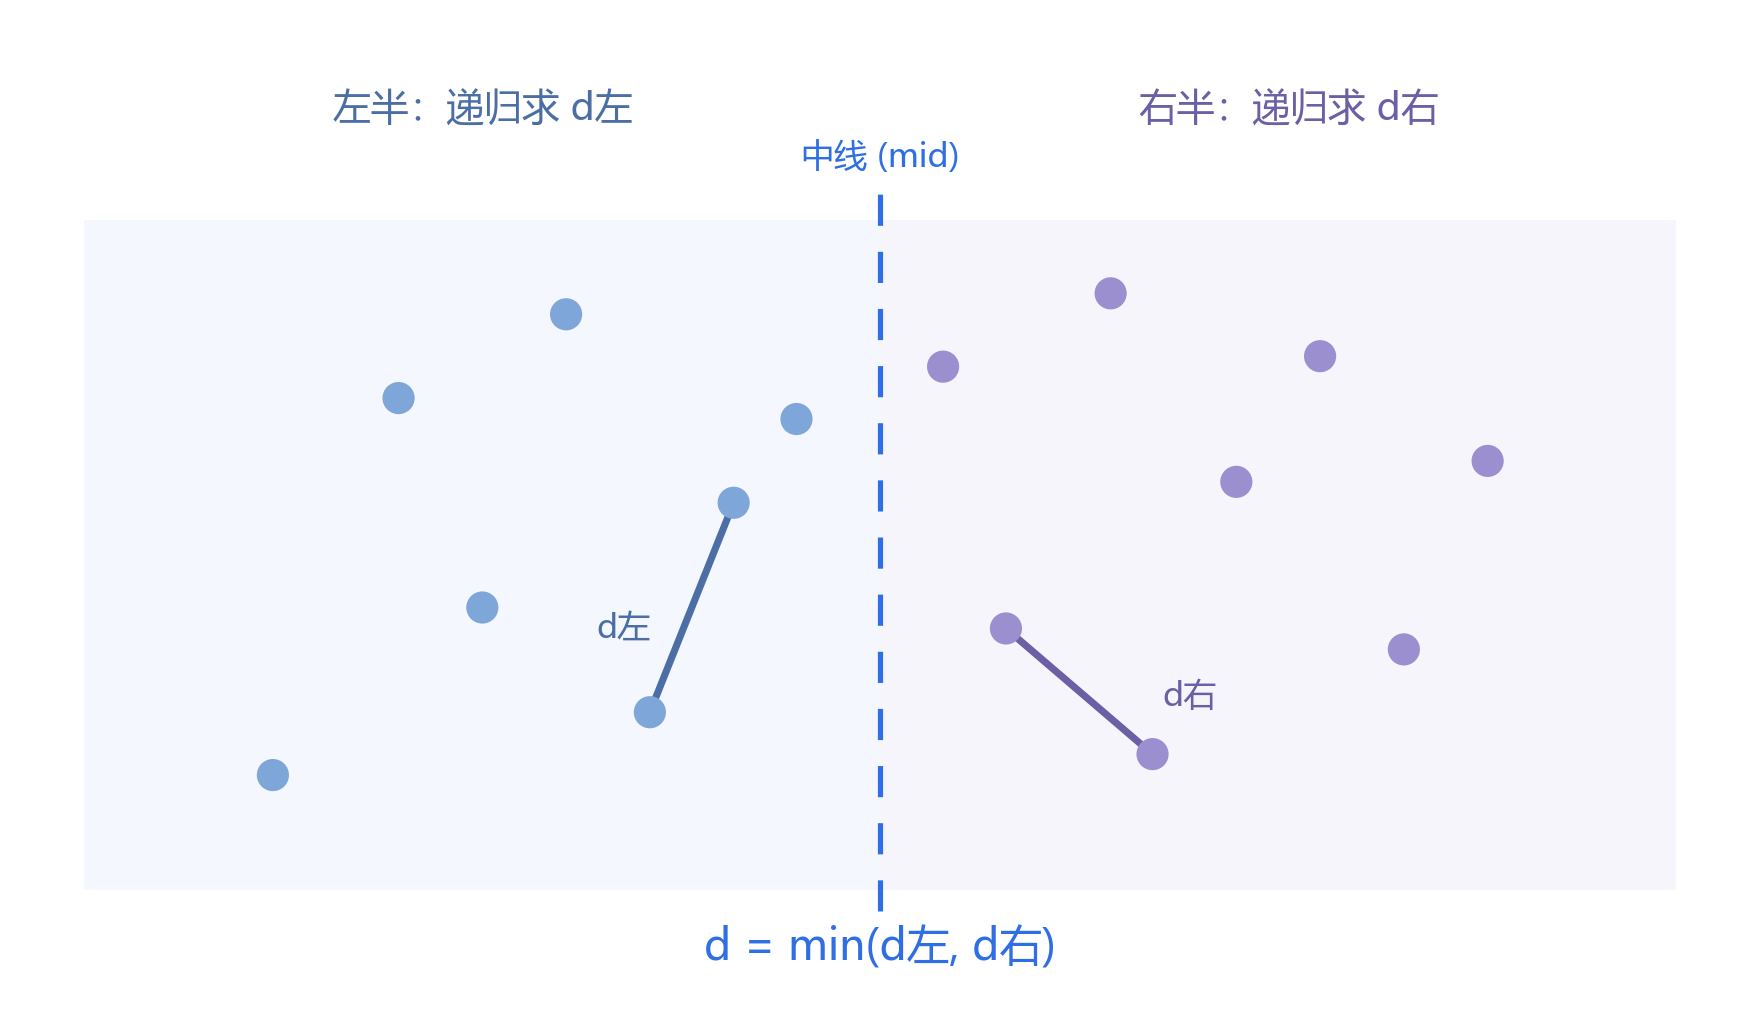
递归部分的复杂度是标准的 T(n) = 2·T(n/2) + 合并代价,只要合并代价能压到 O(n),整体就是 O(nlog n)。所以整道题真正的难点在于合并过程中怎么高效地找出跨过分界线、距离最小的那一对?
三、合并:跨中线的点对
我们手里已经有一个“当前最优值”d。那我们可以设想下,如果有一对跨线的点,距离比 d 还小,那它们必须长什么样?
若这对点的距离小于 d,那么它们到中线的水平距离必然小于 d,否则光是横向的距离就超过 d 了。换句话说,它们只能待在中线左右各宽 d 的那条竖直长条里。我们把它叫做带宽(strip;有些资料中会叫做“片隙”,但感觉还是带宽或者窄带听着生动点):
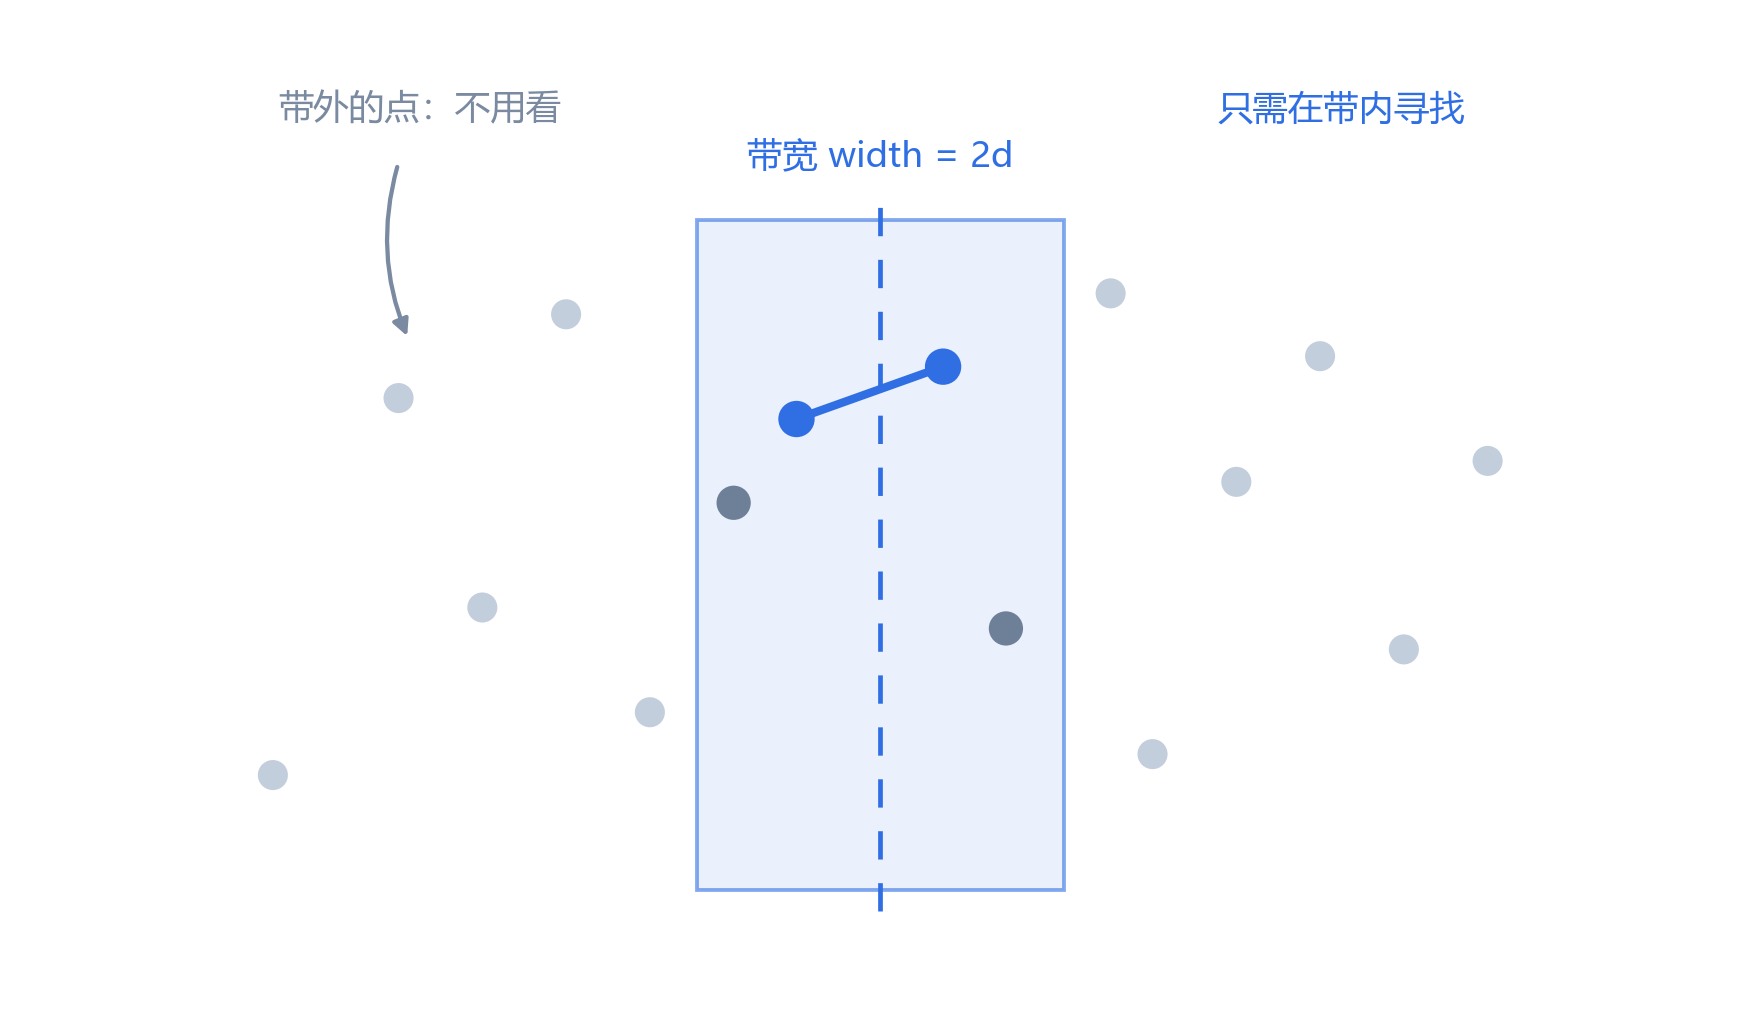
于是跨线最近点对的答案范围又被缩小成只需在带宽内部的点里找,带外的点(上图那些浅灰的点)可以完全无视。
但如果直接对带宽中的点进行暴力,最坏情况下所有的点都挤在带宽中,时间复杂度还是会到 O(n²)。这就要进行一步推导,我们最后能推得:带宽中的每一个点,都只需至多与其他 7 个点进行比较;这也是整个问题中几何推导最巧妙的一部分。
四、常数点引理:为什么带宽里最多比 7 个
先给出结论:把带宽内的点按纵坐标 y 排序后,每个点只需要和它后面“纵坐标差 < d”的点比较,这样的点最多 7 个。也就是说,这一步最多只需做 7n 次比较,时间复杂度是 O(n) 的。
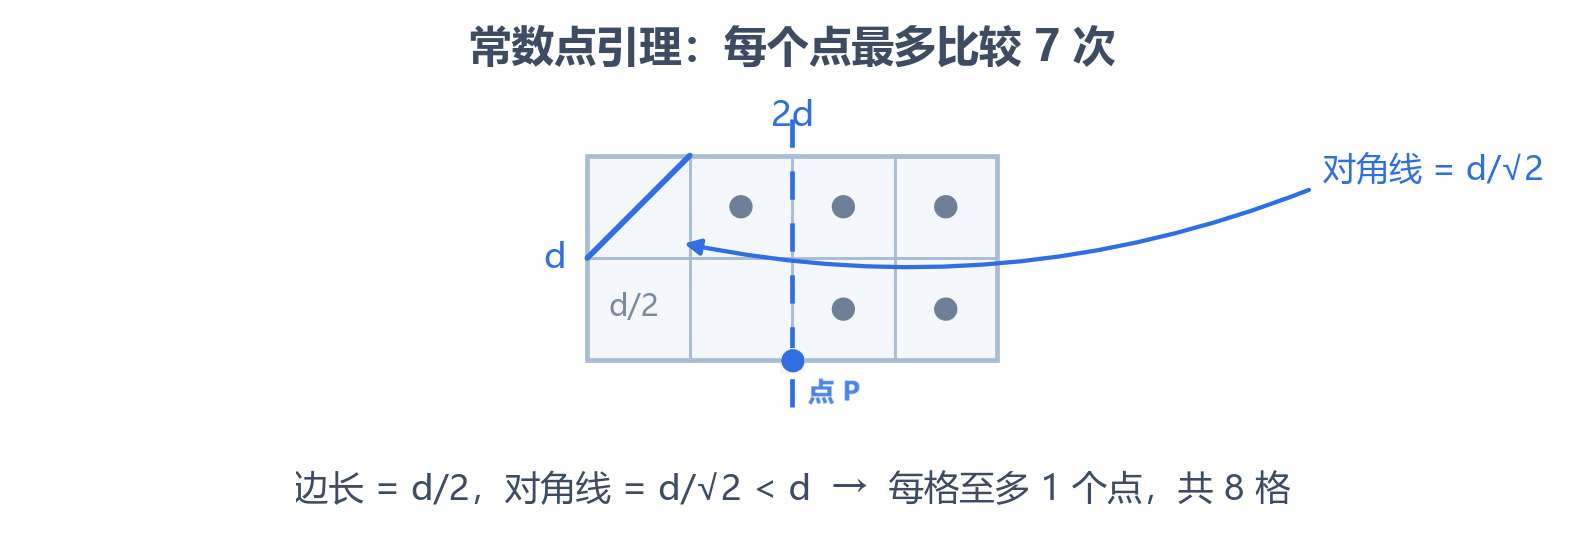
对带宽内的某个点 p,看它上方、纵坐标差 < d 的那些候选点:它们一定落在这样一个宽 2d、高 d的矩形里。沿着中线把这个矩形切成左右两个 d×d 的方格,每个方格再均分成 4 个小格,一共得到 8 个小格:
接着是最关键的一步:
- 每个小格的边长是 d/2,对角线是 (d/2)·√2 = d/√2,小于 d。而对角线是同一个 d/2 * d/2 小格中离得最远的两个点,也就是说同一个小格中,离得最远的点距离也小于 d;
- 而由 d = min(d左, d右) 可知,位于中线同一侧的任意两个点,距离都不小于 d;
- 小格完全落在某一侧内,若一个格子里塞进两个点,它们的距离就会小于 d,与上一条矛盾。
所以每个小格至多容纳 1 个点,8 个小格至多 8 个点;去掉 p 自己,一个点最多只需要和后面 7 个点比较。
五、详细流程
到这里三个部分齐全了。完整流程如下:
- 先把所有点按 x 排序;
- 递归求出左半、右半的最近距离,取较小值得到 d;
- 把与中线水平距离 < d 的点收集起来,按 y 排序,逐个向后扫描(每点最多比 7 个)更新 d。
代价的递推式是:
T(n) = 2·T(n/2) + O(n)
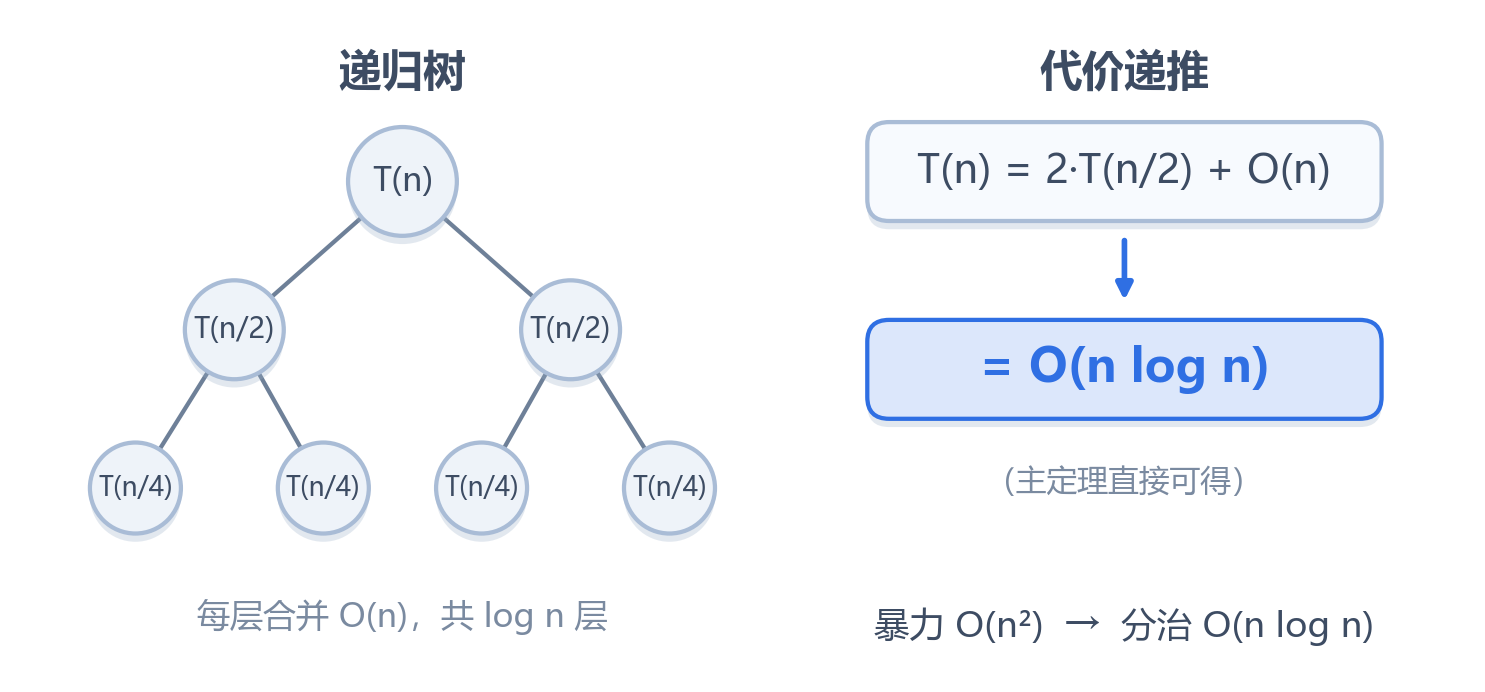
每一层的合并都是 O(n),一共 logn 层,时间复杂度优化到 O(nlog n)。
另外:上面第 3 步里如果每次都重新对带宽排序,合并本身是 O(nlog n),整体会退到 O(nlog²n)。标准做法是预先按 y 排好序,递归过程中顺带归并,把合并压回 O(n),才是真正紧凑的 O(nlog n)。但是log n的影响较小,多数场景下“每次重排”的版本也足够快,为了便于书写其实也可以接受。
六、代码实现
把上面的三块写成函数,结构非常干净。
首先给出每次都按 y 排序的版本:
// 递归出口:对小区间(这里设定的是3个点以下)暴力求解
double brute(Pt p[], int lo, int hi) {
    double best = 1e18;
    for (int i = lo; i <= hi; i++)
        for (int j = i + 1; j <= hi; j++)
            best = min(best, dist(p[i], p[j]));
    return best;
}

// 带宽扫描:s 已按 y 升序,d 为当前最优
double strip(Pt s[], int m, double d) {
    for (int i = 0; i < m; i++)
        for (int j = i + 1; j < m && s[j].y - s[i].y < d; j++)  // Δy ≥ d 直接停
            d = min(d, dist(s[i], s[j]));
    return d;
}

// 主递归:p 已按 x 升序
double solve(Pt p[], int lo, int hi) {
    if (hi - lo + 1 <= 3) return brute(p, lo, hi);
    int mid = (lo + hi) / 2;
    double d = min(solve(p, lo, mid), solve(p, mid + 1, hi));
    Pt s[N]; int m = 0;
    for (int i = lo; i <= hi; i++)
        if (fabs(p[i].x - p[mid].x) < d) s[m++] = p[i];   // 收集带宽内的点
    sort(s, s + m, byY);                                  // 此处为了书写方便,选择每次按 y 排序
    return min(d, strip(s, m, d));                        // 合并
}
然后是预先排序 + 边排边归并的版本。它和上一版的区别只有一处:递归返回时顺手把区间按 y 归并好(就像归并排序那样),于是带宽收集到的点天然就是 y 有序的,省掉了每层重新 sort 的 log n 因子,才是真正紧凑的 O(nlog n)(dist、brute、strip 与上一版相同,这里只改 solve 的组织方式):
Pt p[N];      // 全程按 x 升序;递归返回时,区间内已按 y 升序
Pt tmp[N];    // 归并用的缓冲区(归并结束后,顺带继续用作带宽缓冲)

bool byY(const Pt& a, const Pt& b) { return a.y < b.y; }

// 把两个已经是 y 升序的区间 [lo, mid]、[mid+1, hi] 归并成一个 y 序区间
void mergeByY(int lo, int mid, int hi) {
    int i = lo, j = mid + 1, k = lo;
    while (i <= mid && j <= hi) tmp[k++] = (p[i].y <= p[j].y) ? p[i++] : p[j++];
    while (i <= mid) tmp[k++] = p[i++];
    while (j <= hi)  tmp[k++] = p[j++];
    for (int t = lo; t <= hi; t++) p[t] = tmp[t];
}

// 返回 [lo, hi] 内的最近距离;返回时把 p[lo..hi] 归并成 y 升序
double solve(int lo, int hi) {
    if (hi - lo + 1 <= 3) {                 // 出口:暴力 + 排好 y,供上层归并
        double best = brute(p, lo, hi);
        sort(p + lo, p + hi + 1, byY);
        return best;
    }
    int mid = (lo + hi) / 2;
    double midx = p[mid].x;                 // ★ 必须在递归打乱顺序前存下中线
    double d = min(solve(lo, mid), solve(mid + 1, hi));  // 左右返回时都已是 y 序

    mergeByY(lo, mid, hi);                  // 边排边归并:O(n) 拿到区间 y 序
    int m = 0;                              // 此时 p[lo..hi] 已按 y 有序
    for (int i = lo; i <= hi; i++)
        if (fabs(p[i].x - midx) < d) tmp[m++] = p[i];   // 带宽天然有序
    return min(d, strip(tmp, m, d));        // 直接扫,无需再排序
}
这里的核心不变式是:进入 solve(lo,hi) 时 p[lo..hi] 是 x 序,离开时是 y 序。左半递归结束后 p[lo..mid] 变成 y 序,但右半 p[mid+1..hi] 还没被动过、仍是 x 序——所以右半递归内部仍能正确定位自己的中线;等左右都返回(各自 y 序),一次归并即可得到整个区间的 y 序。也正因为递归会打乱区间内顺序,中线横坐标 midx 才必须在递归之前就存下来。
方便对照,把几个关键变量列出来:
| 变量 | 含义 |
|---|---|
lo / hi | 当前递归区间的左右下标 |
mid | 区间中点 (lo+hi)/2,也是中线横坐标的来源 |
d | 当前已知的最近距离,min(d左, d右) |
s[] / m(归并版写作 tmp[]) | 带宽内收集到的点,及其个数 |
best | 暴力出口里维护的最小距离 |
看一道例题。
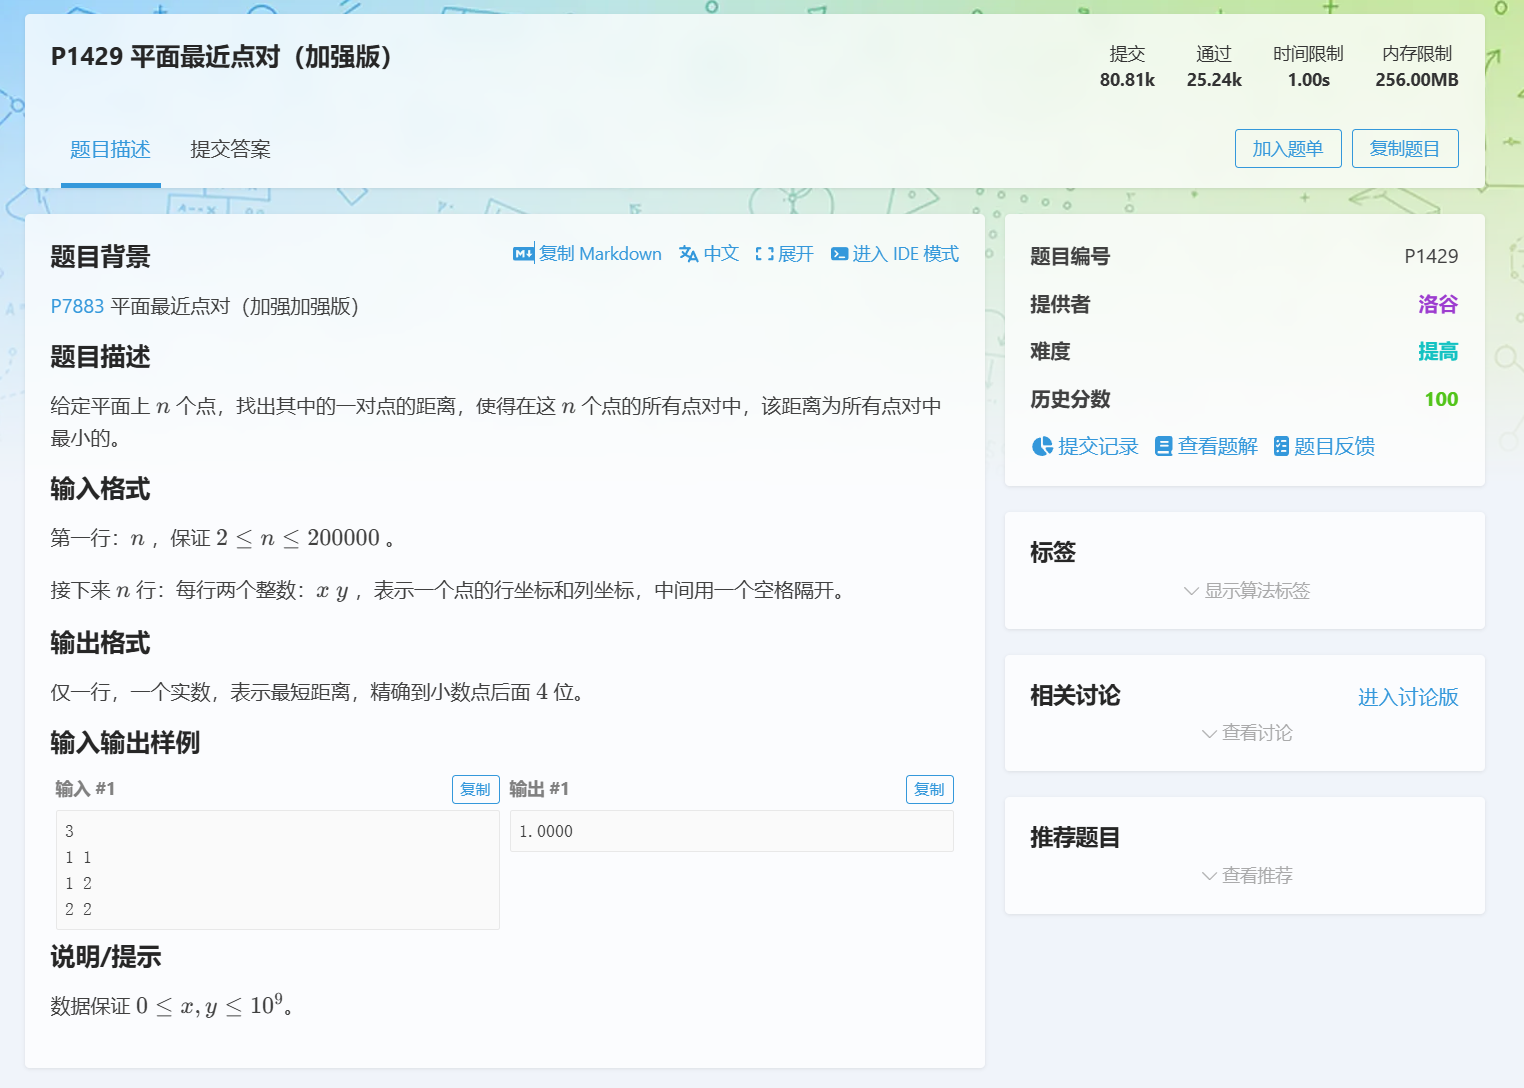
对于洛谷 P1429 平面最近点对(加强版),数据规模为 2×10⁵,暴力 O(n²) 必 TLE;这是一道标准的板子题。完整代码如下:
#include
using namespace std;

const int N = 200005;
struct Pt { double x, y; } p[N];

bool cmpx(const Pt& a, const Pt& b) { return a.x < b.x; }
bool cmpy(const Pt& a, const Pt& b) { return a.y < b.y; }

double dist(const Pt& a, const Pt& b) {
    double dx = a.x - b.x, dy = a.y - b.y;
    return sqrt(dx * dx + dy * dy);
}

double brute(int l, int r) {
    double b = 1e18;
    for (int i = l; i <= r; i++)
        for (int j = i + 1; j <= r; j++)
            b = min(b, dist(p[i], p[j]));
    return b;
}

double strip(vector& s, double d) {
    sort(s.begin(), s.end(), cmpy);                 // 带宽内按 y 排序
    for (size_t i = 0; i < s.size(); i++)
        for (size_t j = i + 1; j < s.size() && s[j].y - s[i].y < d; j++)
            d = min(d, dist(s[i], s[j]));
    return d;
}

double solve(int l, int r) {
    if (r - l + 1 <= 3) return brute(l, r);         // 出口
    int mid = (l + r) >> 1;
    double midx = p[mid].x;
    double d = min(solve(l, mid), solve(mid + 1, r));
    vector s;
    for (int i = l; i <= r; i++)
        if (fabs(p[i].x - midx) < d) s.push_back(p[i]);
    return min(d, strip(s, d));
}

int main() {
    int n; scanf("%d", &n);
    for (int i = 1; i <= n; i++) scanf("%lf %lf", &p[i].x, &p[i].y);
    sort(p + 1, p + n + 1, cmpx);                   // 全局按 x 排序
    printf("%.4f\n", solve(1, n));
    return 0;
}
有一个容易踩的坑:midx 必须在递归前就用当前区间的中点算好,不要在收集带宽时再去取 p[(l+r)/2].x,否则进入递归后再求中间的划分线容易出错。
另一处分治法:关于去取中间划分线的补充
在取一个点集中 x 第size/2大的中间划分线时,最简单的实现就是在进入递归前进行一次全局排序,时间复杂度为 O(nlogn)。但是在《算法设计与分析》中,最近点对的前一小节讲到了一种 O(n) 时间复杂度内就可以找到中位数的算法:线性时间复杂度选择(BFPRT算法;由 Blum–Floyd–Pratt–Rivest–Tarjan 这五个算法领域的大佬于1973年提出,其中Tarjan我们在前些时候的博客里已经专门提到过他求最大连通分量的算法)。这个算法也是分治法的经典题目,但是考试未作要求,这里并不展开。而且由于我们要将整个问题分为 log n 层,所以最后在取中位数的操作上,整体的时间成本还是 nlog n,语法上更复杂的同时并没有获得更优秀的时间成本,故此处没有必要使用(但是 BFPRT 的算法设计也是非常优美的,有很多巧妙的处理,之后若有机会或许会讲解)。
二维最近点对是分治思想里非常经典的问题:拆分把问题变成规模更小的相同问题;带宽把候选从全体点缩到中线附近的一小片;常数点引理再把带宽扫描压成线性——三块缺一不可。它体现的正是分治最迷人的地方:真正难的不是“分”,而是考虑“合”的时候到底还剩下多少工作量,如果子问题不独立,则需要考虑使用动态规划等方法解决。

 点赞
 收藏
 点踩
 分享