这里的多模态模型特指multimodal llm(多模态输入,文本输出的模型)后续讨论以qwen3.8-omni为例。
这里的多模态模型特指multimodal llm(多模态输入,文本输出的模型)后续讨论以qwen3.8-omni为例。
传统的文本大模型预训练就是把各种文本按照特定recipe,把文字放进llm(transformer backbone),然后输出next token,然后loss就是cross entropy。
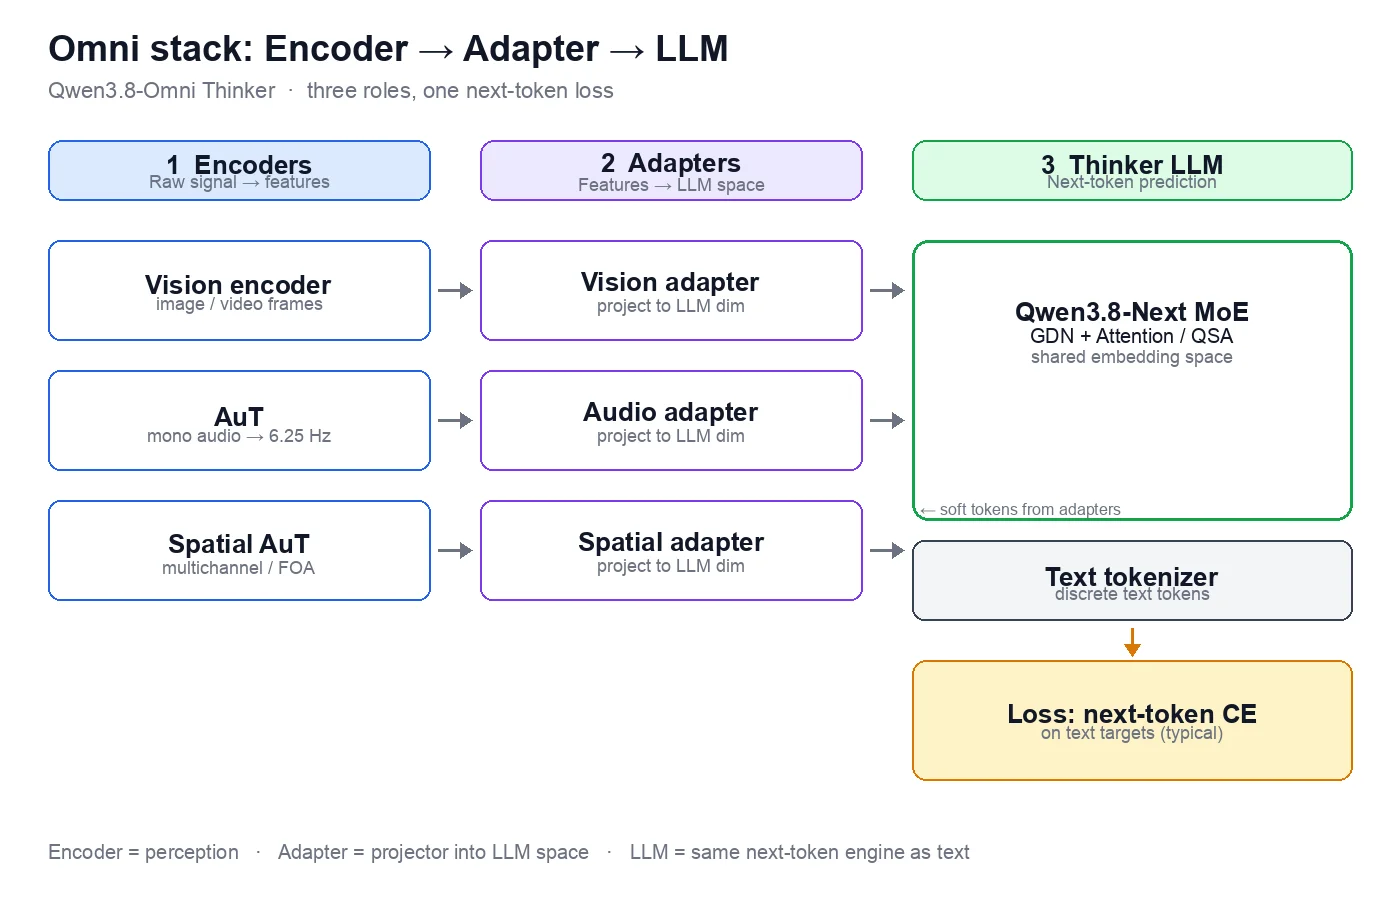
mllm比llm多了encoder和adapter。
encoder把多模态原始文件变忙成向量表征(在pretrained encoders自己的embedding space)
adapter把encoder输出的embedding传唤到文本llm backbone的embedding space(只做转换,相对小)
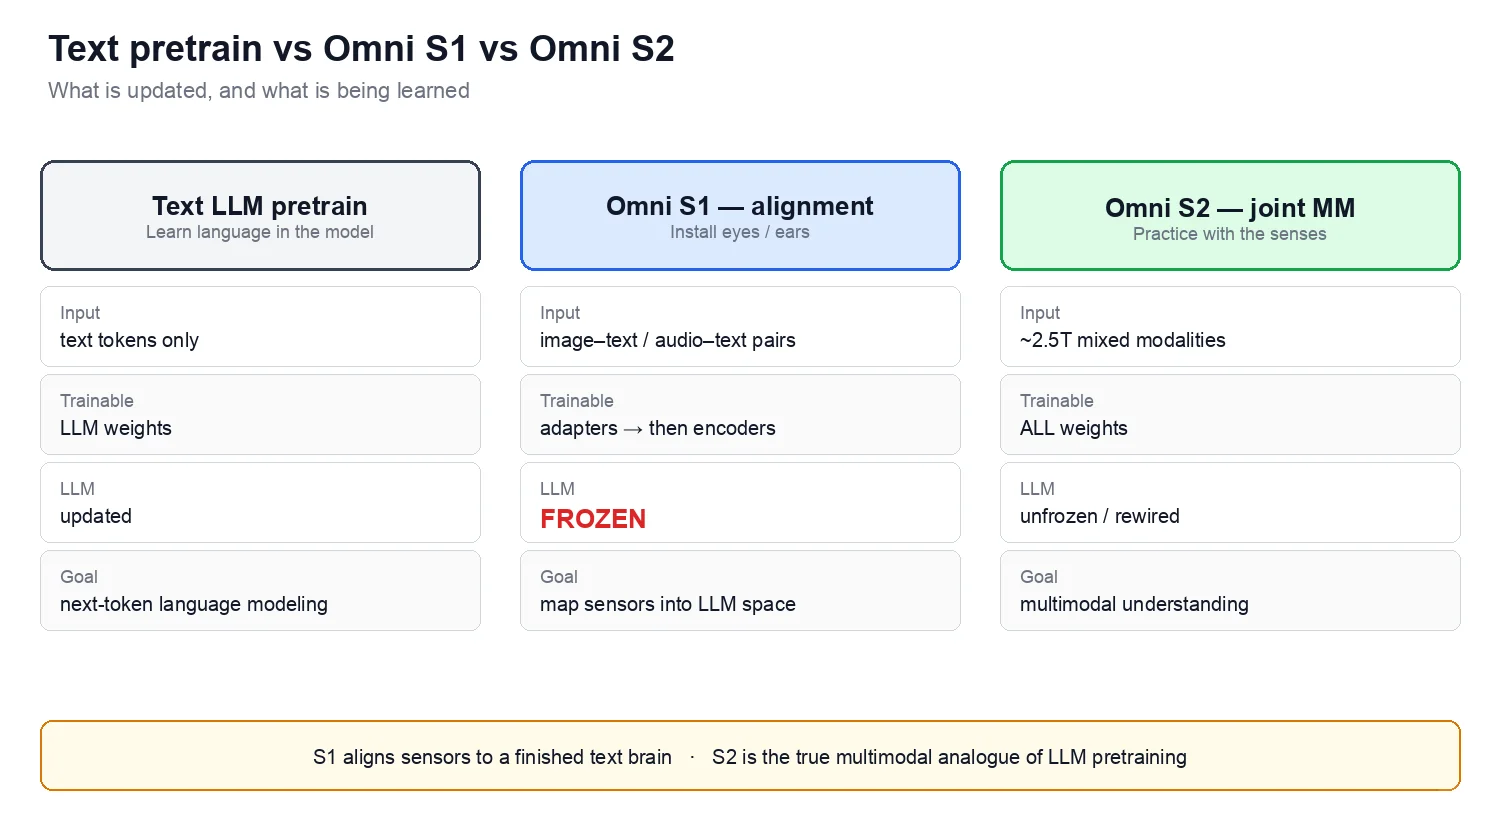
以qwen3.8-omni的预训练流程为例:1. 把训练好的qwen3.8-next作为llm backbone。2. 添加vision,audio,和spatial模态的encoders和adapter。3. 先多模态pairs(文本-图片对,文本-音频对等)把adapter训练好(encoders和llm backbone冻住)。adapter小,先把几个模态的embedding space对齐。如果先动encoder的话embedding space影响太大。4. 再微调预训练好的encoders(llm backbone冻住)。5. 正常文本预训练的模式训,但是多了多模态的输入。
3-5都是通过next token prediction cross entropy的方式优化。
 添加评论
 点赞
 收藏
 点踩
 分享
评论1
?
参与讨论

第4点不一定要吧
13小时前回复
回复