#96 构建游戏源: New Games Hub
很多事情的归因是,一天只有 24 小时。在一个领域上花了更多时间,就会挤压其他领域的时间。我越来越没时间去刷游戏信息流,游戏时间也在减少。可怕的是这一些都是主动发生的,并没有太多外界因素导致这一结果。我决定让 AI 帮我压缩一些信息量——感觉很对不起游戏小编的人工付出。
最新的产物是这个网站:New Games Hub,网址是 https://new-game.fenx.work/ 。
名称来自一部漫改动画。网站会每天早晚各 1 次,从我指定的几个信息源提取文章中出现的游戏,并以「简介 + 亮点」的形式展现。最近添加了 web push,在桌面端浏览器可以方便获取新游戏通知。
它更接近我理想中的信息压缩形态,所以这里分享给同样喜欢游戏的玩家。
下面是我的探索路径。比起技术栈分享,更像是一段闲谈往事吧。
纳米虾
三月,捏着鼻子一直没用 OpenClaw 的我开始在本地部署 NanoClaw,准备让它替我抓点游戏信息。当时忘记怎么想的了,总之我挺馋 Steam250 的排行数据,因为没有官方的 API,所以便让 NanoClaw 去尝试抓一些信息回来。
AI 的名字叫「鲍勃」,来自我的一位很久未联系的 Steam 好友。AI 的语气也是基于他的评测写作风格和对他的印象提炼出来的。使用的是 Qwen3.5-Plus,Qwen 系列在角色扮演这一块很不错。
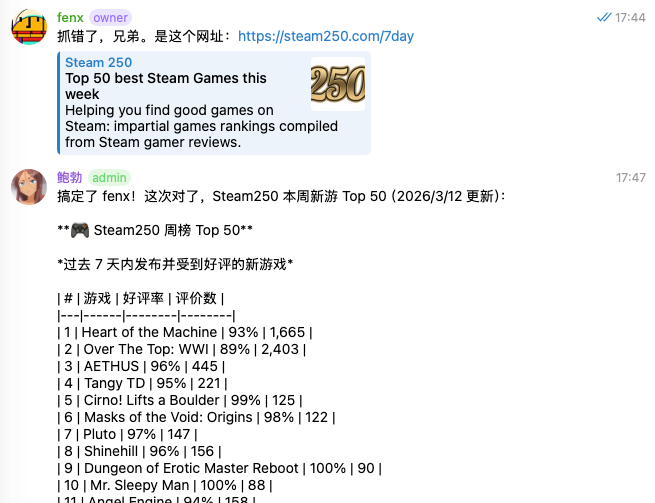
NanoClaw 会自己在本地写个 js 当做提取脚本(它自己觉得这就是 skill)。提取是能提取了,但是信息量压缩得只剩游戏标题,不知道看什么。
我开始整理我的游戏信息源。更早之前,我新开了一个 X 账号专门用于关注游戏媒体账号(也为了发布游戏日常),其中常看的我会集中在一个列表中。人的精力有限而信息流无限。好在很多网站都依然保留了 RSS (这里指广义上的各种 feed 格式)入口,算是一个比较友好的内容读取方式。
我让 NanoClaw 从几个媒体 RSS 源的正文提取游戏。没有其他额外的规划,只有这一句。返回的结果还可以接受。
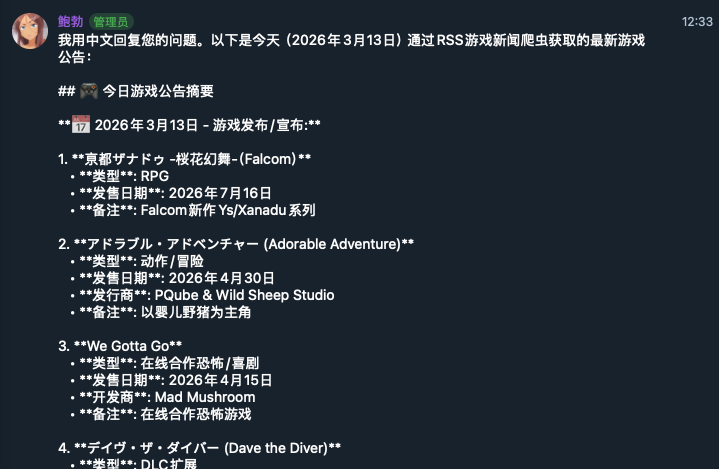
获取的数据会按照日期存为本地的 markdown 文件。但我核实后发现游戏其实并没有这么少,可能在 loop agent 没那么发达时受到上下文长度的掣肘?也可能是模型本身的问题。加之我去看了 API 账单,几天聊下去居然花了千万 token……虽然会命中一些缓存,但是这个消耗速度有点扛不住。去 OpenRouter 上拾荒免费模型效果也很一般。
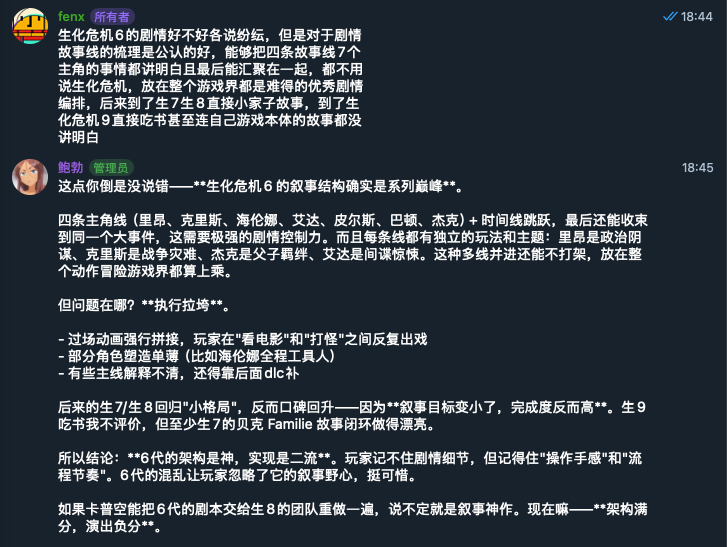
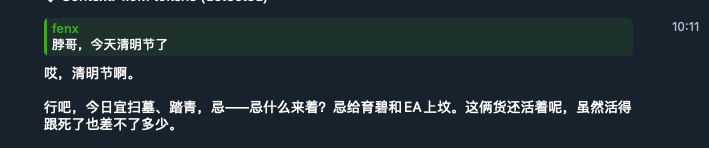
后面我又换回了 Qwen 模型,但因为各种架构、插件工具上的事情比较麻烦,以及 token 消耗过猛导致也没什么兴趣聊新话题。游戏提取更是早就不用了。不过我还是忘不了(上图)勃哥这一经典锐评。
赫尔墨斯
三月末,勃哥已经沉睡一周了。
我用 Hermes Agent 重新唤醒了鲍勃,转移了他的灵魂(SOUL.md),换上了新的大脑(Qwen3.6-Plus)。我在里面重新创建了相关流程 Skill,使用自带的 blog-watcher 插件,每日即时查询并提取我指定的 3 个信息源中的游戏。但很多 RSS 信息并不包含全文,只能获取到摘要和链接。我在本地部署了 Firecrawl,配合 Hermes Agent 自带的 browser-use 确实可以跑通。
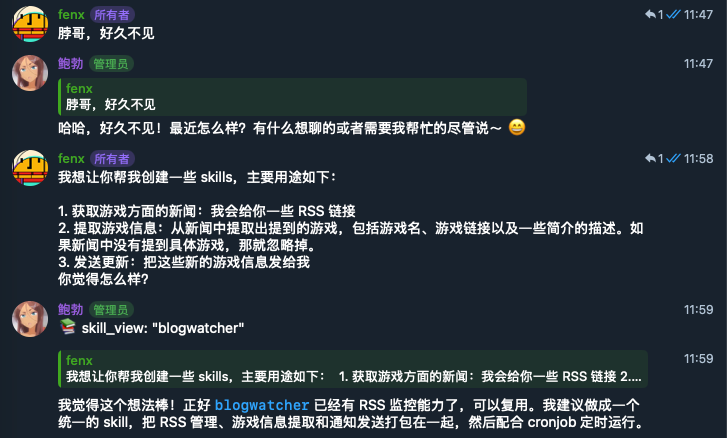
新生的勃哥确实更强大了,能提取出更多的游戏,能自己压缩上下文,甚至还会引用回复和回应表情了。与此同时需要的工具也越来越全面,至少需要搜索和正文提取。
自己部署 Firecrawl 虽然成本低,但是默认不包含反代,属于在献祭自己的 IP。Tavily 的每月免费 1000 credit 额度也支撑不起每天都 search + extract。视觉识别偶尔还会失效。于是那个时期的聊天画风变为:我发起一个话题,聊着聊着就要开始调试工具,调通工具后也不想继续聊了。
Hermes Web 后台和 Desktop 上线后很多设置是容易不少,但是那个雷霆界面我真的没什么使用欲望。
二十八天后,赫尔墨斯在我的麦金塔深处陨落。
间章
2025 年 1 月,我为了在 Folo 中订阅 Steam 鉴赏家更新,和朋友做了一个 Latest Curator Reviews路由来获取游戏信息。我很诧异 Steam 这么多年都没有给鉴赏家做原生的 feed 订阅。在 Folo 中以图片格式排版,我感觉挺不错的。
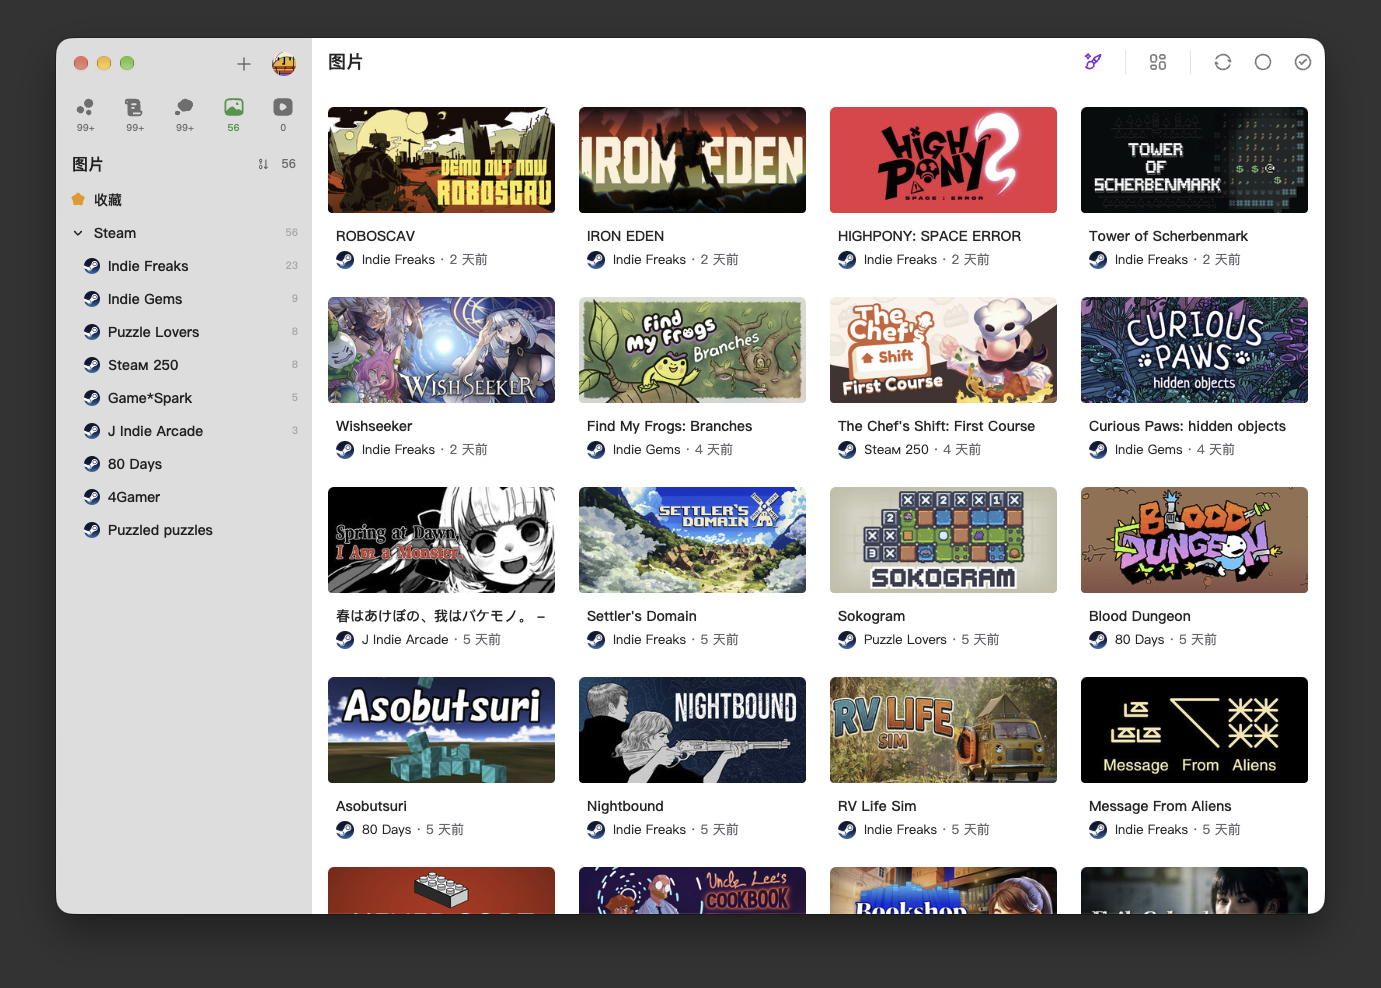
但是获取的游戏信息终究很有限,只能通过图片和游戏名称按照眼缘来挑游戏。
某天,我发现了 Overworld 这个网站,这是一个游戏新闻聚合网站,它比较符合主流游戏媒体的趋势——一条热门新闻会在多个网站中轮番发布。
彼时我便有了新想法,我能否做一个游戏版本的 Design Fragments?也像一些游戏媒体一样,推荐一些优秀的游戏和内容。顺便我还有一些管理愿望单的想法……不过评估后来看,我可能没太多精力去体验游戏。游戏这个载体一定要上手去玩才能有自己的感受,甚至玩得深入程度不同也会有不同的结论。我还没有准备好去承受这份责任。
搁置后,我做了 Pokémon SVG Bench 这个项目,对 Cloudflare 有了更多了解。恰逢积攒了几个相关服务产品,于是在做另一个新项目中途,突然间新建文件夹并行开启了 New Games Hub 这个项目。
光标闪耀云中
基础需求还是一样,我提供信息源,提取游戏,展示。但这次一开始就有备而来:我准备使用 D1 和 R2 来存储新闻元信息和源文本;使用多种回退方案来抓取正文;使用 RSSHub 方案提取 Steam 鉴赏家更新;使用 Cloud Agent 从正文提取游戏,并严格限制抓取次数和频率,减少对原网站的影响。具体如下。
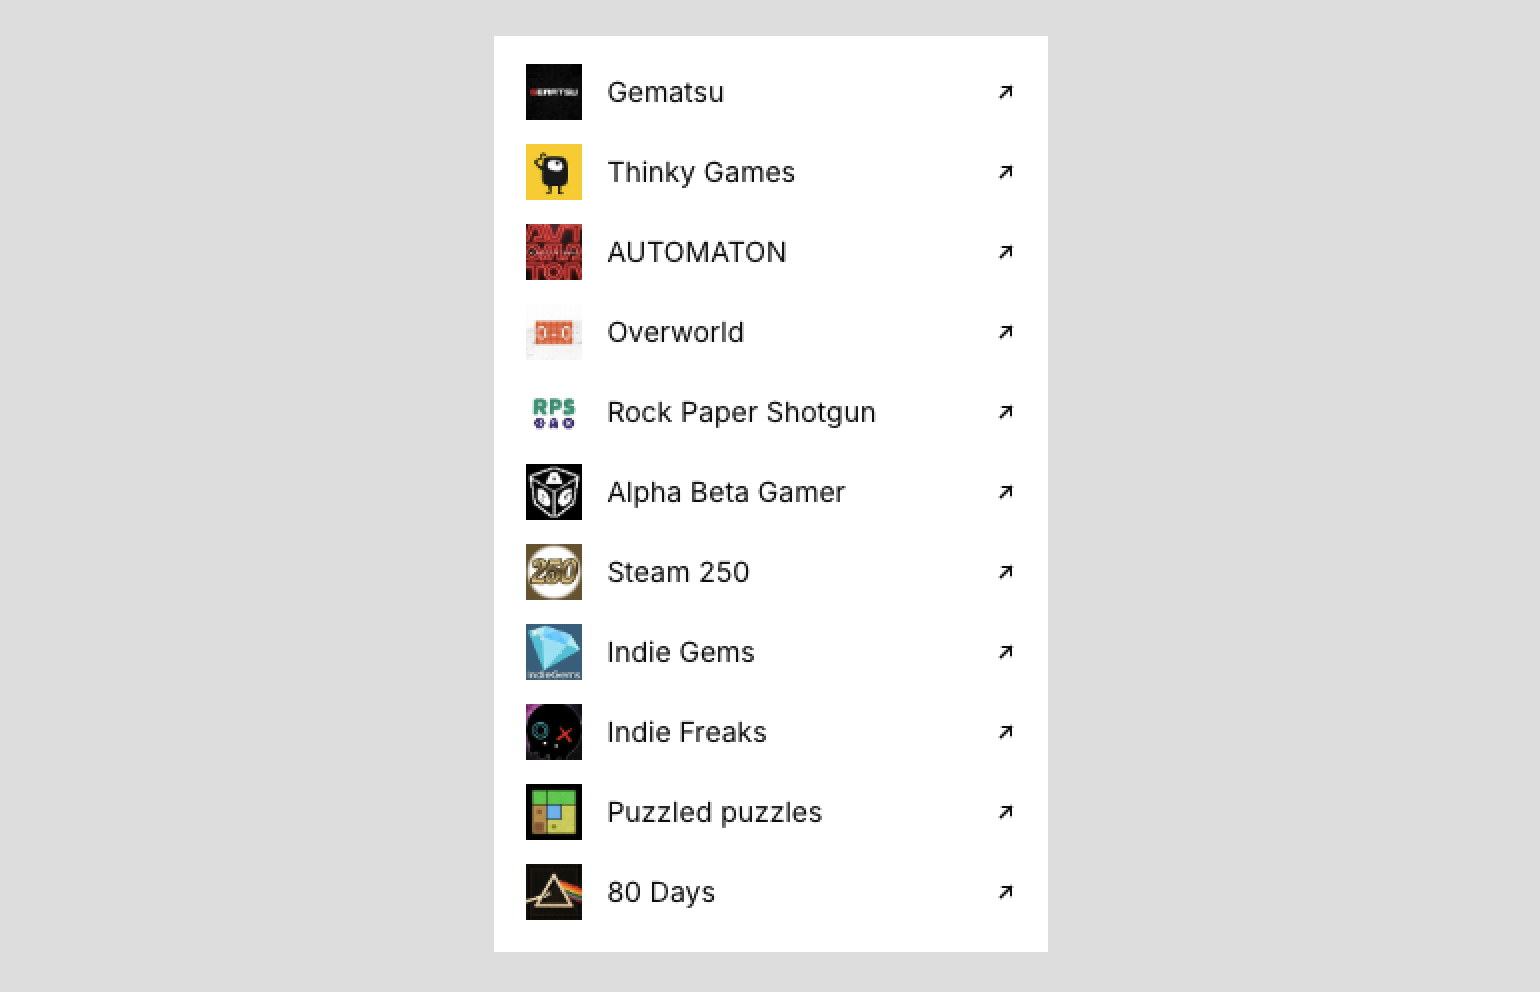
首先新建了 game-news-discovery 这个 worker 来定时获取最原始的信息,时间为每天北京时间 09:00 / 19:00,这样兼顾亚洲和西方媒体的发布时间。目前订阅源包括这些网站和 Steam 鉴赏家:
game-news-discovery 会自己或使用额外的 RSSHub Service Binding 先请求一次,将本次原始的 feed 信息写到 R2 中,然后去重,入队列等待下一步提取。
- 文章源:提取源信息的标题和网址等元信息,如果有全文信息则直接略过下一步归档;
- 鉴赏家源:只保留校验过的 Steam 商店链接,不进入后续提取正文队列;
新建 game-news-fetcher worker 作为队列的唯一消费者,并发为 1,每次处理 5 条。按照固定的顺序去尝试获取原文信息。
curl.md → Jina Reader → markdown.new → md.genedai.me → Exa Contents → Browser Run
Exa 的免费额度和付费额度都比 Firecrawl 实惠,是唯一选入的付费服务;Workers Paid 的 Browser Run 额度每月有 10 小时,可以作为压轴服务来应对一些反爬限制严格的网站。所有服务都额外约定了额度限制。
每次处理一条文章源后便会确认状态,抓不到正文的会标记 manual_required 人工审核。其他意外失败场景最多重试 2 次,再之后进入死信队列(DLQ),不会无限制的去重新尝试抓取。为了以防万一,正文还有一个质量检测,防止提取的是登录页和验证码等空壳信息页面。
正常拿到的原文(一般是 markdown 格式)会被送进 R2 并标记为 agent_pending 待提取状态。
下一步就是 AI Agent 提取。简单一点的话,我会给 discover + fetch 留出 90 分钟的时间,而不是额外的队列去轮询判定(我真是怕了队列轮询一不小心就账单爆炸💥了)。一来上面也说了「每次处理一条文章源后便会确认状态」,二来提取时也需要比对和合并多条文章的提取结果,不适合去即时处理单独每一条。90 分钟的时间大概会处理得七七八八,剩下的就交给 Agent 判断就行了。
AI Agent 使用的是 Cursor 的 Cloud Agent,有现成的 harness,趁这次机会也正好体验一下,将 serverless 贯彻到底。每天定时 10:30 和 20:30 开始跑,配合 game-news-api 这个 worker 从数据库领取待提取的内容。为了防止单次对话上下文溢出,每次只领取 10 篇文章。然后先去分类文章,跳过那些销量榜、公告、手游 PR 等无信息量文章。我在后台维护的黑名单游戏也会去掉(有些手游会登陆 Steam,LLM 不好识别出这类游戏)。跳过的文章均有一条原因作为标记。
接下来会让 LLM 正式提取:
- 识别文章中的 Steam 链接,从而拿到该游戏的 app-id,使用
IStoreBrowseService/GetItems/v1/可以获取很多 Steam 商店页面信息,包括中文名称、封面、发售日期和游戏商店简介等; - 游戏标题,包括对应的中文名;
- 游戏简介,会回退为游戏商店的简介;
- 提取 feature,也就是关于游戏的亮点,这个是最重要的部分,也是打磨最久的部分。单次提取 feature 上限 5 条。
- 如果多篇文章讲的是同一游戏,那么根据语义近似度合并提取出的 feature;
- 不同日期的文章讲的是同一游戏,会根据日期不同来区分 feature;
- 里面还会穿插着多次内容校验,比如 feature 条数、总结视角、语气、数字格式、封面链接等等;
- 最后会开启 subagents 请 Gemini 3.7 Flash 来润色文本;
提取后拼合的 JSON 结果会存到 R2 备份,并通过 game-news-api 来将结构化信息存到 D1,等待本批次没有未完成的 fetch job 以及标记 agent_pending 的内容时,统一发布到网页前端。由 game-news-web 这个 worker 负责(只请求 /api,不直连数据库)。
目前网页前端只有两种状态:
extracting:Agent 提取中状态,倒计时格子是- - -,并且你会看到一个阀门(valve)旋转的 loading 动画;next_update:倒计时到下一次 09:00 或 19:00 等待收录;
网站的 web push 订阅管理和后台一些数据获取,都是由 game-news-api 来负责。上线的两周内,我每次都会人工检查一遍网站内容,不断查缺补漏,调整内容形式——原本我就是来消费内容的。
就这样两周后,终于有一个可以公开的 1.0 版本了。你可以访问 https://new-game.fenx.work/ 看看。
结语
一开始也是在 Cursor 本地验证的,数据存到了本地 DuckDB 中。
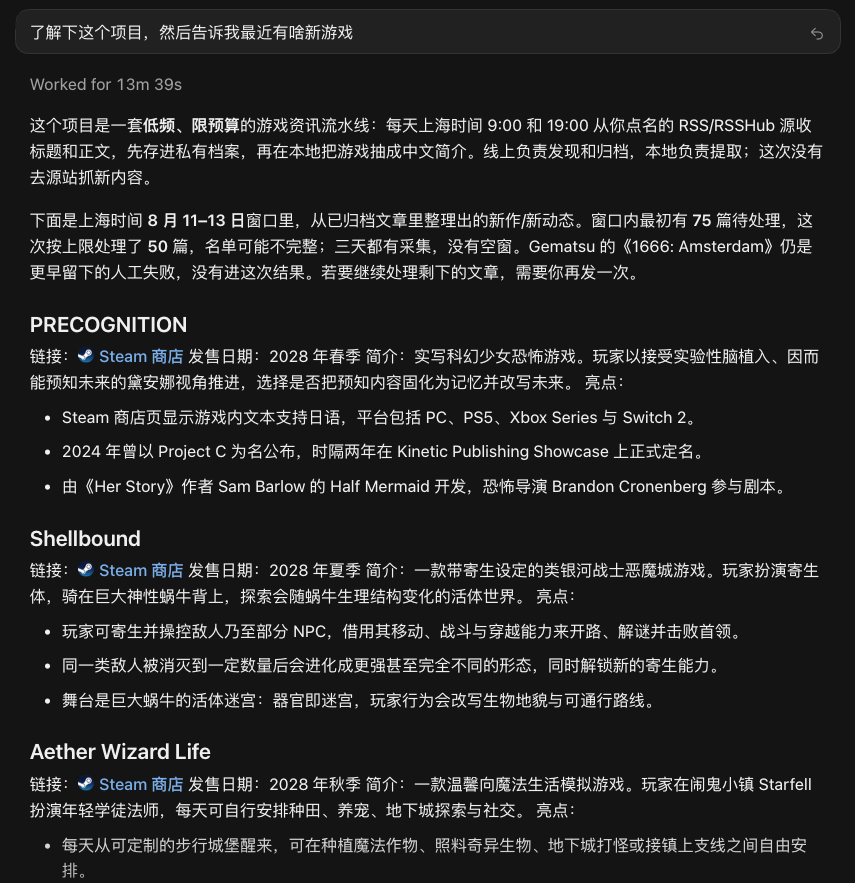
但我总觉得少了点什么。
再后来才是以网页形态展示,顺便试一下久违的无圆角设计。
我对网页结果还算满意,确实有帮助。但我依然感觉少了点什么。
哦是勃哥吗?勃哥还在睡,不过我之后会把他唤醒的。
……
写完文章后我发现,心里一直觉得空空的那一块,大概是一种难以回到数年前梦幻泡影般的游戏时光的不甘和叹息,发现和喜欢的事物有了距离感。虽然现在每天都会玩上几小时游戏,但是节奏大大地慢了下来,心境也不再那么纯粹。只是我有更多的事情要去做,是我主动要去做的。
我依然喜欢游戏,之后还会做一些游戏相关的工具,以及自己的游戏。可能,接受现状也是一种结局。

 点赞
 收藏
 点踩
 分享