LangGraph 机制与 Agent 设计模式深度剖析
简介
在构建CVE评估代理时,我遇到了一个起初看似微不足道的编排问题,但后来证明很有启发性。
该代理采用LangGraph实现,(概念上)结构如下:
--- 配置: 主题:“基础” themeVariables: 原色:“#BB2528” primaryTextColor:“#fff” primaryBorderColor: '#7C0000' 线色:“#F8B229” 次要颜色:“#006100” TertiaryColor:“#fff” --- 图TD Start(((__start__)) --> GetCVE[get_cve_data] 开始——>获取CVSS[get_cvss_data] GetCVE --> GenASD[generate_asd_data] GetCVSS --> GetStmt[get_cvss_statement_data]
GenASD——> 正常化[normalize_cvss_data] GetStmt ——> 规范化
归一化——>GenVector[generate_cvss_vector] GenVector --> End((__end__))
然后木头开始感觉......怪怪的:
2025-12-24 12:07:16|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:504|_generate_cvss_vector|开始完成CVE风险评估并生成CVSS向量
2025-12-24 12:07:16|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:401|_normalize_cvss_data|开始归一化CVSS向量数据
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:527|_generate_cvss_vector|Generated CVSS Vector Response
2025-12-24 12:07:26|x-sec|DEBUG|./core/agents/mimora/cvss_vector_agent.py:528|_generate_cvss_vector|Response content: {
    "cvss_vector": "CVSS:3.1/AV:L/AC:L
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/tools/tool_utils.py:19|wrapper|开始执行工具: _calculate_cvss_score, 参数: ('CVSS:3.1/AV:L/AC:L/PR:N/UI:R/S:U/C:H/I:H/A:H',), {}
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/tools/cvss_tool.py:107|_calculate_cvss_score|开始计算CVSS评分: version=3.0, vector=CVSS:3.1/AV:L/AC:L/PR:N/UI:R/S:U/C:H/I:H/A:H...
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/tools/cvss_tool.py:170|_calculate_cvss_score|成功计算CVSS评分: version=3.1, base_score=7.8, base_severity=High
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/tools/tool_utils.py:22|wrapper|工具 _calculate_cvss_score 执行成功,耗时: 0.00s
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:504|_generate_cvss_vector|开始完成CVE风险评估并生成CVSS向量
2025-12-24 12:07:26|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:568|_generate_cvss_severity|开始生成CVSS严重性等级
2025-12-24 12:07:35|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:527|_generate_cvss_vector|Generated CVSS Vector Response
2025-12-24 12:07:35|x-sec|DEBUG|./core/agents/mimora/cvss_vector_agent.py:528|_generate_cvss_vector|Response content: {
    "cvss_vector": "CVSS:3.1/AV:L/AC:L
2025-12-24 12:07:35|x-sec|INFO|./core/agents/mimora/tools/tool_utils.py:19|wrapper|开始执行工具: _calculate_cvss_score, 参数: ('CVSS:3.1/AV:L/AC:L/PR:N/UI:R/S:U/C:H/I:H/A:H',), {}
2025-12-24 12:07:35|x-sec|INFO|./core/agents/mimora/tools/cvss_tool.py:107|_calculate_cvss_score|开始计算CVSS评分: version=3.0, vector=CVSS:3.1/AV:L/AC:L/PR:N/UI:R/S:U/C:H/I:H/A:H...
2025-12-24 12:07:35|x-sec|INFO|./core/agents/mimora/tools/cvss_tool.py:170|_calculate_cvss_score|成功计算CVSS评分: version=3.1, base_score=7.8, base_severity=High
2025-12-24 12:07:35|x-sec|INFO|./core/agents/mimora/tools/tool_utils.py:22|wrapper|工具 _calculate_cvss_score 执行成功,耗时: 0.00s
2025-12-24 12:07:42|x-sec|INFO|./core/agents/mimora/cvss_vector_agent.py:596|_generate_cvss_severity|Generated CVSS Severity Response
输出不稳定。我的第一反应是常见的替罪羊——大型语言模型(LLM)幻觉。
但图运行时间本应是减少这种不可预测性,而不是放大它。
追踪执行路径后,我找到了罪魁祸首:_generate_cvss_vector被安排了两次。这直接违背了我原本的拓扑结构。
这里我就跳过逐个调试了。重要的是这个异常引发了什么:对代理编排的更深入探讨——以及由此产生的设计模式。
重新思考特工编排
如今的配器开始出现裂痕的地方
随着系统从“生成式人工智能”(单次文本)演变为自主智能体,架构成为真正的稳定性杠杆——不仅仅是提示,也不仅仅是模型选择。
早期流行的范式链条:线性提示序列,适合小型、有界任务。
但一旦智能体需要规划、调用工具、反思和迭代,线性DAG(有向无环图)就变得不合适。
代理不是干净的输入输出管道。它是一个循环感知→推理→行动→观察,重复直到终止——如果终止存在的话。这种循环性质违反了“无环”假设。
与此同时,许多系统正向多智能体构建方向漂移:规划者、执行者、批评者和检索者并行协作,共享并变异上下文。
到那时,你就会继承分布式系统的问题:竞态条件、状态一致性、循环依赖和容错性。
所以问题变成了:什么编排模型能表示周期并行协作,而不把运行时变成猜测游戏?
LangGraph的赌注是BSP(批量同步并行)模型——在高性能计算(HPC)和大数据图计算中经过实战考验——转化为代理编排。
为什么要用图计算模型?
传统软件将系统建模为服务或对象。代理系统的行为更接近状态机遍历图, 其中州是资产,且转换是工作。
- 周期是默认的,不是例外
反应(ReAct)基本上是Think → Act → Observe → Think.DAG只能间接表达(递归、外环、手动重入),这会使调用栈和上下文处理变得复杂。BSP自然地处理周期:循环只是一系列持续的超步骤。 - 状态是重心
在代理系统中,上下文不是“数据通过”——它是系统。决策是当前状态的功能。BSP强制要求显式的状态管理和版本管理,这与基于LLM的工作流程异常契合。 - 并行性需要一类同步原语
像Map-Reduce的扩散模式或主管/员工协作需要并行工作,这些工作后来会汇聚。BSP障碍它能让你原生实现同步点——无需临时拼凑asyncio.gather、锁或脆弱排序假设。
谷歌普雷格尔与BSP模型
普雷格尔框架
Pregel可以归纳为三个观点:
- 计算方式:a顶点状态机——决定是工作还是睡觉
- 运行方式:该BSP 执行模型——决定系统如何同步
- 传播方式: 消息传递—— 边上的移动值
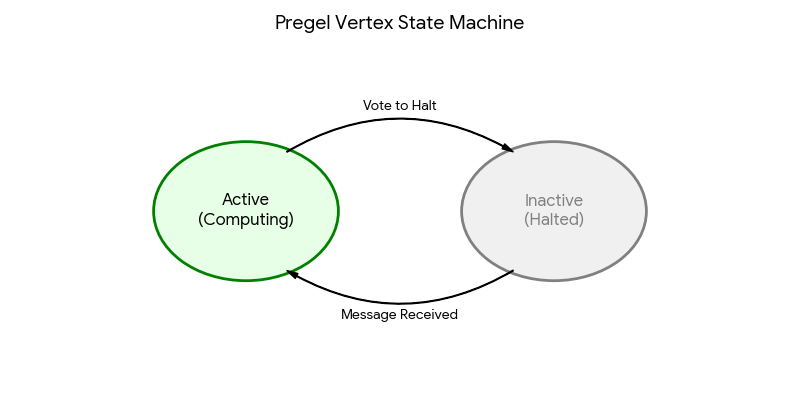
这就是“像顶点一样思考”的核心直觉。每个顶点有两个关键状态:
- 活跃状态:顶点运行
compute()处理入站消息,更新其值,并将消息发送给邻居。 - 非活跃(停止):顶点在投票决定停止后进入“休眠”状态。
- 醒来:收到消息会使停止的顶点返回活跃.
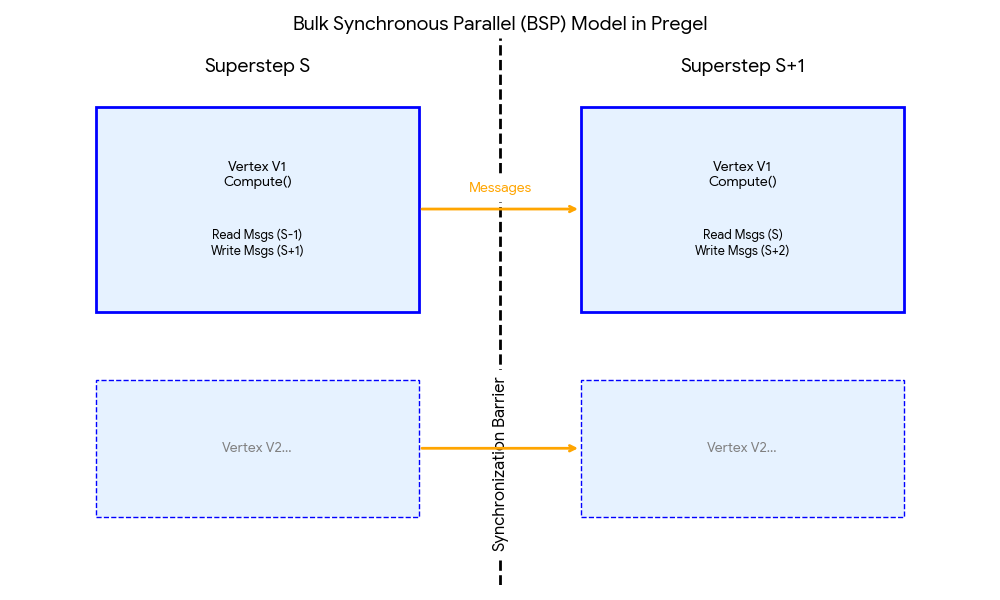
在一个聚类上,计算被切分为超阶:
- 计算:所有活跃顶点并行运行(读取 step 中的消息)
S-1→ 计算→发送 step 的消息S+1) - 留言:值正在流转
- 障碍:每个人都必须完成这一步
S——而且信息必须在之前送达任何人步进S+1
没有人跑在前面;没有人被落下。这种节奏消除了大量比赛条件。
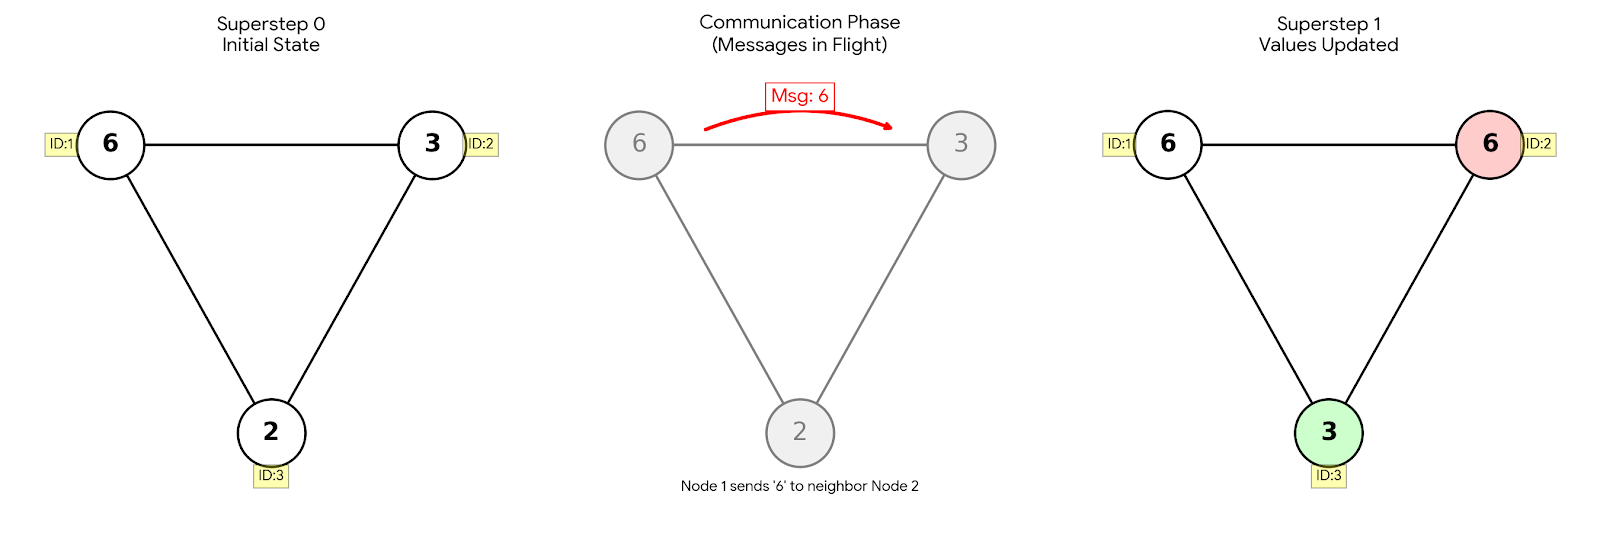
例如:将最大值(6)分布在图中。
- 超级步 0:节点1的值为6。
- 信息:节点1对节点2说:“我有一个6。”
- 超级步1:节点2接收6,将其与自身值(3)比较,更新为6,并继续传播。
- 结果:最大值像传染病一样在图中蔓延。
BSP模型
由莱斯利·瓦连特提出,批量同步并联(BSP)将执行分为顺序超阶.在每个超步中,会发生三件事:
- 局部计算:每个处理器独立计算本地数据。
- 沟通:处理器发送消息,但这些消息直到下一步才可见。
- 屏障同步:大家都等到计算和通信完成。
这抑制了混沌:由于消息只有在障碍之后才可见,每个单元都会观察到前一步的全局一致状态。对程序员来说,心理模型更简单:编写交替计算和通信的逻辑,并被一个障碍限制。
解码 LangGraph 运行时
那么LangGraph是如何实现BSP的?核心引擎是PregelLoop.
StateGraph 与消息传递
一切都始于州.你定义一个模式(通常是TypedDict或是皮丹塔模型)表示流经图中的数据。
from typing import TypedDict, Annotated
import operator

class AgentState(TypedDict):
    messages: Annotated[list[str], operator.add]
    summary: str
关键细节是Annotated[list[str], operator.add]:它定义了一个频道以及其减速器.
通道:将读写解耦
在BSP中,节点不会直接变异共享内存。它们是向通道发布更新。
- LastValue(默认):保持最新值(适合覆盖)。
- BinaryOperatorAggregate:安全并行更新的骨干。二进制操作符(例如:
operator.add)在该障碍处合并更新。如果多个节点在同一超步内发布更新,运行时会确定性地聚合它们——没有丢失的更新,也没有竞量。 - 话题:一个类似公共/订阅的频道,用于瞬态事件。
PregelLoop:超步的生命周期
心跳是PregelLoop.tick.
第一阶段:计划
在超步开始时,运行时检查频道版本.
- 它是数据驱动的:如果节点订阅了上一步更新的通道,该节点则变为活跃.
- 如果前一步结束于条件边,路由函数决定下一个激活哪些节点。
第二阶段:执行(本地计算)
活动节点是并行运行的。
- 阅读孤立:每个节点读取快照在步骤开始时捕获的状态。即使节点A发布更新,节点B(并发运行)仍然会看到旧快照。
- 写缓冲:节点输出是缓冲的;它们不会立即应用。
第三阶段:更新与障碍
所有活跃节点完成后:
- 收集缓冲写入
- 应用减小器(例如:
old_messages + new_A + new_B) - 增量信道版本
- 检查点:将完整状态序列化到存储中
只有在这之后,屏障才会被解除,下一个超级步开始。
LangGraph 源代码(概念性)
状态与频道
状态行为由底层信道类型定义。
| 海峡级 | 更新逻辑 | 典型用途 |
|---|---|---|
| LastValue | value = new_value(覆盖) | 旗帜,最新查询 |
| 二元运算子聚合 | value = reducer(value, new_value) | 聊天记录(add_messages),平行结果 |
| 主题 | 附加到队列 | 发布/订阅,活动流 |
# BinaryOperatorAggregate (reducer channel type)
class BinaryOperatorAggregate(BaseChannel):
    def __init__(self, operator, initial_value):
        self.operator = operator  # e.g., operator.add
        self.value = initial_value

    def update(self, values):
        if not values:
            return False

        for new_val in values:
            if isinstance(new_val, Overwrite):
                self.value = new_val.value
            else:
                # Apply reducer: old + new -> updated
                self.value = self.operator(self.value, new_val)
        return True
Pregel环路与超阶(简化版)
class PregelLoop:
    def execute(self, initial_state):
        # 1. Initialize channels
        self.channels = self.initialize_channels(initial_state)

        # 2. Superstep loop
        while not self.is_terminated():

            # --- Phase A: Plan ---
            tasks = []
            for node in self.nodes:
                # Trigger: input channel updated in the previous step
                if self.check_trigger(node, self.channels):
                    # Read snapshot (immutable)
                    input_snapshot = self.read_channels(node.inputs)
                    tasks.append((node, input_snapshot))

            if not tasks:
                break

            # --- Phase B: Execute (parallel) ---
            # Nodes cannot observe each other's writes within the same step
            results = await parallel_execute(tasks)

            # --- Phase C: Update (barrier) ---
            for node, result in results:
                writes = self.parse_writes(node, result)
                for channel, values in writes:
                    self.channels[channel].update(values)

            # --- Phase D: Checkpoint ---
            self.checkpointer.put(self.channels.snapshot())

            self.step += 1
检查点与“时间旅行”
检查点不仅仅是一个存档文件;它是一个逻辑时钟.
它同时存储了这两份文件channel_values(用户数据)和channel_versions(同步元数据)。这使“时间旅行”成为可能:加载任何之前的检查点,重放执行,或从过去状态分支新分支。
对于调试多步代理行为来说,这并不是一个可有可无的“可有”功能——它改变了可能性。
中断
在标准Python中,中段暂停——await而序列化暂停执行上下文则很痛苦。
在BSP中,超步之间的障碍是一个自然的暂停点。当中断被配置时(例如:interrupt_before=["node_A"]),运行时在障碍处停止调度,保持状态并退出。
恢复就是:重新加载检查点→继续进行下一个超步。
框架比较
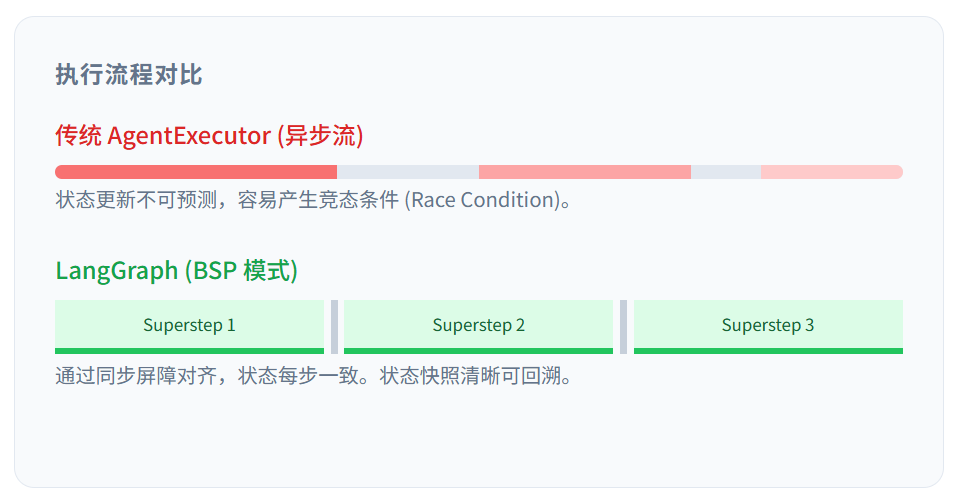
| 特色 | LangGraph(BSP) | 原生非同步 | 注释 |
|---|---|---|---|
| 控制流程 | 按步骤:读取→运行→写→同步 | 持续回拨/等待 | BSP结构化,更容易推理;asyncio可以更快,但审计更难 |
| 一致性 | 强力:减小器解决屏障处的冲突 | 脆弱:易于引入的种族 | BSP减少了对锁的需求 |
| 调试 | 时间旅行:从任意步重放 | 仅用原木 | 快照使全球重建成为可能 |
| 失控环 | 显式的保护措施(例如递归/步数限制) | 隐含(绞刑/饥饿) | BSP将“终止政策”视为一流关注点 |
与其他代理框架相比:
- CrewAI:非常适合高级“角色扮演团队”,但更难控制细致状态或实施严格回滚。
- 自动生成:以对话为中心;状态通常分散在代理历史中,而非集中化,这使得全局撤销和重放更为困难。
高级模式
BSP解锁了其他架构中尴尬的模式。
1) 映射缩减(动态扇出)
当批处理大小在运行时未知:
- 地图(步骤1):调度员发出信号
Send对象 - 流程(步骤2):运行时动态生成$N$并行工作者
- 减少(步骤3):减频器仅在所有并行输出到达并聚合到障碍时触发
--- 配置: 主题:“基础” themeVariables: 原色:“#BB2528” primaryTextColor:“#fff” primaryBorderColor: '#7C0000' 线色:“#F8B229” 次要颜色:“#006100” TertiaryColor:“#fff” --- 图 LR A[规划节点] -->|生成|B(发送数据包1) A -->|生成|C(发送数据包2) A -->|生成|D(发送数据包3) B -.->|动态生成|W1 C -.->|动态生成|W2 D -.->|动态生成|W3 W1 -->|写信给|R W2 -->|写信至|R W3 -->|写信至|R R -->|触发|S
import operator
from typing import Annotated, TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.types import Send

# 1. 定义状态
class OverallState(TypedDict):
    topic: str
    sub_results: Annotated[list[str], operator.add] # 聚合所有 Worker 的结果

class WorkerState(TypedDict):
    section: str

# 2. 定义节点
def planner(state: OverallState):
    # 动态生成 3 个子任务
    sections =
    # 返回 Send 对象列表。这不会立即运行,而是安排在下一超步并行运行。
    return

def worker(state: WorkerState):
    # 并行执行的逻辑
    return {"sub_results": [f"Finished section: {state['section']}"]}

def reducer(state: OverallState):
    # 当所有 Worker 完成后,本节点被触发
    # 由于 sub_results 是 operator.add,这里能看到完整的列表
    return {"final_summary": "\n".join(state["sub_results"])}

# 3. 构建图
graph = StateGraph(OverallState)
graph.add_node("planner", planner)
graph.add_node("worker_node", worker)
graph.add_node("reducer", reducer)

# 动态扇出:使用 add_conditional_edges
graph.add_conditional_edges("planner", lambda x: x) # 直接返回 Send 列表
graph.add_edge("worker_node", "reducer") # Fan-in: 所有 worker 写完后触发 reducer
graph.add_edge("planner", END) # 只是为了图完整性,实际流向由 Send 控制
graph.set_entry_point("planner")

app = graph.compile()
2)子图(分形复合)
一个图可以作为节点包裹在另一个图中。父图暂停,子图通过自身的超步骤推进。这支持模块化和隔离性——当你需要没有单体的复杂代理时非常有用。
--- 配置: 主题:“基础” themeVariables: 原色:“#BB2528” primaryTextColor:“#fff” primaryBorderColor: '#7C0000' 线色:“#F8B229” 次要颜色:“#006100” TertiaryColor:“#fff” 背景:“#f4f4f4” --- 图 LR 子图父图 启动——>路由器 路由器 -->|复杂度高|子图节点 路由器 -->|复杂度低|SimpleNode SubGraphNode --> 结束 SimpleNode --> 结束 结束
子图子图节点 [子图执行] 方向 LR S_Start(起始))——> 特工1 特工1——>批评 批评 -->|拒绝|代理人1 批评 -->|赞同|S_End(结束) 结束
# 定义子图 (Child Graph)
child_builder = StateGraph(MessagesState)
child_builder.add_node("child_agent", call_model)
child_builder.add_edge(START, "child_agent")
child_builder.add_edge("child_agent", END)
child_graph = child_builder.compile()

# 定义父图 (Parent Graph)
parent_builder = StateGraph(ParentState)
parent_builder.add_node("router", router_node)

#!!! 关键点:将编译后的子图作为节点加入父图!!!
# 在 BSP 运行时看来,这只是一个耗时较长的普通节点
parent_builder.add_node("nested_workflow", child_graph)

parent_builder.add_edge(START, "router")
parent_builder.add_conditional_edges(
    "router",
    route_logic,
    {"complex": "nested_workflow", "simple": "simple_node"}
)
3)人机循环(HITL)
因为状态与执行是解耦的,你可以“冻结”世界,让人工编辑状态(例如修正银行转账金额),然后恢复,好像世界一直保持一致。
# Demo 说明:
# Agent负责处理敏感的转账请求:
# - 输入分析: 提取金额和收款人。
# - 风险评估: 如果金额 > 1000,需要人工审批。
# - 执行转账: 调用银行 API。

# Demo 代码示意实现:
## 定义状态
class State(TypedDict):
    amount: int
    recipient: str
    status: str

## 节点 1: 风险检查
def risk_check(state: State):
    if state["amount"] > 1000:
        # 触发中断
        decision = interrupt(f"Approve transfer of {state['amount']}?")
        if decision!= "approve":
            return {"status": "rejected"}
    return {"status": "approved"}

## 节点 2: 执行
def execute_transfer(state: State):
    if state["status"] == "approved":
        print(f"Transferring to {state['recipient']}")
    return {}

## 构建图
workflow = StateGraph(State)
workflow.add_node("risk_check", risk_check)
workflow.add_node("execute_transfer", execute_transfer)
workflow.add_edge(START, "risk_check")
workflow.add_edge("risk_check", "execute_transfer")
workflow.add_edge("execute_transfer", END)

app = workflow.compile(checkpointer=MemorySaver())
回归现实:代理实现
回到最初的bug,我将这些想法应用到了代理开发中。
速度与隔离
我用过并行执行对于数据获取(get_cve_data,get_cvss_data)以降低延迟。
为了避免上下文污染——即一个分支(例如ASD生成)的大量上下文渗透到另一个分支——我用了子图以隔离执行上下文。
class CVSSVectorAgent:
    """CVSS Vector Agent"""

    def __init__(self):
        self.data_agent = CVEDataAgent()
        self.asd_agent = MitreASDAgent()
        self.llm = ChatTongyi(name="cvss-vector-agent-llm", model="qwen3-max")
        self.prompt_manager = CVSSVectorPrompts()
        self.memory = MemorySaver()
        self.agent = self._build_graph()
        self.logger = get_logger()

    def _build_graph(self):
	    ...
	    # 添加边
        # get_cve_data, get_cvss_data, generate_asd_data 是并行节点用于加速agent执行
        builder.add_edge(START, "get_cve_data")
        builder.add_edge(START, "get_cvss_data")
显式同步障碍
为了解决调度/同步问题,我添加了一个无操作障碍节点。
# No-op node to synchronize paths
def sync_barrier(state: CVSSVectorState):
    return {}

builder.add_node("sync_barrier", sync_barrier)

# ... route conditional edges to sync_barrier ...

# Only proceed after the barrier
builder.add_edge("sync_barrier", "normalize_cvss_data")
通过明确让拓扑尊重BSP节奏,“双重执行”消失了。运行时间恢复到可预测的节奏:计算、等待、推进。
结语
“了解工具”是第一步。“了解工具背后的模型”才是杠杆的来源。
从链式思维转向图表不仅仅是语法的升级——它改变了我们对时间,州, 和一致性在智能体系统中。一旦你把屏障看作时钟,许多问题就不再神秘。
参考文献
- Pregel:一种大规模图处理系统
- 图 API 概述 - LangChain 文档
- Pregel |LangGraph.js API 参考 - GitHub 页面
- LangGraph 运行时 - LangChain 文档
- 使用LangGraph构建AI代理:第8部分 — 理解约简器和状态更新 |作者:HARSHA J S
- LangGraph 概述 - LangChain 文档
- 使用LangChain的图API - 文档
- 应用结构 - LangChain文档
- 编译状态图 |LangGraph.js API 参考 - GitHub 页面
- StateGraph |LangGraph.js API 参考 - GitHub 页面
- LangGraph 101:让我们打造深度研究代理 |迈向数据科学
- 在 LangGraph - Medium 中构建带有触发点的事件驱动多代理工作流
- 通道 |LangChain 参考
- 如果有两个节点(一个节点有前节点),则前往同一个第四个节点,那么第四个节点将运行两次 ·问题 #5979 ·langchain-ai/langgraph - GitHub
- 使用条件句时节点重复执行 - LangGraph - LangChain 论坛
- 图的执行可以追溯到之前的节点——LangGraph - LangChain 论坛
- 图的执行可以追溯到之前的节点——#3,作者ignacio——LangChain论坛
- 图处理的演变:从Pregel到LangGraph |由......
- LangGraph:多代理工作流程 - LangChain 博客
- Build.inc 如何利用 LangGraph 启动多代理架构,自动化数据中心开发关键的 CRE 工作流。- LangChain 博客
- 构建LangGraph:从基本原理设计代理运行时 - LangChain博客
- Pregel |LangChain 参考 - LangChain 文档
- LangGraph执行语义。|作者:克里斯托夫·布斯勒 - 中等
- 基于LangGraph开发复杂智能体一则 - 博客园
- 如果多个子图并行使用,汇节点问题 ·问题 #1964 ·langchain-ai/langgraph - GitHub
- 2025年掌握LangGraph状态管理——Sparkco
- LangGraph 多智能体编排:完整框架指南 + 架构分析 2025 - Latenode
- 功能性 API 概述 - LangChain 文档
- 我使用 Langgraph 进行确定性工作流程的体验:r/LangChain - Reddit
- 用LangGraph打造更智能的代理:工具、内存与工作流程 - GoPenAI
- 比较AI代理框架:CrewAI、LangGraph和BeeAI——IBM开发者
- LangGraph 与 CrewAI:让我们了解它们的区别——ZenML 博客
- 利用 LangGraph 的 Send API 实现动态和并行工作流程执行
- LangGraph的执行模型比你想象的更复杂——原子旋转
- LangGraph子图中的状态是如何工作的?- LangChain论坛

 点赞
 收藏
 点踩
 分享