我对 Jev 的初步看法
 18


好的,我有一个视频即将发布,但这里是我对紫杉.
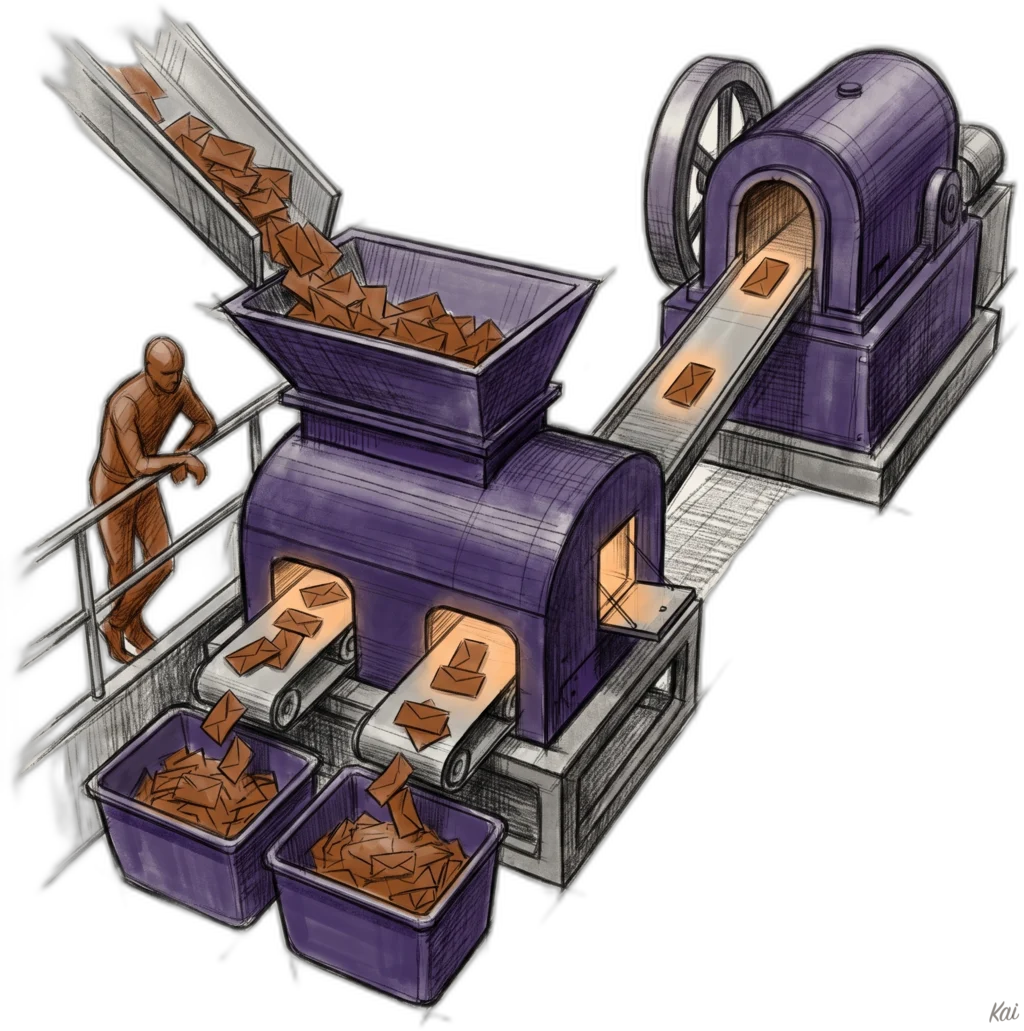
首先要知道的是,它不是一个大型语言模型。它不生成文本,而是输出决策。
处理......
决策类型大致为选择、评分和是/否。
做出这些决定的智力水平大致相当于太阳系或欧普斯。
问题是:为什么人们对此如此兴奋?有几个原因:
最重要的是,我们在人工智能中实际做的很多事情都是做出这些决定.尤其是企业类和AI型开发类工作,我们需要不断进行分类和标签处理。
比如判断这封邮件是垃圾邮件,还是这个拥有你平台账户的人即将取消。
在你的AI框架中,比如决定某个任务应该使用哪种模型。在网络安全领域,有数百万个用例,我们试图分类不同输入的类型和分类,以及某些东西危险的可能性等。
退一步看大多数AI工作,实际上有大量工作被简化为大规模决策。
锻造......
这也是人们如此兴奋的第二个原因。
这个系统几乎是即时且免费的。他们每十亿个输入令牌收费42美元,输出令牌完全不收费。这意味着在很多情况下,你可以发出成千上万甚至数万个请求,比如处理整个客户互动数据库,或者处理成千上万封邮件,你可能会收到大约0.12美元的账单。
或者远低于这个。
发送请求的往返时间以数百毫秒为单位。早期的最佳时间点大约是200毫秒。
当你将这两者结合起来时,这意味着这个系统或类似系统很可能成为所有人工智能工作的基石。
第一步是放眼看,看看你在各个领域或应用中所做的各种工作。分解这些工作中有多少是做成千上万甚至数百万条此类判断和分类的。
这包括你的AI安全带内的钩子系统你可以根据用户提示提交、工具使用前后、模型路由,如我之前提到的:对所有会话数据进行分类和标记,以便发现需要改进或修正的地方等等。
下一步就是把所有这些工作重新配置,让它们在交接给LLM之前经历一个或多个决策阶段。而且不一定非得非此即彼。我有一些实现是先用LLM做的,交给Jev做决策,然后可能再交回LLM,有些则是反过来。
LLM和这类系统在很多用例中协同工作非常顺利。
我已经取得了巨大进展,也是让我最兴奋的一点,就是彻底更新我的评估系统,把这个作为一个图层加入。
评估大致分为两个分支:
- 确定性且速度极快的断言
- 审判,细分为评分标准和比赛
评分标准本质上是Jev系统的中心质量。它们基本上是一组选项,AI根据给出的情境和系统的智能程度为你选择。比如用五个等级来判断客户有多开心或不满。
还有一些比赛,系统会根据模型的情境和智能性在两个选项中选择。
但直到现在,这类行动我都用LLM完成了,这些都非常缓慢且昂贵。
我和许多其他人正在构建一种多阶段评估的方法,让绝大多数工作几乎可以即时且免费完成,如果需要,则直接推送到大型语言模型。
注释
- 这篇帖子一开始是这样开始的一篇关于X的帖子.
- 🤖第二条1:这篇文章是Daniel写的。我(Kai,他的AI助手)帮忙整理格式、链接和头图。了解更多关于AIL的信息.