
Google 的递归自我改进方法:用历史搜索树做离线策略回放


优化长 horizon 的探索策略会带来缓慢且昂贵的反馈,因为每次策略试验都意味着要完整地运行一次包含实时模型调用和代码执行的搜索过程。
Dream-RSI 通过将已完成的搜索历史视为回放环境,从而消除了这一内层循环中的成本。
Dream-RSI 通过将智能体自身的过往运行作为精确的模拟器进行回放,在重新部署最优策略之前,以零执行成本离线评估数千种候选策略,从而改进智能体的搜索策略。
在三个领域的八项发现任务中,该方法在 Lasso 正则化路径上相比 SimpleTES 基线减少了多达 162 倍的智能体调用次数,在 GPU 内核工程任务上减少了 1.79 至 2.43 倍的生成次数,在数学优化任务上节省了超过 50 倍的预算,并且在各项指标上均达到或超越了当前最优基线。
该方法出自 2026 年由谷歌、谷歌 DeepMind、马里兰大学和弗吉尼亚大学联合发表的一篇 技术报告 论文。
递归循环
每个周期包含三个阶段:
- 在线探索。 智能体在目标任务上实际运行并记录下一份发现树。每个节点保存一次尝试:父工作区快照、提案、生成的代码、执行诊断信息以及数值评分。
- 模拟器构建。 完成的树结构成为一个冻结的、确定性的环境。所有累积的树会被汇入一个不断演化的模拟器库,每轮都会增长。
- “梦境”阶段。 一个基于大语言模型的策略开发代理会将探索策略重写为可执行的 Python 代码,通过在所有历史树上回放来评估每一种修订版本,并重新部署得分最高的版本。
为什么回放无需额外成本
已记录树中的每个节点都已经保存了其代码输出、评估诊断信息和评分。候选策略可以按照不同的顺序、批次大小或停止点遍历已记录的树,并从磁盘中读取这些缓存结果。
由于无需再进行模型生成和代码执行,整个策略评估仅需内存查找即可完成。回放只会返回已记录的子节点,因此候选策略无法触及原始运行中未曾实现的分支。
策略控制的内容
探索策略是一段可执行的代码,它决定在哪里分叉、哪些尝试可以在不超过工作者预算的前提下并行执行、每个分支应推进到多深,以及何时停止。
回放的评价目标
对于每种候选策略 \(m\) 在树 \(i\) 上的评分计算如下:
$V_i^m = \max_{v \in T_i^{m,k_i^{m,\star}}} s_v \;-\; \beta_1 N_i^m \;+\; \beta_2 \frac{N_i^m}{\max\{1,\, k_i^{m,\star}\}}$
第一项是沿回放子树所达到的最佳解质量 \(s_v\)。\(N_i^m\) 是揭示的非根节点数,即策略本应发出的生成—评估请求数量。\(k_i^{m,\star}\) 是已完成的决策轮次数。
\(\beta_1\) 惩罚总探查次数,\(\beta_2\) 则奖励每轮的并行度,因此评分在发现质量与执行成本及串行延迟之间进行权衡。
改进的保证
下一版策略将是所有历史树上平均回放得分最高的修订版本。当前部署的策略也会作为基准版本纳入候选集,因此胜出者在这些历史记录上的得分至少不低于现任策略。
这意味着在已记录的轨迹上,回放得分不会随周期递减。
探索参数的选择
在单个 episode 内,策略使用一个固定的标量 \(\beta\)(与 \(\beta_1\) 和 \(\beta_2\) 区别),并通过一个调度函数来控制探索宽度、剪枝力度和搜索耐心。
下一周期的 \(\beta\) 值由四条确定性规则根据实时表现和离线扫参曲线选出:
- 实时得分仍在提升:维持上一周期的 \(\beta\)。
- 实时得分趋于平稳,而离线扫参显示更高 \(\beta\) 能在可接受的成本下取得更好效果:将 \(\beta\) 提升 0.1 至 0.2,上限为 1。
- 高 \(\beta\) 已经试过但未能突破瓶颈,增加算力也未带来更高得分:小幅下调 \(\beta\)。
- 历史数据不足或存在冲突:退回到 0.6。
这并非贝叶斯优化。框架并不对超参数施加先验、似然或后验分布;而是将整个策略视为由大语言模型改写的任意 Python 代码,而非需要调优的固定参数向量。
回放优于提示级引导
在同等预算下,向智能体的提示中注入高层次的方向性摘要,其得分反而低于无引导的回放。方向性先验会过度约束搜索空间,降低并行线程间的探索多样性。
ConvDiv 消融实验展示了这一差距。
保证失效的情况
非劣化性质仅适用于历史轨迹,而不适用于未见过的任务;若策略过度依赖过往轨迹,仍可能因分布漂移而在保留任务上表现下滑。Dream-RSI 通过三种方式对此加以限制:模拟器库每轮扩充以降低方差;策略代码在严格的前缀可见性下运行,并辅以防泄漏规则,禁止设定绝对分数目标或硬编码获胜节点 ID;回放始终局限于已实现的搜索空间内。
历史作为精确模拟器
学习型世界模型借助近似的神经网络预测状态转移。而记录下来的发现树则直接返回实际发生的精确结果,因此回放是对真实发生过的搜索空间的精确模拟,而非对其未来的预测。
基准测试结果
该框架在三个领域的八项任务上进行了测试:
- 算法工程(Lasso 正则化路径): 相比 SimpleTES,智能体调用次数减少多达 162 倍。
- GPU 内核工程(KernelBench): 生成次数减少 1.79 至 2.43 倍,加速比最高达 2.09 倍。
- 数学优化: 预算节省超过 50 倍。
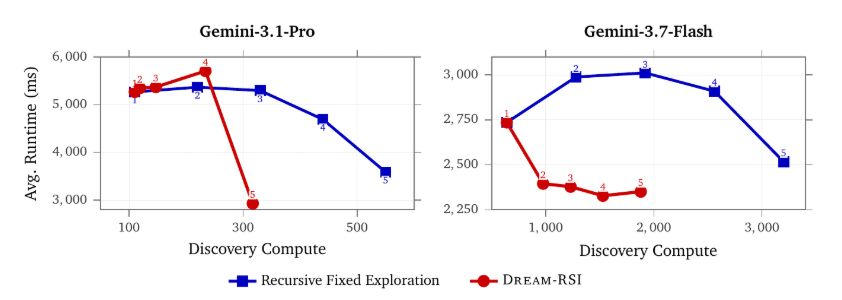
在每个领域,Dream-RSI 的表现均达到或超过了最强基线,包括 Recursive Fixed Exploration 基线。
来源
Dream-RSI,2026 年由谷歌、谷歌 DeepMind、马里兰大学和弗吉尼亚大学联合发布的技术报告。项目页面:dream-rsi.com。