JetBrains 如何在 MacBook M5 上优化 Qwen 3.6 本地推理

不久前,我们启动了一个长期项目,旨在让用户能够在各种硬件配置中完全本地运行Junie,通过本地推理。经过长时间的期待,我们最近发布了Junie Local的初版它能在配备Qwen3.6-27B的MacBook M5上运行。
在这篇博客文章中,我将分享让它运行所付出的努力,以及我们为何选择在Qwen3.6-27B而非Qwen3.8-27B发布。我们在整个栈中进行了优化,从Junie代理本身到我们选定的推理引擎。
我们先从Junie说起——毕竟,这里是你开始与本地模型互动的地方。
Junie 优化
扩展代理人的滚动上下文
和其他编码代理一样,Junie 有一个主要执行循环,所有工作都在这里完成:
- 首先,用户指定一个任务。
- 然后,Junie把它发给LLM。
- 然后,LLM会响应一些工具调用(比如Bash命令、读写文件指令等)。
- 最终,Junie将该命令的结果传回来。
这里有一个非常简化的流程图,说明了底层的运作情况:
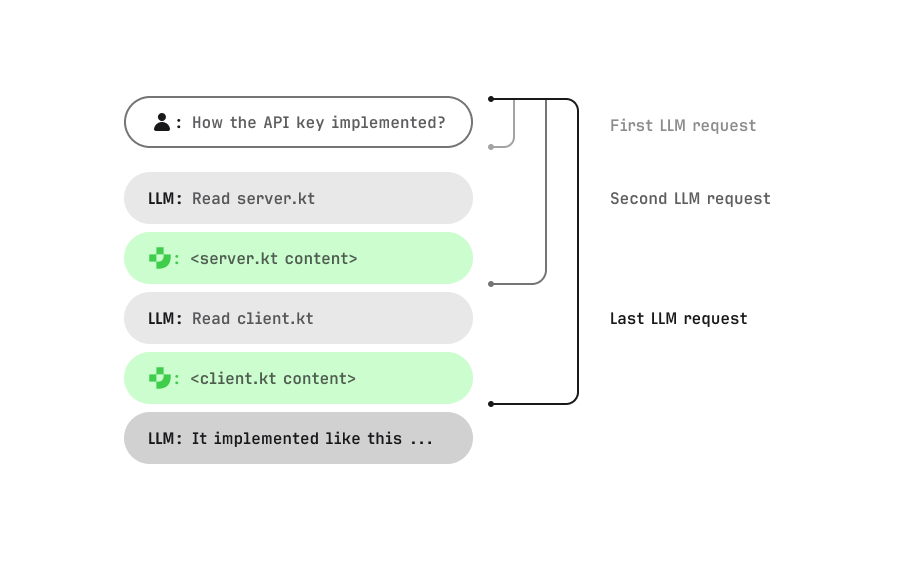
从图表中可以看到,LLM持续接收上下文扩展请求,允许它部分重用已处理过的信息。更具体地说,这意味着我们可以在下一次请求中重复使用上一次请求的预填充数据,这些数据被称为KV缓存。
但当我们让Junie在同一场次完成第二个任务时,它只从上下文中取出相关部分,并放在窗口中:
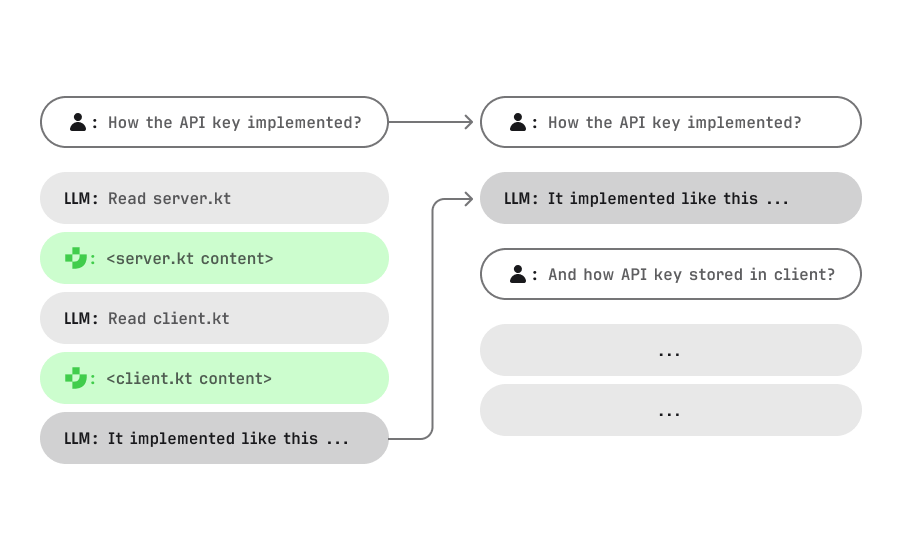
对于云模型来说,这通常非常完美,因为即使模型需要重新获取某些文件的内容,它也会请求访问并再次处理。预填充也非常快。
对于本地模型来说,情况并非如此——预填充速度不快,而且“读取”文件实际上需要相当长的时间。
为了解决这个问题,我们改变了局部推理的逻辑。现在,我们会将每个新请求直接添加到滚动上下文中:
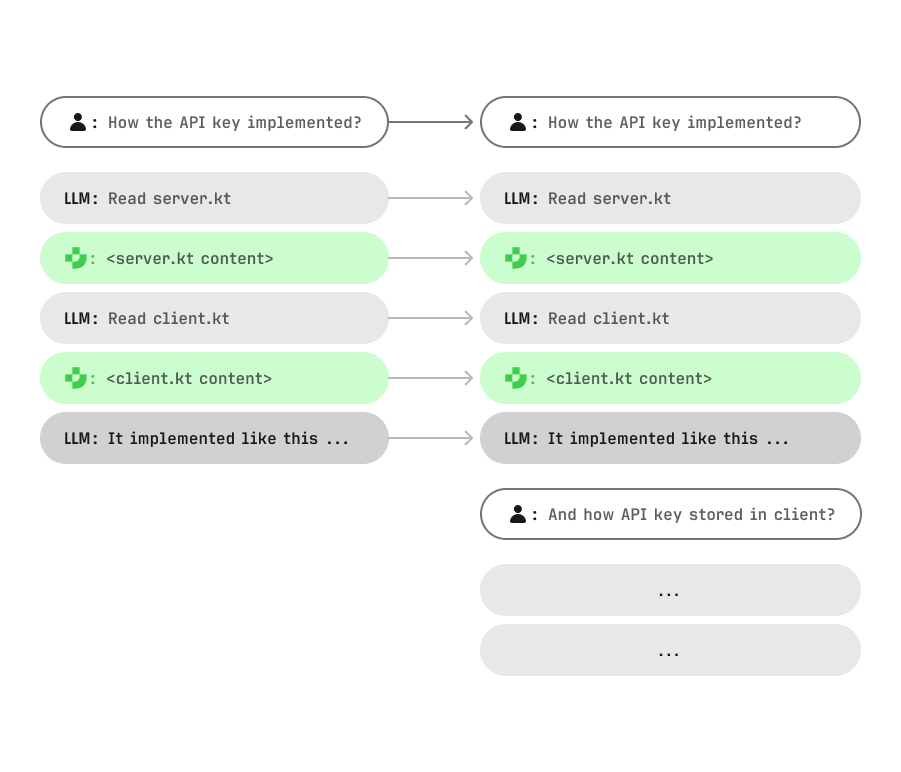
这样,我们可以重复使用上一个任务中的KV缓存,也就是说,如果模型已经读取了文件,它会留在上下文窗口中,我们无需再次“读取”它。
最大化初始可重复使用前缀
我们做的另一个类似优化是关于Junie在开始新编程会话时发送的系统提示和初始上下文。
在上一节中,流程有所简化:在首次LLM请求时,实际发送到LLM的数据远多于图表所示:
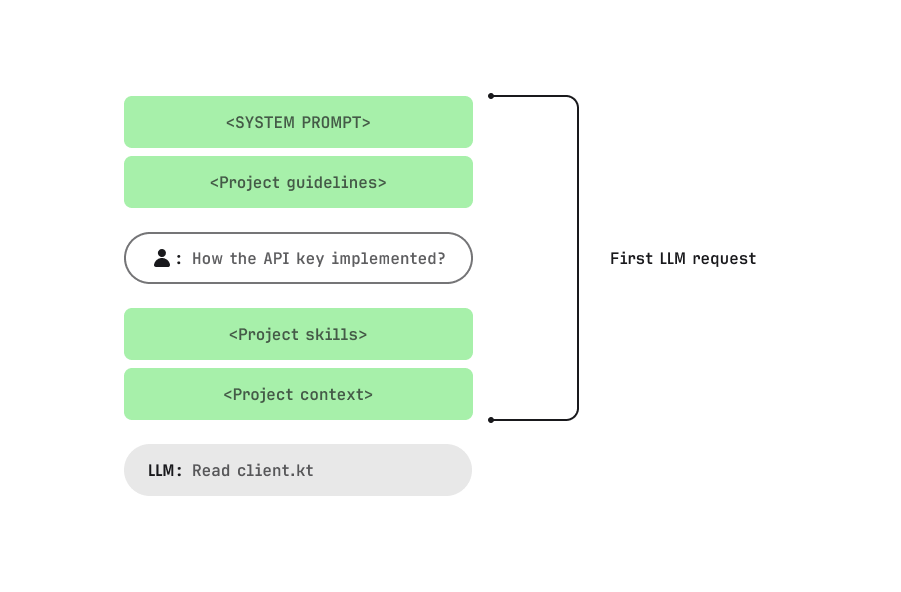
如你所见,LLM会收到完全不同的信息。所有这些信息都会在每次新会话开始时发送和处理。自然,我们更希望能以某种方式🙂缓存它
考虑到这一点,我们调整了发送这些数据的顺序:
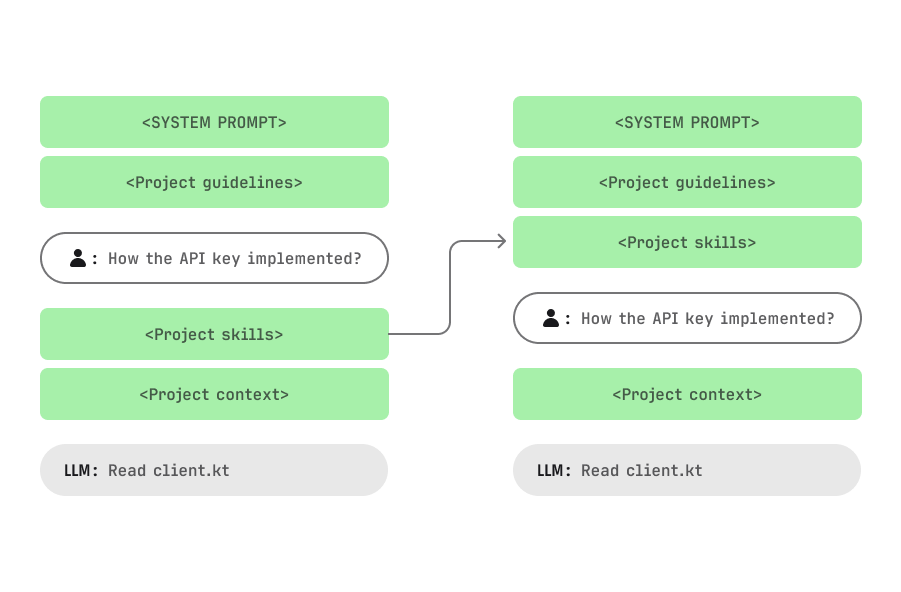
我们还为推理引擎添加了特殊逻辑,将前缀缓存到用户请求,因此在后续任务(同一项目中)中,前缀可以简单地重复使用。我们没有在用户请求之后列出任何项目上下文,因为它规模较小,且大多是顶层项目文件,可能会频繁变化。
让进度更新正常工作
在更强大的云模型中,Junie要求LLM添加一个类似XML格式的特殊块,更新内容将向用户展示。遗憾的是,Qwen 3.6 大多忽视了这些请求。
同时,模型会将动作写成纯文本,作为大型语言模型请求结果的一部分——即大型语言模型发送一些工具调用并附带说明文本。
所以,修复方法很简单——只需使用Qwen 3.6生成的文本作为用户的更新。这类适应是针对特定型号的,也就是说,我们很幸运Qwen 3.6能这样表现——有些模型在那里不打印任何内容,而另一些则生成过多的文本。
移除对LLM的不必要调用
接下来的优化,禁用所有可选的LLM请求,看似微不足道,但它确实帮助了智能体更高效。实际上,这意味着我们会禁用任何能产生任务简短描述的逻辑。
虽然我们确实牺牲了一些用户体验,但我们并不认为这种损失过大。此外,我们完全禁用了多代理模式,因为在M5上处理LLM请求的最高效方式是顺序处理,因此启用多个代理毫无意义——它们无论如何都会被推理限制。
模型参数优化
reasonning_effort:没有
当我们在内部测试Qwen3.6-27B的云端版本时,发现启用推理并未显著提升画质。所以,在本地版本中,我们决定完全禁用推理功能。这很重要,因为推理引擎视角使用的推理代币与用于生成主要响应的代币是相同的。
因此,关闭推理后,我们需要生成的token数是2–3倍,这意味着任务执行速度提升了2倍,但对质量影响微乎其微。
量子化
我们选择4位版本,因为它在基准测试中的表现仅略逊于8位版本,且生成存在内存瓶颈,使用4位版本比8位版本快约2倍。然而,当我们比较8位和4位版本的预填充速度时,发现它们是一样的......我们觉得这很奇怪,于是深入调查。
推理引擎优化
预填充黑客
有人可能会好奇,我们为什么还要关心预填。毕竟,整个互联网上充斥着世代速度基准测试和优化选项。
在独立显卡(比如RTX 5090)上,他们质疑其重要性可能是有道理的。在这种硬件上,确实非常快,因为预填充依赖计算,而独立GPU通常性能相当强大。
这意味着默认配置下预填充速度大约是3700 t/s。M5开箱时大约是650 t/s。所以当模型请求文件内容时,也就是调查时,大部分时间都花在预填充上,而不是生成!
更糟糕的是,4位、8位和16位的量化在预填充速度上没有区别。但为什么?预填充是计算限制的,这意味着我们完全不受内存速度限制。
事实证明,大多数预填充期间的矩阵操作都是在完整的16位模式下完成的。即所有4位权重在执行操作前都转换为16位数字。但M5处理器对8位数字有特殊操作,远快于16位操作。
所以,当我们对MLX-VLM包安装补丁,将预填充期间的一些*矩阵操作切换到8位时,预填充速度提升了~40%!
顺便说一句,这也是我们决定专注于M5芯片的主要原因。M4芯片没有这些8位算术指令,而M4的16位算术速度比预填充慢了20%–30%。
*Qwen3.6-27B同时使用全注意力层和自我注意力层。我们发现即使在4位量化下,全注意力权重仍以16位精度存储。由于这些层无论如何都能保持全精度,我们没有对它们进行优化——它只应用于自注意层,实际上会减少内存和计算量。
这是链接连接到MLX-VLM的补丁。此外,同样的优化也可以应用到vLLM,只需编辑模型配置文件即可。配置示例
通过MTP和n-gram匹配进行推测解码
作为标准优化,我们应用了:
- MTP(多代币预测)与独立草稿模型:一种推测解码方法,较小的草稿模型先提出多个标记,主模型随后进行验证。
- N-gram推测解码:该方法不是草稿模型,而是在上下文中寻找之前重复的令牌序列,并通过匹配来“预测”即将出现的令牌。
我们同时启用了这两种方法。实际上,这意味着在生成过程中,我们有时不仅接受MTP提出的~3个令牌,还接受多达8个额外的n-gram方法令牌。
下图展示了按生成每个被接受令牌的方法(草稿模型与n-gram)颜色编码的原始生成代币。
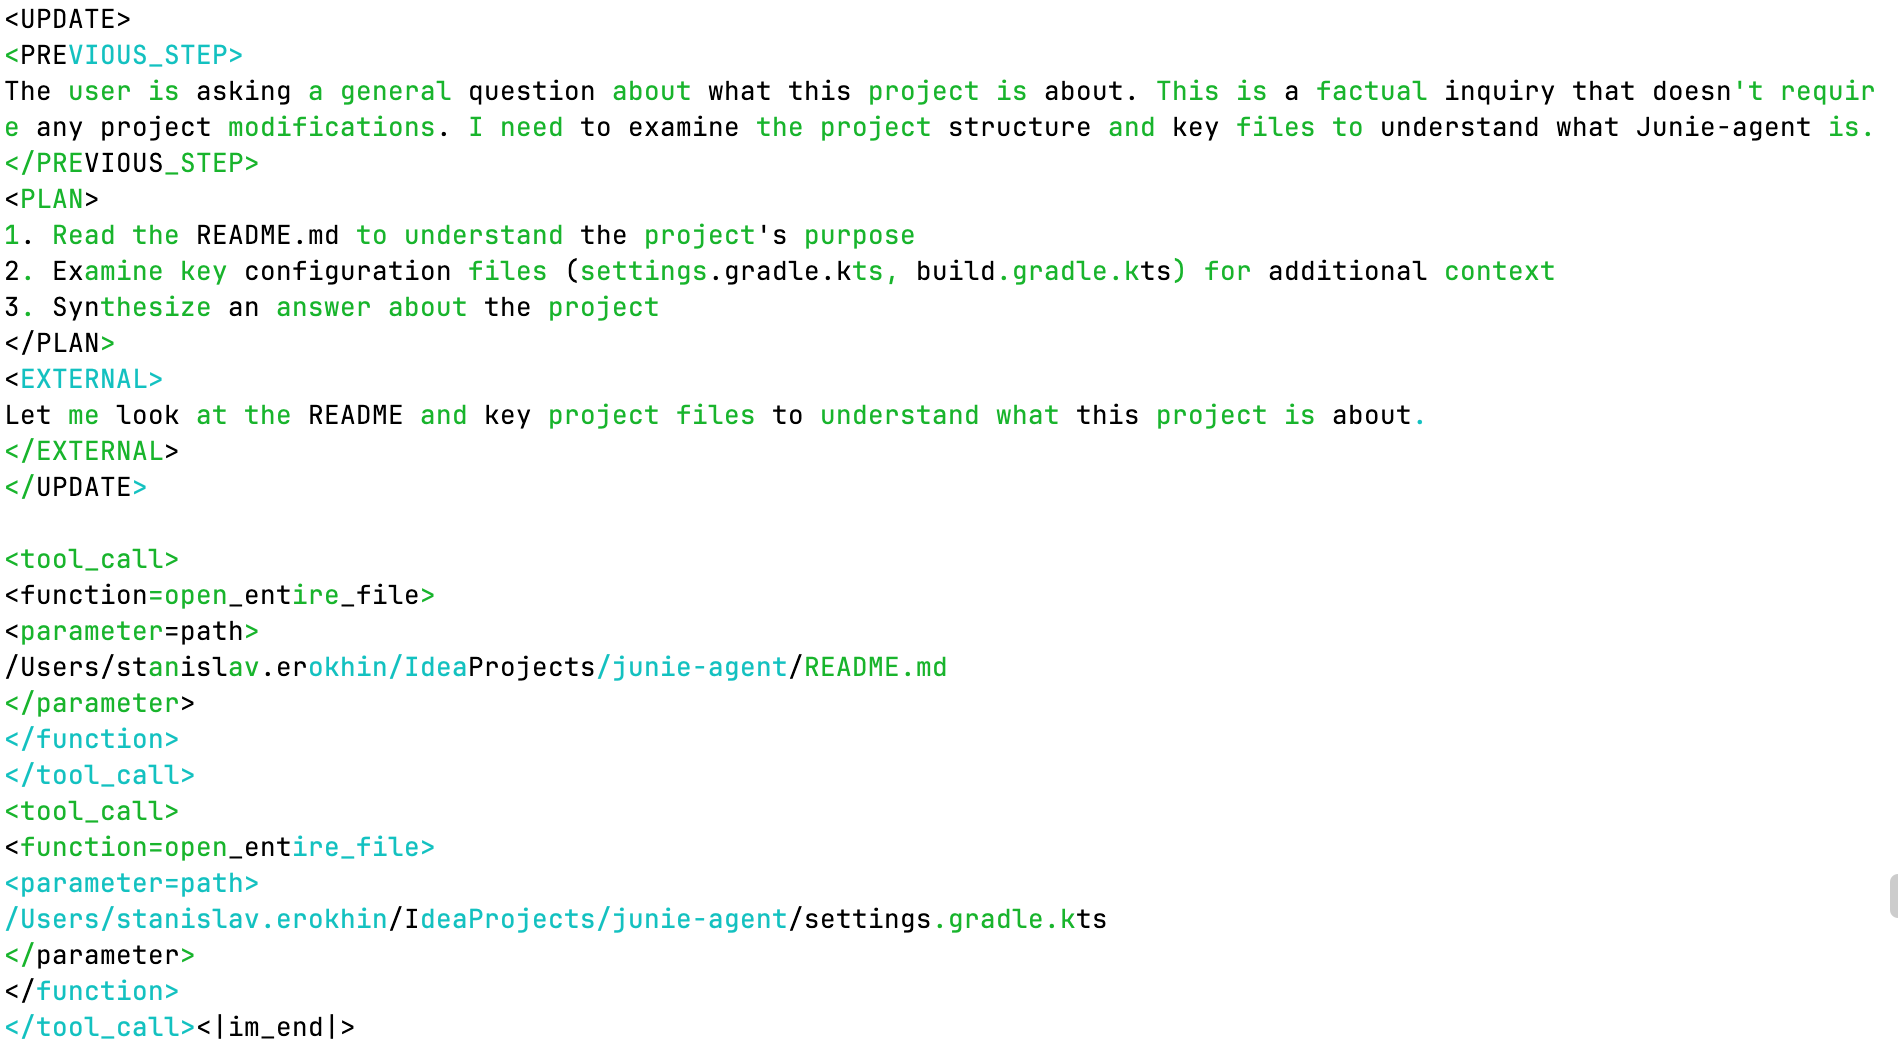
综合起来,生成速度可提升最多2倍。
Qwen 3.8-27b
考虑到这些,为什么我们不使用3.8而不是3.6?
遗憾的是,Qwen 3.8 需要启用推理模式才能正常运行。没有它,输出质量会显著下降——在典型任务中,它甚至可能完全失败,陷入一个循环,不断重复同一个工具调用。
但启用推理模式会显著增加生成的代币数量:在中等推理努力下,产生的代币大约是5倍。由于预填充时间基本保持不变,净减速更接近4倍,而非整整5倍。
这仍然是一笔可观的成本——这也是为什么目前在Mac硬件上,Qwen3.6-27b仍然是更好的选择。
结语
我希望读完我们的经历后,你会明白,单纯关注生成的t/s对于典型的代理编程任务来说是错误的。
你需要优化堆栈的所有部分,包括:
- 生成与预填充:标记逐符号解码过程和初始上下文处理过程。
- 模型参数与量子化:模型的重量、精度和配置。
- 代理线束:驱动模型的周围编排层(工具调用、控制流、提示逻辑)。
这就是我们未来的计划。M5 支持只是第一步——我们已经有了 DGX Spark 和 RTX 5090 的原型机(甚至还在考虑 24GB 显卡),敬请期待!

 点赞
 收藏
 点踩
 分享