开源模型正在追上闭源?SemiAnalysis实测三个时代的数据
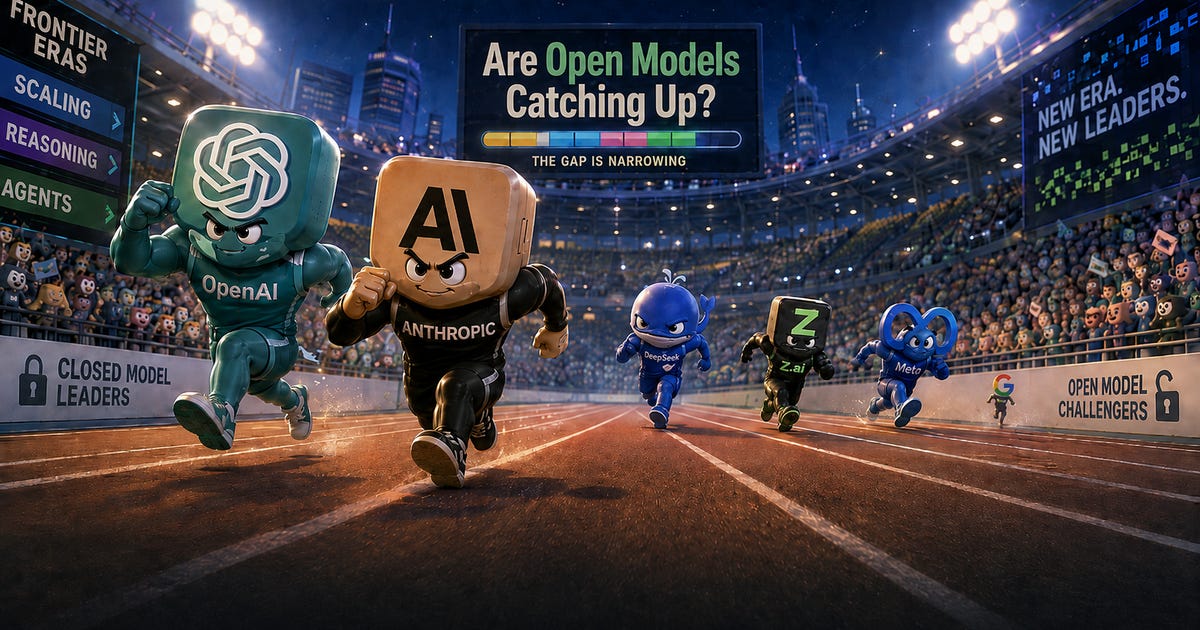
过去两个月是开源人工智能的突破期。是的,2025年1月确实有“深度搜寻时刻”,但实际上没人用R1做任何经济价值的事。相比之下,像GLM 5.3和Kimi K3确实能够胜任许多让Anthropic迅速达到650亿美元+ARR的编码和智能任务.与其他夸大ARR的人不同,我们的数据更接近现实。
现在是成为象征性消费者的激动人心的时代。竞争日益激烈,使用量重置不断,争夺你的代币的战斗已超越OpenAI与Anthropic双头垄断。
仅仅是烟花就在处理完毕40T每天代币数——是OpenAI API的2倍体积三月底。
然而,主要的FUD也源于开放模式的成功:如果开放模型相对于封闭前沿保持足够能力,且成本仅为一小部分,模型层难道不会被商品化吗?
这种结果显然对前沿实验室的边缘是灾难性的。有关Anthropic和OpenAI财务状况的详细信息,请参见我们的代币经济学模型.
要预测开放与封闭能力差距未来的发展,首先需要衡量过去。天真地说,你可能会选择一套基准来衡量所有历史模型,但这是错误的。每一个基准都是特定时代的产物。
当有人创建新的基准测试时,他们的目标是识别当时模型能力的差异。如果成功,模型制造商会不断攀升该基准,直到达到饱和。一旦发生这种情况,大家就不再关心基准,循环就这样循环。
到目前为止,LLMs历史上经历了三个时期:早期扩展、推理和代理阶段.每个时代代表模型效用的阶梯函数提升,我们认为与其试图绘制单一连续趋势,不如分别评估各个时代的模型和基准。
从这个角度看,就很明显开缺口与闭缺口的波动呈周期性.在每个时代的开始时,前沿实验室完成了一些有前景的研究,训练出令人印象深刻的模型,将其大规模部署给用户,然后迅速推进。
然后,其他实验室识别关键进展,逆向工程前沿实验室的进展,在自己的模型中复现,缩小差距。没有什么是永远保密的——尤其是考虑到蒸馏。
关键是需要多长时间。
为回答这个问题,我们收集了各个时代的所有相关模型,并运行了一组精心策划的基准测试,以获得综合能力得分。结果是一个明显的趋势:每一代开源模型追赶当时第一个闭源模型所需的时间都只有一半。
当然,基准数据不能说明全部情况,我们将在下面重点介绍所有相关的注意事项。最后,我们将将此分析延伸到未来,解释为何前沿模型比你最初想象的要少看跌。
我们的测量方式
以下是我们为每个时代选定的模型和基准的概述:
在特定时间选择单一的SOTA封闭和开放模型是主观的,但我们的选择反映了AI专家的普遍共识。在有争议的情况下——比如Fable 5和GPT 5.6的比较——我们比较保守,测试了两者。
作为基准,我们依赖个人品味和人气的结合。例如,人文学科最后考试(HLE)就以包含大量问题但实际上,它也是推理时代的决定性标杆之一,没有近似的替代。
而 SWE-bench Pro 同样受欢迎,问题,但也被DeepSWE近似。
这里的大部分基准分数都是我们自己运行的主智者的评估栈,特别是他们的环境中心和评估工具,包含在Prime-RL.剩下的都是我们朋友在人工分析以及Datacurve的DeepSWE排行榜.开放模型的服务方式与发布时相同:vLLM版本、当时使用的硬件以及从模型卡的采样设置。
对于封闭模型,我们使用了他们钉顶的API版本。当我们的数字与第三方数值共享图表时,我们匹配了他们的规则集。
我们要衷心感谢Florian Brand(@xeophon)来自Prime Intellect感谢我们帮助我们选择基准/模型、实施评估并检查正确性。
第一时代 |早期扩展(2022-2024)
现在是2023年6月。全世界都在与ChatGPT清算,而马克·扎克伯格刚刚同意在斗兽场与埃隆·马斯克对决。但当扎克在训练柔术和做墨菲舞时,他的公司也在进行自己的训练。
FAIR即将突破密斯特拉尔的撤离事件和其他风波,成功运送Llama-2-70B。第一个接近边疆的开放模型。
它离边境有多远?当时有四个基准测试帮助定义了SOTA:GSM8K、HumanEval、TriviaQA和MMLU-Pro:
这些基准代表了当时Frontier车型的性能。简单的选择题、文字题和单一函数的编程题。时代真是变了!以下是Llama-2与GPT-3.5 Turbo在笼中对决中的表现:
为了考虑基准难度差异,我们对分数进行了归一化。每个时代的最佳成绩设定为100分,其他模型则以此为基础评分。综合得分代表了四者权重均等:前沿版GPT-3.5 Turbo为75.7分,Llama-2-70B为39.9分。
这是一个有分寸但相当大的差距。这一初期延迟为该时代后续的发展奠定了基础:2023年12月发布的Mixtral-8x7B推动了GPT-4能力的发展,但GPT-4 Turbo和GPT-4o随后迅速领先:
直到2024年7月Llama-3.1-405B发布,开放模型才以86分的综合分数缩小了与GPT-3.5 Turbo的差距。最后一款前沿模型GPT-4o在2024年12月被DeepSeek V3性能匹配,分别得分为95.5和94.1。
Qwen2.5-72B在405B参数数的六分之一处落地,接近GPT-4o,预训练为18T令牌。
这是差距首次缩小。在这个时代,我们并没有看到前沿超越GPT-4的能力,但这主要是因为优先事项:Turbo和4o是为了让GPT-4更便宜更快,而不是更智能。
与此同时,OpenAI一直在追求一种不同的模型。该过程-奖励论文以及诺姆·布朗的聘用两者都指出了理由,并且到了2024年中每个主要实验室都在发表测试-时间-计算研究.405B发布七周后,即2024年9月12日,OpenAI发布了o1预览版:这一模型引发了创新新纪元。
第二纪元 |理性(2024-2025)
O1重置了基准选择和差距。第一时代的基础评估已不再足够难,无法测试O1的全部能力。小学数学题被AIME取代。Scale AI收集了世界上最晦涩的博士级选择题,挑衅性地将其命名为“人类的最后考试”。
O1的发布在科技圈中的重要性难以言喻。许多人认为那是“我们确信会获得AGI的一天”。然而,与Llama-2-70B与GPT-4不同,开源与闭源之间的差距在第二时代开始时就小得多。
罪魁祸首?一款鲜为人知的型号,名为DeepSeek R1。
相比上一个时代开始时的35.8分,差距是12.1分。市场随之暴跌。幸运的是,AI资本支出交易迅速恢复,R1建立的“我们回来了”开放模型势头很快被Meta的Llama-4 Maverick扼杀。
Gemini 2.5 Pro 和 o3 继续推动推理前沿,R1-0528 检查点于 2025 年 5 月以 78 分缩小了初步差距。8.5个月时间窗口来收复12.1点缺口:
目前排行榜上明显缺席的是Anthropic。他们的模型卡和其他车型一样报告了这些基准,但在这个时代从未争夺排行榜顶端。当OpenAI和谷歌互相竞争时,Anthropic却把Claude变成了默认的编码代理。
这为下一个时代奠定了条件:现在重要的基准运行在终端中。
第三纪元 |Agentic(2025年至今)
在Claude Code出现之前,特工们也有他们的高光时刻(比如Cognition的Devin的病毒式演示但Anthropic是第一个成功推出模型+吊带产品的——而且效果不错。自2025年5月Claude Code全面发布以来,Anthropic在ARR中新增了超过650亿美元。关于深入的人类和OpenAIARR预测,请参见我们的代币经济学模型.
随着特工的出现,又带来了另一套新的标准。复杂的数学题已不再是测试模型能力的最佳手段。相反,人们想知道模型写代码、网页搜索以及像人类一样使用电脑的能力。
Terminal-Bench 2.1、BrowseComp-Plus、τ³-banking 和 DeepSWE 涵盖了当前代理们使用的长期工作:软件工程、深度研究和知识工作。
我们还选择了设计上偏向新颖的基准测试,以减少记忆。
大多数人工智能专家认为Opus 4.5是智能纪元时代的正式开端,因为该模型的可靠性很高。有趣的是,GPT-5.2(当时OpenAI的旗舰)在我们的基准测试套件中表现更好,但这并不意味着用户体验更好。
完整的智能产品(模型+束缚)才是关键,Anthropic一直专注于迭代,打造出一款在通用代理工作中表现出色的束缚装置。相比之下,Codex相对粗糙,OpenAI同时在追求像这样的支线任务网页浏览器.
模型发布也在两个前沿实验室之间压缩。OpenAI和Anthropic通过平均每51天发布一个模型,建立了他们的双头垄断。相比第一时代和第二时代平均213天和120天的发布时间,这大大加快了速度。
尽管边疆模型带来了巨大的经济价值爆炸性增长,第三纪元的差距缩小速度比之前任何一个时代都快。Kimi K2.6在4.8个月内以56.3分超过Opus 4.5,GLM-5.2在6个月内通过了GPT-5.2,得分为72.4分。
关闭时间随着每个时代减半的趋势非常一致。
展望未来
那么,这对闭源模型与开源模型的未来意味着什么?
首先,我们要承认基准测试并不是万能的.Kimi K3在我们精心策划的综合视频中得分可能高于Fable 5,但我们仍然更喜欢在SemiAnalysis使用Fable来做日常工作。
这部分是因为Anthropic通过Claude Code和Claude Tag等工具更好地将模型产品化,但更多原因是基准测试并非真实工作的完全代理。这在公开基准测试中尤其如此,模型开发者只需创建一系列紧密模拟基准任务的强化环境,就能轻松爬坡。
其次,你可能会说第三时代的关闭时间被人为拖慢了,因为Anthropic和OpenAI在安全测试上花费的时间比Moonshot和Zhipu更多,但这并非新鲜现象。
例如,GPT-4在发布前218天完成了训练。即使假设神话在二月中旬完成训练,距离《寓言》发布也只有114天的延迟。

 点赞
 收藏
 点踩
 分享